
AI 要跑 rm -rf 时谁来拦?pi 的工具调用要过三道关
编程 agent 的每一次读文件、跑命令,在 pi 里都要过准备、执行、收尾三道关,被拦下的不会让程序崩,而是变成一张错误结果交还模型。它手里明明有 bash,为什么还要另配六个工具?附源码和一个现成的危险命令拦截扩展。
{ "name": "bash", "arguments": { "command": "rm -rf ./build ./dist ~/.cache" } }假设模型某一轮的回答里,冒出来这么一条工具调用。
前两个目录删了也就删了,第三个路径多了一个波浪号,删的是你家目录下的缓存。要是再手滑一点,多一个空格,后果就不好说了。
在开源的 pi 里,这条命令会不会被拦下来?
答案可能有点出人意料,默认不会。pi 的 README 里有一句写得很干脆,No permission popups,不弹权限确认。它的建议是,要么把 agent 关进容器里跑,要么自己写一个扩展来拦。
这就引出了今天要拆的东西。不弹窗,不等于没有关卡。pi 的每一次工具调用,都要过三道关,拦截的位置早就留好了,只是默认没人站岗。
这是「Pi系列」的第三篇。第一篇拆了 agent 的主循环,第二篇拆了上下文压缩,今天轮到循环里最危险的那一步,替模型动手。
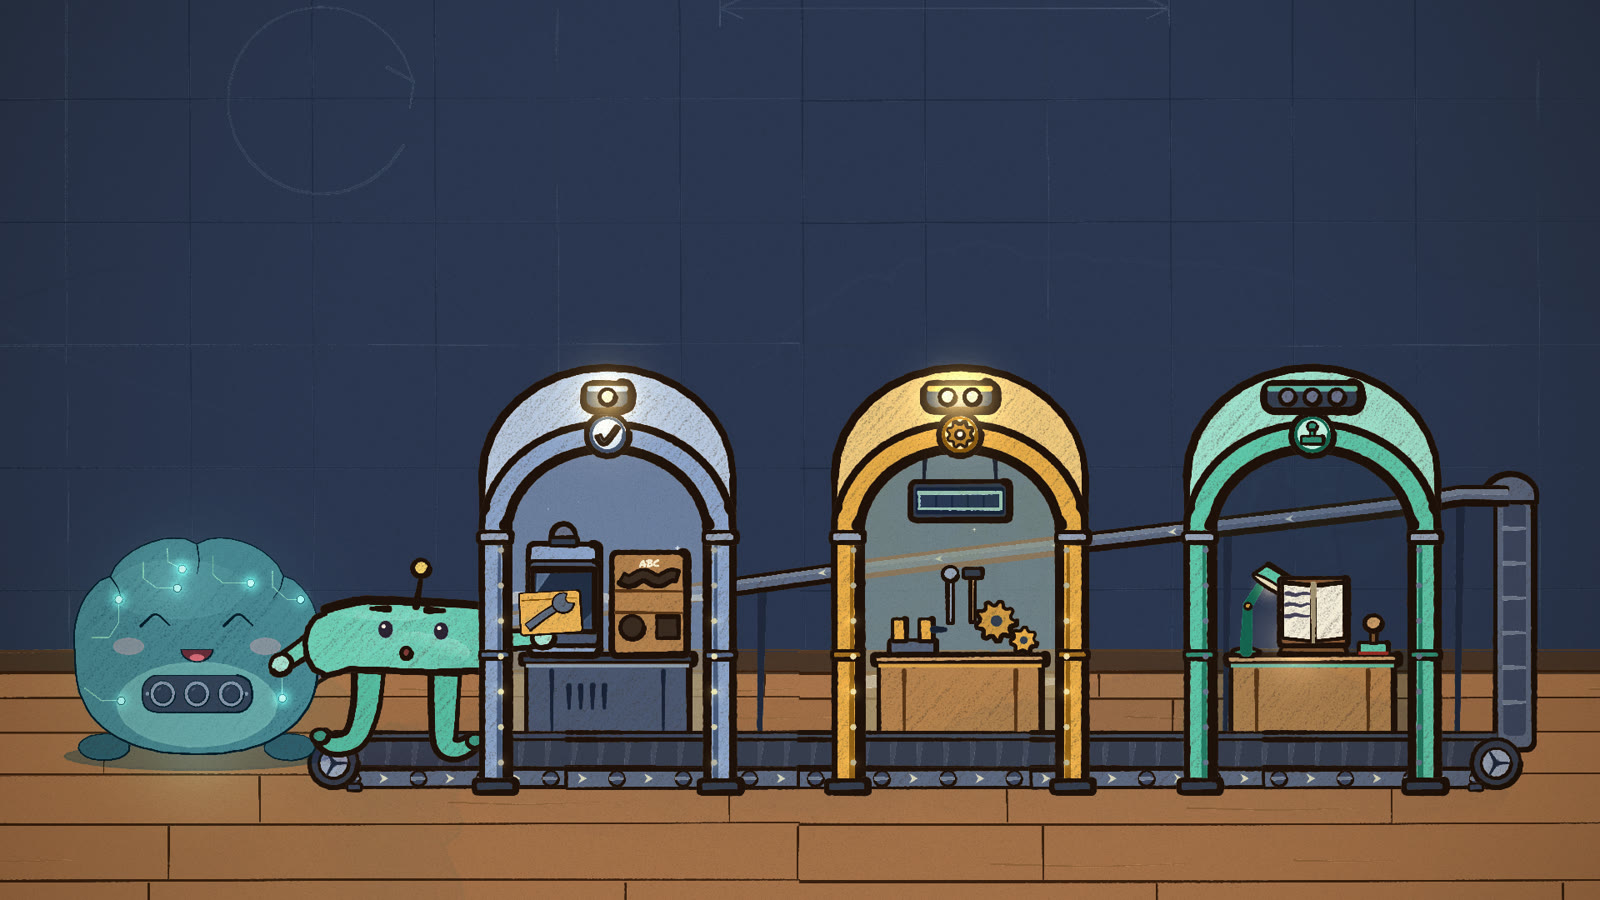
第一关,准备
模型在回答里说要调一个工具,循环不会直接去跑。它先调 prepareToolCall,这一关连查三件事。
// 摘自 pi v0.66.0 packages/agent/src/agent-loop.ts,有删减
const tool = currentContext.tools?.find((t) => t.name === toolCall.name);
if (!tool) {
  return { kind: "immediate", result: createErrorToolResult(`Tool ${toolCall.name} not found`), isError: true };
}
try {
  const validatedArgs = validateToolArguments(tool, prepareToolCallArguments(tool, toolCall));
  if (config.beforeToolCall) {
    const beforeResult = await config.beforeToolCall({ assistantMessage, toolCall, args: validatedArgs, context: currentContext }, signal);
    if (beforeResult?.block) {
      return { kind: "immediate", result: createErrorToolResult(beforeResult.reason || "Tool execution was blocked"), isError: true };
    }
  }
  return { kind: "prepared", toolCall, tool, args: validatedArgs };
} catch (error) {
  return { kind: "immediate", result: createErrorToolResult(error.message), isError: true };
}
第一件,有没有这个工具。模型偶尔会编一个根本不存在的工具名,要一把没有的锤子,直接退回。
第二件,参数对不对。每个工具都声明了参数格式,要的是一串文字,它塞来一个数字,校验不过,退回。
第三件,问上层让不让干。这一步叫 beforeToolCall,是整个 pi 里专门留给拦截的位置。上层返回一个 block,这次调用就不执行了。
注意这三种退回的方式。没有一个是抛异常把程序搞崩,全部变成一张错误结果,isError: true,当作这次工具调用的返回值交还给模型。模型下一轮看到「Tool xxx not found」或者参数校验的报错,自己就会改。
好家伙,拦截也是对话的一部分。
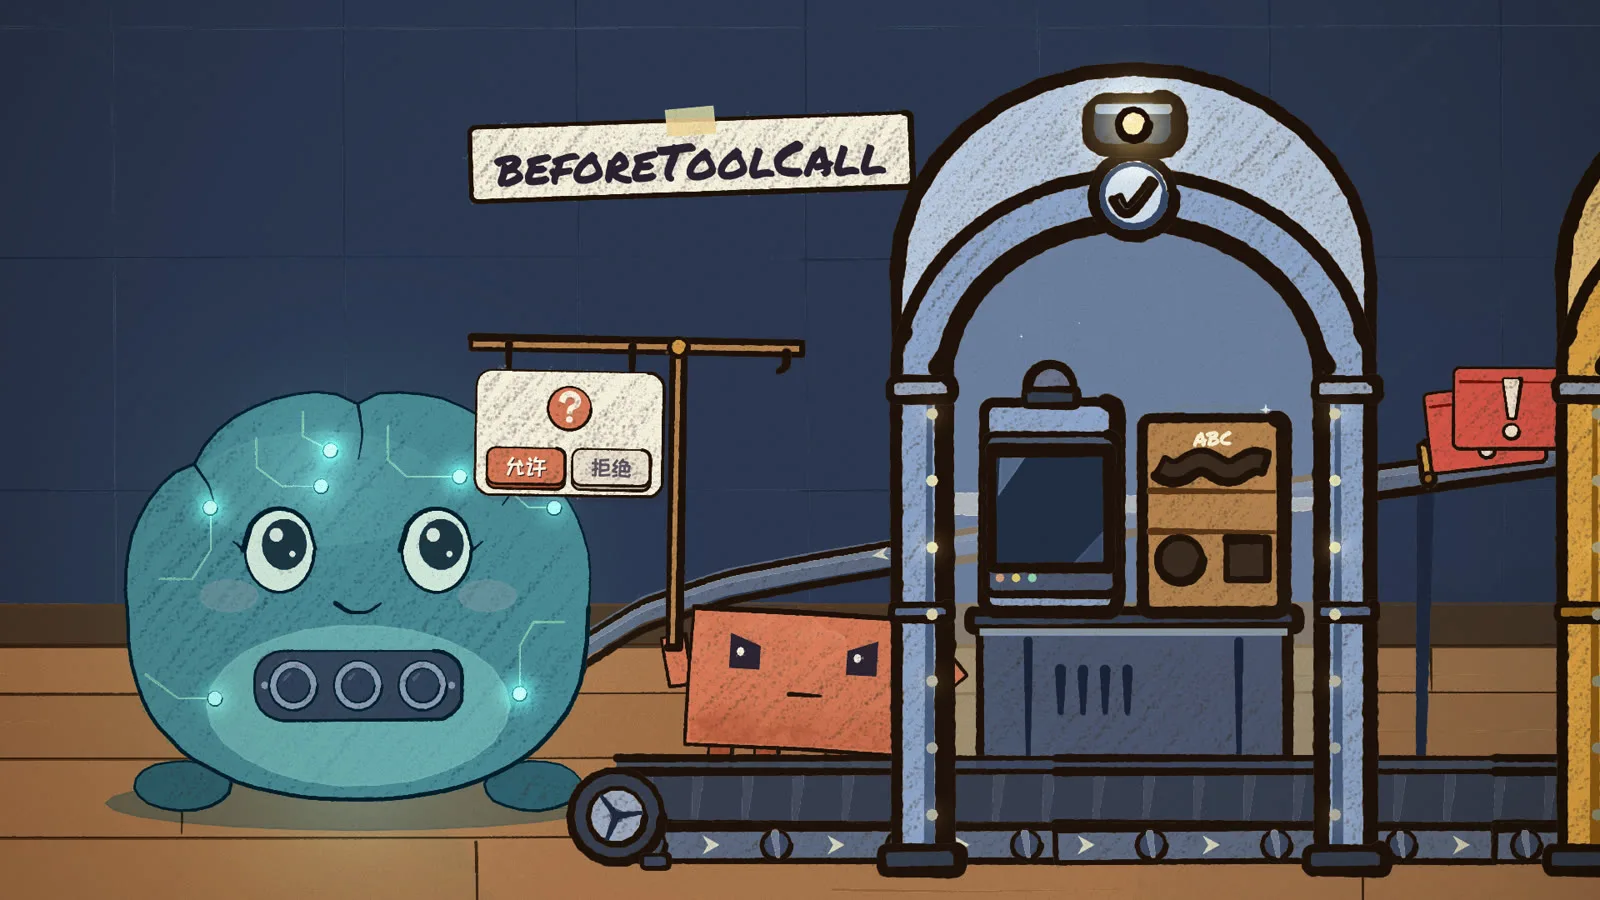
站岗的扩展,长这样
那开头那条 rm -rf 该在哪拦?就在 beforeToolCall 这一关。
pi 的终端版把扩展系统接在了这里,扩展监听 tool_call 事件,底下走的就是 beforeToolCall。仓库的示例目录里正好有一个现成的,叫 permission-gate,三十来行,核心是这些
// 摘自 pi v0.66.0 packages/coding-agent/examples/extensions/permission-gate.ts,有删减
const dangerousPatterns = [/\brm\s+(-rf?|--recursive)/i, /\bsudo\b/i, /\b(chmod|chown)\b.*777/i];

pi.on("tool_call", async (event, ctx) => {
  if (event.toolName !== "bash") return undefined;
  const command = event.input.command as string;
  if (!dangerousPatterns.some((p) => p.test(command))) return undefined;

  if (!ctx.hasUI) {
    return { block: true, reason: "Dangerous command blocked (no UI for confirmation)" };
  }
  const choice = await ctx.ui.select(`⚠️ Dangerous command:\n\n  ${command}\n\nAllow?`, ["Yes", "No"]);
  if (choice !== "Yes") return { block: true, reason: "Blocked by user" };
});
三条正则,rm -rf、sudo、777 权限。命中了,有界面就弹一个选择框问你,没界面的自动化场景就直接拦。被拦的理由会原样写进错误结果,模型能看到自己为什么被拒。
我挺喜欢这个设计取舍的。一个固定的弹窗策略,永远只适合一部分人。有人在容器里跑,巴不得全自动,有人在生产机上跑,恨不得每条命令都确认。pi 干脆不替你决定,把钩子留出来,示例给你,自己装。
第二关,执行,第三关,收尾
过了第一关,才真正开工。
执行这一关有两个细节。干得久的工具可以边干边报进度,界面上实时看得到。工具自己要是出了错,引擎也接得住,一样变成一张错误结果,循环接着转,不会因为一个工具挂了就整个停摆。
第三关叫 afterToolCall,工具跑完、结果交给模型之前,上层还能再过一遍目。可以记一笔审计日志,可以把结果里的密码涂掉,也可以把「没搜到」从错误改判成正常,免得模型以为自己犯了错。
它的改法很克制。类型定义里写着,合并是逐字段的,你只返回 content,就只换掉内容,details 和 isError 原样保留,不做深度合并。改哪一项,就只动哪一项。
如果模型一口气要了三个工具呢?pi 默认是并行模式,安排得挺讲究。三个调用先排队过第一关,一个一个检查,每道检查看到的顺序永远一样。过了安检的,一起开工,谁也不等谁。交结果时,开工的这几个再按原来的顺序排好,哪怕老三先干完,也得等老大。
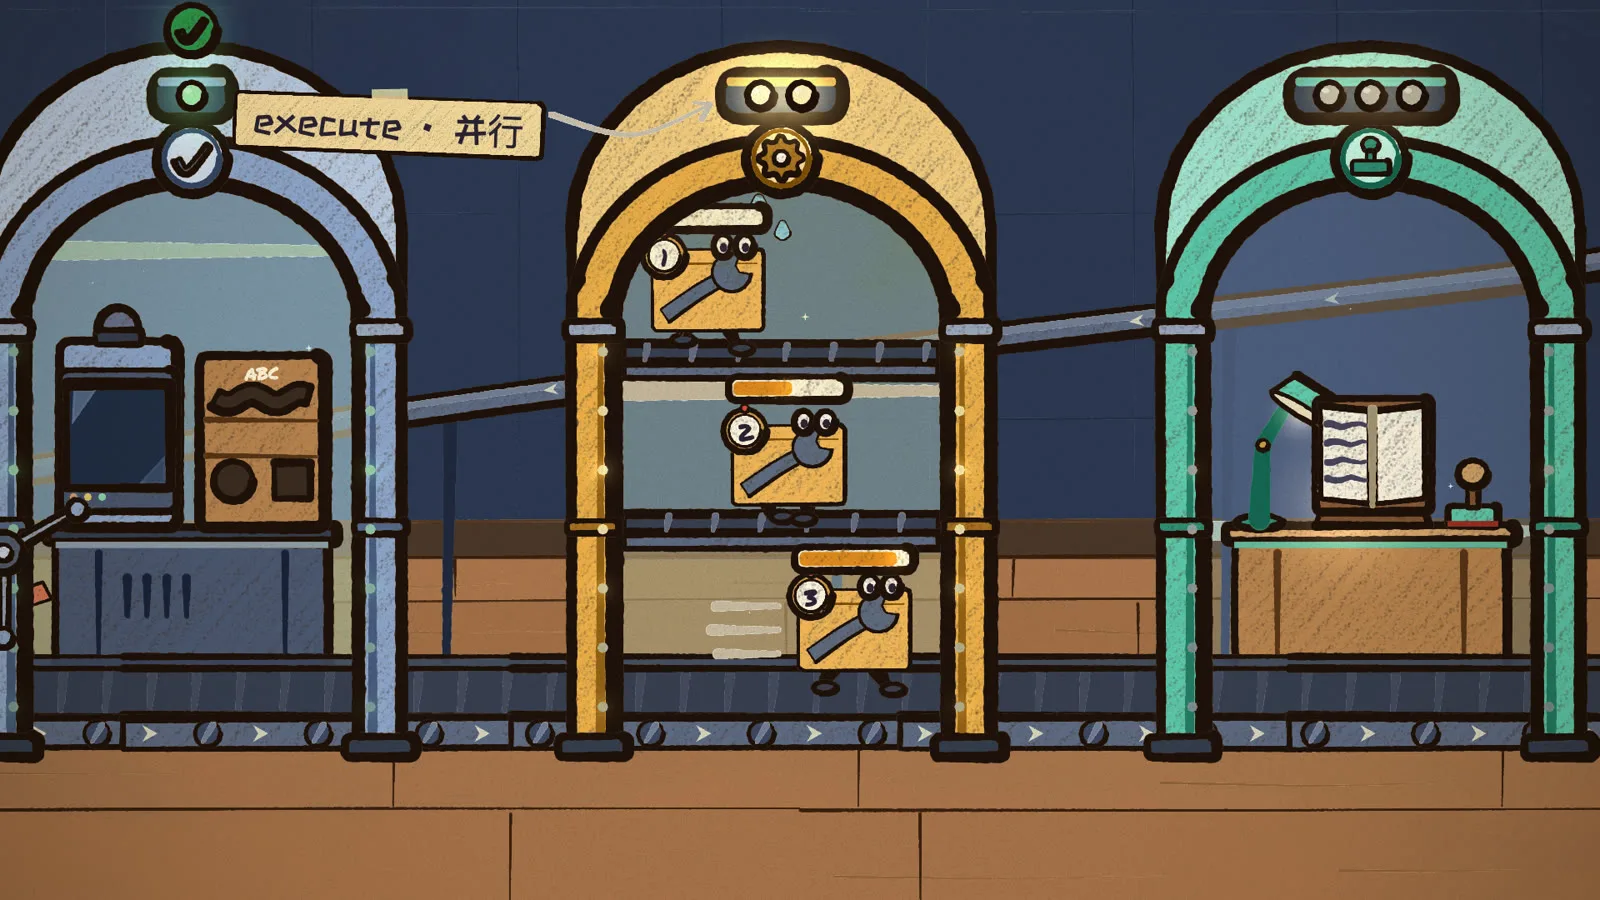
检查要确定,执行要快,结果要可预期。三件事拆开处理,就都照顾到了。嫌并行不放心,配置里把 toolExecution 设成 sequential,就老老实实一个接一个跑。
有了 bash,为什么还要六个工具
三道关管的是怎么调用。还有一个更早的问题,给模型哪些工具。
pi 一共内置七个工具,read、bash、edit、write、grep、find、ls。其中只有 bash 什么都能干,读文件、写文件、搜索、改代码,一行命令全能搞定。其余六个,每个只干一件事。
明明一个 bash 就够了,为什么还要另配六个?
理由很朴素。让模型填结构化的参数,比让它拼一行命令犯的错少得多。read 要的是路径、从第几行开始、读多少行,每一项都能校验,填错了当场在第一关退回,报错清清楚楚,下一轮就能改对。拼一条 bash,少配一个引号,报错含糊不清,可能要来回好几轮。
edit 最能说明问题。它不让模型重写整个文件,因为模型重抄一遍,可能漏掉一段、改乱缩进。它只做精确替换,把原文里的这一句,换成那一句。要换的原文必须在文件里只出现一次,找不到或者找到多处,都会明明白白地报错
// 摘自 pi v0.66.0 packages/coding-agent/src/core/tools/edit-diff.ts
`Could not find the exact text in ${path}. The old text must match exactly including all whitespace and newlines.`
`Found ${occurrences} occurrences of the text in ${path}. The text must be unique. Please provide more context to make it unique.`
这两句报错写得很用心,不光告诉模型错了,还告诉它怎么改,多给点上下文让它唯一。
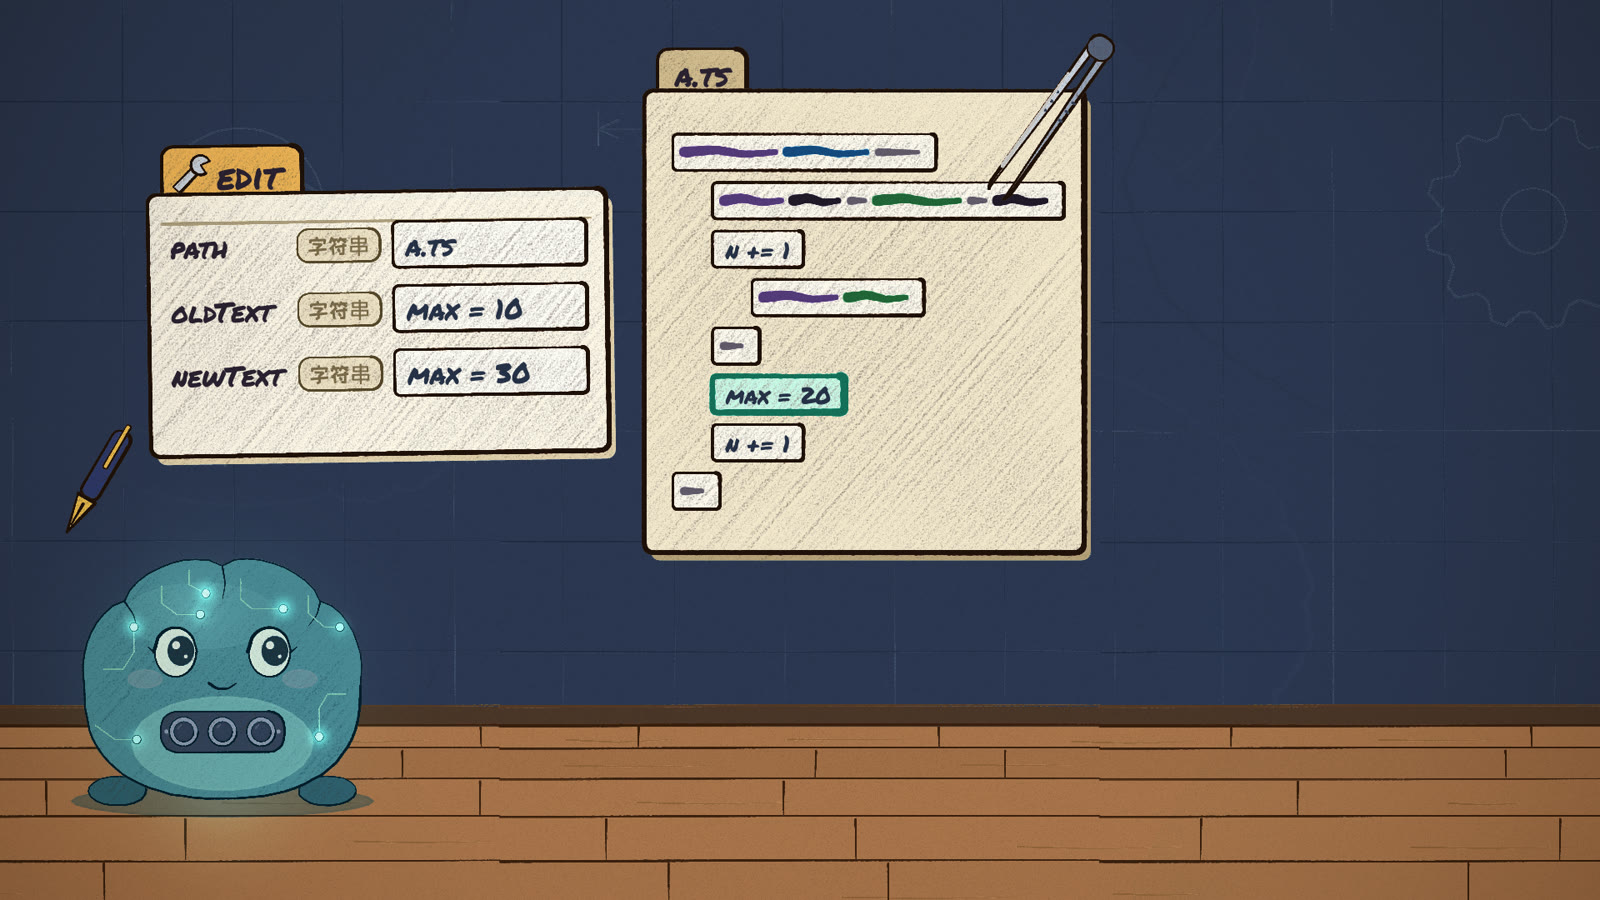
匹配之前,edit 还会先抹平一些小差异。行尾空格、中文排版里常见的弯引号、各种长短破折号、全角空格,统一成普通字符再比。模型抄原文时最容易在这些地方差一点点,抹平了就少白跑一轮。同一个文件的几次修改自动排队,不同的文件照样并行。
所有工具的输出还共用一把尺子,最多两千行或者 50KB,先到哪个算哪个,截掉的部分会告诉模型一共多少、还剩多少。find 默认最多给一千条结果,grep 默认一百条,每行最多五百个字符,文件名信息少,内容信息多。
bash 的截断正好反过来。read 留开头,bash 留结尾,因为命令的报错和结果都在最后。完整输出另存到一个临时文件,模型真需要,再用 read 去看。
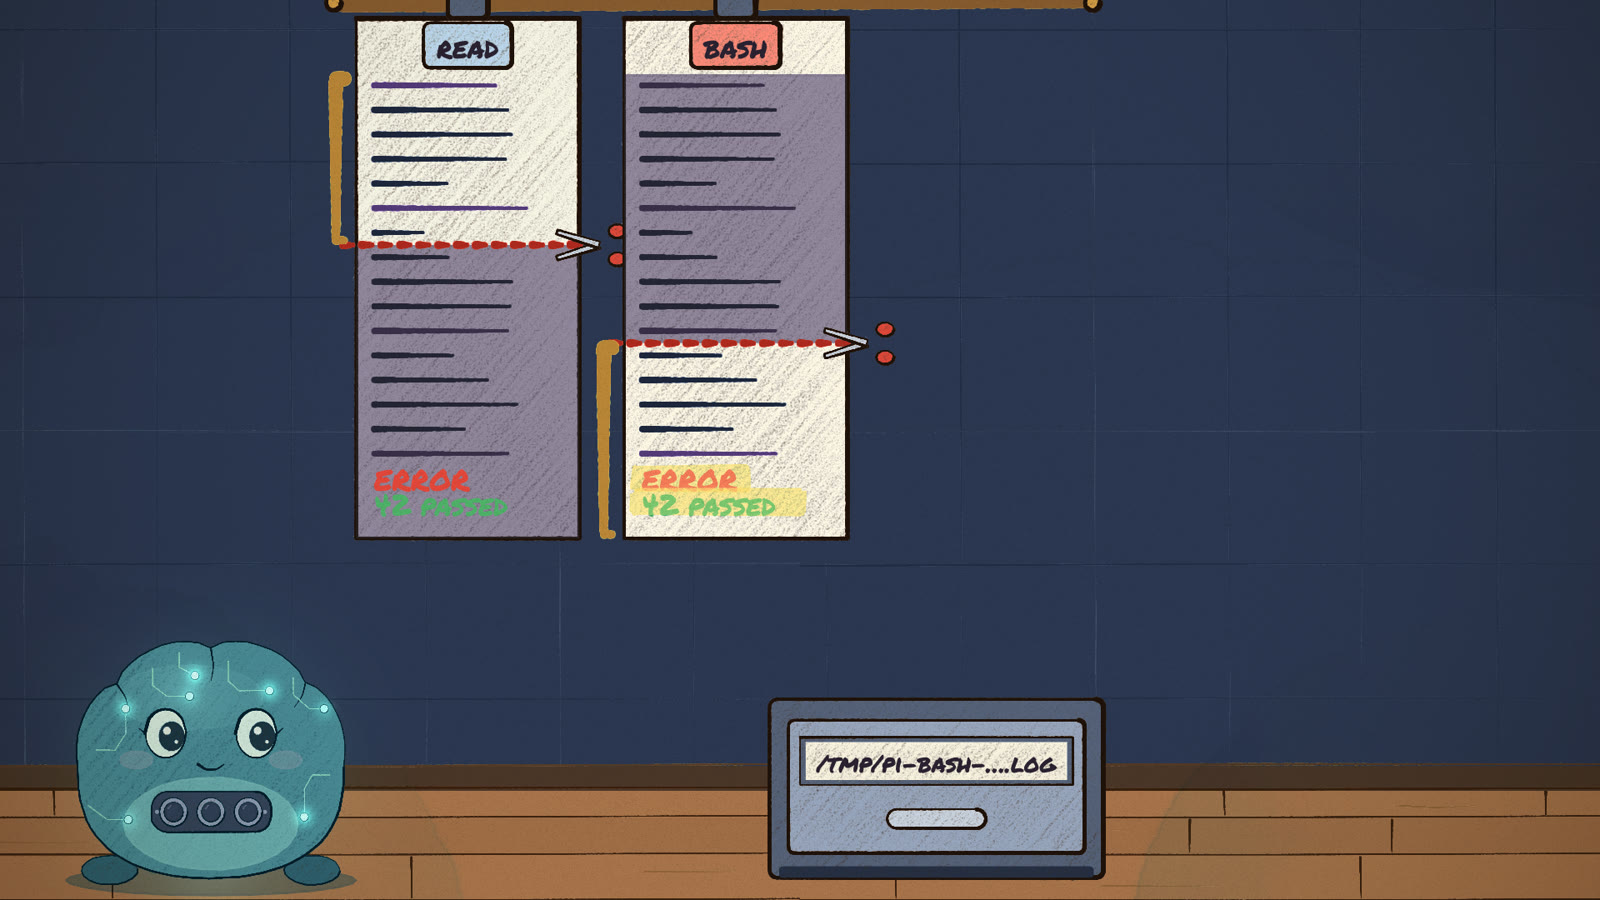
bash 的超时是可选的,默认不设。一旦设了、超时了,pi 会杀掉整棵进程树,不会留下孤儿进程在后台继续跑。
最稳的拦截,是一开始就不给
绕回开头那条 rm -rf。
pi 的 README 里有一个例子,我觉得比任何拦截规则都干脆
pi --tools read,grep,find,ls -p "Review the code"让它审代码,只给四个只读工具。bash、edit、write 都不在手里,它想删什么都删不了。
默认模式下,pi 开给模型的是 read、bash、edit、write 四个,grep、find、ls 要自己打开。只读的活,就只给只读的工具。工具少一个,能出的事就少一类。
当然有代价。工具多了,模型得学会挑,偶尔还会挑错。要搜被 gitignore 忽略的目录,find 和 grep 都会跳过,还得退回 bash。每多一个工具,每次请求都要多带一份工具说明,也要占 token。
换来的,是更少的出错,和更可控的 token。
我自己的感受是,这一篇拆下来,pi 对安全的态度挺一致的。它不假装替你兜住所有风险,不弹一个你迟早会无脑点确定的窗口。它做的是把每一次调用都拆成三道能插手的关,再把趁手又不容易出错的工具递到模型手里。站不站岗、站在哪,你自己决定。
下一篇拆会话。pi 的会话不是一条直线,是一棵树,随时可以分叉,也可以回到过去的任何一步。
你给编程 agent 开的是全自动,还是每条命令都要确认?
这个系列的内容,我还做成了一套彩铅动画,13 集,每集两三分钟,一集讲透一个设计决定。今天这篇对应第 6 集和第 11 集,三道关怎么过、六个工具各管什么,动起来看会更直观。
课程在 B 站课堂,预告和前两集可以免费看。
本文基于 pi v0.66.0 源码,新版本如有变化,以源码为准。讲解脉络参考了开源书《pi 的设计艺术》,想系统深入的推荐直接读原书。