
聊到一半从 Claude 换成 GPT,记忆怎么带过去?拆开 pi 的模型接入层
pi 用一块九十八行的插线板接了 23 家厂商、833 个模型,中途换模型时还会把上一位的思考过程、工具编号、半截调用一一洗干净再交接。附源码拆解,和一份接本地模型只要写 id 的配置。
在 pi 的内置模型清单里,Kimi 和 MiniMax 说的是 Anthropic 的话。
没写错。翻开 models.generated.ts,kimi-coding、minimax 这几家的模型,协议那一栏填的都是 anthropic-messages。GitHub Copilot 更离谱,一家厂商,清单里同时挂着三种协议。
看着有点荒诞,其实恰好是 pi 接模型的方式里最有意思的地方。
这是「Pi系列」的第六篇。前面几篇拆的都是 agent 自己怎么干活,今天往下挖一层,看它怎么跟各家模型打交道。主线就一个你大概率干过的动作,聊到一半,换个模型。
先把厂商和协议拆开
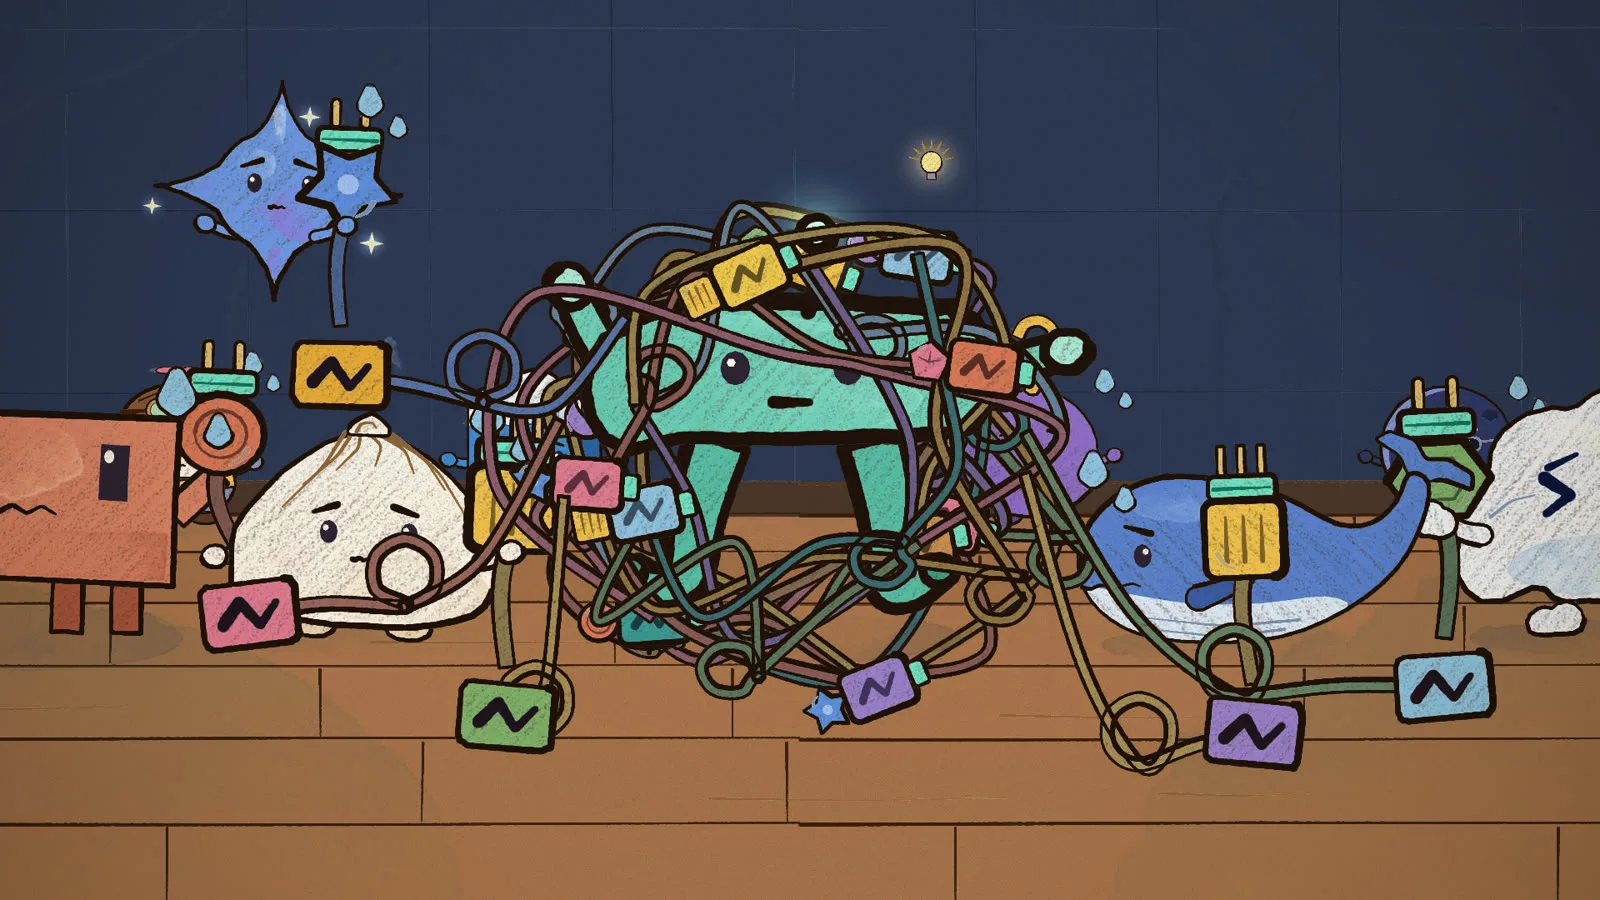
Claude、GPT、Gemini、Grok,接口各不相同。最直接的写法是每家写一个适配器,家数一多,代码就缠成一团乱麻。
pi 先分清了两个词,厂商和协议。
厂商是谁在卖模型,协议是请求和回答长什么样。这两样经常对不上。谷歌一家就有好几种协议,OpenAI 那套 chat completions 协议,Groq、xAI、OpenRouter、智谱都在说。v0.66.0 的内置清单里一共 23 家厂商、833 个模型,协议只有 10 种。
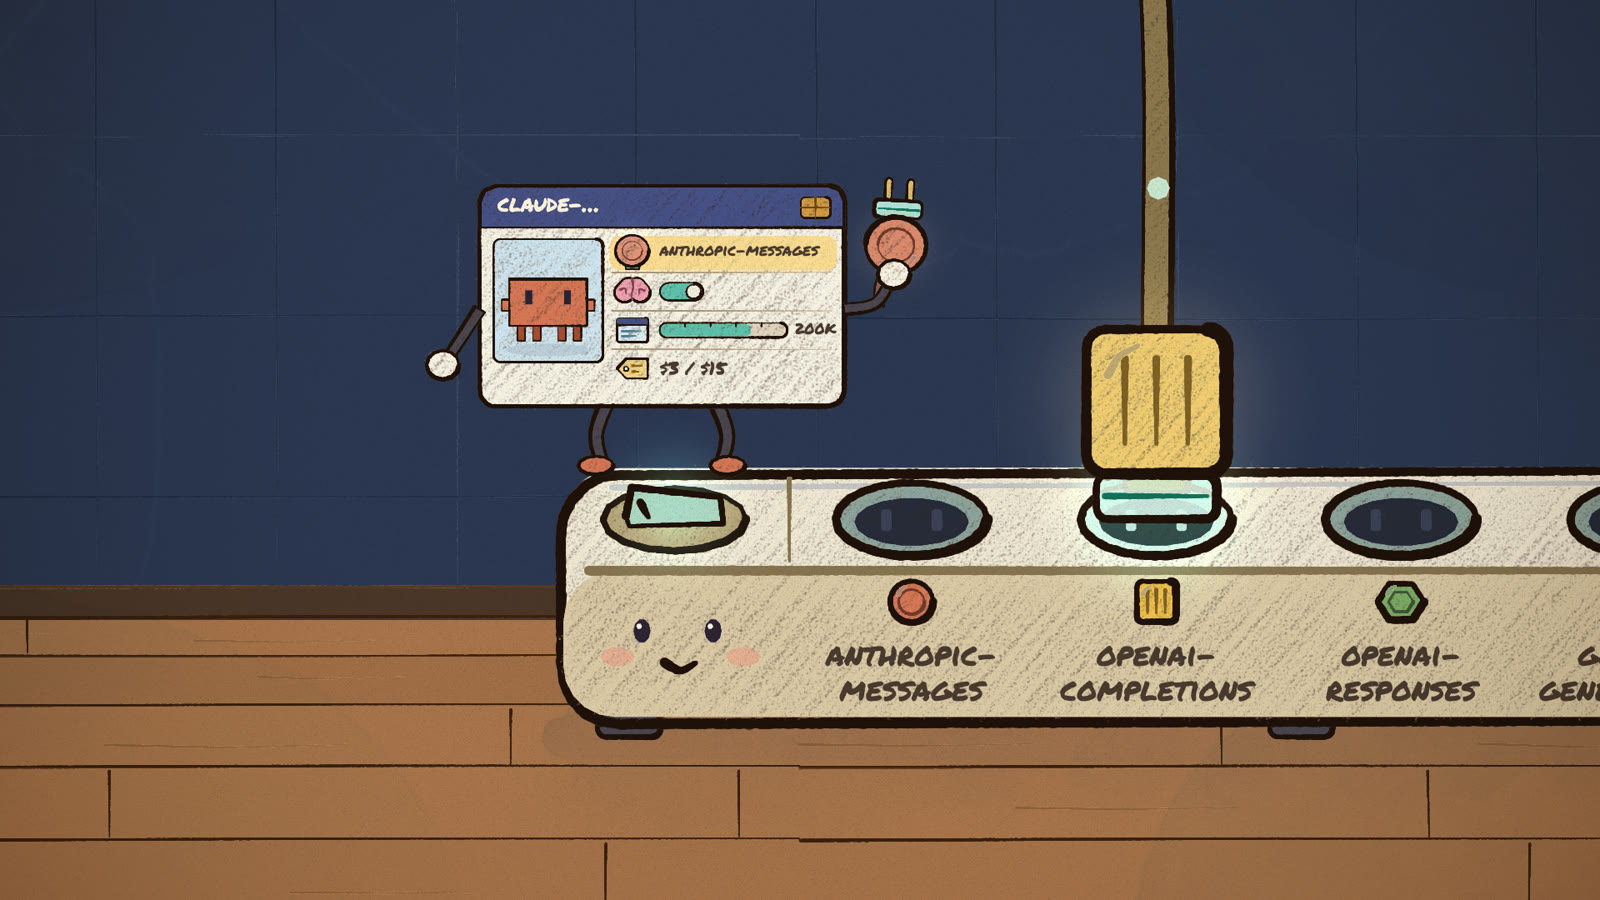
所以 pi 按协议登记,不按厂商登记。登记处叫 api-registry.ts,整个文件 98 行,核心是一个 Map,键是协议名。调用的时候,看模型身上写的是哪种协议,就去板上找那个插孔
// 摘自 pi v0.66.0 packages/ai/src/stream.ts,有删减
export function stream(model, context, options) {
  const provider = getApiProvider(model.api);   // 按协议找插孔,不按厂商
  if (!provider) throw new Error(`No API provider registered for api: ${model.api}`);
  return provider.stream(model, context, options);
}
每种协议只交两个函数,一个完整版 stream,一个参数统一过的简化版 streamSimple。新来一家厂商,只要协议兼容,一行协议代码都不用写,模型清单里多一张卡就行。
Kimi 说 Anthropic 的话,就是这么来的。GitHub Copilot 挂三种协议也不奇怪,它背后同时转卖好几家的模型,Claude 走 Anthropic 那套,GPT 走 OpenAI 那套,一家厂商,三个插头,插线板照单全收。
插孔也不是一开机就全通电。每种协议的实现代码,要等第一次被用到时才加载。加载失败也不会把程序带崩,而是回一条带错误信息的回答
// 摘自 packages/ai/src/providers/register-builtins.ts,有删减
loadModule()
  .then((module) => forwardStream(outer, module.stream(model, context, options)))
  .catch((error) => {
    const message = createLazyLoadErrorMessage(model, error);  // stopReason 标成 error
    outer.push({ type: "error", reason: "error", error: message });
    outer.end(message);
  });
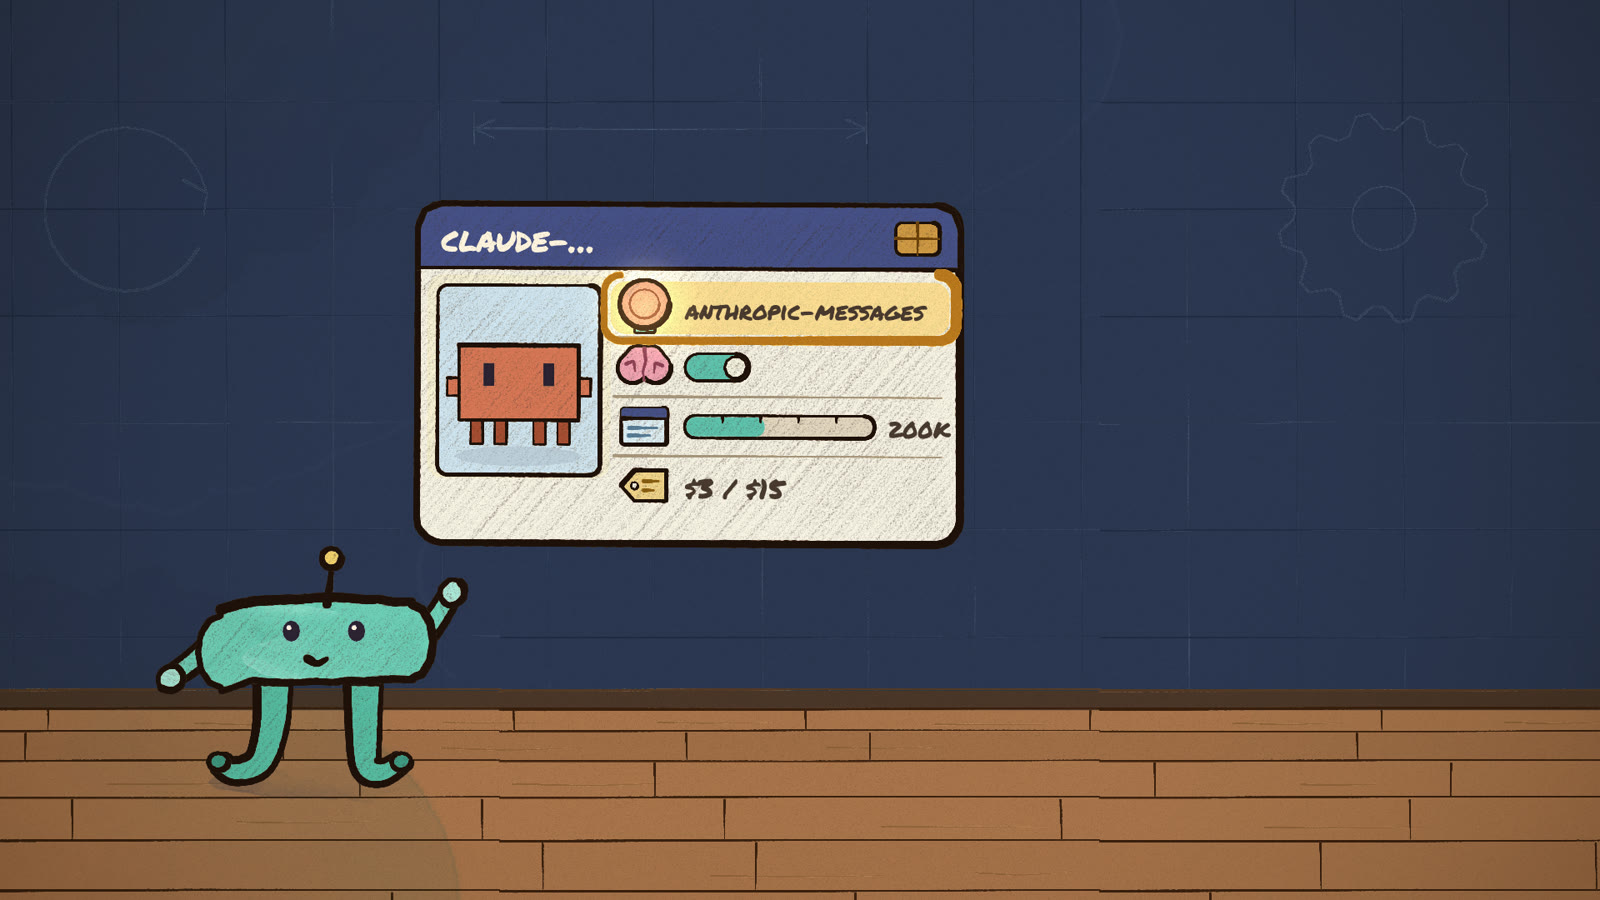
模型本身在 pi 里也不只是一个名字,更像一张身份卡。哪家的、说哪种协议、会不会深度思考、上下文多大、每百万 token 怎么计价,全写在卡上。内置那 833 张卡是发版时脚本自动抓取生成的,断网也能列出来。
想接自己的模型,比如本地的 Ollama,在 ~/.pi/agent/models.json 里写几行,每个模型最少只要一个 id
{
  "providers": {
    "ollama": {
      "baseUrl": "http://localhost:11434/v1",
      "api": "openai-completions",
      "apiKey": "ollama",
      "models": [{ "id": "qwen2.5-coder:7b" }]
    }
  }
}
这个文件每次打开 /model 选模型时都会重新读,改完不用重启。
还有一件小事,处理得很细。现在不少人是用订阅账号登录的,Claude 的、Copilot 的、ChatGPT 的,拿到的是会过期的令牌。一个编程任务跑个几十分钟很正常,令牌中途过期了怎么办?
pi 的做法是每次调模型之前,都现取一次密钥。第一篇那个 78 行的循环,每轮发请求前会调用 getApiKey,源码注释里专门写了一句 important for expiring tokens。快过期的令牌在这一步就换成新的,循环本身完全感觉不到。
放在最底层做,上面的人就不用操心。你在终端里看到的,只是 agent 一直在干活,不会某一轮突然弹出一个登录失效。
换模型,最难的是记忆
插孔接上只解决了一半。真正麻烦的是,你和 Claude 已经聊了五十轮,现在切到 GPT,这五十轮能直接递过去吗?
不能照搬。每家模型的回答里,都夹着只有自己看得懂的东西。
pi 在交接之前,先问一句,是不是同一个模型
// 摘自 packages/ai/src/providers/transform-messages.ts,有删减
const isSameModel =
  assistantMsg.provider === model.provider &&
  assistantMsg.api === model.api &&
  assistantMsg.model === model.id;

if (block.type === "thinking") {
  if (block.redacted) return isSameModel ? block : [];         // 加密的思考,换人就丢
  if (isSameModel && block.thinkingSignature) return block;
  if (!block.thinking || block.thinking.trim() === "") return []; // 空白的思考,丢
  if (isSameModel) return block;
  return { type: "text", text: block.thinking };               // 换人,降级成普通文字
}
厂商、协议、型号,三样全对上才算同一个。同一个就原样保留,换了人就降级处理。
最麻烦的是思考过程,也就是模型回答前那段推理。被安全过滤、加了密的思考,只有原模型解得开,换人时直接丢掉。空白的,也丢掉。正常写了字的,降级成一段普通文字。字还在,只是新模型不知道那是上一位的心里话。
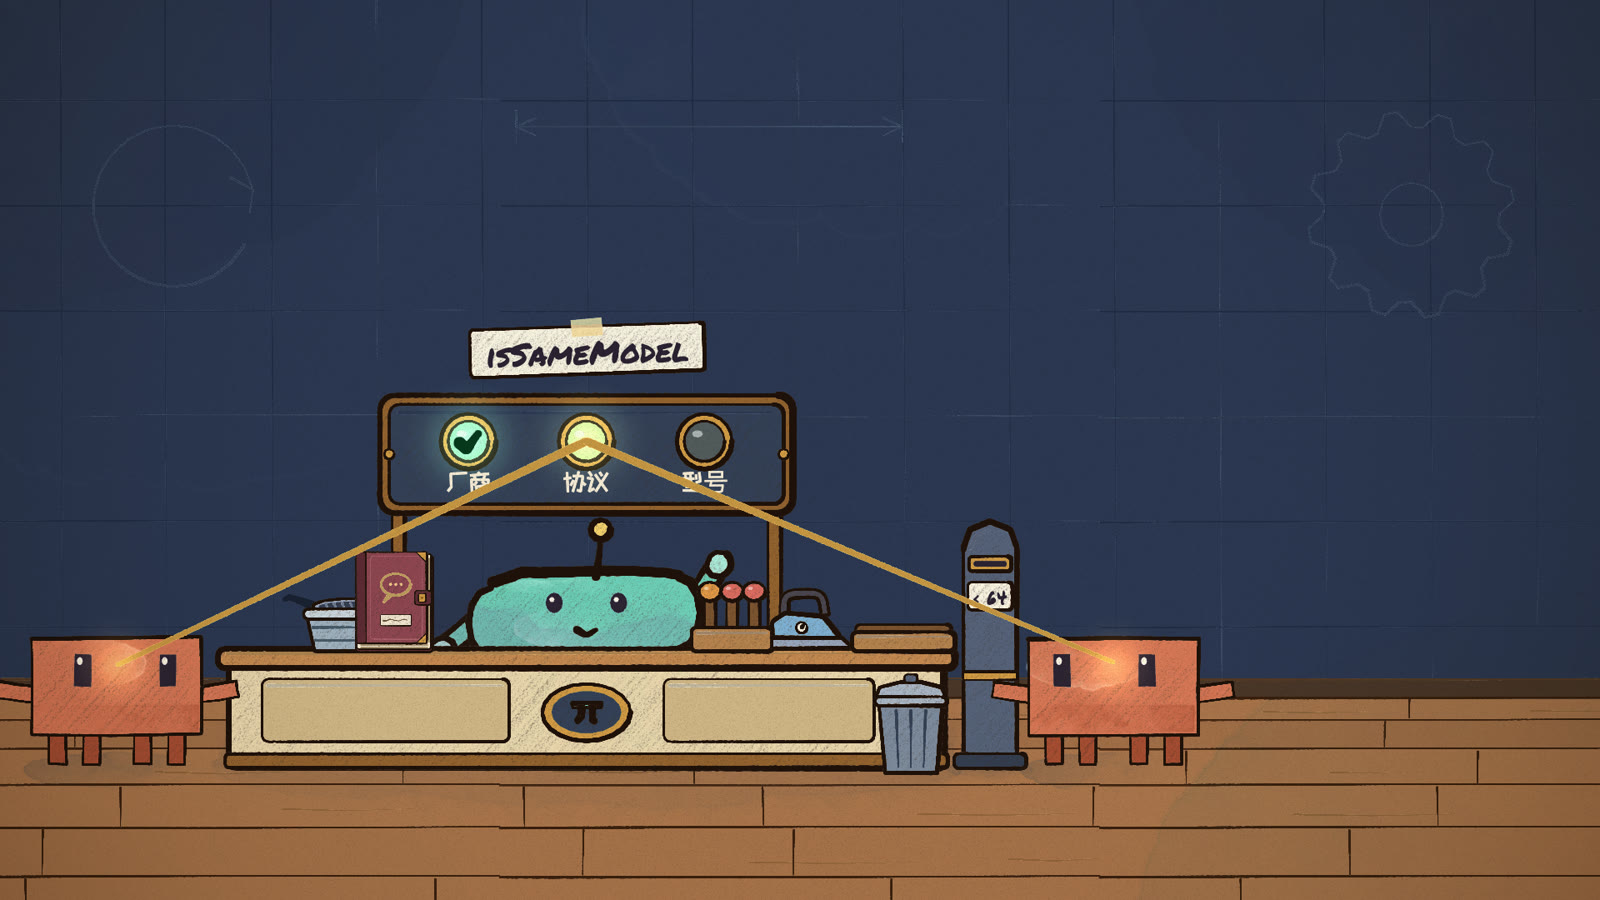
工具调用的编号更头疼。源码注释里写得很清楚,OpenAI Responses 接口生成的编号能有 450 多个字符,还带竖线这种特殊符号,Anthropic 的接口只收 64 个字符以内、只含字母数字下划线横线的编号。
pi 的处理是把编号改短,同时记一张新旧对照表,后面对应的工具结果跟着改名。调用和结果一对都不能错,错一对,下一家模型就会报错拒收。
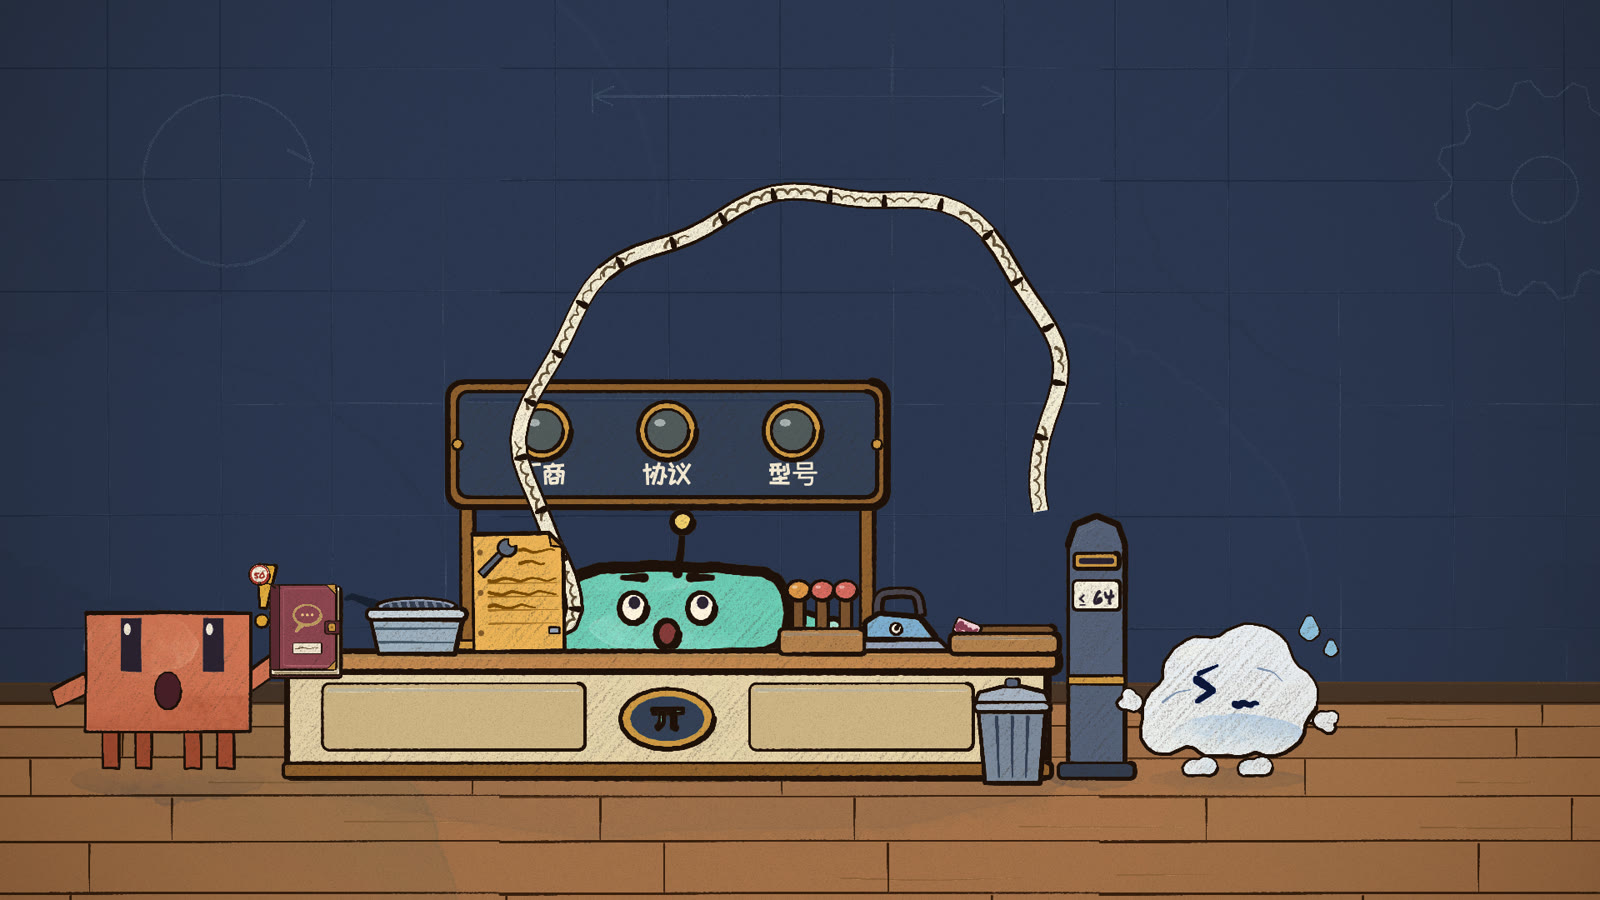
还有断了头的情况。模型发起了工具调用,你中途按了停止,结果没回来。这种残缺记录,下一家模型会直接拒收。pi 就补一条结果,内容写 No result provided,并且标成出错,让模型知道这事不可靠。本身就出错或被中止的半截回答,干脆跳过,不再重放。
好家伙,交接一次,要洗这么多遍。
丢掉的是各家的私有标记,留下的是谁问了什么、做了什么、结果如何。有损,但安全。
为什么连后台任务都返回事件流
最后一件事,藏在前面所有代码里。你会发现,不管是 stream 还是加载失败时的兜底,交回去的都是一条流,而不是一个结果。
调模型最简单的写法是发过去,等着,拿回一整段文字。pi 从最底层起就不这么干,哪怕是后台任务、不需要显示,也返回事件流。
一次回答被拆成一串事件。先是一张开始卡,然后思考、正文、工具调用各自有开始、一段段增量和结束,最后一张终结卡。终结卡分两种,正常结束的写明是说完了、写到长度上限了,还是要调工具,出了错的写明是失败还是被中止。
这套约定写在类型定义的注释里
// 摘自 packages/ai/src/types.ts
// Contract:
// - Must return an AssistantMessageEventStream.
// - Once invoked, request/model/runtime failures should be encoded in the
//   returned stream, not thrown.
// - Error termination must produce an AssistantMessage with stopReason
//   "error" or "aborted" and errorMessage, emitted via the stream protocol.
三条规矩。必须返回流。一旦开始,出了任何错都写进流里,不往外抛,网络超时、被限流,都只是流里的一张卡。就算失败,最后也要交出一条完整的回答,只是停止原因写着出错。
所以调用的人不用写两套处理,成功和失败走同一条路。第一篇里那个 78 行的循环,只检查一下 stopReason 是不是 error,就知道该不该停,靠的就是这条约定。
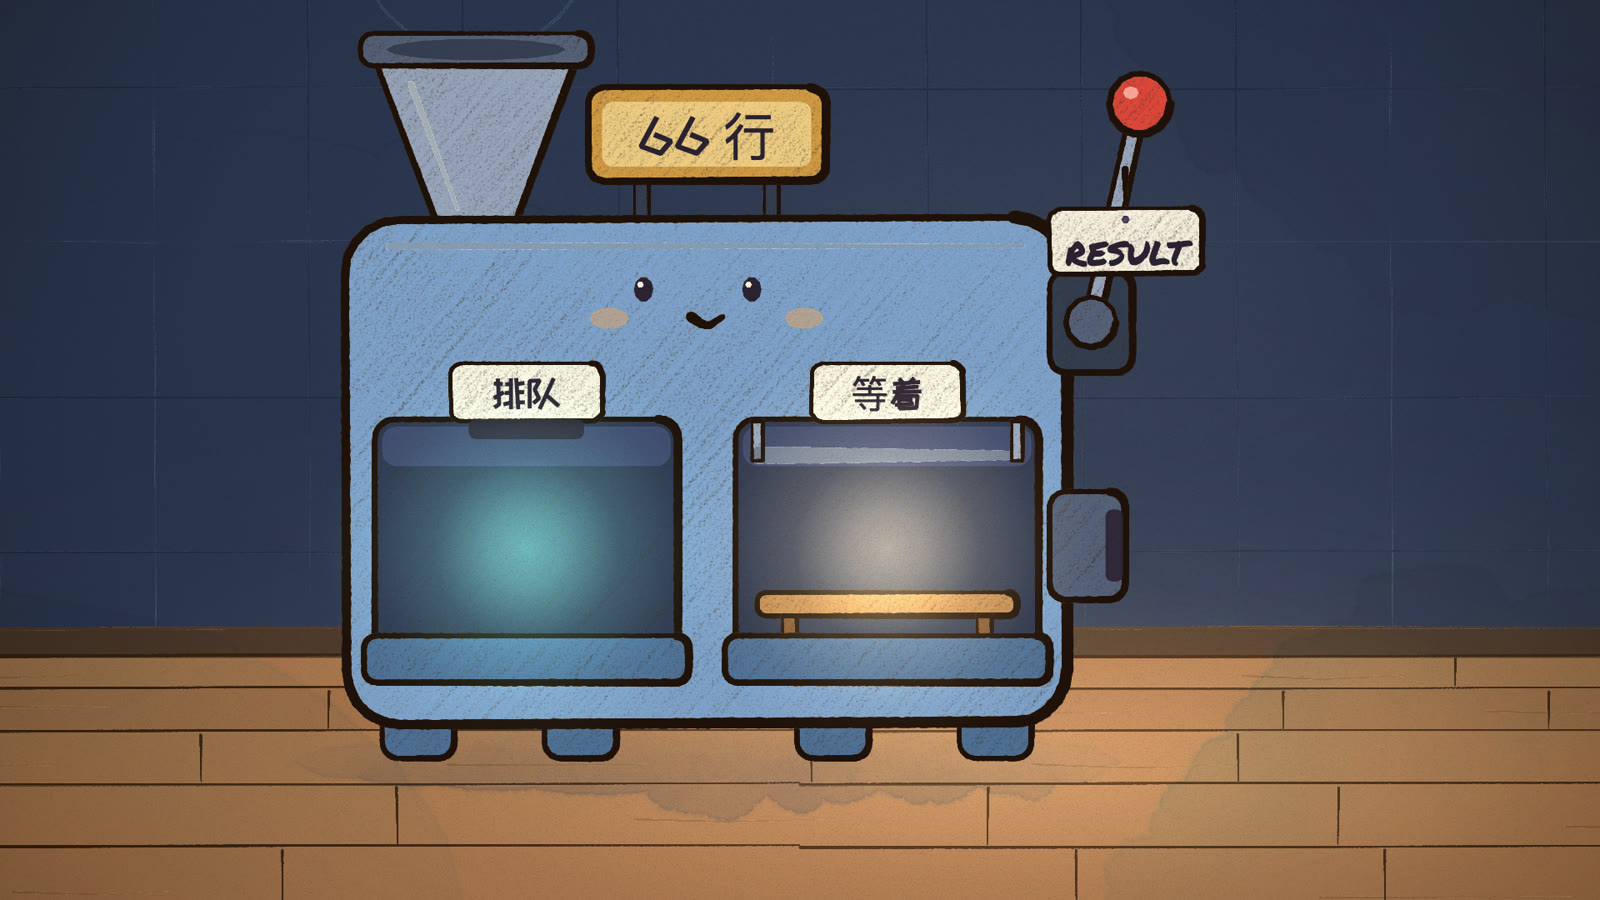
流背后的机器很小,EventStream 这个类六十来行,两个队列。事件先到,就排队,消费的人先到,就等着。只想要结果的,调一下 result() 就拿到最终回答,想看过程的,一张张接着看。
代价也有。每个消费的人都得看懂这套事件协议,每家协议的实现都得守住不抛错的约定,写一个新协议要比写一个普通的 HTTP 调用费劲不少。
换来的是,录下事件就能回放整个会话,界面、存档、循环各取所需,互不打扰。
回到那两家说 Anthropic 话的模型
《圣经》里有个巴别塔的故事,人们说的话被打乱,塔就盖不下去了。模型圈现在有点像那座塔,每家都有自己的方言。
pi 没去统一方言,它做的事更朴素。把厂商和协议拆开,新来的只要会说某种已有的话,就能直接插上。实在要换人,就把上一位的私有标记洗掉,把能说清楚的事实交过去。
核心不变,边缘生长。Kimi 说 Anthropic 的话,在 pi 里一点都不奇怪。
下一篇拆扩展和 Skill。pi 的核心这么克制,那些它不做的功能,是怎么从外面长进产品里的。
你平时会在一个任务中途换模型吗?换完之后,它有没有忘掉前面的事?
这个系列的内容,我还做成了一套彩铅动画,13 集,每集两三分钟,一集讲透一个设计决定。今天这篇对应第 2、3、4 集,其中第 2 集是免费集,插线板怎么开孔、交接怎么洗记录,动起来看会更直观。
课程在 B 站课堂,预告和前两集可以免费看。
本文基于 pi v0.66.0 源码,新版本如有变化,以源码为准。讲解脉络参考了开源书《pi 的设计艺术》,想系统深入的推荐直接读原书。