
写代码的模型费降一半,GPT‑6 真正要换的是分流
GPT‑6 Sol 和 Luna 把 API 价格又往下拉了一截。对写代码和跑 Agent 的团队,更值得动手的不是立刻全员切换,而是把任务、验收和缓存重新排进同一条路由。
一段代码要不要交给最贵的模型,最近突然成了一道很贵的选择题。
9 月 22 日,OpenAI 发布了 GPT‑6 Sol 和 GPT‑6 Luna。Sol 的标准 API 价格是每百万 token 输入 2 美元、输出 10 美元。Luna 则是输入 0.1 美元、输出 0.5 美元。两档都比 GPT‑5.6 的促销价低了 50%。
好家伙,价格表看着像在催人立刻把默认模型改掉。
但模型升级最容易踩的坑,也正是在这里。团队只看单价,干脆把所有代码任务、所有长上下文、所有失败重试都塞进同一个新型号。月底再回头看,钱也没少花多少,偶发回归还多了一层。因为真正吞预算的,从来不只是那一行输入单价,还有任务配错模型、缓存反复失效、失败后无止境重跑。
这次更新值得看的,不是「又多了两个名字」,而是模型分工终于更清楚了。OpenAI 自己仍把 GPT‑6 Astra 放在能力上限的位置。Sol 和 Luna 负责把同一代训练方法做得更快、更便宜,分别落在主力执行和高频走量的位置。对日常写代码的人,这比排行榜上的一两个分数更实在。
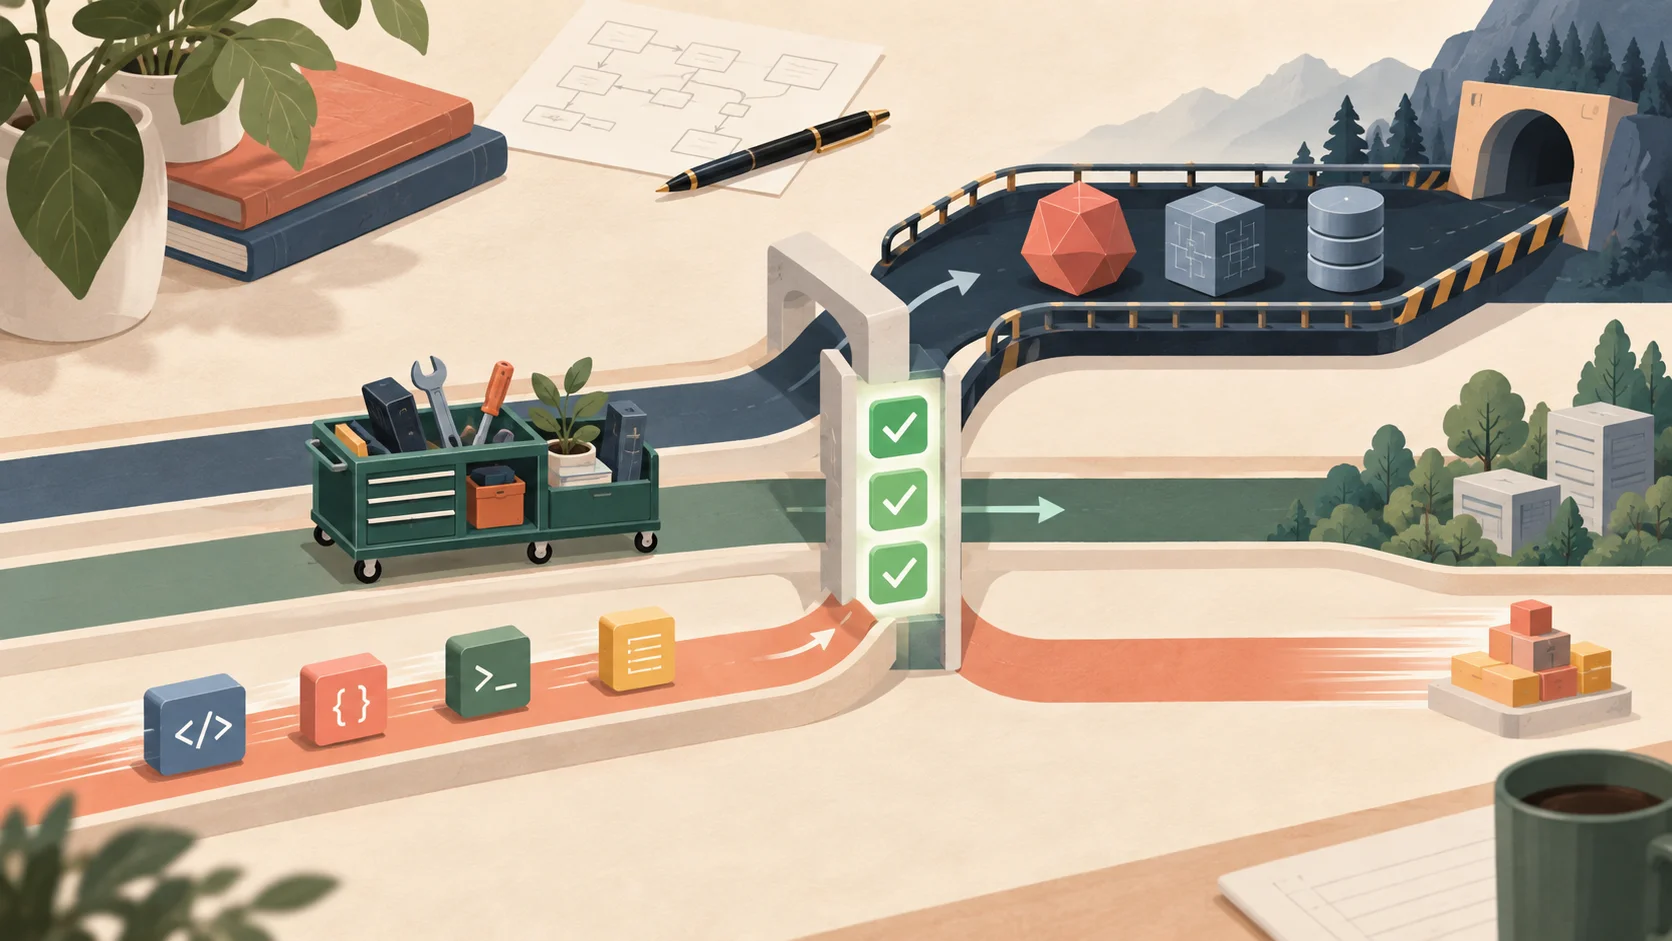
图:一条更适合日常 Agent 的模型分流思路。图示是工程建议,不是官方架构图。
便宜,不等于全员默认
先说结论。不要因为 Luna 便宜,就把它当成所有 Agent 的终点。也不要因为 Astra 最强,就让它去处理每一条字段提取和每一个格式转换。
模型应该跟任务的失败代价走,不该跟发布会的热度走。
Luna 适合边界比较清楚、量又很大的活。比如把一堆工单归类,从固定格式的文档里提字段,把代码库里明显重复的注释整理成候选,或者给一批小改动做第一轮草稿。它便宜到每百万输入 token 0.1 美元,公开文档也把它定位成高吞吐的聚焦任务模型。可便宜的前提是,你得能很快验收它。
一段生成的 SQL 能不能跑,一份结构化 JSON 是否过 schema,一次小改动有没有通过已有测试,这些都有明确答案。可以交给 Luna 先跑。它错了,路由就该把任务升级,而不是让它在同一条坏路上多试五次。
Sol 更像主力开发位。OpenAI 公告里给它的重点是复杂工作、编码和计算机使用。官方还列了 DeepSWE、FrontierCode 这些评测成绩,不过这些数字仍属于厂商公告,不是我们自己的生产结论。把 Sol 放在需要读懂仓库约束、改多个文件、需要几轮工具调用的任务上,比较符合它的成本位置。
Astra 则应该留给失败后仍值得救、上下文很长、或者错误代价特别高的任务。比如一次会改动权限、支付、数据迁移逻辑的重构。贵模型不是身份象征,它更像升级通道。只有当低一档模型的结果过不了验收,或者任务本身就没有低风险试错空间,才值得把它叫出来。
厉害了,模型路由听起来像是一个大平台才需要的东西。其实一份很小的配置就能先把讨论落地。
routes:
  high_volume_and_verifiable: gpt-6-luna
  multi_file_implementation: gpt-6-sol
  hard_or_high_risk_escalation: gpt-6-astra

gates:
  - schema_validation
  - tests_pass
  - human_review_for_sensitive_changes
这里最重要的不是型号名字,而是 gates。没有验证闸门的分流,只是在用低价模型把不确定性批发出去。很多人说 Agent 省钱,结果把省下来的 token 花在修回归上,多少有点子牛逼,也多少有点像把 CI 当许愿池。
真正的折扣,藏在缓存有没有活着
这次发布同时上线了新的 GPT‑6 提示词缓存能力。官方说明里,30 分钟窗口内重复的合格共享前缀,缓存输入最高可享 90% 折扣。Sol 的缓存输入价格是每百万 token 0.2 美元,Luna 是 0.01 美元。
这个数字比单纯降价更容易被忽略。
一个能持续工作几小时的 Agent,往往每一轮都带着同一份系统说明、同一组工具 schema、同一个仓库摘要和前几轮的上下文。如果这些东西每次都被重新计算,模型再便宜也会被长提示词拖住。反过来,稳定的前缀能复用,模型切换带来的账单变化才会真正落到实处。
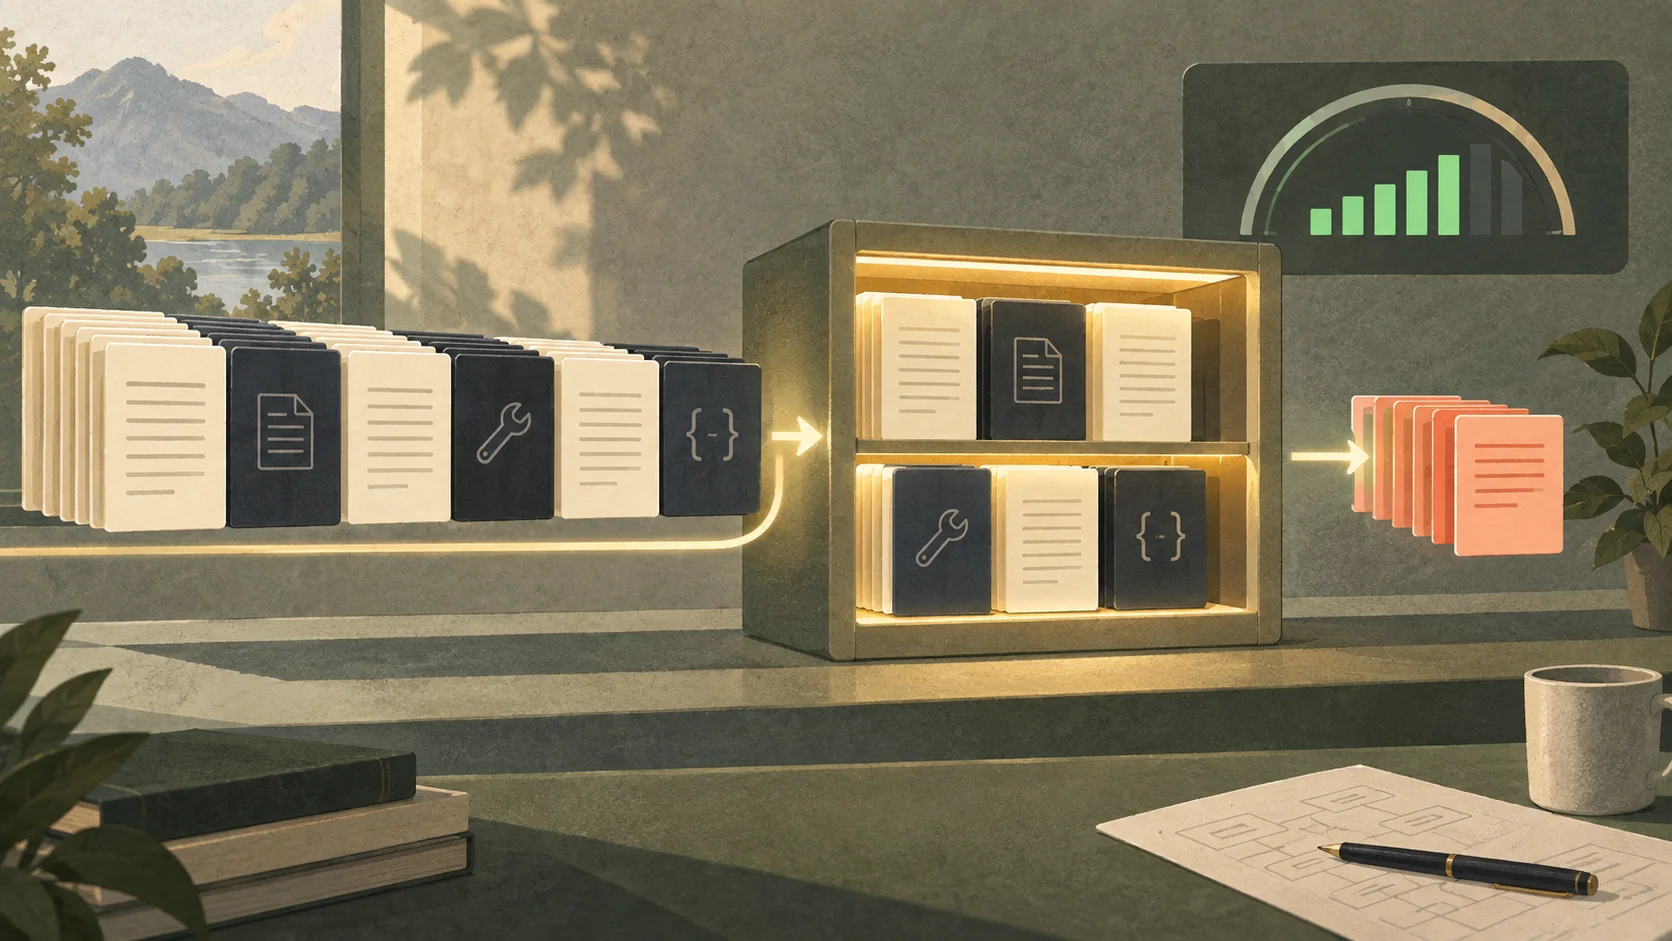
图:缓存友好的上下文摆放。稳定内容靠前,频繁变化的任务信息尽量靠后。
OpenAI 这次给的工程建议很具体。工具定义、参数 schema 和工具排序尽量稳定。需要临时收窄能力时,用允许调用的工具列表控制,而不是把整组定义删掉。新指令尽量追加在上下文末尾,别每轮都重写开头那份系统提示。
以前很多 Agent 的 prompt 像搬家。今天加一个工具,明天换一下顺序,后天把安全说明挪到最前面。功能看着没问题,缓存却悄悄从后门溜走了。现在官方还提供了缓存仪表盘和未命中诊断,能看见究竟是模型、工具、设置还是输入变动让复用断掉。
这很土,但很有用。先把缓存命中率当成一个要看的指标,再谈换模型能省多少。不是每个团队都要做复杂的优化,至少得知道那 50% 的价格下降有没有被自己的上下文结构吃掉。
切换前,留一条能回来的路
新模型刚上线时,最稳妥的做法不是一次性替换,而是选一类能验收的任务做影子对照。让新模型处理同一批低风险请求,记录通过率、重试次数、平均 token、缓存命中和人工返工量。五个指标已经够用。
如果 Luna 在字段提取上通过率没有掉,成本更低,那就扩大它的份额。如果 Sol 的多文件改动测试通过率更高,或者它减少了重试,就把主力任务移过去。要是结果反过来,也没什么丢人的。模型换代不是入教仪式,路由改回来就行。
OpenAI 公告还提到,GPT‑6 Sol 和 Luna 已经可以在 Codex、ChatGPT Work 和 API 里使用。订阅端看到新选项,不代表 API 侧的自动化就已经适合全量切换。手动写一个页面和让 Agent 连跑两百个任务,消耗的不是同一种预算,也承担不了同一种失误。
所以这波更新给日常开发最直接的动作,我觉得不是把「GPT‑6」写进系统提示里,而是把任务分成三类。高频且可验证的,给 Luna。需要读仓库和做实现的,给 Sol。真正难、真正贵、真正不能乱来的,再升级给 Astra。每一层都留测试、schema 或人工复核作为出口。
模型的单价还会继续往下掉。可团队是不是会因此跑得更快,取决于你有没有把便宜的算力放到适合它的位置。
你们团队现在的默认模型,是按任务难度分的,还是谁最新就先上谁?