
AI 写得越来越快,CI 成了最贵的限速器
测试快翻四倍,Linear 反而把单测试 runner 时间砍到约一半。答案不是盲目加机器,而是先把关键路径和固定 setup 成本从流水线里挖出来。
一支编码 Agent 把 PR 推上去,接着它就站在 CI 队列前等结果。人也在等。最后一起盯着一个绿点亮不亮。
这画面现在太常见了。代码出来得像复印,验证却还保留着人类工程时代的速度。你给 Agent 再开一个并发,它不会替你腾出 runner,不会缩短 checkout,也不会让那几个最慢的测试文件突然懂事。
Linear 昨天放出了一篇很实在的工程复盘。测试套件接近翻四倍 后,他们把 PR 等待时间从超过 6 分钟压到略高于 5 分钟,单个测试消耗的 runner 时间大致减半。
五分钟听起来并不传奇。可别急着嫌少。
如果测试规模快翻了四倍,CI 没有被拖到 10 分钟以上,本身就是一场把洪水引进水渠的活。Linear 给出的答案也挺有意思,他们没有把故事写成买更大机器、加更多分片、缓存一切。真正的顺序刚好相反,先挖掉关键路径上那些没有产出验证价值的固定成本,再去谈并行。
这比又一篇「AI 让 CI 成为瓶颈」有用得多。因为多数团队此刻的问题并不是不知道 CI 慢,而是不知道下一笔钱该投到 runner、缓存、测试还是人。
先别盯总耗时,先盯谁把后面的人堵住了
CI 很容易给人一种错觉。页面上几十个 job 一起跑,哪里红得久就优化哪里。可开发者真正感受到的是合并路径,不是仪表盘上所有格子的平均数。
Linear 的 API 测试有八个 shard。它们启动前得先经过变更检测,判断这次 diff 碰没碰数据库迁移,也得确认相同输入的测试是不是跑过。任务本身不大,却被放在所有测试前面。一个小门卫,后面排着八辆大卡车。
他们把最慢的 gate 从 94 秒压到 20 秒。根本不需要工作树的任务,直接取消 checkout,从 27 秒到 7 秒。变更检测 job 的中位数由 26 秒变成 8 秒,p90 从 31 秒变成 12 秒。
这部分特别值得抄,不是数字,而是提问方式。
当 CI 慢下来时,先画出真正的依赖图。哪些 job 的完成会放行一整排测试,哪些 job 只是结果晚一点也没人受伤。前者是一厘米就能堵一公里的关键路径,后者再慢也不该抢第一笔优化预算。
很多团队一看测试慢,就给测试再切几刀。切完 runner 数涨了,账单也涨了,队列有时还更抖。因为你把更多人送到了同一个入口,入口本身还是那扇门。好家伙,排队系统做成了并发系统。
Linear 还发现一些 cache marker 写入放在合并前最后一道检查里。测试已经通过,PR 还得等它落盘。他们把这件事移到一个不阻塞任何人的 job 后面,每个 API PR 和 merge queue 条目少等 42 秒。
42 秒看着像边角料。放在每天一堆 PR、每次 Agent 都要拿结果继续改的节奏里,它就不是边角料了。它是反馈回路里一段被白白占住的空白。
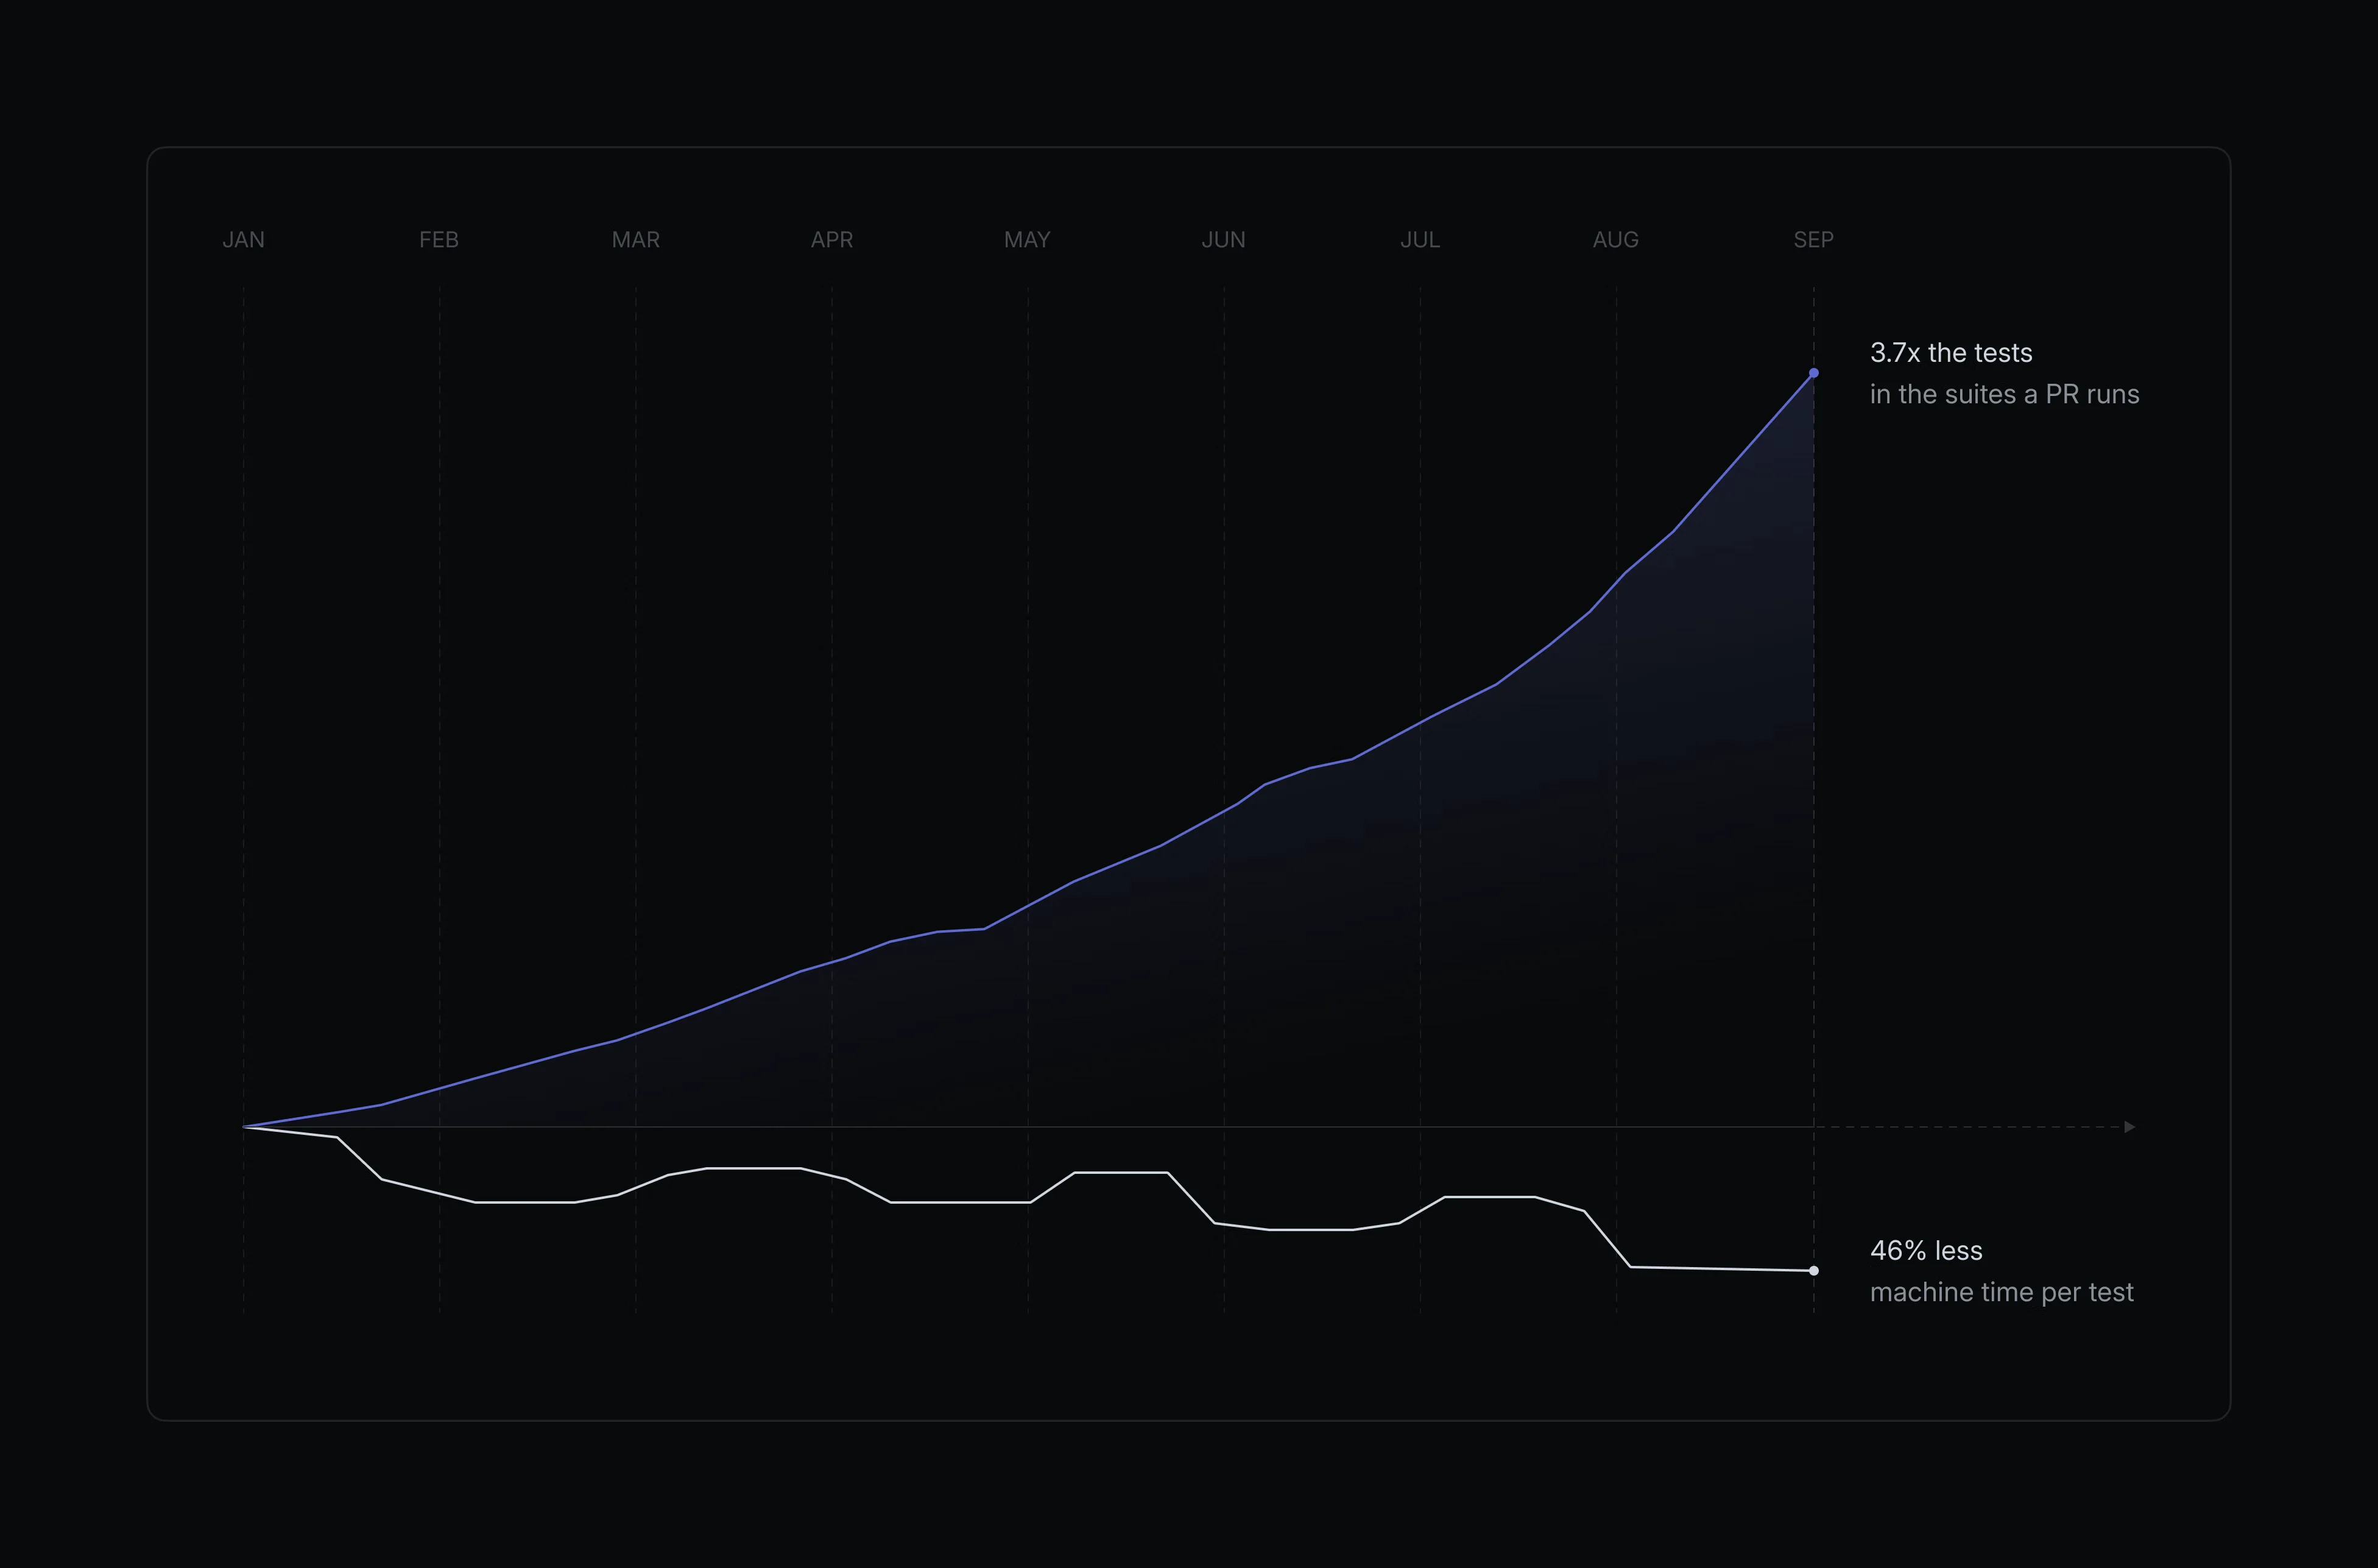
测试变多不必然让验证更慢,前提是先把每次执行都重复缴的过路费找出来。图源 Linear 官方工程复盘。
Setup 不是小事,它经常比测试本身还贵
编码 Agent 改一行代码也会推 PR。它在乎的是尽快知道这一行有没有把仓库弄坏。可传统 CI 习惯把每个 job 当成一次独立开荒,拉起机器,checkout,装依赖,准备数据库,最后才开始做那十几秒真正的检查。
这就很像每次去楼下取快递,都先把整栋楼装修一遍。厉害了,流程很完整,事也确实没少干,就是快递还在门口。
Linear 把 API 测试 shard 每次都会装的 Postgres client 放进了一个很小的基础镜像。后来又把原生构建头文件一起塞进去,因为运行时下载偶尔会卡住,长尾比平均值更会折磨人。
更直接的一刀落在 monorepo。它们用 pnpm workspace 管理仓库,API 测试此前却会安装整个 workspace。改成只装 API package 及其依赖后,安装时间从 44 到 73 秒,变成 16 到 18 秒。
很多人看到这里会下意识说,那就缓存 node_modules 呗。
Linear 真的测了。锁文件经常变化,缓存命中后还要约 28 秒恢复。过滤安装只要约 7.5 秒。缓存不但没占便宜,还多了保存时间和波动。
这正是 CI 优化里最容易自我感动的地方。缓存名字听上去就很快,命中率报表看着也舒服,可它是不是比重建快,只能拿时延说话。不要把缓存当信仰,它只是一个需要参加性能考核的候选人。
还有七个独立短检查,原来每个都要启动 runner、checkout、安装依赖,然后只干几秒正事。Linear 把它们合并成两个 job,在 job 内并发跑七项任务。官方按 6 月用量估算,这个改动每月省约 87,000 runner minutes,占总 CI 用量 11.8%。
这不只是省钱。固定开销降下来,你才有资格讨论更细的并行度。否则每多开一个 shard,都是多请一个人来重复铺地板。
分片不是越多越好,它吃的是固定成本
走到这一步,Linear 才把 API suite 从 4 个 shard 加到 8 个。
他们用的是 Vitest。Vitest 按文件分发,而不是按每个测试的实际运行时长。少数特别大的测试文件会压住一个 shard,其他 shard 早都跑完了,最后全队看着那个慢文件发呆。
Linear 先把大文件拆成更聚焦的小文件,再试不同的 shard 和 runner 组合。8 shard 的初始基准里,关键 job 快了 19%,成本也低了 19%。一周后,最慢 shard 从 5.25 分钟降到 4.33 分钟。
这里藏着一个很重要的前提。分片会把等待时间摊平,也会复制 setup。官方算得很直白,优化前每个 shard 的 setup 要 110 到 140 秒。8 个 shard 光是准备就要花 15 到 19 分钟 runner 时间,比测试本身还显眼。优化后 setup 约 40 秒,8 个 shard 的总 setup 时间反而比以前 4 个 shard 更少。
所以别把分片数当一个独立旋钮。它和 checkout、依赖安装、数据库准备、镜像、缓存绑在一起。固定成本没被压下去前,更多分片往往只是把一张慢账单复印更多份。
最危险的优化,通常看起来最爽
Linear 最大的一项性能改造和测试隔离有关。
Vitest 默认让每个测试文件隔离运行。这样更安全,但每个 worker 都得重建 entity、GraphQL、decorator 这些模块图。Linear 给安全的文件提供了一个显式 opt-in 的 Vitest project,用 isolate: false 让同一 worker 内的测试复用 module registry。
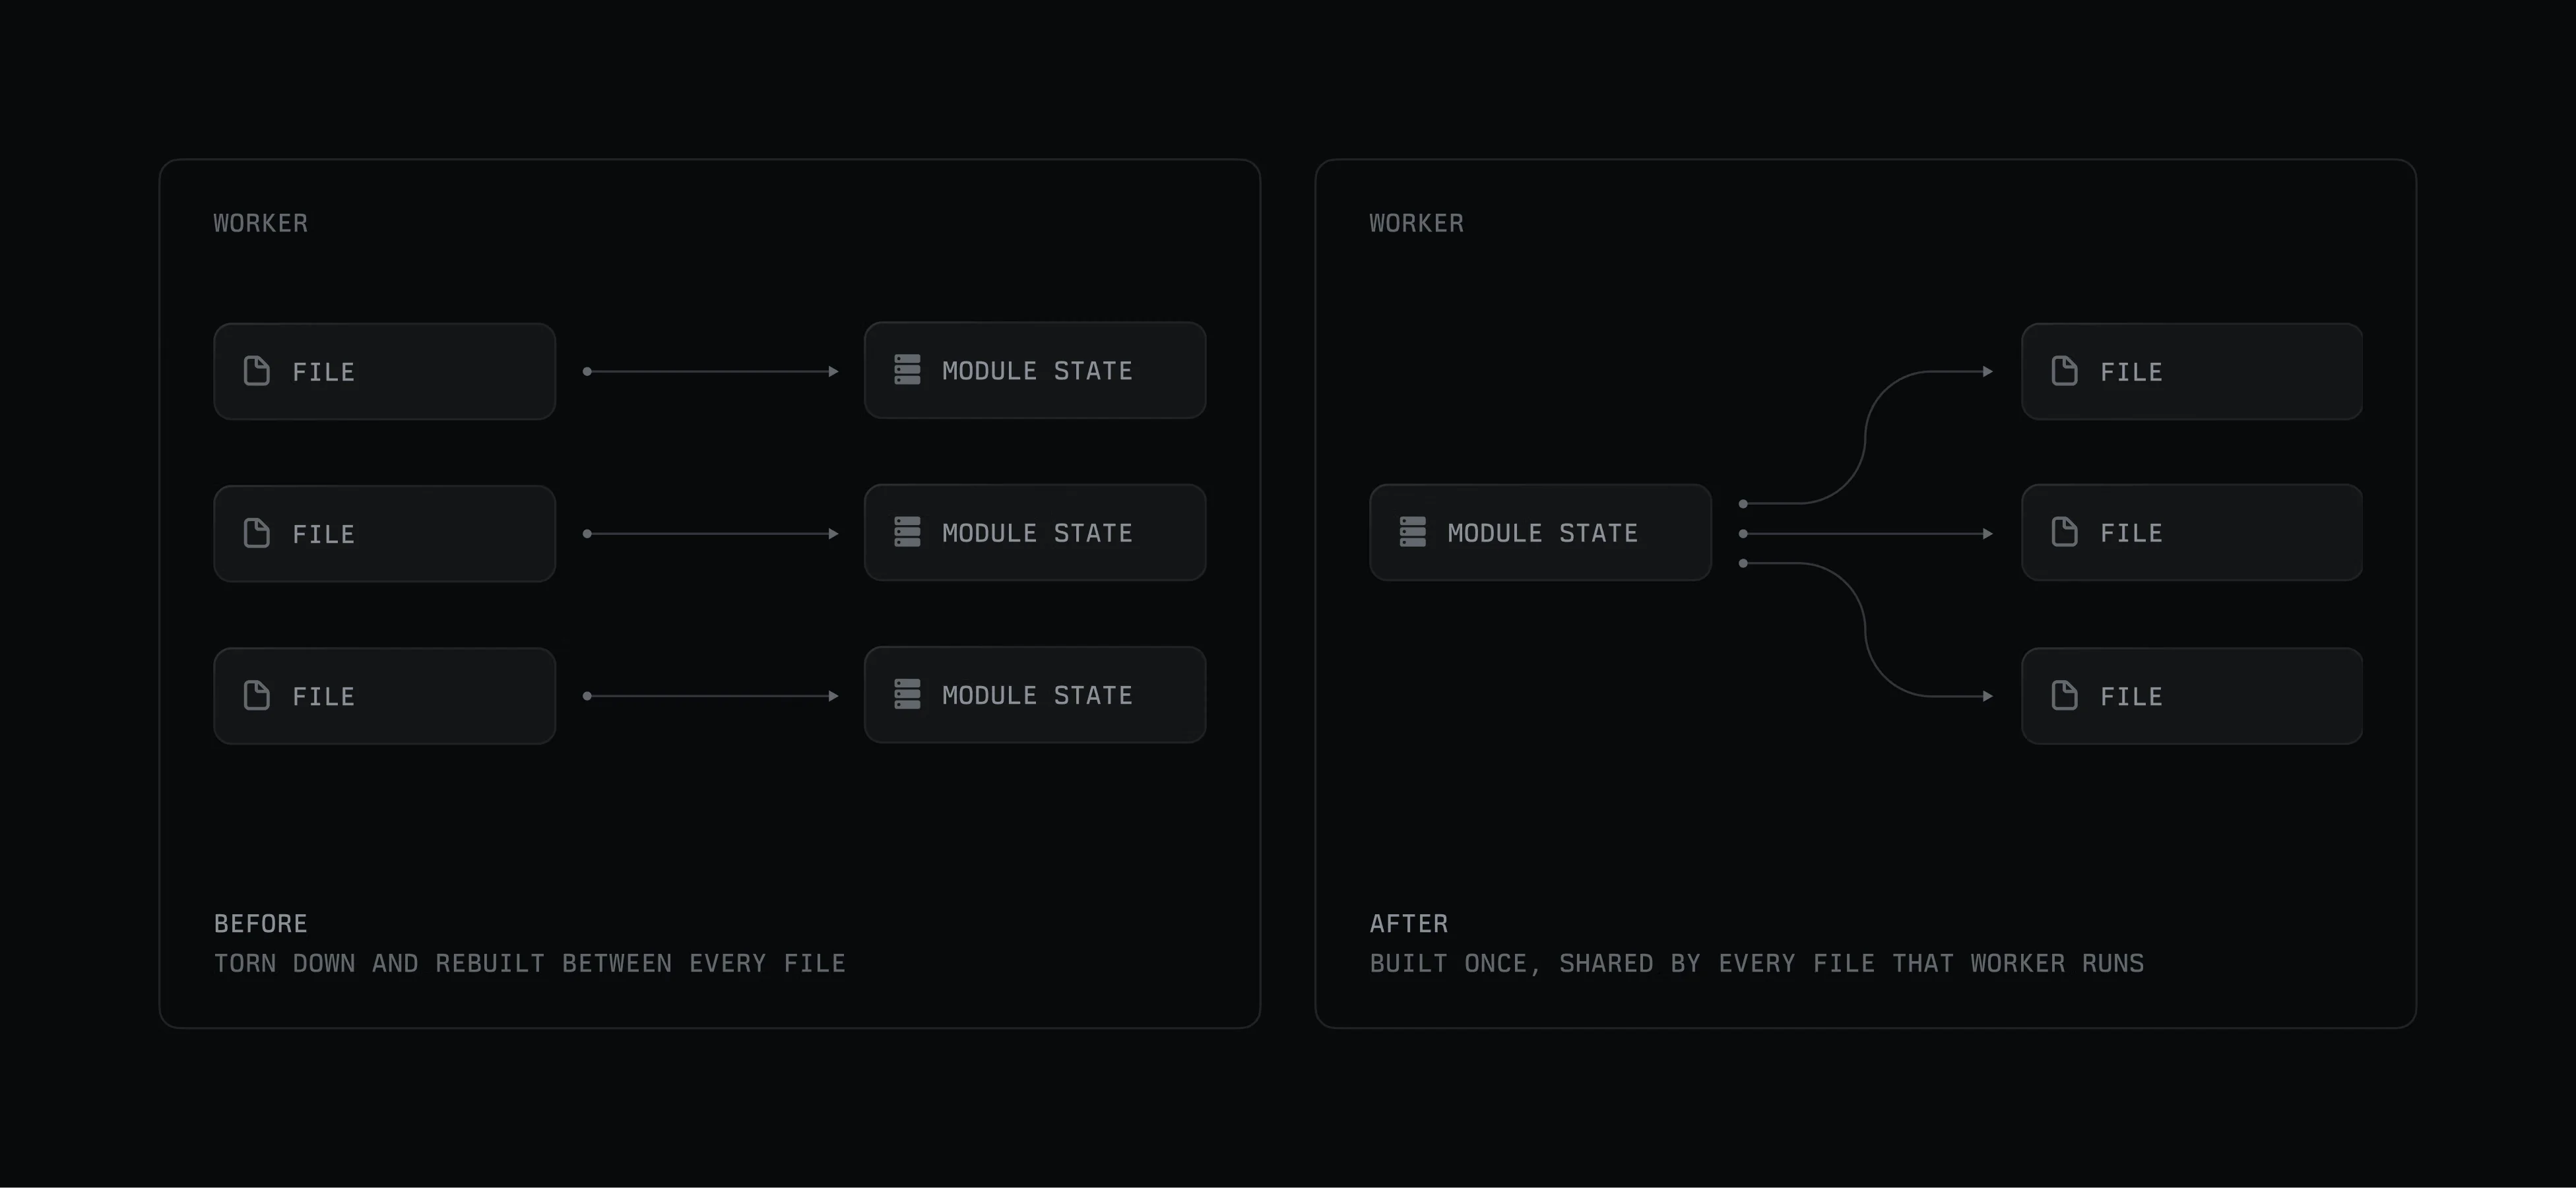
共享 module state 能少做重复工作,但它只适合被明确许可且有 teardown 的测试文件。图源 Linear 官方工程复盘。
最慢 shard 从大约 300 到 379 秒降到约 195 秒。API shard 总 runner 时间从约 32.8 分钟降到 22 分钟。数字很香。
可官方把它明说为正确性风险最高的一项。每个文件要显式声明能不能进这个 project,还要补共享状态的 teardown。带 fake timer 或共享状态理不清的文件,继续待在隔离环境里。
这段不能只抄 isolate: false。把隔离拿掉很像拆防火门,通行的确快了,但前提是你知道哪些房间真的不会起火。测试更快不等于测试还可信,特别是当 Agent 已经在帮你生成越来越多测试的时候。
Linear 也把这个 opt-in 约束写进了生成测试的 Agent 规则里,让新来的测试默认遵守边界。这个动作比参数本身更有价值。性能规则如果只藏在某个资深工程师脑子里,下一批自动生成的代码很快会把它冲掉。
给自己的 CI 先做一次不花钱的体检
不需要照搬 Linear 的 TypeScript、pnpm 或 Vitest。它们的做法能落到任何语言栈里的,是排查次序。
先测 PR 的排队时间和关键路径,不拿全部 job 的平均值糊弄自己
再找每次重复发生的 setup,checkout、装依赖、拉镜像、起数据库
然后用真实时延比较缓存和重建,命中慢就别留
最后才调整分片和并发,并给影响隔离与共享状态的优化留明确准入规则
如果你的 CI 现在很慢,别一上来重写流水线。看一眼那个总在最前面、却只干十几秒的 job。看一眼每个 shard 都重复安装的包。看一眼缓存恢复究竟耗了多久。它们不够酷,却往往是整个队列里最会吞时间的东西。
Linear 说,如果年初没有主动改造,如今测试套件大约要跑 11 分钟。他们现在每周还在新增约 2,000 个测试,所以这场仗并没有结束。
AI 把写代码的成本压低以后,工程团队的竞争力开始落到另一件更朴素的事上,能不能快速而可靠地证明改动没有坏掉。代码会越来越多,绿灯不能只越来越慢。
你们团队现在最先堵住 Agent 的,是 checkout、测试、合并队列,还是那个没人碰过的十秒钟门卫 job?