
开源 Agent 模型,别只盯跑分,MiMo 把训练环境摊开了
小米 MiMo-V2.6 不只放出了模型权重,还放出 7,000 多个 RL 任务环境、训练链路与可组合 harness。做 Agent 的团队能从中带走什么,又该先验哪几层?
如果你做过一个会调用工具的 Agent,大概见过这种落差。
模型在公开榜单上一路往上冲,仓库也能顺利拉下来。真轮到自己的任务,问题却从第一步就开始冒头。浏览器怎么重置,仓库依赖谁来准备,工具返回什么算成功,任务跑到一半卡住以后该罚谁。把提示词换三版都没用,到头来发现是环境和评测根本没有对齐。
今天小米正式开源的 MiMo-V2.6,有个地方比它的 46 分综合智能指数更让我在意。它同时放出了 7,000 多个强化学习任务环境、端到端训练框架、一个 9B 的蒸馏起点,以及把系统提示、工具和上下文管理拆开的 mini-harness。
好家伙,这次摆上桌面的不只是一个更大的 checkpoint,而是一段能被别人继续折腾的 Agent 训练链路。
这不等于谁都可以在本地复刻出旗舰模型。官方披露的两条训练线,30 步累计跑了约 75 万条轨迹,Flash 与 Pro 的训练成本分别约 85 万和 262 万美元。这个量级不是周末租几张卡能碰瓷的。
但它给了做 Agent 的团队一个更实际的问题,开源模型到底是一个下载包,还是一套能被验证、替换和继续训练的工作台。
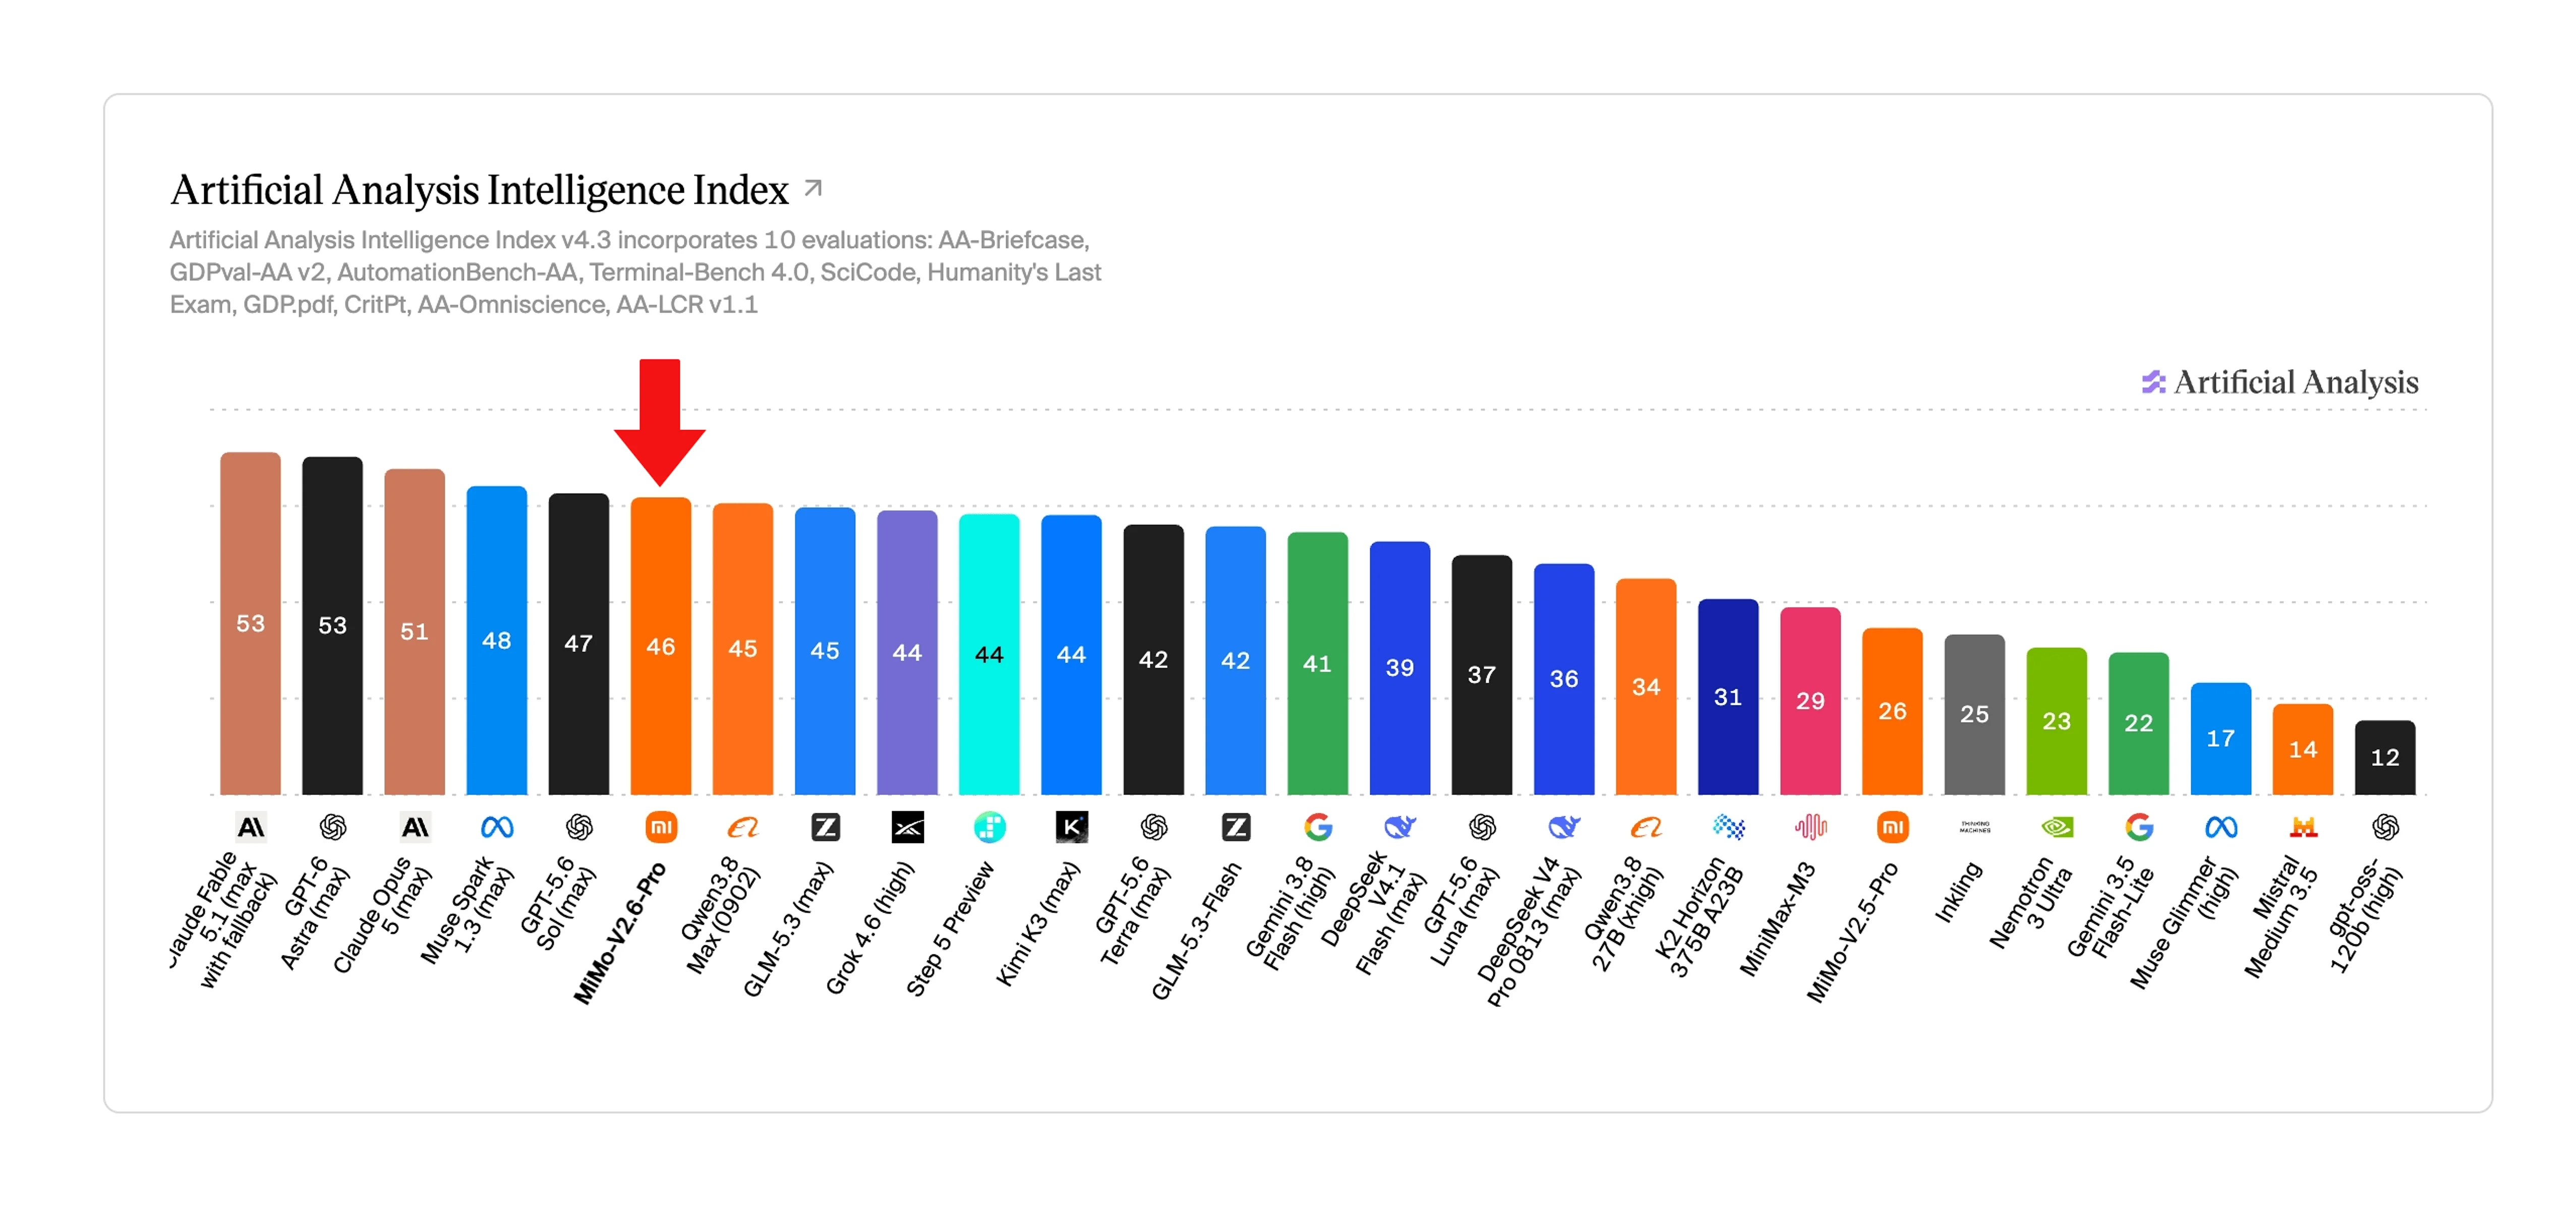
官方发布页引用的综合智能指数图。榜单能说明能力位置,却不能替你补齐训练和验收环境。
真正稀缺的不是权重,是能反复重置的任务
很多开源模型发布时,最容易被转发的是参数量、上下文长度和榜单排名。这些当然重要,毕竟选型不能只靠感觉。
可一旦目标从聊天变成让 Agent 修一个真实仓库、处理一段带附件的工单,或者在网页里完成一条业务流程,难点就从生成答案变成构造一次完整的回合。它要看见什么状态,可以做哪些动作,动作之后怎么判定,失败时是否能恢复到同一个起点。
这次 MiMo 放出的 7,000 多个 RL 环境覆盖软件工程、漏洞复现、知识型工作和网页设计开发四类任务。这个分类挺有用,因为它没有把所有 Agent 都塞进代码补全一个抽屉里。代码任务能否通过测试,网页任务能否渲染出可操作的结果,知识任务能否在约束下检索和交付,判定方式完全不是一回事。
一个可以训练的环境,至少得交代四件事。
任务初始状态要固定。不然今天给模型一个干净仓库,明天带着上次留下的缓存和数据库,再漂亮的提升都很难解释。
可行动作要明确。终端、浏览器、文件系统、网络和自定义工具的权限不同,等于给模型发了不同难度的试卷。
完成条件要可验证。只凭模型自己说做完了,厉害了,但这叫自我报告,不叫评分。
失败后要能重置。一次卡死就得人工收拾的环境,跑几十条轨迹还行,跑几十万条轨迹会把训练平台拖进泥里。
很多团队现在卡的恰恰是这层。模型 API 已经接好,评测脚本也有几条,放到连续任务里就开始漂。不是模型忽然变笨,而是每次运行面对的世界不再相同。
MiMo 的环境是否适合你的任务,仍得逐项检查许可证、镜像、外部服务依赖与重置机制。开源不替你做尽职调查。不过把这一层和模型一起公开,至少让讨论从「它强不强」往前走了一步,开始问「它在哪种世界里强,那个世界能不能被我复现」。
训练链路里,harness 往往比一条神奇提示词更诚实
官方说明里还有一个容易被略过的词,轻量可组合的 harness。可以把它理解成让模型真正干活的那层脚手架,里面放着系统提示、工具定义、上下文策略和执行约束。
同一个权重,换一套工具描述、上下文裁剪或重试规则,得到的并不是一点点文案差异。它看见的任务历史变了,能走的路径变了,拿到奖励的机会也变了。把这种变化误当成模型进步,是 Agent 训练里最常见的坑之一。
MiMo 说它把这些部分拆开,再用多种 harness 训练,希望模型在没见过的框架里也能工作。这个目标很对胃口。生产里的 Agent 很少只活在一个固定框架中,今天接的是浏览器工具,明天可能是内部工单系统,后天又换成一组受限的数据库操作。
不过,多 harness 不是把十份配置扔进锅里搅一搅就结束。每多一种配置,就多了一条归因链。结果变好了,到底是任务更简单、工具更宽松、提示词更长,还是模型真的学会了迁移。这里如果没有统一的轨迹格式、版本号和固定对照组,训练日志很快会变成一堆看着热闹的数字。
官方列出的端到端框架基于 verl、uni-agent 和 mini-swe-agent,覆盖环境交互、轨迹采集、奖励评估和策略优化。这四块正好可以当成读代码时的顺序。
先看环境接口。一次回合的输入、动作、异常和 reset 是否留了记录。
再看轨迹。是否把工具调用和中间状态完整留下,还是只剩一段最终答案。
然后看奖励。自动判分会不会被格式投机,是否有交叉校验和异常检测。
第四才看优化。采样、过滤、批次配比和版本回滚是否能追溯。
棒棒的,这套顺序不性感,却比先冲着榜单去调温度靠谱得多。
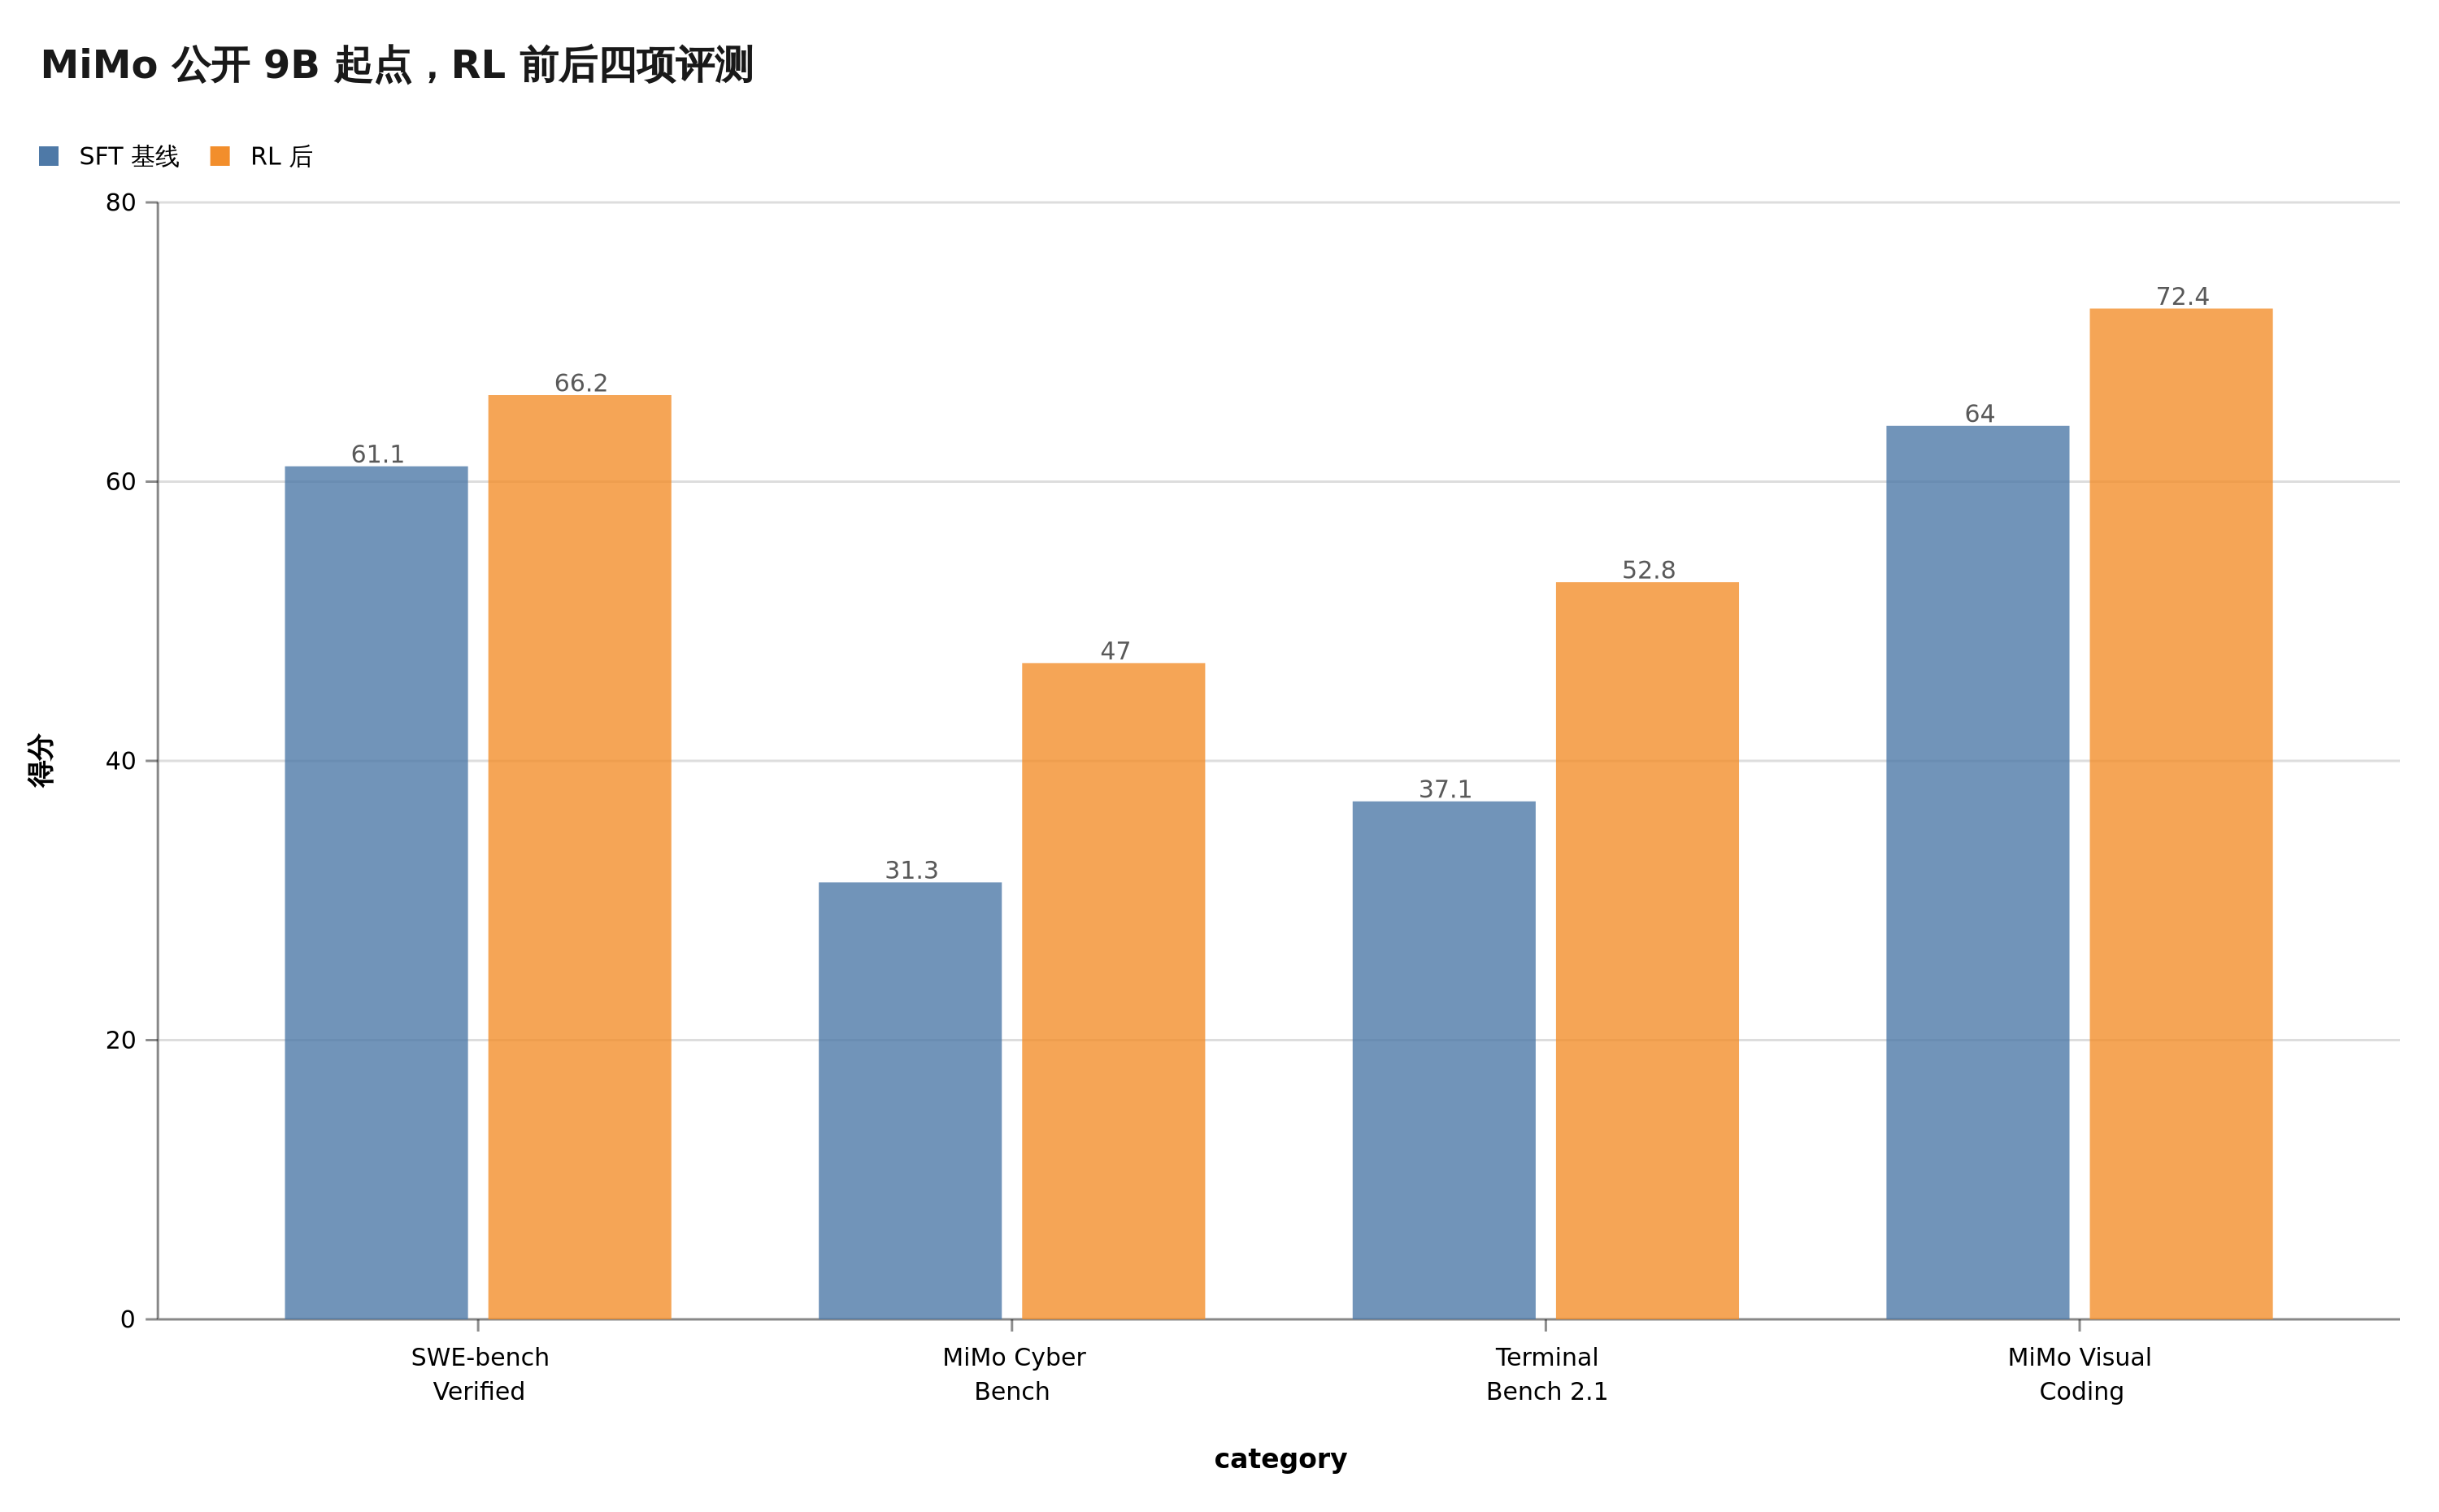
数据来自 MiMo 官方发布页,图中是 9B 蒸馏起点的公开对照,不应外推为旗舰模型在任何私有任务上的实际表现。
四个数字,刚好说明该怎样读这份开源包
官方给出的 9B 蒸馏模型对照很值得留一眼。以它为起点做 RL 后,SWE-bench Verified 从 61.1 到 66.2,MiMo Cyber Bench 从 31.3 到 47.0,Terminal Bench 2.1 从 37.1 到 52.8,MiMo Visual Coding 从 64.0 到 72.4。
数字本身看着挺爽。尤其是后面三项,涨幅并不小。
但比起立刻把它翻译成「RL 包治百病」,更有价值的读法是盯住实验边界。官方说的是一个指定的 9B 起点、这批任务环境与 11 项评测下相对 SFT 基线的结果。它支持的结论是,任务、奖励和训练流程在这组公开条件里组成了一条可观察的增益链。
它不支持的结论也很清楚。你拿一个内部 CRM Agent,接上完全不同的权限、文档和审批流,并不能直接期待同样的提升。你的评测如果只检查最终文本,甚至可能看不见工具调用路径已经歪了。
这就是开源环境比一张 benchmark 截图更值钱的地方。截图只告诉你终点在哪里,任务环境和训练代码至少给了你一条可以追问的路线。你可以换模型、换奖励函数、换工具限制,然后确认分数到底为什么动了。
对于要上生产的团队,我会把这类数字当成「值得建一个小型验证场」的信号,而不是采购结论。模型的公开成绩很像汽车的马力表。能不能跑进你的配送线路,还得看油路、刹车、载重和司机能否随时接管。
想借这套资源起步,可以先做一个很小的验收场
别一上来就试图复现几十万条轨迹。那样大概率只会收获一台很热的机器和一串看不懂的日志。
更实际的做法,是挑一个能在十分钟内重新跑完的任务。它可以是修一个带测试的小 bug,也可以是从一份固定资料中生成带引用的答复。任务越小,越容易看出到底是哪一层在骗人。
先给它写清楚初始状态和完成条件。代码任务不只看测试通过,还可以记录改动文件、命令退出码和是否碰了禁止目录。知识任务不只看答案像不像,还要检查引用是否来自允许的资料。网页任务则要看最终 DOM、截图或可操作元素,不要只截一段模型自述。
接着留一条最朴素的基线。固定模型版本、工具集合、系统提示和上下文上限,连续跑一批任务。基线难看没关系,它至少是同一把尺子。
然后一次只换一层。先换任务环境,下一轮再换评分器,而后才换 harness 或训练策略。这样结果即便没有涨,也能知道是哪一块先露了馅。
再把失败样本留下来。不是只保留成功案例的最终答案,而是保留那次工具报错、上下文被截断、权限不足和错误重试。真正能帮下一轮训练的,往往就是这些不太体面的轨迹。
如果这四步都跑顺了,再去研究公开训练框架里的采样、奖励和策略优化。顺序反过来,先把大框架端上来再找任务,通常会让排错成本直接起飞。
别把公开训练资源当成生产许可证
还有两道边界,最好在下载之前就写进项目说明。
一是安全边界。漏洞复现、浏览器操作和真实工具调用这类环境,不能因为开源就直接连到公司的网络、密钥或客户数据。训练与评测应该放在隔离的账号、模拟数据和可撤销凭证里。模型遇到陌生页面时,宁可停下来报错,也别让它带着正式权限到处试。
二是可迁移边界。任务环境里通过的模型,可能只是更熟悉那套奖励和工具格式。要判断它是否真的学到了更稳的行为,需要另留一批没参与训练、工具约束又略有不同的任务。没有这层样本外检查,训练分数涨得再整齐,也可能只是把题库背熟了。
MiMo-V2.6 这次把权重、任务、框架和 harness 一并放出,真正值得欢迎的不是多了一个能跑分的名字,而是更多人可以把上面这两道边界放进实验里验证。
模型会越来越会写代码、点网页、调用工具。训练它的人,也该越来越会问,究竟是哪一个环境、哪一种奖励、哪一条轨迹让它学会了这件事。
你们做 Agent 时最先卡住的是任务环境、评分器,还是工具和上下文那层脚手架?