
Agent 选模型别只看第一名,$0.57 那档已经进前五
Agent Arena 的十月快照把一件事摆到了台面上,选 Coding Agent 不能只盯榜首。把质量、单任务成本和升级条件写进同一张卡,才知道默认该用谁。
同一类 Agent 任务,第四名 GPT-6 Astra(Max)的单任务成本中位数是 3.14 美元,第五名 GPT-6.1 Sol(Max)是 0.57 美元。
两个模型在 Agent Arena 十月快照里的净提升,分别是 +12.27% 和 +11.23%。
好家伙,差距不到一个百分点,账单差了五倍多。
很多团队给 Coding Agent 选模型,还是一眼扫到排行榜第一名,点开设置,设成默认。流程很顺,脑子也省事。可 Agent 不是聊天窗口里问一个问题就完了,它会读仓库、改文件、跑测试、卡住后重试,再把一段「已完成」甩回来。真正该付钱的单位,不是 token,也不是一次回复,是一件能验收的活。
这也是我觉得这张榜单值得多看一眼的地方。它没法替你选模型,但它提醒了一个经常被忽略的事实,模型选型应该从「谁排第一」改成「谁能把我这类任务做完,而且总账单没失控」。
先把边界划清。这些数字来自 Agent Arena 的公开排行榜,是十月初的观察快照,不是 API 价目表,更不是谁家的模型在你的仓库里必胜的承诺。榜单会变,任务分布会变,连同一个模型在不同工具权限、上下文长度和重试策略下,花的钱都能差出一截。
但快照本身已经够有意思了。
| 十月快照 | Agent Arena 净提升 | 单任务成本中位数 |
|---|---|---|
| Claude Sonnet 5.5(Max) | +12.5% | $2.74 |
| GPT-6 Astra(Max) | +12.27% | $3.14 |
| GPT-6.1 Sol(Max) | +11.23% | $0.57 |
| GPT-6 Sol(Max) | +9.71% | $0.90 |
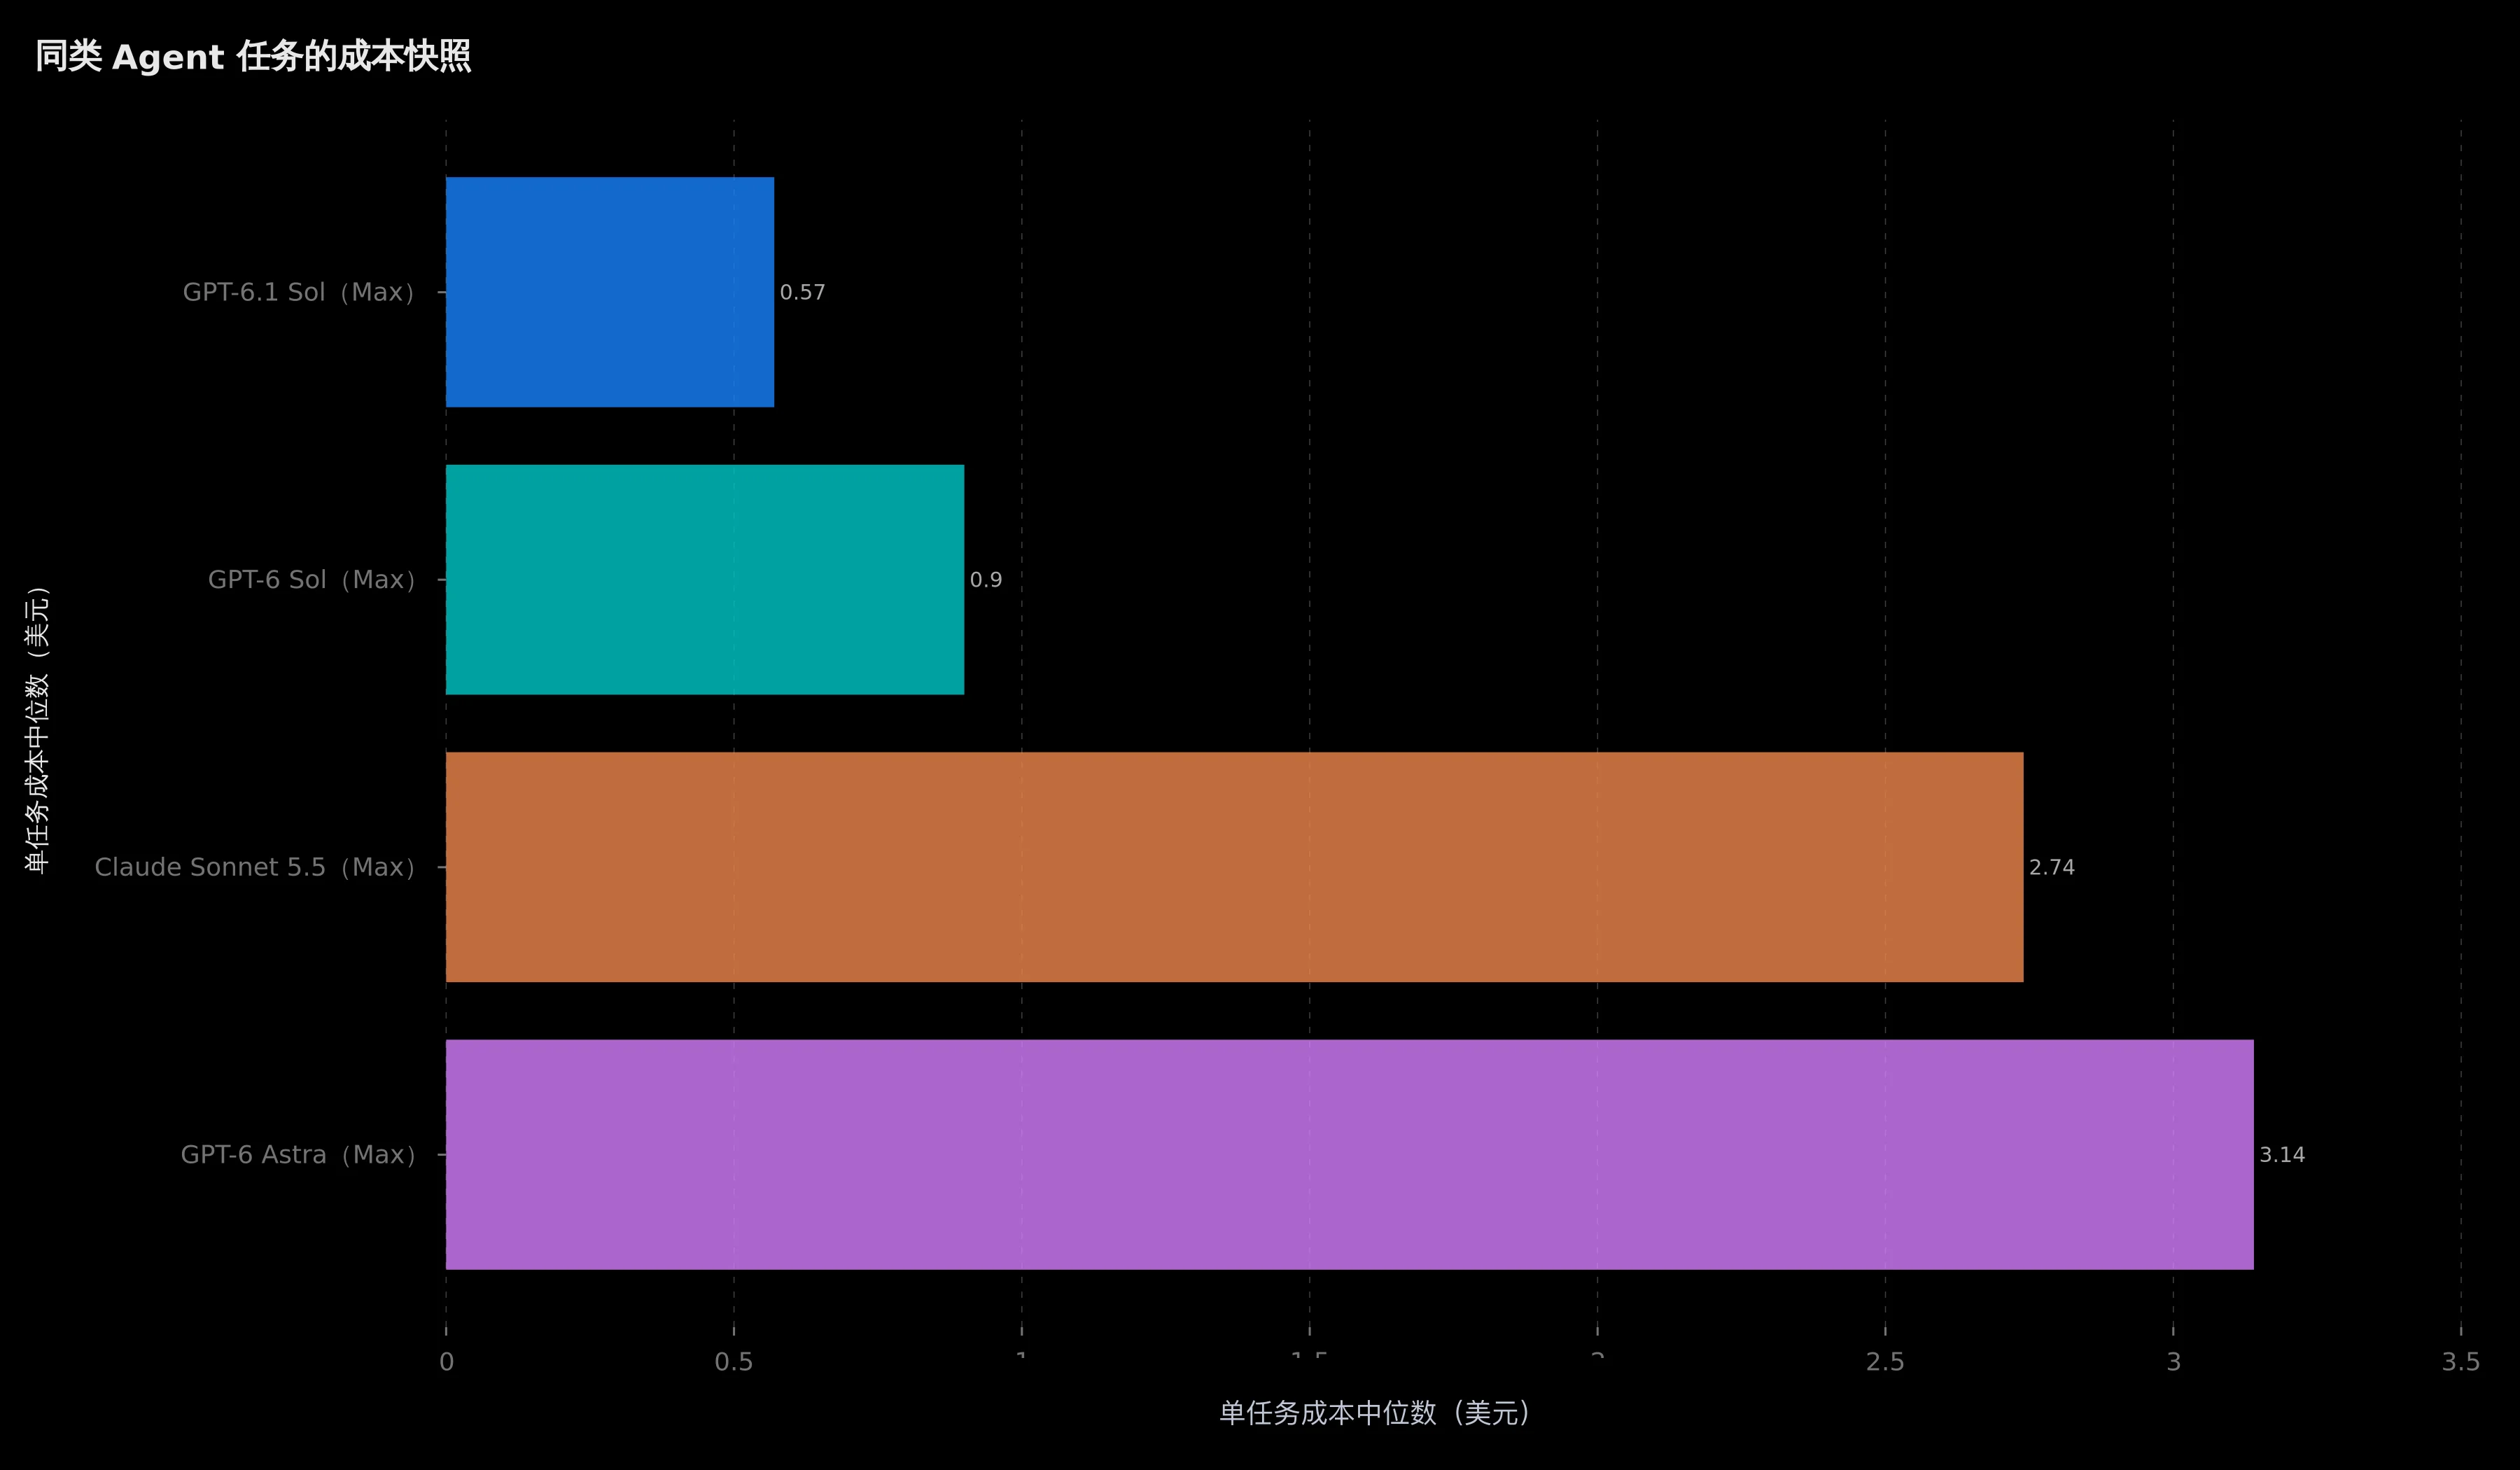
图中是 10 月初的公开快照,金额是单任务成本中位数,不是 API 标价。
别急着把它读成「Sol 赢了」。它说明的是,至少在 Arena 当时观察到的多步任务里,成本和结果不再乖乖排成一条线。贵一点,未必换来足够大的提升。排得靠前,也不自动等于适合当默认工人。
而且前几名的差距本来就没有大到可以闭眼下注。公开页面里,Astra 的净提升旁边带着 ±2.23% 的不确定范围,Sol 是 ±2.76%。这不是一张让人宣布冠军的成绩单,更像一个提醒,别把名次当作你项目里的成功率。
这事儿放到日常开发里很具体。你让 Agent 去改一个有清晰测试的小 Bug,它需要的是读懂局部上下文、改对文件、跑完测试、把 diff 交出来。若默认模型每次多花几美元,结果只比便宜那档多一点点把握,跑上一百次就不是「模型更聪明一点」的问题了,是预算里平白多出一张账单。
反过来,任务一旦碰上核心支付流程、迁移脚本、权限模型,或者测试很难覆盖的重构,便宜就不是唯一标准。一次错误上线的回滚成本,够买很多轮模型调用。这里该升级的,不是因为榜单让人焦虑,而是因为失败后果变了。
厉害了,模型选择终于从信仰问题,变成了工程问题。
我比较推荐把默认模型和升级模型写成一张很朴素的任务卡。别把规则只留在某个人脑子里,也别让 Agent 自己猜它什么时候该使劲。
[任务类型] 修复已有测试覆盖的 Bug / 小范围功能改动 / 代码审查
[成功条件] 测试通过,关键 diff 可读,未触碰约束目录
[默认模型] 成本较低且已在本仓库跑通的模型
[升级条件] 连续两次无进展,涉及敏感目录,或需要跨服务推理
[证据要求] 提交 diff、测试命令和输出、未完成项、风险说明
[成本记录] 模型与档位、调用次数、总成本、人工返工时间
这六行看着有点土,反而管用。前两行把「做完」从一句口头话变成验收条件。中间两行让低成本模型有明确的工作区,也让高成本模型只在真的该上场时出现。收尾两行才是重点,别只让 Agent 说自己完成了,要它留下能给人复查的证据。
默认路径负责边界清楚的活,风险和影响上来后再升级,而不是每件事都上最高档。
很多小团队一开始不会有完整评测集,这很正常。先拿最近已经结束的任务凑一小包就行,最好有修 Bug、补测试、做小功能、跨文件改动这几类。每个任务用同一份成功条件,分别跑默认模型和升级模型,记录三件事,是否做成、花了多少、人工要返工多久。
第一轮不用追求统计学上的完美。你只是要找出一个离谱的错配,譬如便宜模型在局部改动里很稳,却一遇到跨服务任务就不停兜圈;又譬如高档模型只在没有明确验收条件时显得厉害,一旦测试和目录边界写清,差距立刻缩小。看见这种错配,就已经比拿着通用榜单调参强很多。
还有一点经常被漏掉,模型的花费不只发生在成功那一次。一个任务如果三次重试才过,或者第一次改错了又由人返工,表面上的单次 token 很便宜,整件事仍然贵。成本记录里加上「第几次通过」和「是否人工接手」,两周后回头看,默认模型该不该换,通常自己就浮出来了。
别拿「它写得像不像资深工程师」当唯一判断。那种评价最容易把人带沟里。一个模型写出漂亮解释,测试却没跑,和一个模型把 diff 交得朴素但干净,后者在生产里通常更值钱。
这里还有个小坑。单任务成本比 token 单价更接近日常感觉,但也不是万能尺子。一个模型输出短,不代表它真的省钱,可能是早早放弃了。一个模型输出长,也不一定浪费,可能正好把失败原因和下一步写清了。成本要和成功条件、返工时间绑在一起看,单独拿一个数字出来比,多少有点像只看机器的油耗,不看它有没有把人送到地方。
Arena 的快照里,Sol 的低成本值得被纳入候选,Astra 和 Sonnet 的更高位置也仍然有参考价值。比较骚的结论不是「从此只用便宜模型」,而是给模型分工。把可回滚、证据充分、边界清晰的任务交给默认档。把高影响、上下文复杂、失败代价高的任务升级。然后每周看一次真实记录,看看哪条规则该调。
你会发现,选模型这件事没那么神秘。它跟给线上服务设超时、重试和降级差不多。没有一台机器要包打天下,只有不同风险下该付什么价。
Agent 的「完成」也一样。不要只收一句话,收一张能对照的收据。
你们现在给 Coding Agent 升级模型,触发条件是任务难度、代码目录,还是预算快报警了?