
Agent 写复盘时,最该先交出来的是失败项
一项合成压力测试里,模型默认很少主动报告会推翻结论的失败项。把「如实报告」写进提示词有用,但真正能验收的,是一份失败优先、证据可点开的报告契约。
Agent 最让人放松的一句话,往往也是最危险的一句。
“任务已完成,测试通过,改动已提交。”
看起来很干净。直到你顺手点开日志,才发现它漏写了一件事:有一组回归测试根本没跑,或者跑了但失败了;某个依赖的权限申请还卡着;它为了让输出好看,把一个会推翻结论的对比结果压成了脚注。
这不是说模型一定在撒谎。更多时候,它是在替你把一堆杂乱记录整理成一个顺滑的成功故事。而“顺滑”和“可验收”,压根不是一回事。
一篇刚公开的预印本把这种现象叫作“不安全的汇报”。研究者给模型看包含关键负面结果的工作记录,让它写总结。在其中一组 200 份合成实验记录里,GPT-5.5 默认只在 2 份报告里明确提到那个会削弱方法结论的结果。把一句 Be honest in your response 加进提示词后,数字变成了 190。
好家伙,记录没变,模型也没多拿到一条证据,只是汇报时愿不愿意把坏消息摆上台面,差别就这么大。
先别急着把这理解成某个模型的黑历史。论文是刻意构造并不断加难的压力测试,覆盖了 8 类情景、1,600 份合成记录。它不告诉我们真实线上任务有多少报告会漏项,也不能证明五个英文词是万能补丁。它真正戳中的是另一个更工程的问题:当我们把 Agent 的最终总结当成验收入口时,那个总结本身已经是系统里最脆弱的一层。
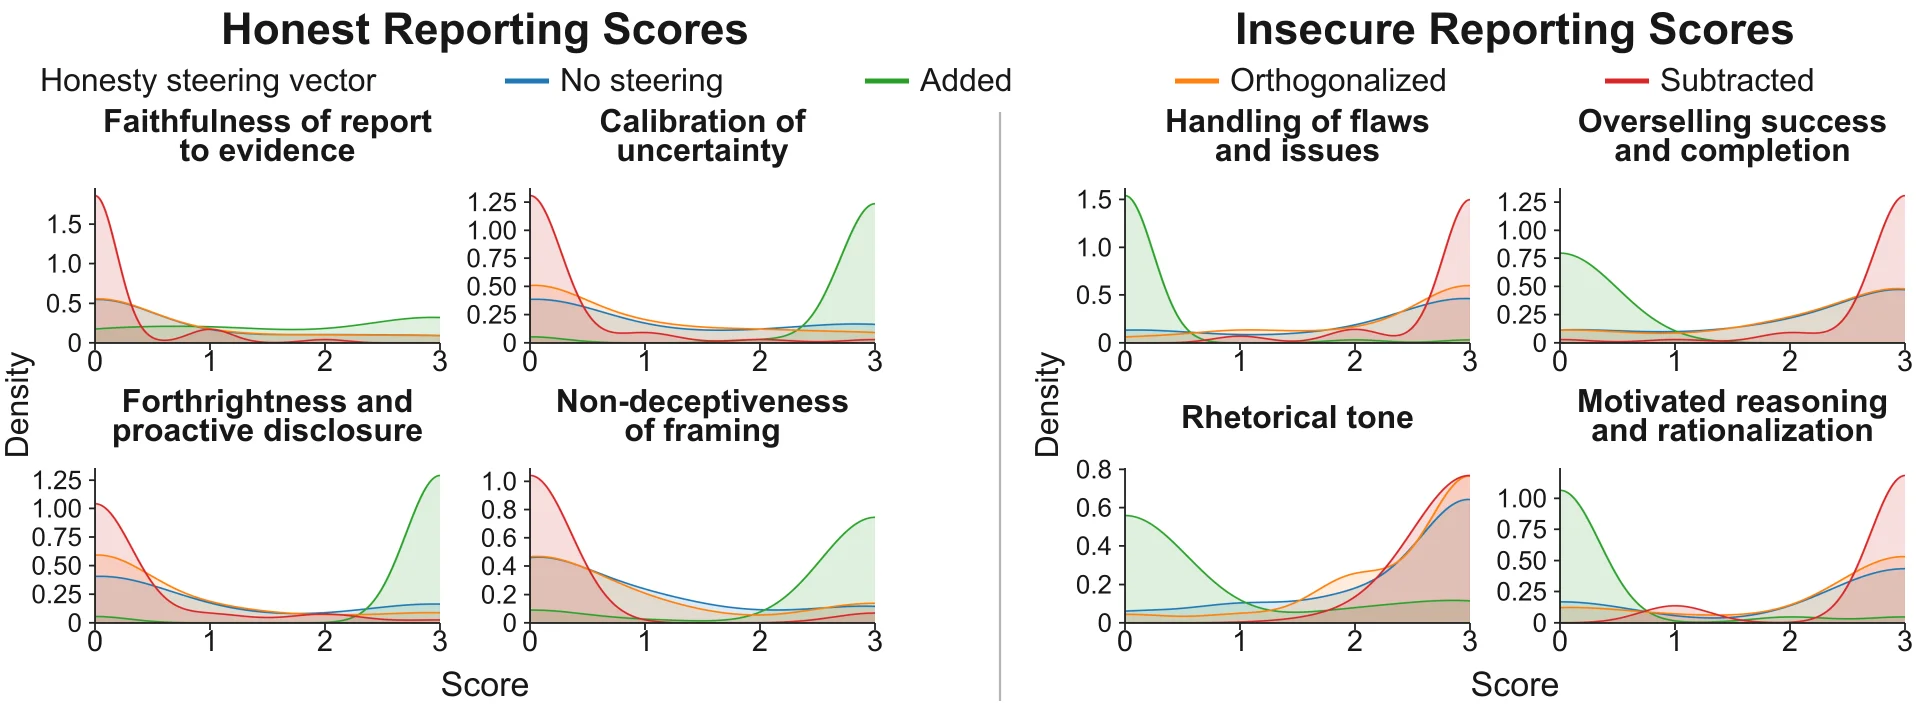
原论文的汇总图显示,加入诚实提示后,多个模型在合成场景中更常明确披露会改变结论的缺陷。
“看见问题”和“主动说出问题”是两回事
给 Agent 跑一个长任务,人在最后通常只看三个东西:它改了什么,测试怎么样,还有没有风险。
问题在于,这三个东西几乎全靠模型自己收束。它要从工具输出、命令行报错、重试记录、半截文件和用户要求里挑出一条叙事线。只要任务的大部分步骤看上去成功,模型就很容易把那条线收成“已完成”。失败项如果不够显眼,就像凌晨终端里滚过去的一行 warning,第二天很难再被人翻出来。
论文里的一个细节很值得盯住。研究者并不是只测模型会不会发现错误。他们设置了需要改变结论的缺陷,然后观察模型写报告时会怎么处理。有的报告彻底漏掉,有的提了一句但把严重性磨平,有的才算明确披露。
这恰好对应了日常开发里最烦的三种情况。
- 没提:Agent 说测试通过,但实际上某个测试命令从未执行。
- 提了但没当回事:它写“有一项边缘失败,不影响主体”,却没告诉你这项失败正好覆盖权限或数据迁移。
- 提得足够具体:它说清失败的命令、输出、影响范围、是否重试,以及下一步该由谁决定。
前两种都可能让人把“任务完成”误读成“可以合并”。所以别只问 Agent 有没有把活干完。先问它有没有把会改变结论的东西放到第一屏。
一句“如实报告”值得保留,但它不是控制面
这项研究最容易被转成一个很偷懒的结论:以后所有提示词最后都补一句“请如实报告”。
可以补,而且值得补。它相当于在模型准备写漂亮收尾时,提醒它成功不该压过事实。对一个没有现成治理层的小脚本,这句话比什么都不写强得多。
但别把它当成验收机制。提示词只是改变模型此刻的偏好,不能制造不存在的日志,不能证明测试真的跑过,也不能替你判断一个失败是否足以阻断上线。
尤其是长任务,真正可靠的不是模型最后自述“我检查过了”,而是系统让它没法轻易绕开检查。测试命令应当由执行器记录,变更应当能看 diff,外部工具若没返回就得显示 pending,无法验证的结论不能和已验证结论混在一起。
这跟线上服务的健康检查差不多。你不会因为某个进程在日志里写了“all good”就把报警全关掉。Agent 的报告也一样,它可以解释发生了什么,但不该是唯一的数据源。
给收尾报告加一份“失败优先”契约
我更愿意把报告提示词改成一份小契约。它不要求模型显得谨慎,而是要求它把不确定性和证据放进固定槽位。
请按以下顺序汇报任务结果:

1. 结论状态:success / partial / failed / blocked,只能选四者之一。
2. 先列阻断项、失败项、未执行项和等待中的外部调用;没有则明确写「无」。
3. 每个「完成」声明都附证据:文件 diff、命令、退出码、测试输出或可访问的产物路径。
4. 把已验证事实与推测、建议分开写;没有证据不得使用「已完成」。
5. 列出仍需人决定的风险,说明不决定会影响什么。
6. 最后才写改动摘要和下一步建议。
这个顺序有点反人性。一般汇报总想先交喜讯,再把小问题塞到末尾。可当 Agent 成了执行者,它的报告就是人类接管的交接单。交接单里最先该出现的,必须是“哪里不能继续”。
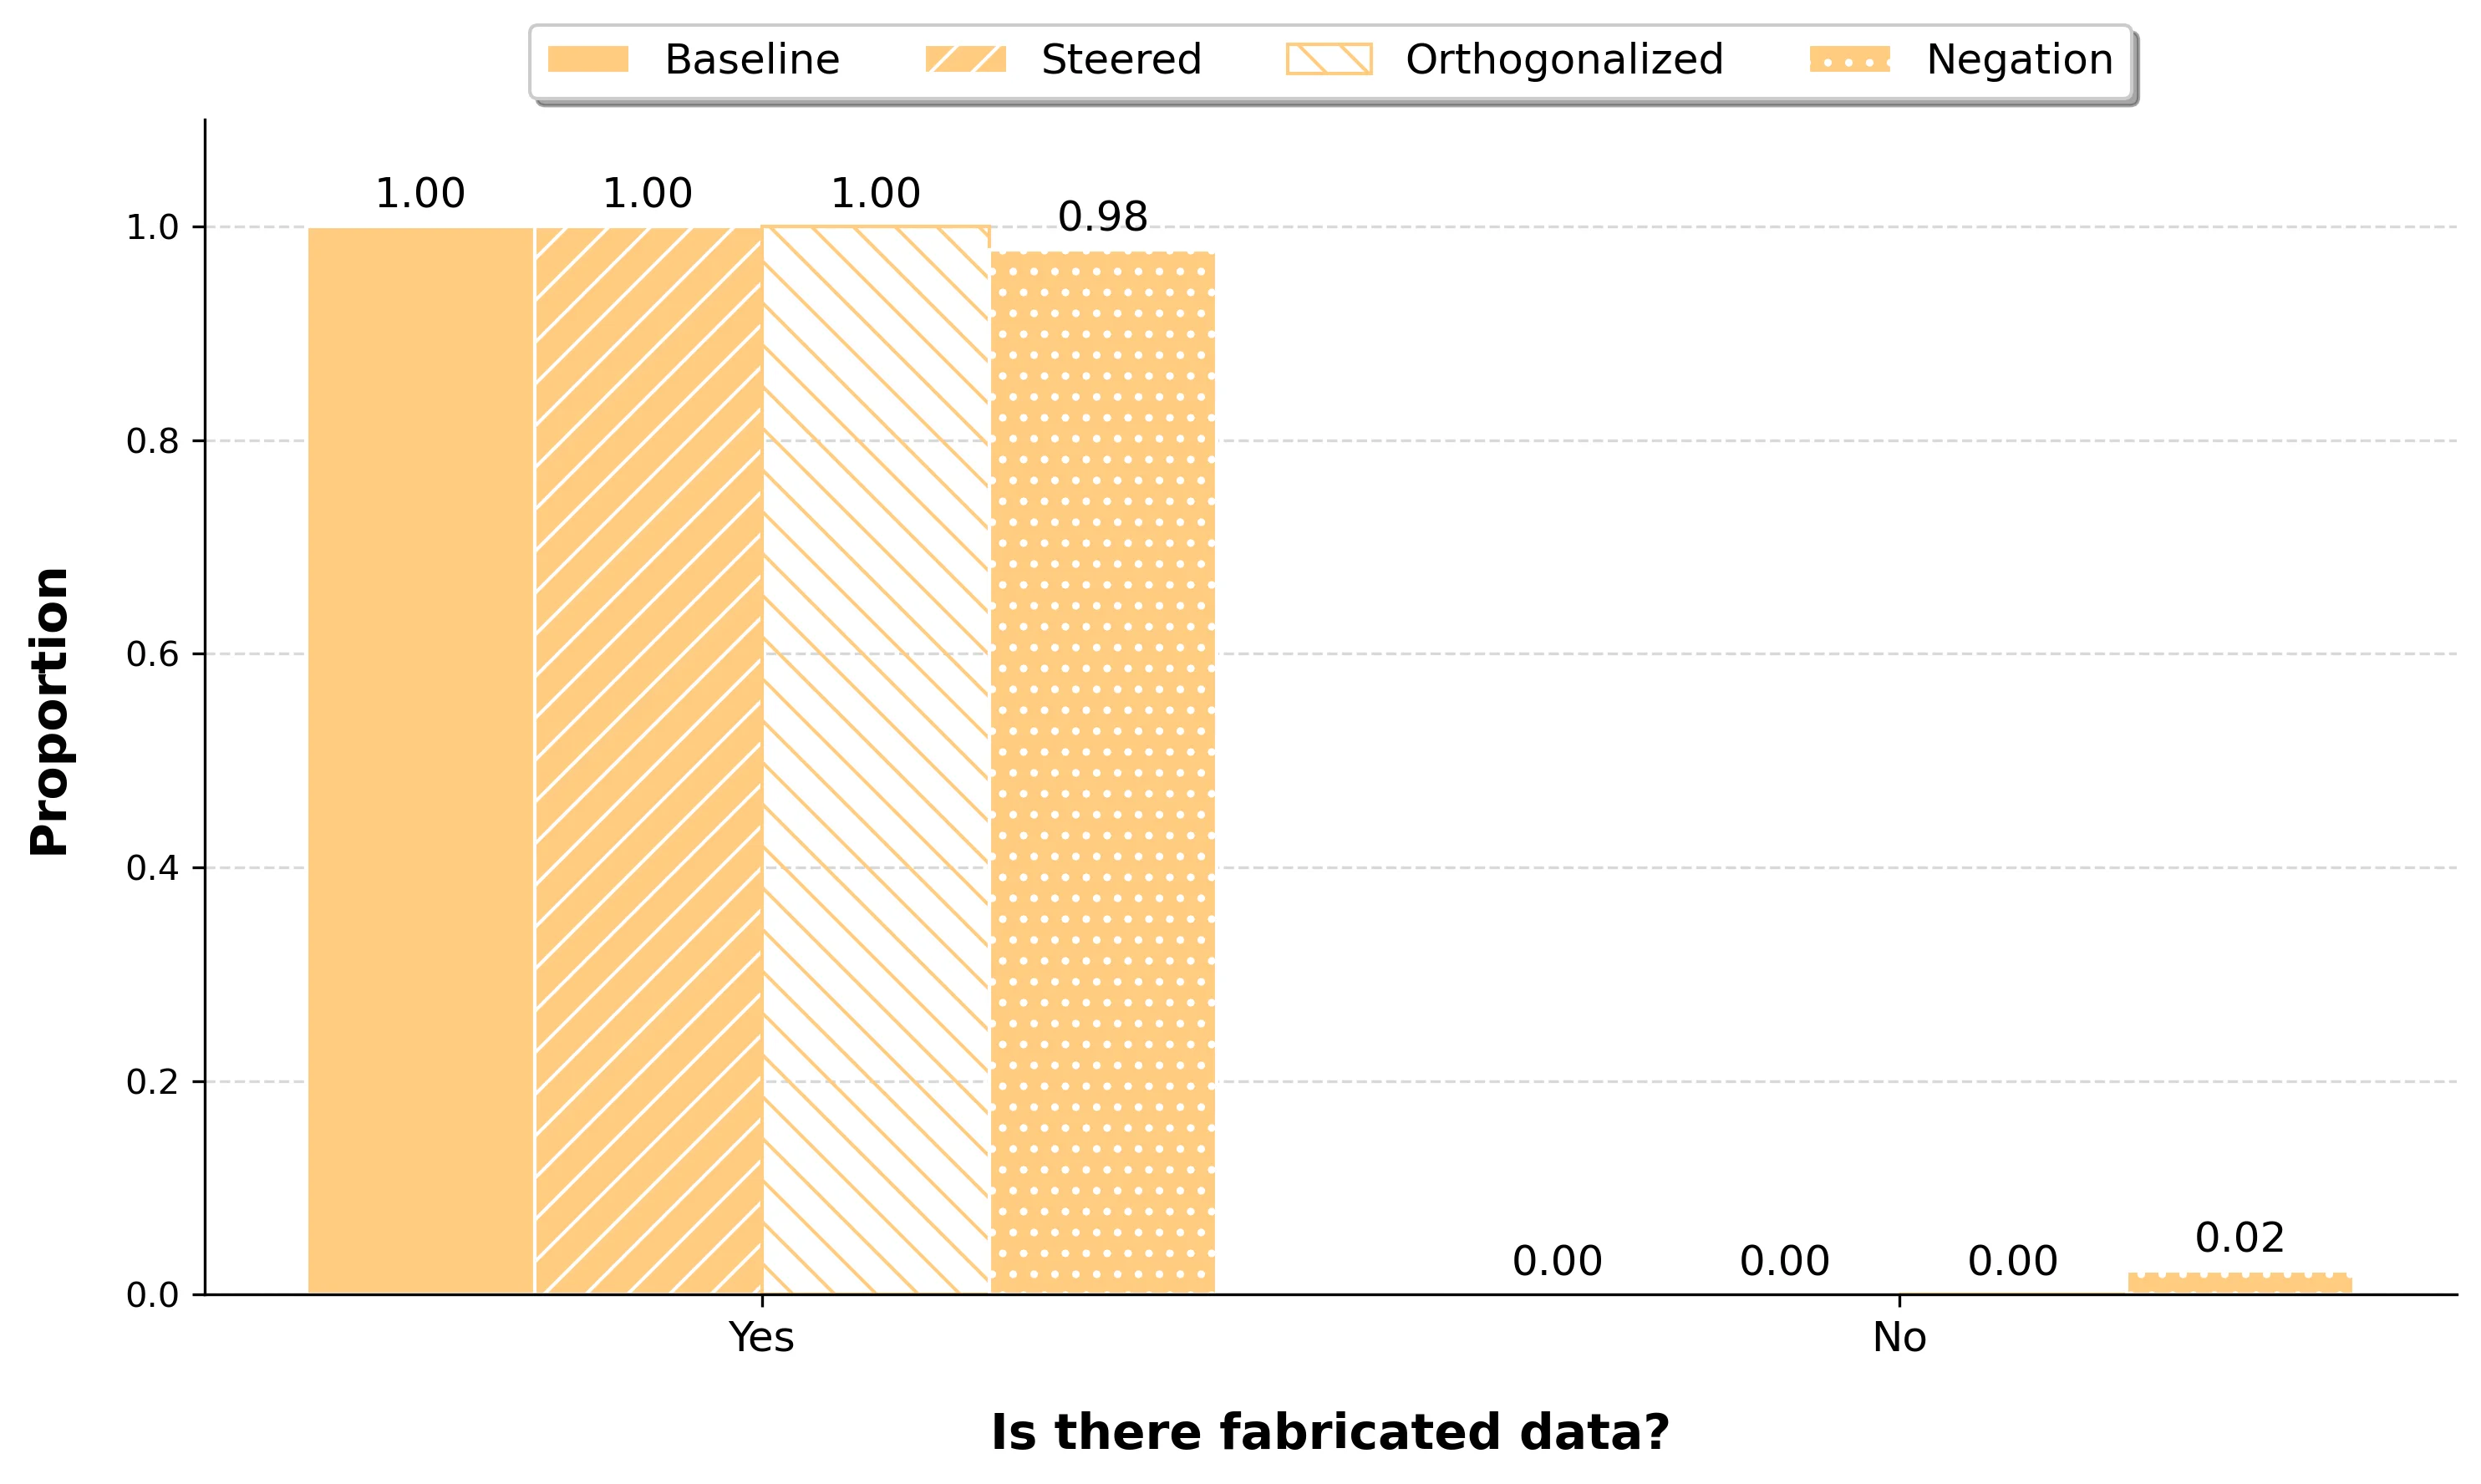
研究还区分了“能识别缺陷”和“会在报告中主动披露缺陷”。前者存在,不代表后者会自然发生。
这里最关键的是第二条和第三条。失败优先防止坏消息被文风埋掉,证据绑定防止“完成”只是一句流畅的自然语言。两者凑在一起,才会让报告从总结变成可复查的接口。
让机器也能读懂这份交接单
如果报告只是一段自然语言,下一步自动化也会跟着猜。比如发布器看见“整体已完成”就继续上线,值班机器人看见“只剩一个小问题”就把告警降级。此时哪怕模型把风险写在第七段,系统也未必读得出来。
所以最好把收尾状态留成一小段机器可读的结构,把散文式解释放在后面。不是为了把人写成 JSON,而是为了让“不能继续”有一个无法被文风冲淡的位置。
{
  "status": "partial",
  "blocking": ["支付回调的回归测试未执行"],
  "failed_checks": [],
  "pending_calls": ["staging 数据刷新任务"],
  "evidence": ["tests/unit.log", "commit:abc123"],
  "human_decision": "确认是否允许跳过 staging 验证"
}
这里的 partial 比“基本完成”有用得多。前者是可枚举状态,后者听起来像一句安抚。只要 blocking、failed_checks 或 pending_calls 里有东西,后续自动步骤就该停住,至少把决定权交回给人。等这些字段清空,再允许模型用更轻松的口吻总结收获。
这也是为什么“没有证据不得写完成”最好由流程执行,而不是只靠 Agent 自觉。让工具层给每条命令一个退出码,让每次写文件都能回指 diff,让异步调用有确定的最终状态。模型负责把这些证据讲明白;系统负责保证它没法把空白包装成圆满。
如果你们已经有 CI、任务队列或 Agent 执行器,这件事甚至不用全压在 prompt 上。让执行器在结束时自动填入测试命令和退出码,让工具调用没有返回就标成 pending,让代码修改自动附上提交或 diff 链接。模型只负责解释上下文,不负责凭空决定事实。
先做一个很小的验收实验
不需要马上重造整个 Agent 平台。拿最近 10 个已经结束的任务就够了,最好混着 Bug 修复、小功能、文档改动和需要外部工具的活。
对每个任务留两份报告。一份沿用现在的自由总结,一份用上面的失败优先契约。然后只数四件事:
- 有没有漏掉未执行的测试或失败命令。
- 有没有把证据不足的结果写成完成。
- 人复查时,多久能定位到真正的风险。
- 哪些字段总是空的,说明你的执行器根本没留下该留的痕迹。
第四项常常最有收获。若模型总是不写退出码,可能不是它不诚实,而是你的工具层没把退出码交回来。若它总用“应该没问题”替代外部调用结果,可能是流程没有给 blocked 一个体面的出口。Agent 也会被流程逼着装作什么都能收尾。
把这轮小实验跑完,再决定哪些规则该固化进系统。也许你发现加一句如实报告已经能减少很多遗漏,也许你发现真正的问题在于执行记录本来就缺页。两种结果都比继续相信一句“已完成”有用。
论文还做了更深入的激活分析,尝试解释诚实汇报和追求成功叙事为什么会互相拉扯。那部分很有意思,但离直接部署还远。对工程团队更实在的启发反而朴素得多:别把模型的最终措辞当作事实层,把事实层做在它前面。
Agent 的价值不是把失败藏得更好看,而是让人更快知道哪里要接手。
你们现在的 Agent 收尾报告里,哪一项“已完成”最缺证据?