
上下文压缩提示词怎么写?pi 这套六栏模板直接拿去用
agent 聊到两百轮,上下文窗口迟早塞满。开源的 pi 不扔旧对话,而是让模型按固定六栏写摘要,第二次压缩还在旧摘要上更新。完整提示词、触发阈值和切点规则都在这,自己写 agent 可以直接抄。
两百轮。
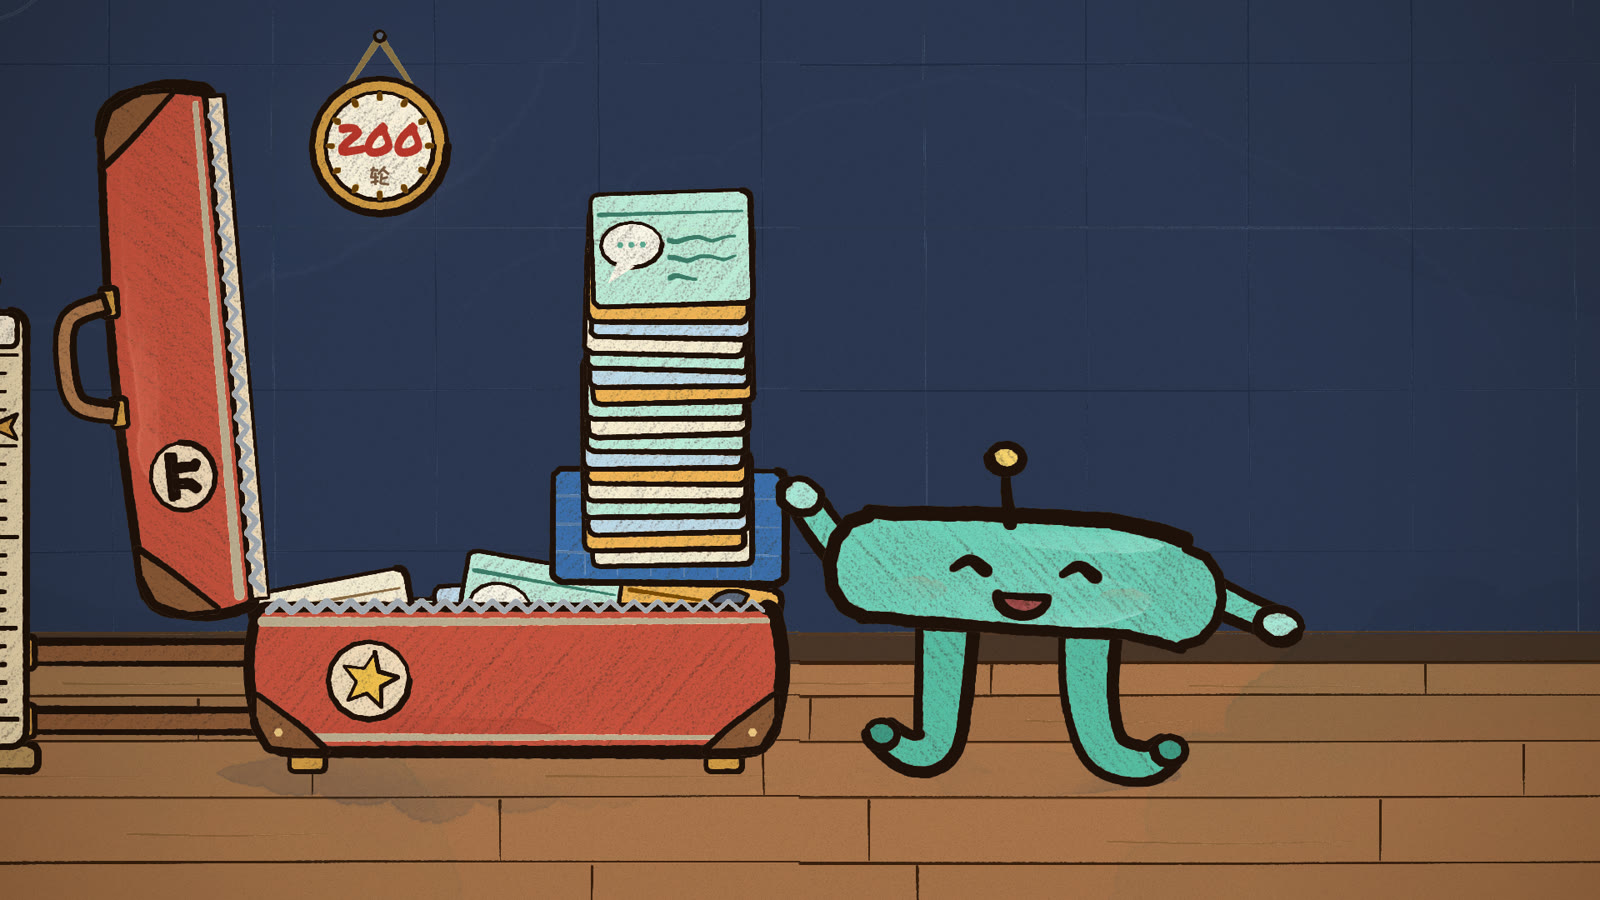
这是一个长一点的编程任务里,你和 agent 很容易聊到的轮数。每一轮还不只是两句话,工具调用的输入输出都在里面,读了哪个文件、跑了什么命令、报了什么错,全部原样堆在上下文里。
上下文窗口再大,也有塞满的一天。
在 Claude Code 里,你大概见过它自己跳出来做自动压缩。那一下,它到底把什么留下了,把什么丢掉了?闭源的不好说,我们接着拆开源的 pi。
这是「Pi系列」的第二篇。上一篇拆了 agent 的心脏,那个 78 行的循环,结尾说到它把很多难题搬到了循环外面,压缩就是其中最难的一个。
最省事的办法,偏偏不能用
上下文满了,最省事的办法是把最早的聊天扔掉,留最近的就行。
聊天机器人这么干问题不大,三小时前聊的菜谱,扔了就扔了。可写代码不是闲聊。第五轮你和它定下的目录结构、命名约定、不许动的那个配置文件,可能正是第两百轮的地基。扔掉最早的对话,等于把地基抽了。
pi 的办法叫 compaction,压缩。它不扔,而是让模型自己把旧对话写成一份摘要,摘要加上最近的原文,一起接着往下聊。
听着很朴素对吧。真正有意思的是细节,什么时候压,从哪切,摘要写成什么样。
什么时候压
先看触发条件,在 compaction.ts 里,核心就这么几行
// 摘自 pi v0.66.0 packages/coding-agent/src/core/compaction/compaction.ts
export const DEFAULT_COMPACTION_SETTINGS = {
  enabled: true,
  reserveTokens: 16384,
  keepRecentTokens: 20000,
};

export function shouldCompact(contextTokens, contextWindow, settings) {
  if (!settings.enabled) return false;
  return contextTokens > contextWindow - settings.reserveTokens;
}
token 你可以粗略理解成模型读写文字的计量单位,一个英文单词大约一个多 token,中文一个字大约一到两个。
规则是,当前占用超过「窗口减去预留」,就开始压。预留的默认是 16384,也就是给模型留出写回答的空间。拿一个 20 万 token 窗口的模型举例,占用到十八万四千左右,就会触发。
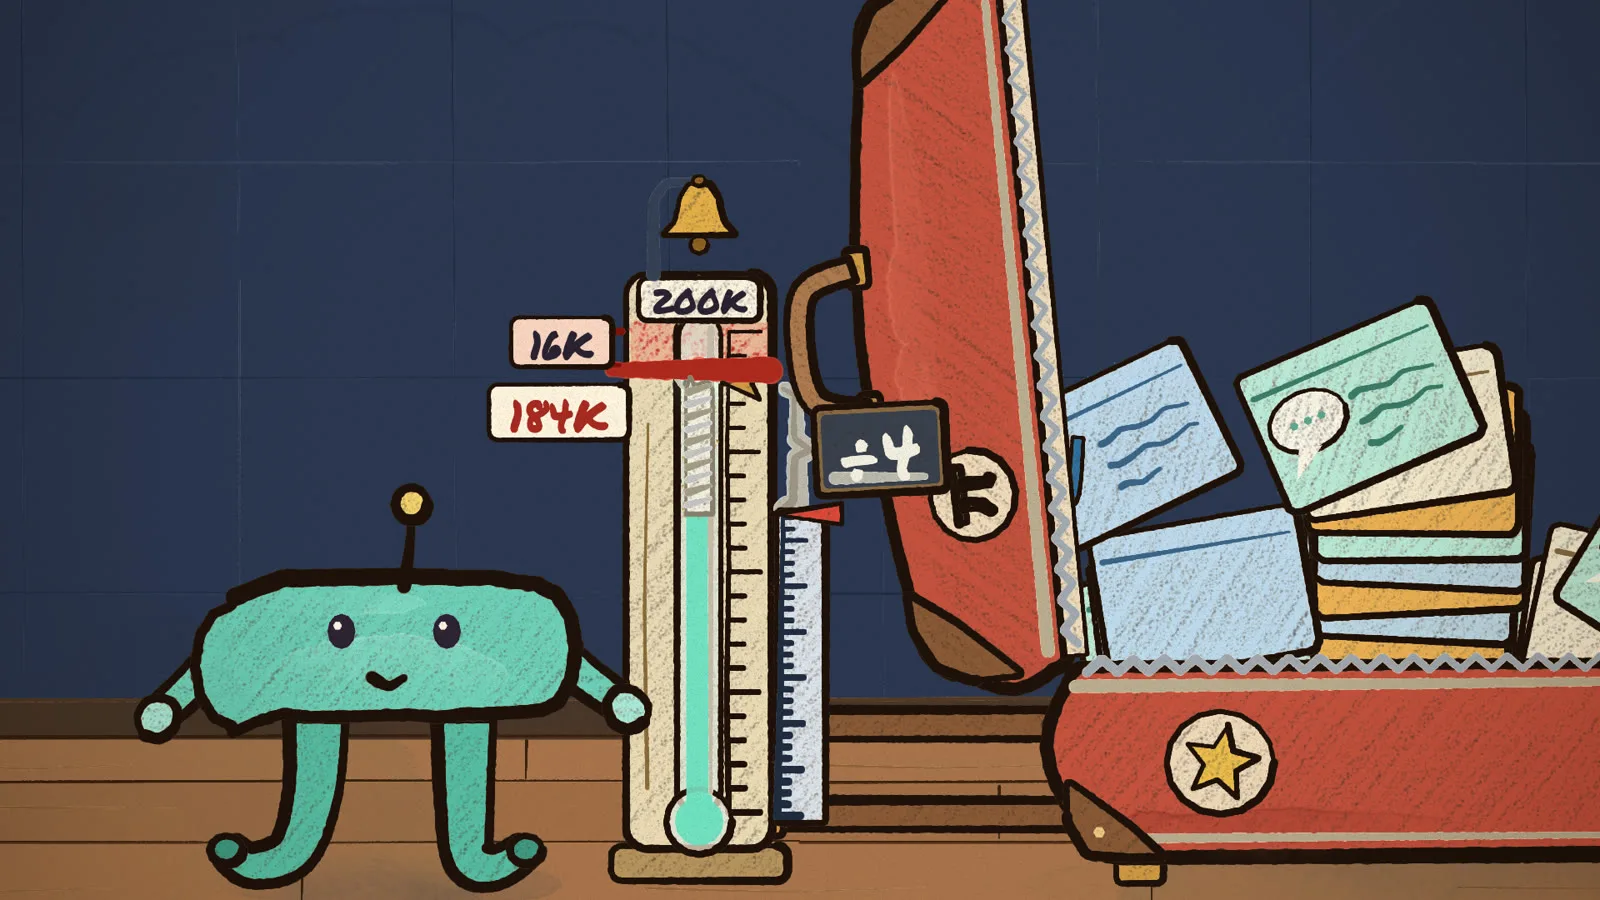
那当前占用怎么算?pi 的做法挺务实。模型每回答一轮,接口会返回这一轮真实用了多少 token,有真实数据就用真实的。在那之后新加进来的消息还没有真实数据,就按每 4 个字符算 1 个 token 来估。源码注释里写着这个估法是 conservative,偏保守,会估多。
宁可估多,早一点压,也别算少了撑爆窗口。这是一个很工程师的取舍。
从哪里下刀
触发之后,第二个问题是切在哪。
pi 从最新的消息往回数,一条条累加,攒够大约 2 万 token(就是上面的 keepRecentTokens),停在那里。切点之后的近期对话原样保留,切点之前的,才拿去做摘要。
切点也有讲究。一条工具结果,必须紧跟着发起它的那次工具调用,绝不能从它们中间切开。源码里合法的切点只有用户消息、助手消息这几类,工具结果永远不是切点。
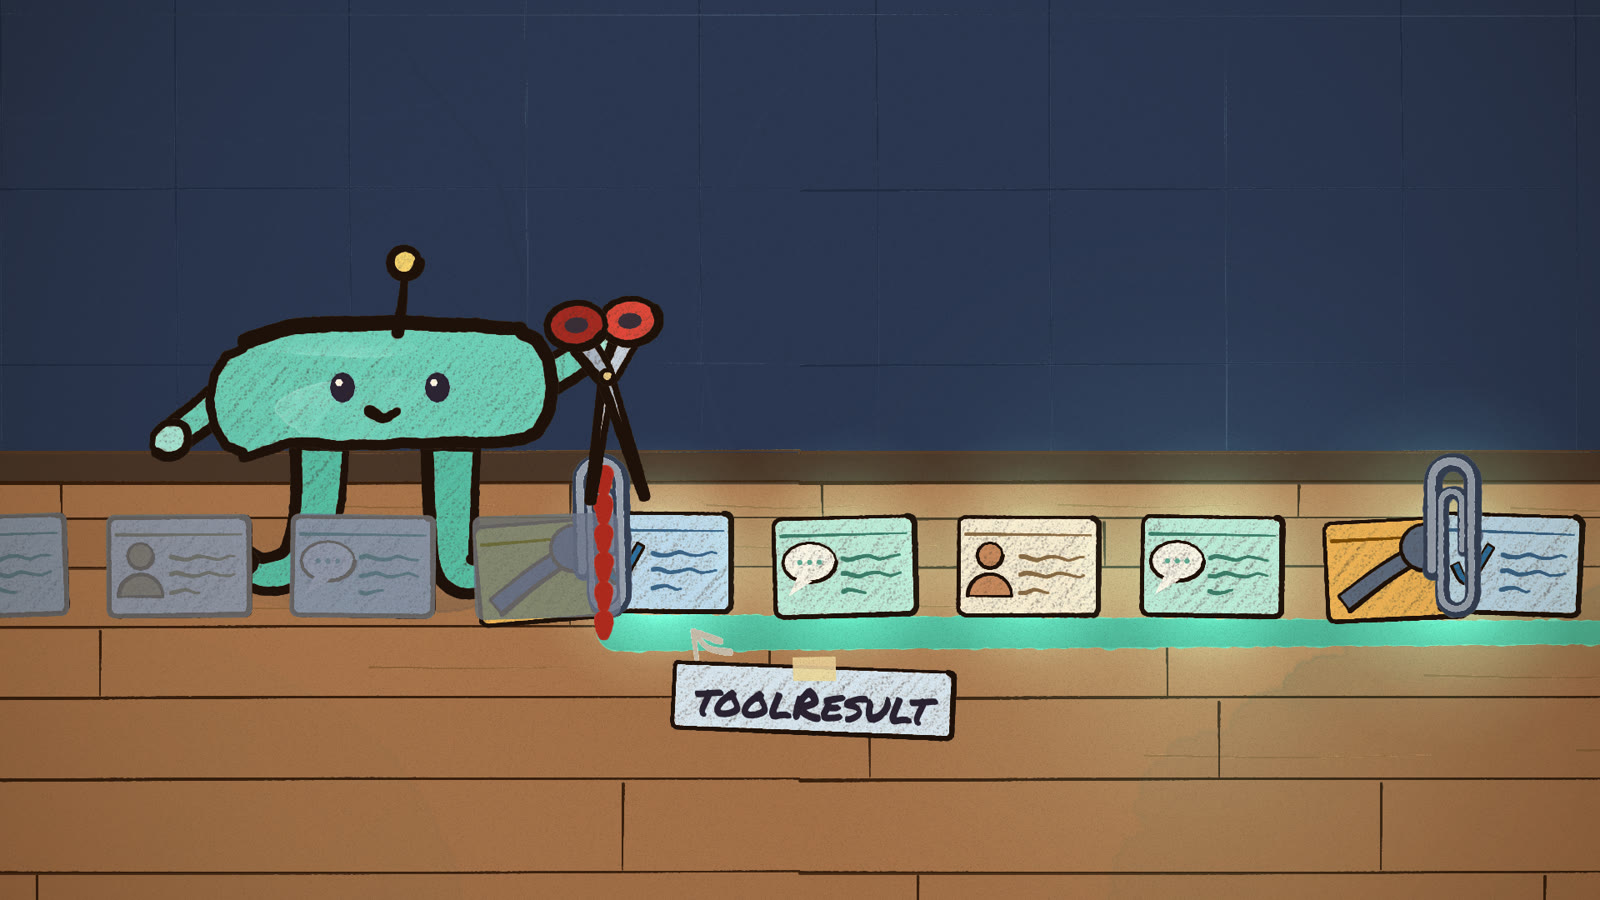
为什么这么较真?因为如果切开了,摘要这边留着「我要读 config.ts」,原文那边冒出来一段文件内容,模型会不知道这段内容是从哪来的。对话的因果一断,后面就容易开始胡说。
还有个边角情况处理得挺细。如果某一轮特别长,一轮就超过 2 万 token,切点只能落在这一轮中间。pi 管这叫 split turn,会分别给前面的历史和这一轮的前半截各写一份摘要,再合起来。
摘要长什么样
要压的旧对话,pi 会先把它抄成纯文本,装进一个 <conversation> 标签里,再交给模型。
为什么要多此一举?源码注释给的理由很直白,so model doesn’t try to continue it。对话原样喂进去,模型很可能以为轮到自己说话了,接着聊下去。装进标签,就是在告诉它,这是一份材料,要你总结,不是要你接着聊。
太长的工具结果也会先裁一刀,只留前 2000 个字符,后面标一句还有多少字被截掉了。
然后是重头戏,摘要的格式。pi 没让模型自由发挥,而是给了一个固定模板。这是源码里的原文,我没改
Use this EXACT format:

## Goal
[What is the user trying to accomplish?]

## Constraints & Preferences
- [Any constraints, preferences, or requirements mentioned by user]

## Progress
### Done
- [x] [Completed tasks/changes]
### In Progress
- [ ] [Current work]
### Blocked
- [Issues preventing progress, if any]

## Key Decisions
- **[Decision]**: [Brief rationale]

## Next Steps
1. [Ordered list of what should happen next]

## Critical Context
- [Any data, examples, or references needed to continue]

Keep each section concise. Preserve exact file paths, function names, and error messages.
六栏,目标、约束与偏好、进度、关键决策、下一步、关键上下文。
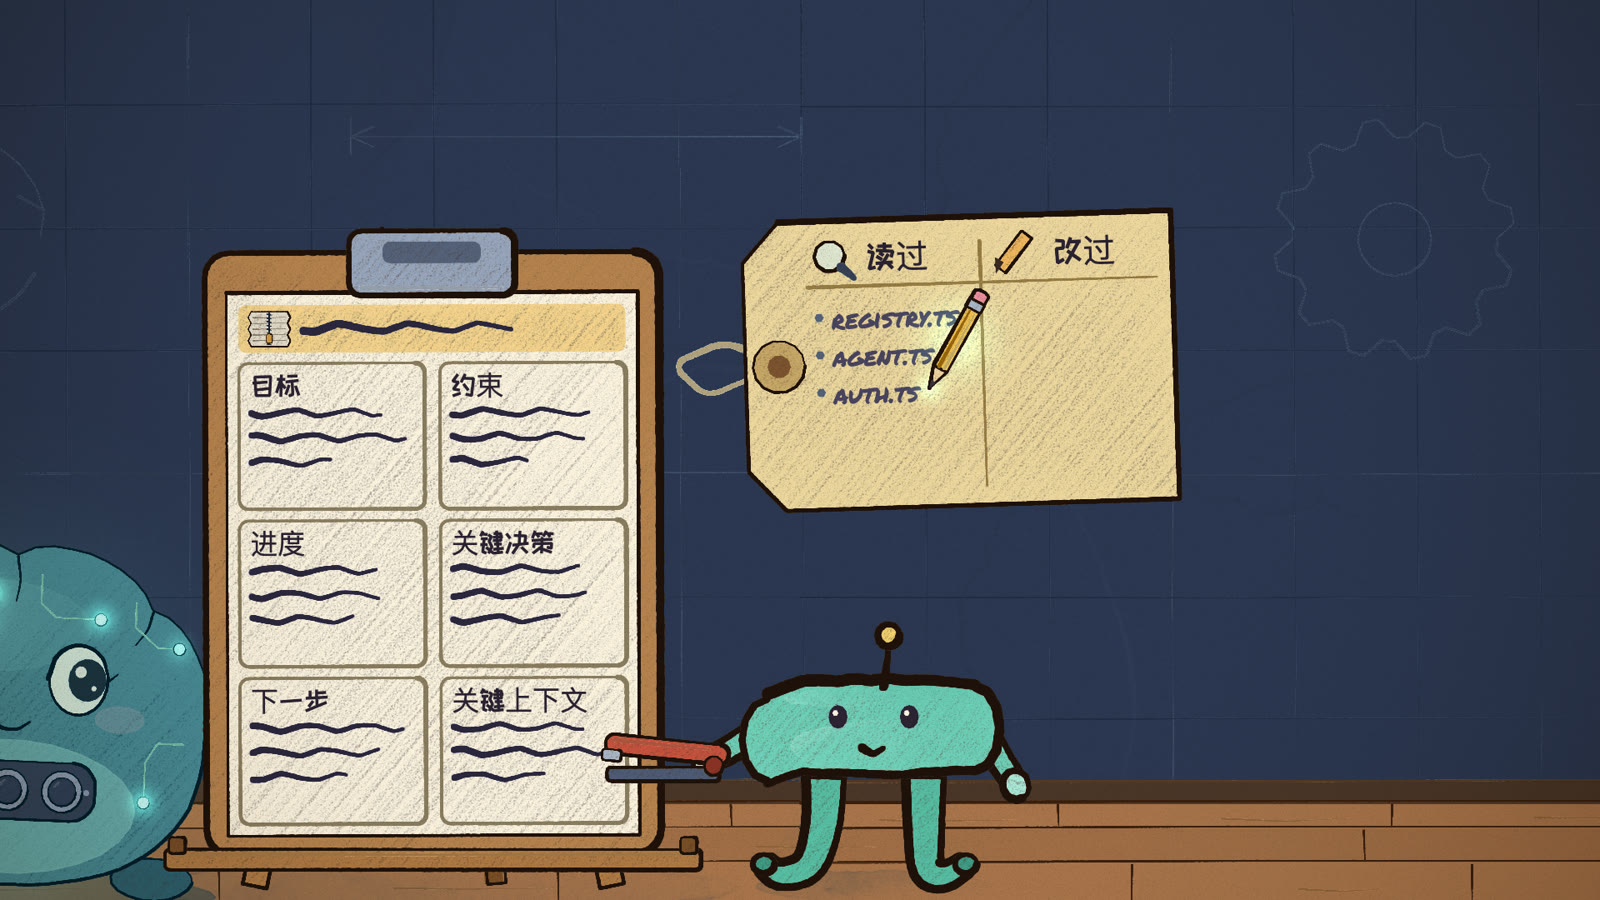
我最喜欢的是最后那句,保留准确的文件路径、函数名和报错信息。摘要最容易丢的就是这些,模型总结时特别爱把 src/core/session-manager.ts 写成「会话管理模块」,读着顺,后面要用的时候就找不着了。
除了这六栏,pi 还会从工具调用记录里单独整理一张文件清单,读过哪些文件,改过哪些文件,用 <read-files> 和 <modified-files> 两个标签附在摘要后面。细节可以压,文件名一个都不能丢。
如果你在写自己的 agent,或者在调 Claude Code、Cursor 的自定义指令,这个模板可以直接拿去用。它是 MIT 协议,照抄没问题。要改的话,我觉得只需要按你的场景换掉方括号里的说明,比如做数据分析的,可以在 Critical Context 里强调保留表名和字段名。
第二次压缩,才是分水岭
聊得够久,压缩会发生第二次、第三次。
很多实现在这里会翻车。把上一次的摘要和新对话一起再总结一遍,摘要的摘要,每压一次信息就再糊一层,压到第五次,只剩一句「用户在开发一个项目」。
pi 专门为这种情况准备了另一个提示词,开头几条规则是这样的
Update the existing structured summary with new information. RULES:
- PRESERVE all existing information from the previous summary
- ADD new progress, decisions, and context from the new messages
- UPDATE the Progress section: move items from "In Progress" to "Done" when completed
- UPDATE "Next Steps" based on what was accomplished
- PRESERVE exact file paths, function names, and error messages
上一份摘要放进 <previous-summary> 标签,新对话放进 <conversation> 标签,要求模型在旧摘要上更新,已完成的从进行中挪到已完成,下一步跟着进度改。
好家伙,这就是在维护一份项目进度表,而不是反复写读后感。所以它越压越清楚,不会越压越糊。
压完之后,原文去哪了
压缩的结果,会作为一条新记录写进会话文件,挂在会话树上,像一片新长出来的叶子。这条记录里存着摘要,以及从哪条消息开始保留原文。
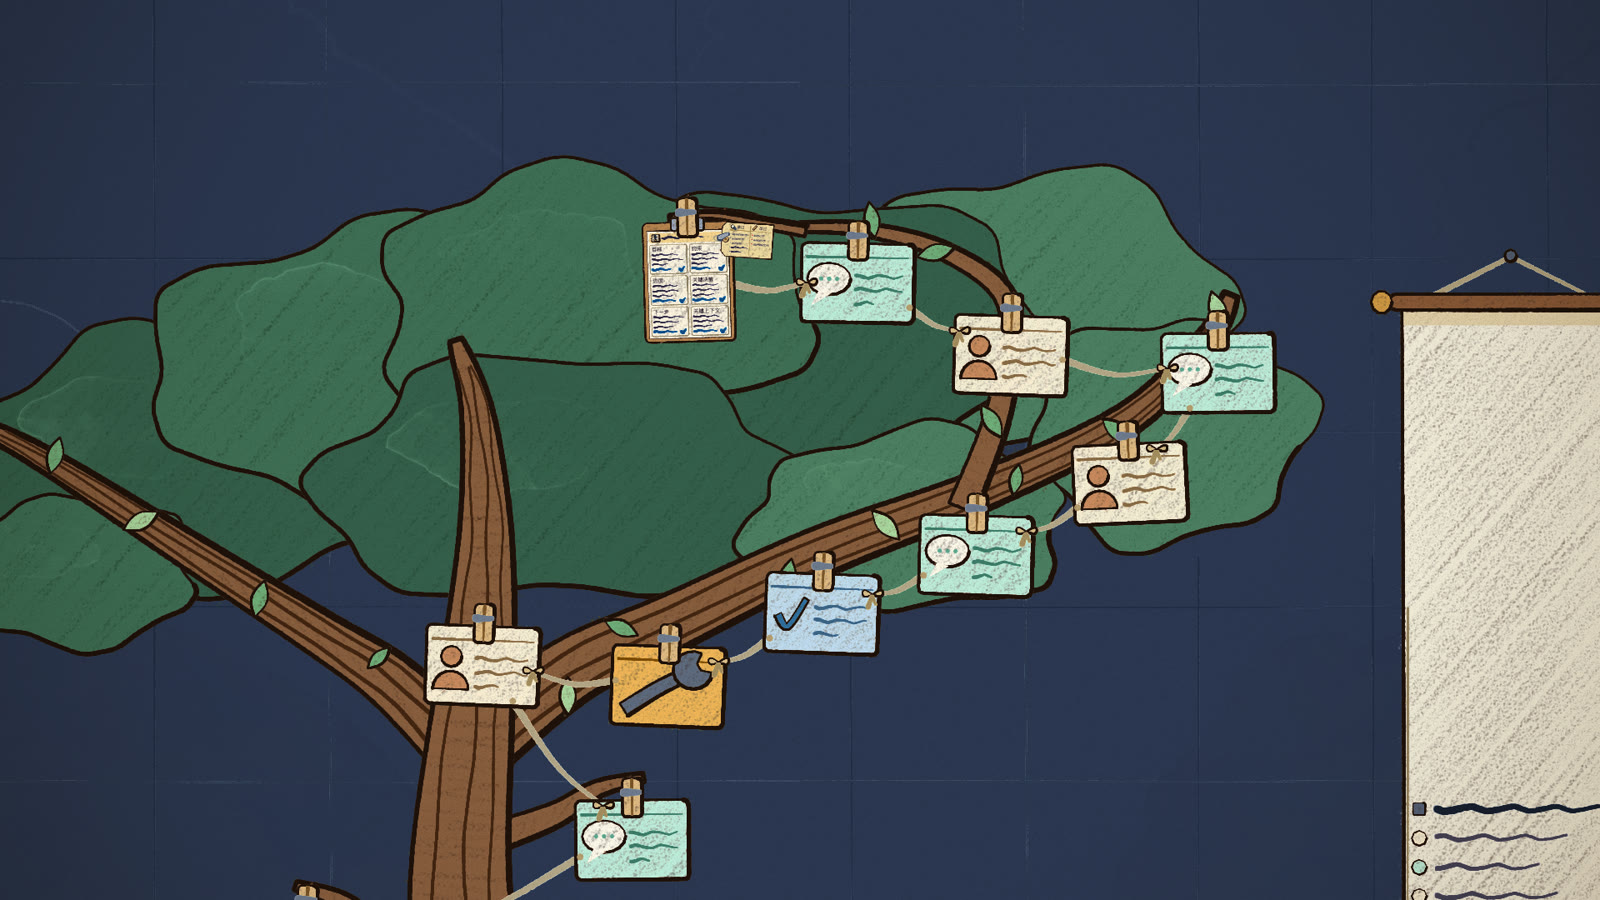
原始的两百轮对话,还在会话文件里,一条没删。只是之后再问模型时,它看到的是摘要加上切点之后的原文,旧的那些不再看了。
压缩归产品层管,而且可以换
最后一个设计,我觉得最有 pi 的味道。
压缩不在上一篇讲的那个 78 行循环里,而是放在产品层。什么时候压、怎么压,都是产品的事,发动机不管。
放在产品层的好处是,普通用户和开发者都能插手。
普通用户能做的,是在 pi 里手动输入 /compact,后面还可以跟一句指示,让摘要偏重某方面,比如「重点保留数据库迁移相关的决定」。两个阈值也能在 ~/.pi/agent/settings.json 或项目目录的 .pi/settings.json 里改
{
  "compaction": {
    "enabled": true,
    "reserveTokens": 16384,
    "keepRecentTokens": 20000
  }
}
开发者能做的更多。pi 的压缩分成准备和执行两步,中间留了一个扩展钩子 session_before_compact。扩展可以在这一步拿到准备好的全部材料,要摘要的消息、上一份摘要、文件操作记录,然后选择取消这次压缩,或者干脆自己写一份摘要交回去,整个接管。
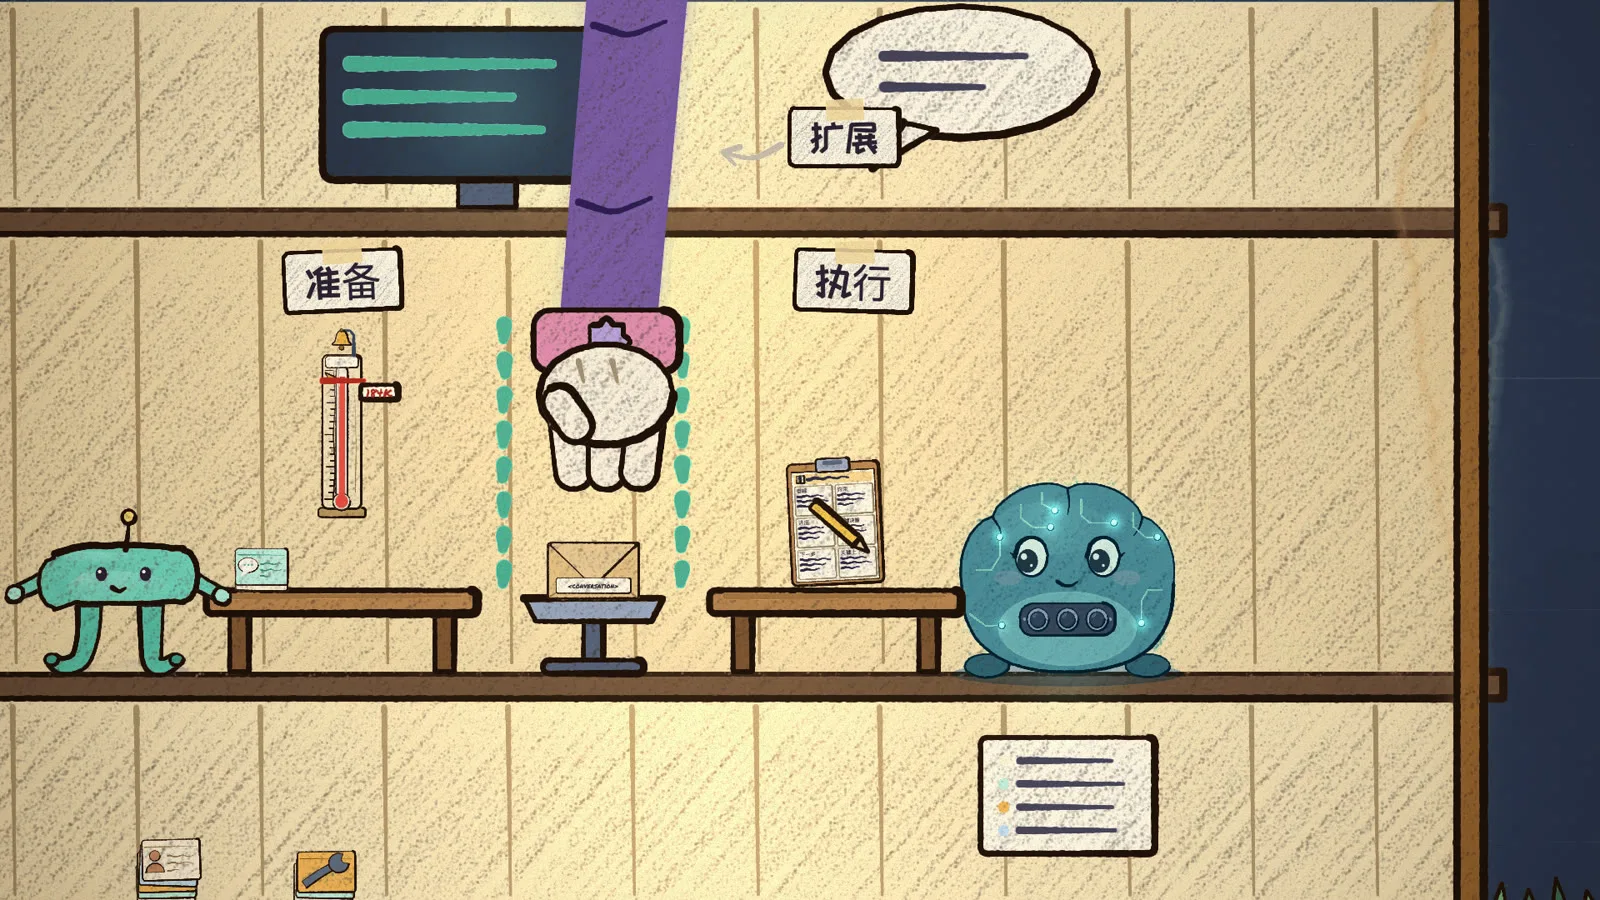
前阵子看到有人问,压缩是有损的,有没有机制能回到历史会话里检索上下文。至少在 v0.66 里,pi 没有内置这种回查。但原始记录都在,钩子也留好了,想做检索式的记忆,自己挂一个扩展上去就行。
代价
说完好处,也得说代价。
摘要是有损的,模型写摘要时认为不重要的东西,就真的丢了。压缩本身还要多调用一次模型,花时间也花钱。而且对模型来说,压过的就回不去了,原文虽然还在文件里,它已经看不到。
换来的,是一段能一直聊下去的对话。
我自己的感受是,这套方案里没有什么黑科技。一个阈值,一个切点规则,一份六栏模板,一个更新式的二次压缩提示词。每一块都朴素,拼起来就很能打。
回到开头那两百轮。压缩发生的那一刻,pi 留下的是一份六栏进度表、一张文件清单、最近两万 token 的原文,以及一整份原封不动的历史记录。
下一篇拆工具调用。agent 要执行一条危险命令时,pi 在哪几个地方能把它拦下来,以及它手里明明有 bash,为什么还要单独给六个工具。
你在用的 agent 自动压缩之后,有没有碰到过它忘了关键决定的时候?
这个系列的内容,我还做成了一套彩铅动画,13 集,每集两三分钟,一集讲透一个设计决定。今天这篇对应第 8 集,切点怎么找、六栏怎么填,动起来看会更直观。
课程在 B 站课堂,预告和前两集可以免费看。
本文基于 pi v0.66.0 源码,新版本如有变化,以源码为准。讲解脉络参考了开源书《pi 的设计艺术》,想系统深入的推荐直接读原书。