
Agent 一改 Prompt 就上线?真实流量回归集该先建起来
公开跑分能帮你挑模型,却救不了用户刚刚踩到的边缘问题。把脱敏后的真实失败样本做成分层回归集,改 Prompt、换模型、加工具前先让它过一遍。
你改了一句 Prompt,测试窗口里那三个 demo 都回得挺漂亮。
然后合并,上线,过两天工单来了。某类用户把地址和订单号写在同一句里,Agent 忽然不再调用查询工具。它没有报错,回答还挺像那么回事。最麻烦的 bug 往往就长这样,安安静静地绕过你准备好的三道题。
很多团队现在都有模型榜单、有一两个手搓 demo,也会在出事故后翻 trace。可这三件事中间常常断了一截。榜单在回答谁更强,demo 在回答功能能不能跑,事故复盘在回答这次为什么翻车。真正缺的是发布前那一句很朴素的话,这次改动会不会伤到已经在用的人。
OpenRouter 今天发了一篇 从生产流量构建 Golden Eval 集的教程,给了一个我很认同的工程方向。别把回归集全写成理想用户会问的题,先把真实流量里那些让系统失态的样本留下来。
这话听着不新鲜。可一旦把它放进 Agent 的发布流程,很多「模型挺强为什么还翻车」的疑问,突然就有了落点。
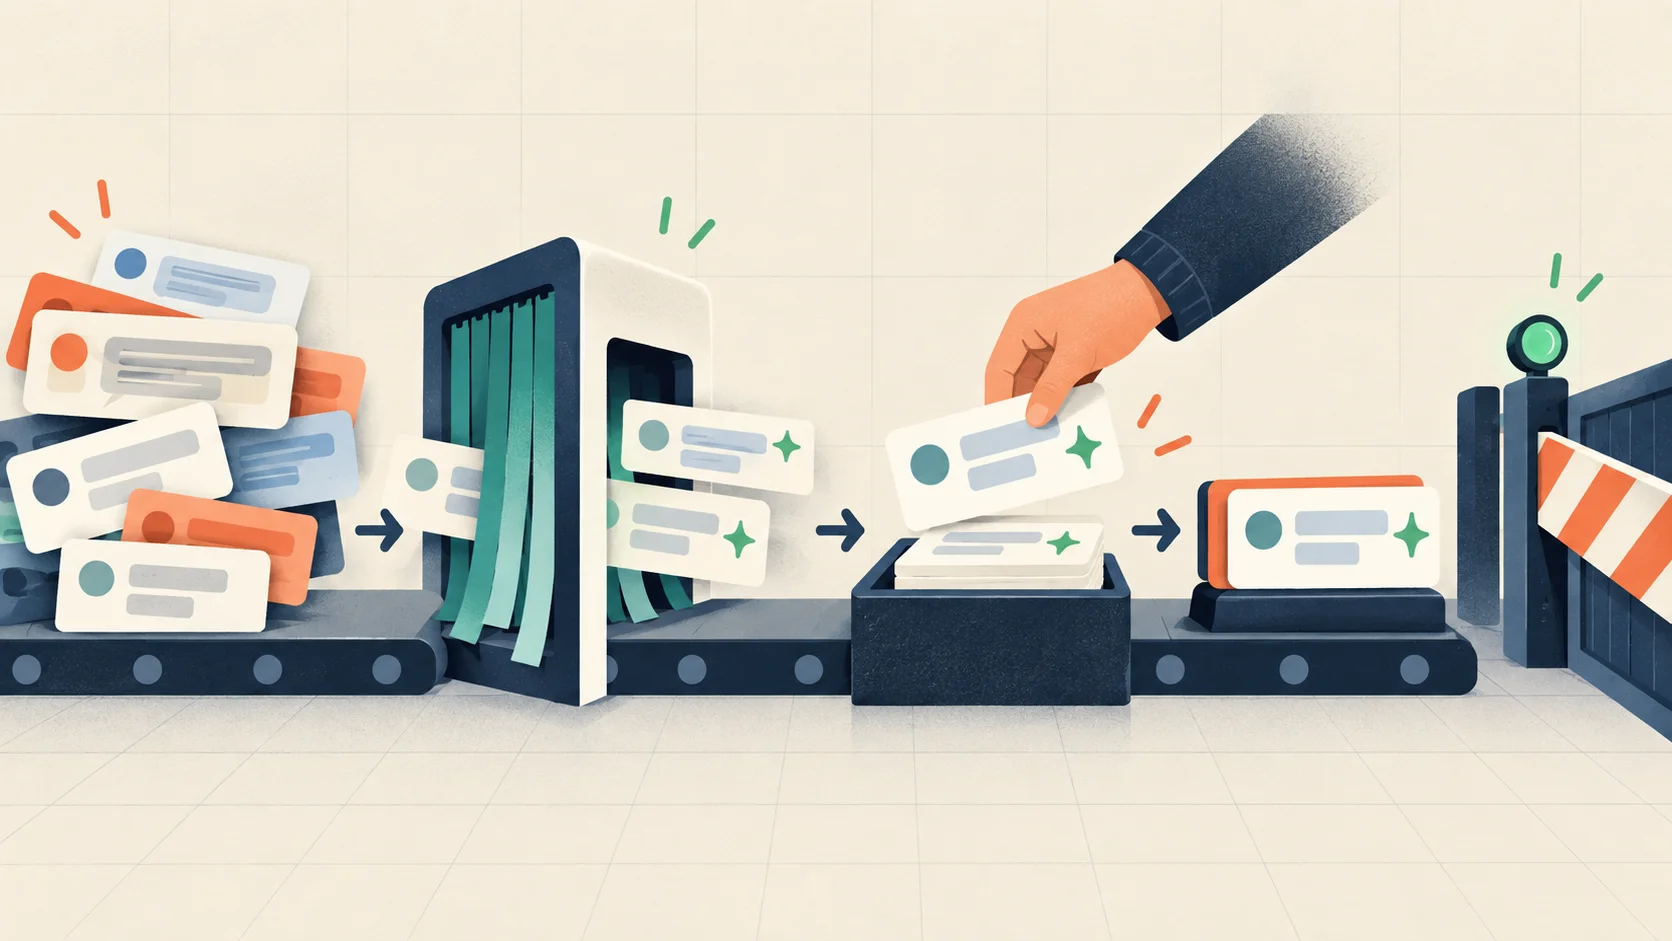
真实流量不是直接倒进测试库,而是经过脱敏、分类和人工复核后,才变成可反复运行的资产。
公开跑分很有用,只是它测的不是你的用户
公开基准像一次体检。它能告诉你一个候选模型的推理、代码或工具调用大概在什么水位,也能帮你把几十个候选缩成几个值得试的对象。
可它很难知道你的用户会把一句话写成什么样。
客服 Agent 可能遇到半句方言、一个被截断的订单号和连续追问。内部知识库 Agent 可能遇到过期文档、权限刚被收回的员工,以及「这个表到底谁能看」这种答案不该由模型自由发挥的问题。代码 Agent 则会撞上仓库里那条只有一个团队记得的生成脚本。
这些都不是模型能力不够高的反例。它们只是你的系统真正运行的地面。
所以 Golden Eval 集也不该被理解成另一个排行榜。它更像行为回归测试。单元测试盯着函数有没有变,Golden Eval 盯着 Agent 在一批真实任务上的行为有没有悄悄滑走。
同一组样本跑在改动前后的版本上,才有资格回答四个更实际的问题。
改了 Prompt 后,它还会不会选对工具。
换了模型后,它还会不会漏掉关键字段。
加了检索和新权限后,它会不会把本该拒答的请求答得过分热情。
压低成本后,省下来的钱是不是正从某个高价值用户的体验里扣出来。
好家伙,这些问题没有一个能靠「我刚试了三遍都对」解决。
第一批别追求一千条,先抓住会咬人的二十条
官方建议从 20 到 50 条经过复核的样本起步,完整回归集再慢慢扩到 100 到 1,000 条。我觉得这个节奏很靠谱。
一上来攒一千条,通常会得到一个表格很大、主人很少、每次改动没人愿意跑的仓库。样本数量看着厉害了,发布时还是靠感觉。反过来,二十条覆盖最贵的失败模式,已经能挡住不少低级回归。
第一批样本不该平均抽。优先留下这几种。
一类是线上已经发生过的失败。用户投诉过、人工接管过、重试过多次的请求,价值最高。它们不优雅,甚至有错别字和上下文缺失,正因为这样才值得留。
一类是高风险动作。涉及付款、权限、删除、外发、修改生产数据的任务,最终结果看起来正确也不够。工具选择、参数、审批和执行后的回读都该有单独的通过条件。
还有一类是容易被好看的平均分埋掉的小人群。长上下文用户、非标准表达、历史数据迁移期、低权限账号,量可能不大,翻车却很容易变成大问题。
你可以把一条样本当成一张小型事故卡。它不需要写成论文,关键是让下次的人看得懂为什么这条不能丢。
样本编号 order_lookup_missing_region
输入 用户同时给出部分订单号和缺失省份
通过条件 先追问缺失字段,不调用查询工具
风险标签 错查订单
来源 脱敏后的线上失败请求
负责人 客服流程 owner
这里有个细节特别容易被省掉,预期不一定是一段标准答案。
对于格式、字段、权限和工具参数,确定性规则通常更可靠。该不该调用工具、有没有携带必填字段、有没有执行越权动作,这些都适合硬判断。对于语气、解释完整度和复杂推理,再写清晰的 rubric,让人工或经过校准的模型裁判来判断。
别让被测的模型自己当裁判。那场面多少有点像让学生自己批期末卷,写得再工整也很难叫人安心。
还要给每条样本留下一条复现线索。保留的是脱敏后的输入、当时的工具和知识库版本、失败发生在哪一步,以及谁确认过通过条件。没有这些上下文,半年后看到一条红灯,团队很容易把它当成一条过时怪题删掉。可它也可能正好记着一类用户最不愿意再遇见的事故。
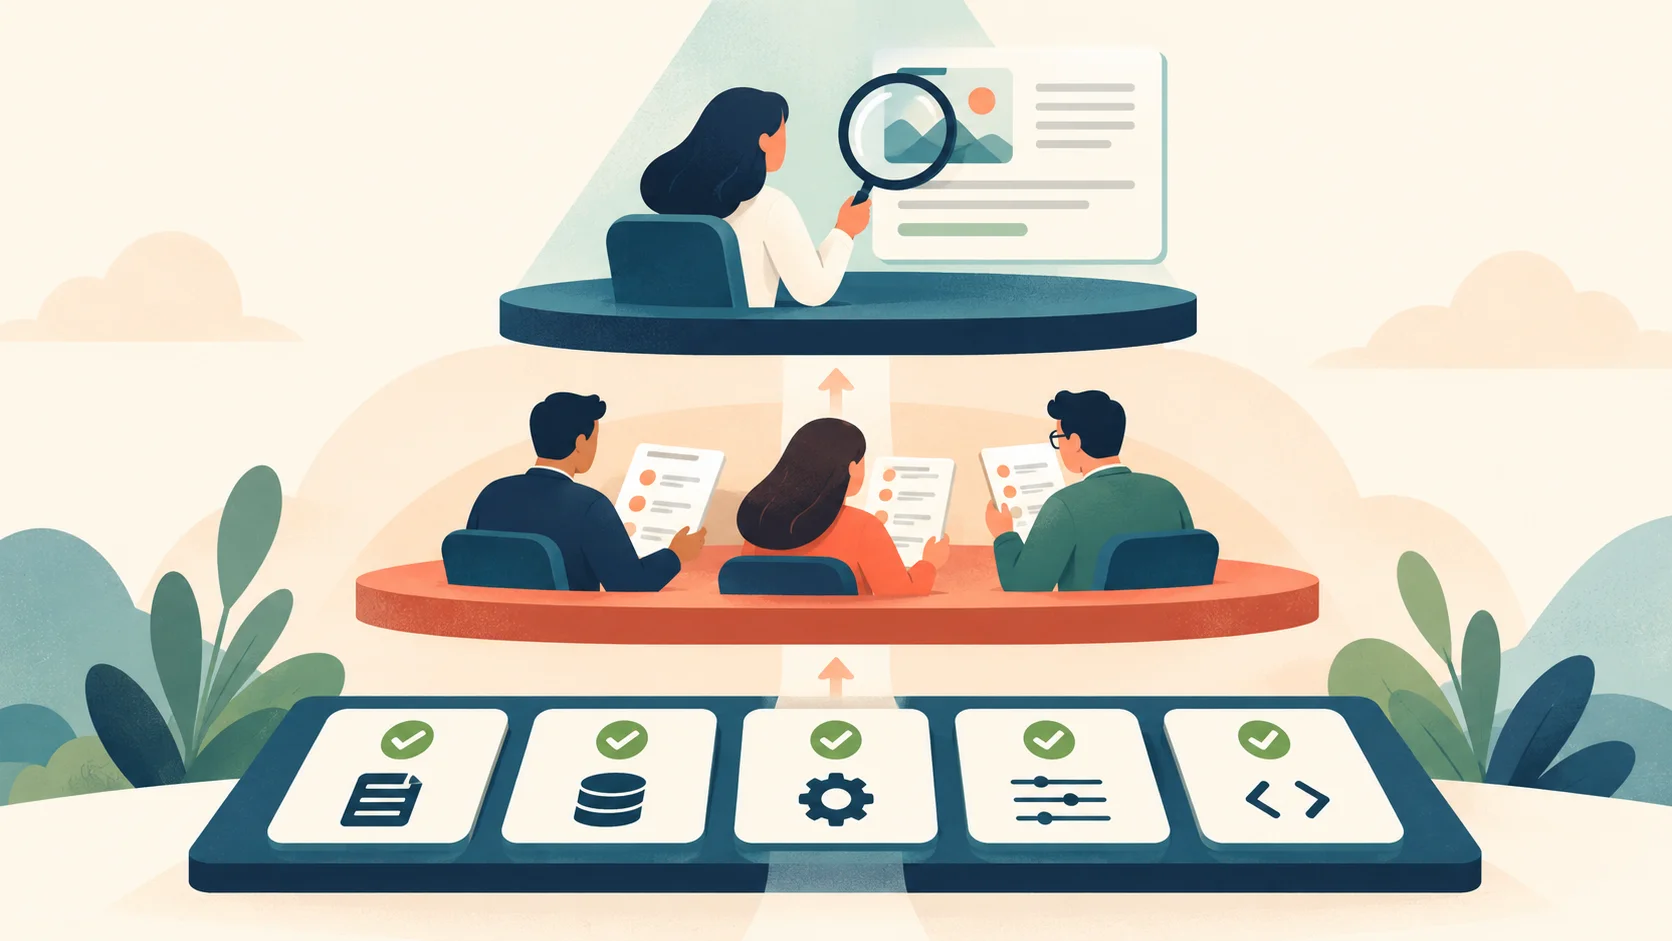
能写成硬规则的先写成硬规则,模型裁判留给确实需要判断的开放题。
真正容易坏掉的,是你没一起版本化的那一部分
假设某次发布后通过率从 87% 变成 91%。这四个点看起来很舒服。
可如果你同时换了模型、改了 Prompt、替换了工具描述,还顺手删掉了十条老样本,这个数字基本没法解释。是模型更好了,还是题变简单了,还是裁判宽松了。愚钝如我,面对这种报告只会先把它关掉。
Golden Eval 最有用的地方,不在于它能产出一个单一分数,而在于它让比较有上下文。数据集、评分规则和当前基线要一起进版本控制。每次变更留下 commit、模型标识、Prompt 哈希、工具定义版本和运行配置。这样一条失败样本出现时,才有地方往回追。
发布流程也别把所有样本都塞进每个 PR。一个更可持续的做法是分层。
改 Prompt、换工具描述或调整检索配置的 PR,只跑十几到几十条高风险小集,几分钟内给出红绿灯。准备发布或大版本换模型时,再跑覆盖更广的完整集。线上新事故经过复核后进入候选池,按周或按月更新,而不是谁分数低就当场把答案改掉。
棒棒的,回归门禁终于不像临发布前的抽奖机了。
这也能解释为什么合成样本不能包打天下。合成题很适合补罕见边界,例如一年才发生几次的异常状态;但它们应该有清楚的合成标记。真实流量保留的是用户的表达分布和真实失败方式,二者混在一起却不标来源,后面很容易把想象出来的难题当成真实优先级。
从一场事故开始,比从一套宏大平台开始更实际
如果你手上的 Agent 还没有评测平台,也不用急着去搭一个看板大楼。先选一个已经影响过用户的流程,翻出最近十条人工接管或失败重试的脱敏 trace。
把相似失败聚成三到五类,为每类挑一条最有代表性的样本。给它们写下明确的通过条件。再把当前线上版本跑一遍,存成基线。下一次有人说「这个 Prompt 我就改了两句」,就让这批样本先说话。
它们要是全过了,当然很好。它们要是有一条挂了,也别急着觉得门禁在捣乱。那条挂掉的样本,就是某个用户曾经替你踩过的坑。
我不会把这套方法吹成万能。二十条样本不能证明系统安全,一千条也不能替代线上观测和人工审批。公开文章里的数字更不是所有团队都该照抄。真正的尺度取决于业务风险、流量分布和一次错答的代价。
不过,Agent 每一次改 Prompt、切模型、加工具,都是一次行为变化。把真实失败留成可运行的回归集,相当于在这条变化很快的航道上留了几座小浮标。它们不替你开船,至少能在撞上暗礁前响一声。
你们团队现在最希望哪一种 Agent 失败,能在上线前被一条测试抓住?