
Fable 5.2 比 Opus 贵一倍,为什么干活反而更省?
单价是 Opus 5.5 的两倍,官方测下来拿到同样分数,每道题却只花一半,有的不到十分之一。这笔账怎么算、默认模型要不要换,文末给一份三档切换判断。
每百万输出 token 40 美元,是 Opus 5.5 的两倍。可在 Anthropic 自己的测试里,Fable 5.2 拿到和 Opus 5.5 一样的分数,每道题的花费只有它的一半,有一项不到十分之一。
单价更贵,干完一件事反而更便宜。11 月 9 日 Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2,我觉得最值得掰开看的就是这一点。跑分你今天大概已经刷到好几遍了,这篇只回答一个天天用 Claude 写代码的人马上会碰到的问题:默认模型要不要从 Opus 5.5 换成 Fable 5.2?
先交代素材边界。下面的分数、价格和每题成本都来自官方发布页和模型文档,我还没拿自己的项目做对照实测;涉及推断的地方,我会直接说是推断。
先把发布的硬信息交代清楚。Fable 5.2 的 API 价格是每百万 token 输入 8 美元、输出 40 美元,上一代 Fable 5.1 是 10 美元和 50 美元,两头都降了 20%。输出速度比 5.1 快最多 30%;另有可选的 fast mode,生成速度到 2.5 倍,价格也翻倍到 16 和 80 美元。
模型名 claude-fable-5-2,上下文 1M,单次最多输出 128K,所有付费订阅都能用,AWS、Google Cloud、Azure 同步上架。
Mythos 5.2 和它是同一个底模,只是网络安全和生物方向的护栏放得更松,只开放给审核过的机构,普通用户碰不到,这篇不展开。
「超越 Opus」,超在哪
官方表格一共 14 项测试。其中 3 项安全和生物测试的那一栏填的是 Mythos 5.2 的成绩,剩下 11 项是 Fable 5.2 自己的,这 11 项每一项都比 Opus 5.5 高。
写代码的人最该看的是这几行:
FrontierCode 2.0(agent 自主写代码)Fable 5.2 是 49.1%,Opus 5.5 是 45.5%。FrontierSWE v2(同样是 agent 改真实代码库)69.9% 对 62.3%。
Terminal-Bench-Science(在终端里完成科学计算类长任务)74.6% 对 58.7%。
Remote Labor Index(把真实远程外包活交给模型做)41.3% 对 21.3%,接近翻倍。
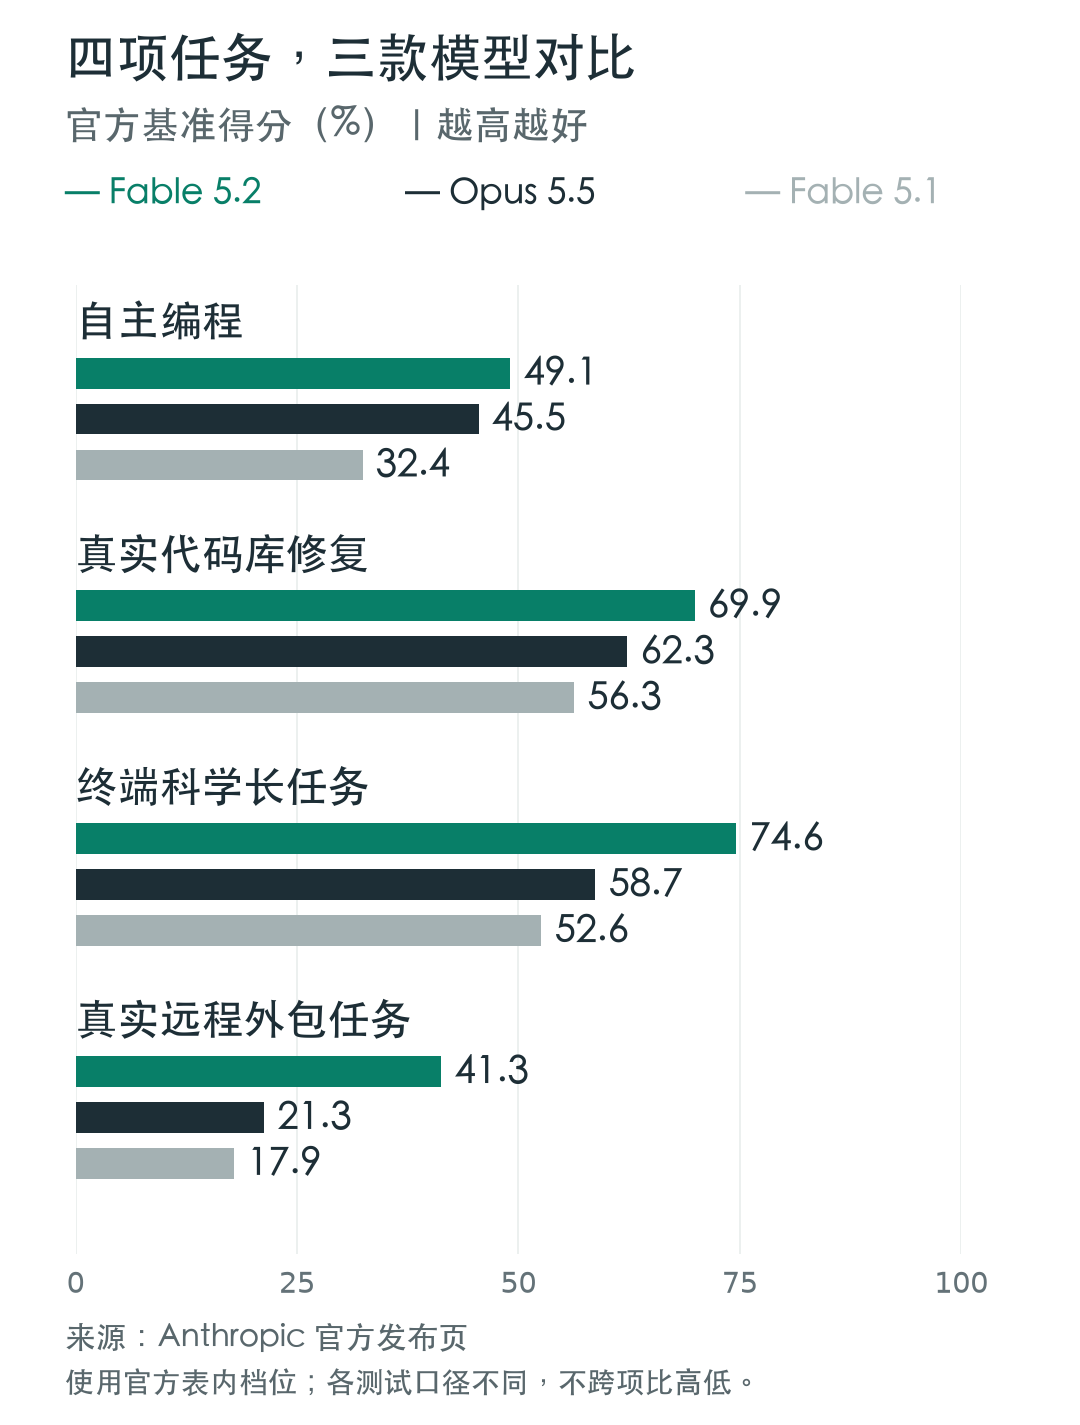
图:数据来自 Anthropic 发布页,推理档位以官方表格注释为准。
看出规律了吗?纯写代码的测试,领先是个位数;任务越长、步骤越多、越需要自己规划,差距拉得越开。
官方给的最狠例子是费马大定理的形式化证明,也就是把整套证明翻译成 Lean 这种机器能逐行检查的语言。1000 个 Fable 5.2 agent 并行,30 小时做完整套。同样的配置换成 Opus 5.5,18 小时只完成 26%,跑到 30 小时也几乎没再往前挪。
另一个例子是一组 agent 用早期版本把一个生产服务从 Python 迁到 Rust,启动快了约 26 倍。
这两个例子都是 Anthropic 自己的展示,你复现不了,但方向和表格对得上:Fable 5.2 拉开 Opus 的地方,是那种要连续干很久、中途不能走丢的活。
也有没赢的。商业流程自动化的 AutomationBench 上,Google 的 Gemini 4 Carbon 是 53.9%,比 Fable 5.2 的 51.4% 高。知识工作测试 AA-Briefcase 下面还有一行 Elo 分,Opus 5.5 的 1800 略高于 Fable 5.2 的 1785。所以这里说的「整体领先」,指的是 Anthropic 这张表里绝大多数项拿第一,不是每一项都通吃。
单价翻倍,每题为什么更省
这里得先说一个参数:effort,推理档位。现在的 Claude 模型都会先想再答,effort 决定它想多久,从 Low、Medium、High 到 Xhigh、Max,档位越高,烧的思考 token 越多,账单越厚。
官方这次给了四组「同分比成本」的数据:
FrontierCode 上,Fable 5.2 开 High 拿到 45.3%,基本追平 Opus 5.5 开到最高档的 45.5%,每题成本大约一半。agent 搜索测试 WANDR 上,Fable 5.2 开 Medium 就追平 Opus 5.5 的最高分,成本约四成。
Humanity’s Last Exam 上,Fable 5.2 开 Low 就追平 Opus 5.5 最高分,每题成本不到十分之一。
看图表的 Chartography 上,Fable 5.2 开 Medium 拿 66.4%,已经高过 Opus 5.5 开 Max 的 64.4%,成本同样不到十分之一。
账单等于单价乘 token 数。Opus 5.5 要开到最高档、想很久才够得着的分数,Fable 5.2 用低档位、想得少就够了。思考 token 省下来的那一截,比单价翻倍多出来的还多。
跑过 agent 的人对这个应该不陌生,账单里最肥的往往不是最后那几句回答,而是中间的思考、试错和重跑。一次做对,比便宜但要重跑三遍省得多。
还有一个容易被跳过的细节,在模型文档的价格注释里:缓存读取价。Fable 5.2 的缓存读取按输入价的 2.5% 收,Opus 5.5 按 5% 收。8 美元乘 2.5% 是 0.2 美元,4 美元乘 5% 也是 0.2 美元,每百万 token 一模一样。
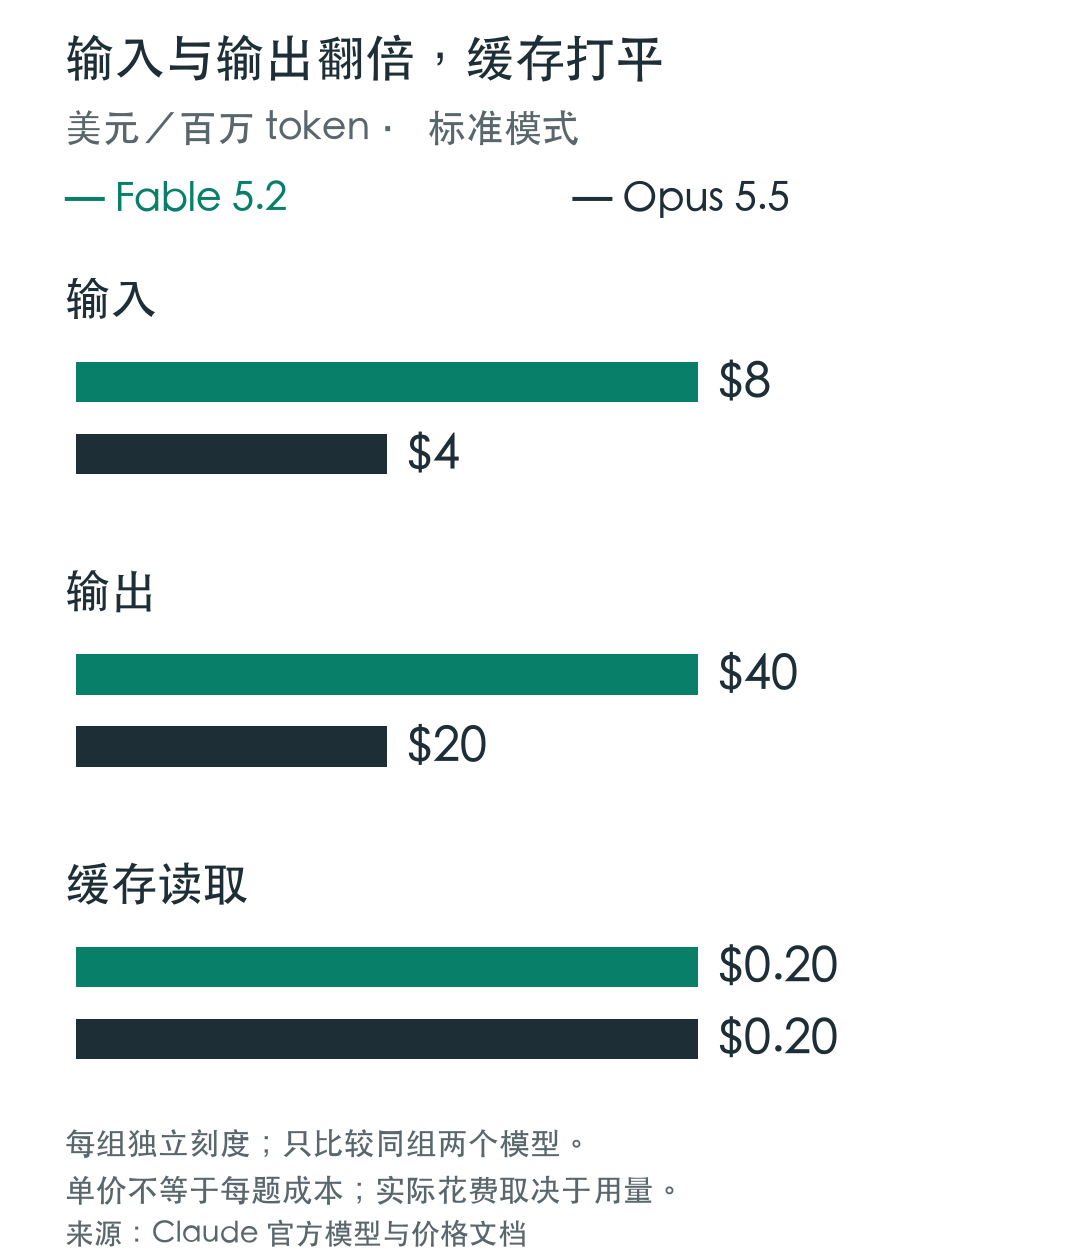
图:标准模式每百万 token 价格,美元。数据来自 Claude 官方模型与价格文档;各组独立刻度,单价不等于每题成本。
agent 长会话里,系统提示、工具定义、代码上下文每一轮都要重读一遍,大部分输入走的是缓存。这部分两个模型打平,差价只集中在输出和没命中缓存的新输入上。如果你的工作流缓存命中率高,Fable 5.2 实际贵出来的比例,比价目表上的「两倍」小一截。
不过这四组成本数据是官方挑的测试、官方算的账,没公开每题的 token 明细。你的任务未必落在同一条曲线上,最后还得拿自己的账单说话。
官方自己还在劝你用 Opus
发布页里有一句话很实在:
For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver, and then switch to a different model as required.
大多数写代码和知识类任务,官方建议还是从 Opus 5.5 起步,需要时再换。模型文档说得更具体:要么是很吃推理的长链路 agent 任务,要么是 Opus 5.5 开到高档位、评测还是不过关的时候,再上 Fable 5.2。
刚算完「Fable 每题更省」,官方又劝你别急着换,这不矛盾。
我的理解是,同分半价这件事,只在任务难到 Opus 必须开高档的时候才出现。改个接口、补几个单测这种活,Opus 5.5 开 Medium 一次就对,本来就没烧多少思考 token,换成 Fable 5.2 省不下什么,单价却实打实翻倍。这是我根据官方数据的推断,官方没有公布简单任务上的成本对比。
订阅用户还有一层限制。Pro 和标准 Team 席位里,Fable 最多只能占每周额度的 50%;发布期间,符合条件的付费用户按订阅时长拿 1 到 3 次 Fable 额度重置,细则在官方说明。
用 API 的要留意另一个默认值:Fable 5.2 在 API 里默认 effort 是 high,在 Claude 应用和 Claude Code 里默认是 Medium。直接调 API 不设 effort,用的就是更贵的那一档。
做安全的朋友再记一条。Fable 5.2 的误拦比 5.1 少了约 55%,但渗透测试、写 exploit 这类请求大多仍会被拦,被拦下的网络安全问题会转交 Opus 4.8 回答。真要做这类活,得走官方的网络安全审核计划拿 Mythos。
要不要换,按任务分三档
我自己的判断是,不用整体切,按任务分档走。
第一档,日常改 Bug、写 CRUD、补测试,留在 Opus 5.5。 这类任务 Opus 开 Medium 基本一次过,Fable 的每题成本优势吃不到,反而占掉订阅里那 50% 的 Fable 额度。
第二档,Opus 5.5 要开到 Xhigh 或 Max、或者经常要你重跑两三遍的任务,换 Fable 5.2 开 Medium 或 High 试一轮。 官方那几组「同分更省」出现的就是这个区间。
第三档,长链路 agent 任务,直接上 Fable 5.2。 跨多个模块的迁移、几十步的终端操作、要连续跑几个小时的活。表格上差距拉得最开的就是这类,费马定理那个例子也是。
试的方法不复杂。从上周的工作里挑 5 到 10 个 Opus 5.5 开高档才搞定、或者重跑过的任务,原样各跑一遍:Claude Code 里用 /model 切到 Fable 5.2;API 里把 model 换成 claude-fable-5-2,同时显式写上 effort。
最后看三个数:一次通过率、总 token、Console 里的实际花费。三个数都站得住,再把这类任务的默认模型改掉。
单价贵一倍,干完一件事反而省钱,这句话成不成立,取决于你的活难不难。对大多数日常任务,Opus 5.5 还是那个性价比最高的主力;Fable 5.2 是你把活交出去、几个小时后回来收结果时,更靠得住的那一个。
你手上有没有那种 Opus 5.5 开到最高档还要重跑的任务?在评论区说说是哪一类,我想攒一批真实任务,做一次两个模型的正面对照。