
产品视频只多 0.05 美元,Google 把“重抽”改成“改稿”
Gemini Omni 1.2 Flash 的关键不只是把视频拉到 15 秒,而是把低清打样、局部对话修改和最终升采样接成一条更像剪辑的流程。附一份不靠重抽的镜头工作单。
一条 720p 的 AI 视频,从 10 秒拉到 15 秒,账单只多了 0.05 美元。
这个数字不是促销海报上的文字游戏。按 Google 刚公布的价格算,Omni 1.1 Flash 的 720p 是每秒 0.10 美元,一条 10 秒片大约 1.00 美元;新的 Gemini Omni 1.2 Flash 是每秒 0.07 美元,一条 15 秒片约 1.05 美元。
好家伙,多了五秒,钱几乎没多。
但我觉得更该盯着的不是那五秒,而是 Google 在这次更新里偷偷换掉的一件事:视频生成开始更像改稿,不再只能反复重抽。
做过产品演示、商品页动图、短广告的人大概都认识这个坑。第一版终于能看了,偏偏产品包装上的字漂了;第二版字对了,镜头节奏又垮了;第三版人物脸终于没变形,背景却像被临时换了一个宇宙。每一次“重新来一条”,都在把已经正确的部分一起扔进回收站。
Google 在 11 月 5 日的官方公告 里给 Omni 1.2 Flash 加的东西,正好瞄着这个返工口:最长原生片段从 10 秒到 15 秒;可以在同一条片上继续对话,换背景、光线、天气或画幅;参考图、短动作片段和音频线索可以一起喂进去。它不保证每条片都稳,但至少把“哪里不对,就只改哪里”这件事放进了产品能力里。
这和“模型更会拍视频了”是两回事。
先算一笔不太浪漫的账
下面这张图只用官方公布的时长与 720p 标价做对比。左边是单条上限,右边是每秒成本;10 秒和 15 秒的完整片段费用,是相乘得出的估算,不是 Google 承诺的实际结算金额。
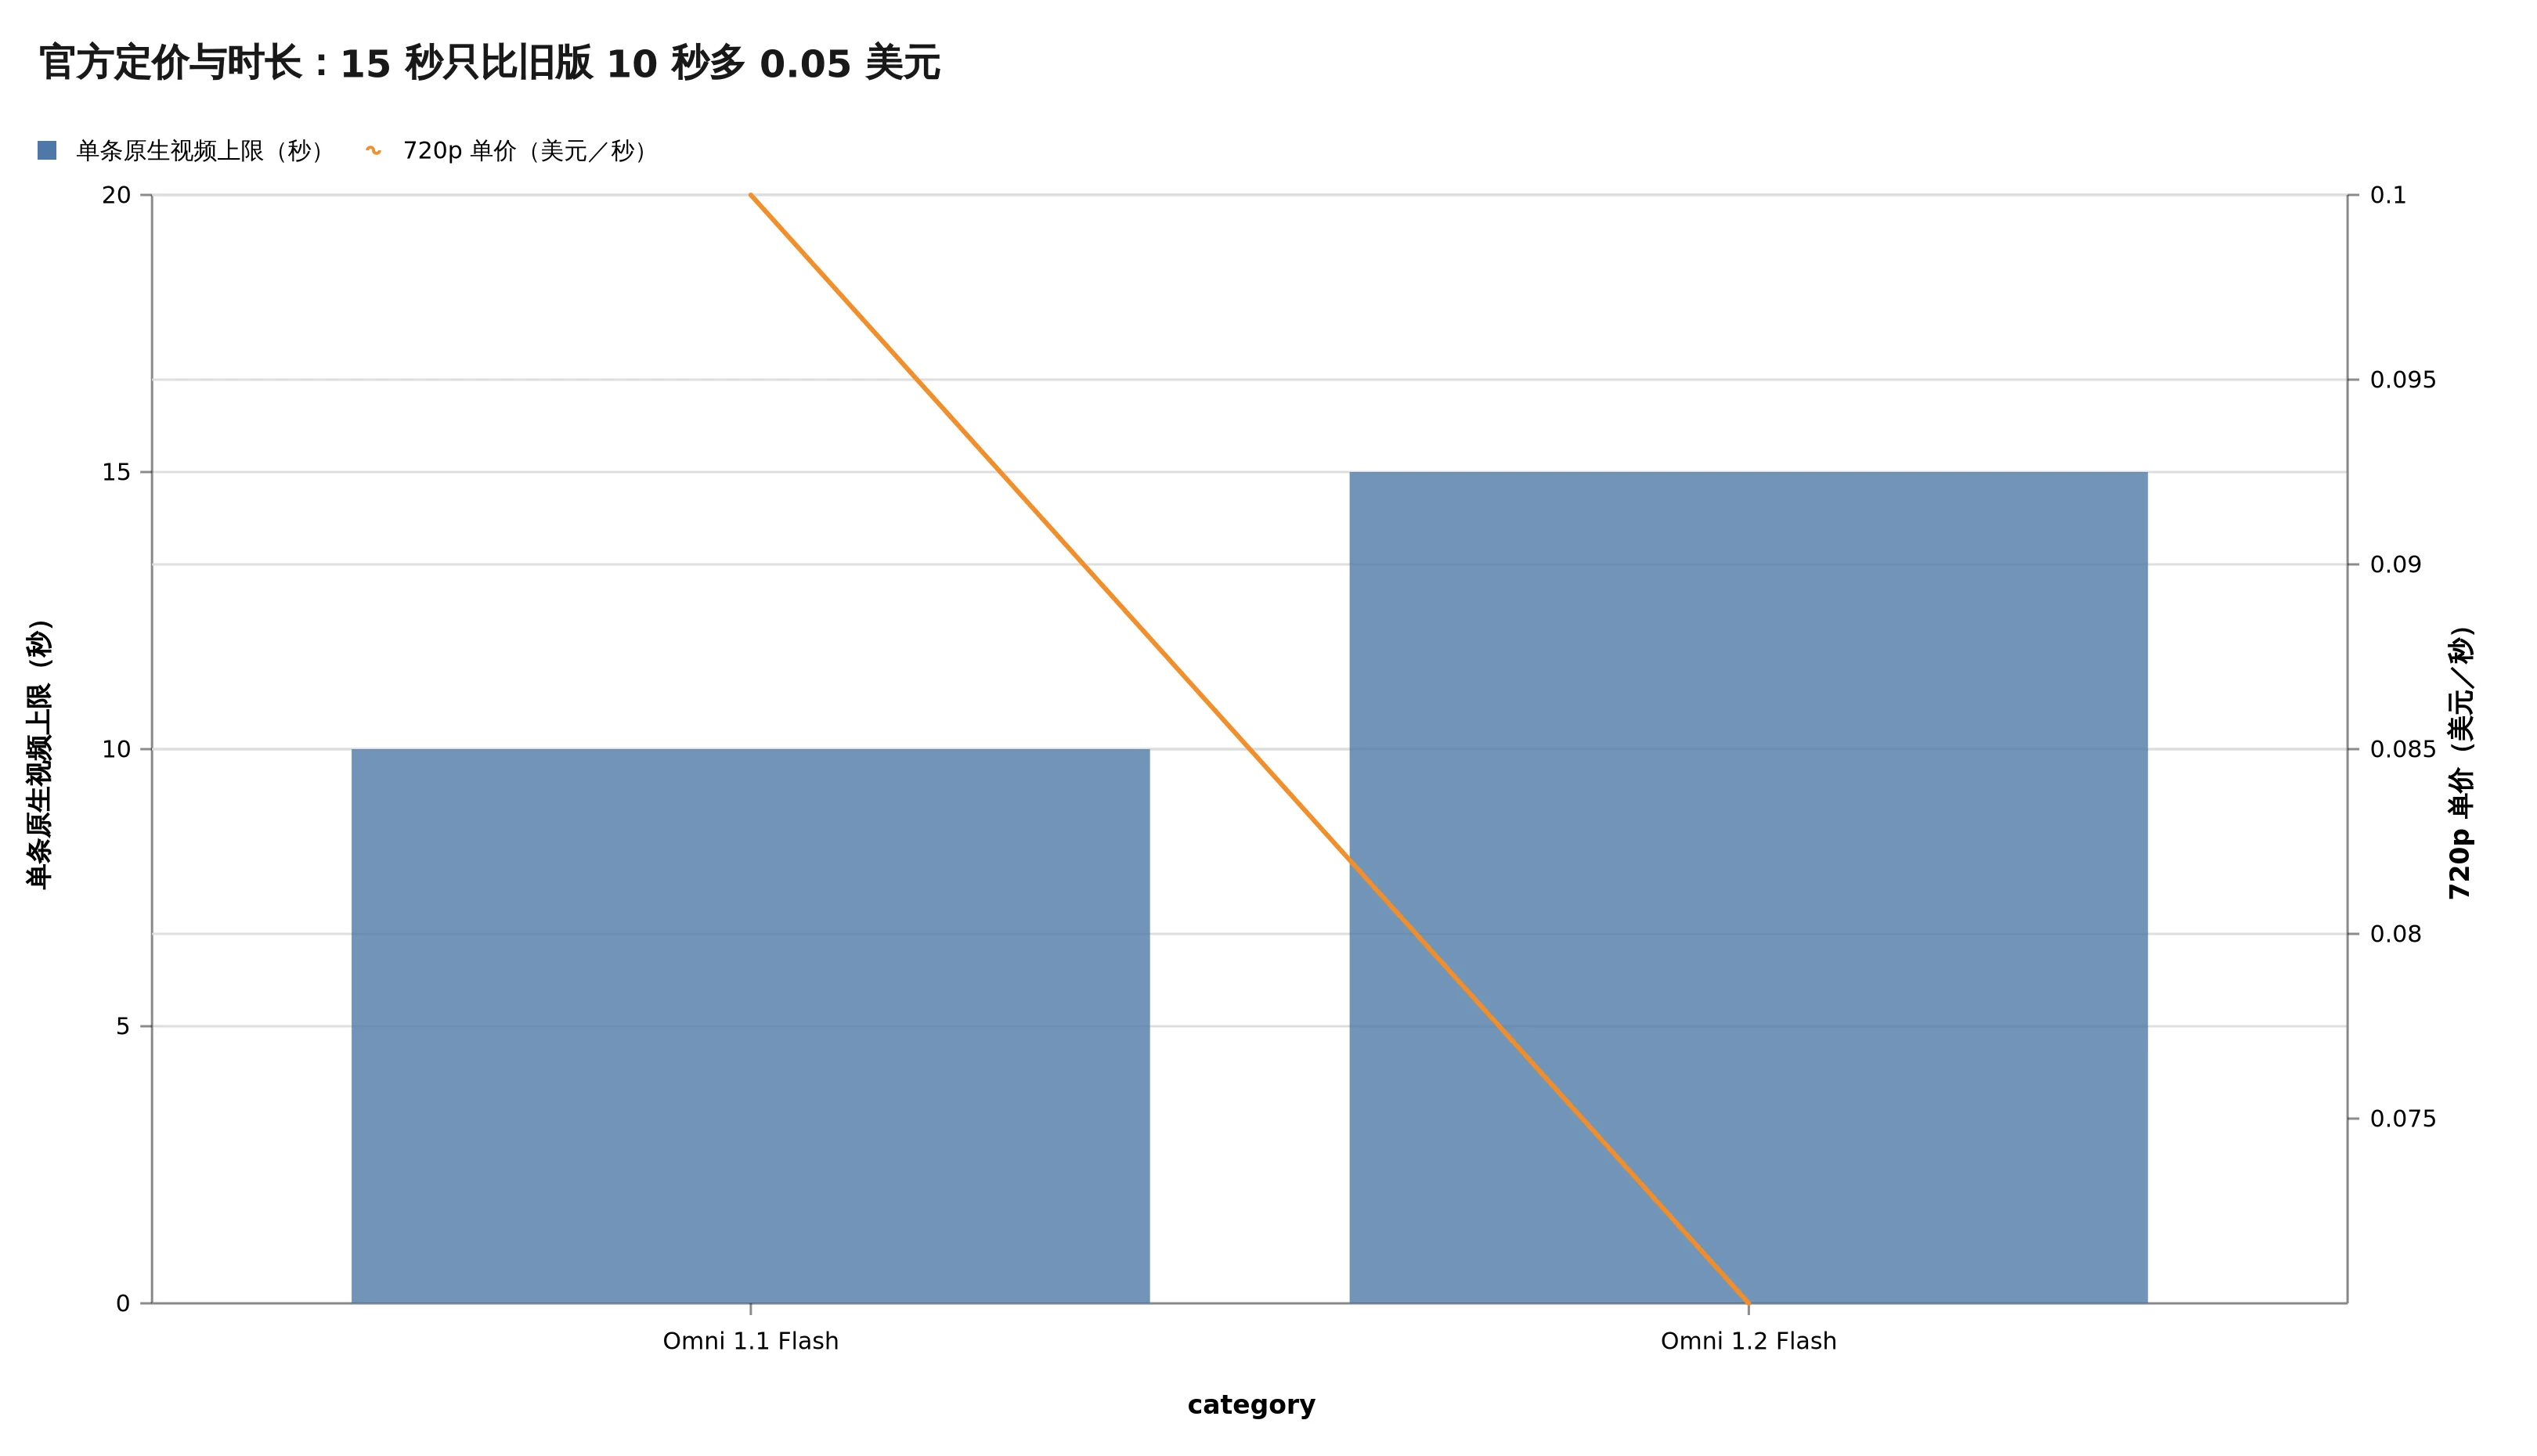
图:基于 Google 11 月 5 日公开的时长与 720p 标价整理。Omni 1.1 的每秒价由“1.2 降价 30% 至 0.07 美元”反推为 0.10 美元。
以前的 10 秒片子,像一段够用的 B-roll:一个镜头、一个动作、一个转场。要讲清楚产品怎么从输入走到结果,常常得把两三段拼起来。拼接当然不是原罪,剪辑师也靠它吃饭;问题在于,生成模型的主体、包装、景别和光线会在每段里重新抽一次签。
15 秒没有神奇到可以替代一支广告片,却刚好跨过了一个实用门槛:它能放进“问题—动作—结果”这三个连续动作。比如一件商品从桌面转到手上,再给一个包装特写;或者一个软件从空白画布到成品界面,再收在使用场景里。不是更长就更好,是终于有空间把一个意思说完整。
更有意思的是价格。旧版做满 10 秒约 1.00 美元;新版做满 15 秒约 1.05 美元。时长增加 50%,按这个官方标价计算,完整片段的费用只增加约 5%。
这会改变什么?不是让团队可以无脑多抽五百条。真正省下来的,可能是“一个小瑕疵毁掉整条”的那轮返工:你先用低分辨率把镜头、节奏和产品位置跑通,再针对已经看见的问题做后续编辑,最后才把选中的版本升到 1080p 或 4K。Google 官方也把这个顺序写成建议:先快出草稿,改细节,而不是每次都重生整条片。
这次值得看的是“连续改”,不是一条更长的样片
官方主视觉里放的是角色、商品、自然场景和街头人物,画面很热闹。它的用途不是证明我已经拿它做过片子——我没有本地实测——而是把 Google 这次的目标说得挺直白:它希望角色、商品、服装、包装文字和品牌色能在镜头运动里别突然改名换姓。
图:Google 官方发布主视觉。本文没有复刻或验证其中的样片效果。
视频模型最折磨人的地方,常常不是第一次生成,而是第二句需求。你说“把背景换成办公室”,模型听成“换背景、换光线、顺便换个产品”。你说“竖版投放”,它可能顺手改了构图重点。于是人只好回到最初的提示词,把整条片重来一遍,祈祷刚才那段唯一正确的运镜还能回来。
Omni 1.2 Flash 宣称可以在同一条片上做多轮对话编辑。它的价值不在于一句“请更换背景”,而在于每次修改都应该带着一个明确的不许动清单:人物、商品、镜头路径、文案位置,哪些必须锁住;背景、色温、画幅,哪些才是本轮变量。
这其实是写 agent 工作流时很熟的一条经验:别把“完成任务”交给一个大而糊的指令。先把不变量写出来,再把可改变量缩小。视频生成也一样。模型未必每次都听话,但你至少不会把所有控制权都交给一个“重来吧”。
一份先拆镜头、后改稿的工作单
下面这份不是 Google 官方 Prompt,也不是实测配方。它是把官方能力边界翻译成一个更容易交给内容团队的工作单。每一轮只允许改一个层面,目的是让“修改”保持可诊断。
【第 0 轮:先锁不变量】
用途:15 秒竖版产品演示,讲清「问题 → 一个动作 → 结果」
必须保留:产品外观、品牌色、主体身份、主镜头运动
允许变化:背景、环境光、字幕位置、末尾画幅
【第 1 轮:低清打样】
生成 360p 或 720p 草稿;只检查镜头节奏、主体位置和叙事是否完整。
不要急着要求 4K,也不要在这一轮同时改商品、人物和场景。
【第 2 轮:只改一个变量】
保留产品、人物和镜头路径不变;把背景改为干净的办公室,
将色温调为偏暖,保留开头和结尾的构图。
【第 3 轮:验收后再升采样】
确认品牌色、包装文字、人物身份和转场没有漂移;
只对通过验收的版本升到 1080p 或 4K。
这张工作单最重要的不是词藻,是顺序。
很多人一上来就写一段几百字的万能提示词,把镜头、角色、动作、产品卖点、配乐、比例和一句金句全塞进去。模型不是听不懂,它只是会在每次生成时重新分配注意力。你很难判断这次翻车是因为镜头描述、参考素材、画幅要求,还是那句临时加进去的“高级感”。
把变量分轮,返工时就有了坐标:是主体漂了,还是背景漂了?是故事没讲完,还是字幕破坏了构图?这比“再生成一次看看”有用得多。
有三类片子,先别被 15 秒冲昏头
第一类是快速体育动作、复杂机械运动或强物理效果。Google 自己在公告里把快速运动、快速脚本切换和复杂物理列为还在继续改进的部分。对这类镜头,15 秒只是让你有更多失败空间,不是自动变成后期工作室。
第二类是必须逐帧正确的产品文字。官方说参考跟随更强,甚至提到包装文字;这值得关注,但“更强”不是“可以不验”。只要有价格、规格、合规信息或品牌字标,仍然要在最终素材里人工逐帧核对。把生成视频当作候选画面,不要当作已验收的交付物。
第三类是脚本还没定的项目。连续改稿能减少局部返工,却救不了每隔十分钟换一次主张。故事、卖点和镜头目标没有先收口,模型只会很勤快地替你制造更多不同版本的犹豫。
所以这次更新给内容团队的实际选择不是“要不要做 15 秒 AI 视频”,而是:你愿不愿意先把视频当成一份可以逐轮验收的草稿,而不是抽到好运的一次性彩票。
Google 已经把 Gemini Omni 1.2 Flash 推向 Gemini API、Google Cloud、Gemini for business 等入口,具体地区、产品资格和价格仍要以各自控制台为准。模型也没有替你决定哪条片值得升采样。
但“先低清跑通—局部改动—再上高清”这个顺序,不管最后用的是哪家模型,都值得留下来。把可变和不可变分开,往往比多写一段华丽提示词更接近真正的剪辑。
你做短视频时,最常被迫整条重来的那个问题是什么:主体漂了、文字错了,还是镜头终于对了但故事没讲完?
—— 小岛 AI