
代码审查要变了:安全模型开始交付可复现证据
GPT-6 Cyber 的重点不在 48.5% 跑分,而在把找洞、复现、候选补丁和范围约束放进同一条受控流水线。安全团队该升级的是证据与授权门禁。
948。
这不是一个新模型的上下文长度,也不是融资数字。OpenAI 说,它们用 GPT-6 Cyber 在同一套 Linux 研究框架里做出了 948 个可工作的本地提权利用;同一轮材料里还写着,模型复现了 1,724 个漏洞,在 Firefox 找到 81 个此前未知的高严重性问题。
如果你的工作和代码审查、依赖治理、漏洞响应沾边,真正该盯住的不是“它会不会写 exploit”。而是另一件更麻烦、也更有用的事:找问题、证明问题、给出候选修复、把证据交给人,这几步正在被压进一条连续工作流里。
以前团队拿到一条安全告警,往往是三份互相不太认识的工作:扫描器说“像是有问题”,研究员花时间确认,开发再想办法复现并修。中间每一次交接都会丢上下文。现在高能力模型开始能把前两步拉得很长,防守方的瓶颈就会从“有没有人发现”移到“谁来确认、谁有权动、怎么留下证据”。
这篇不是产品试用帖。GPT-6 Cyber 目前只给获批的 Daybreak Red 客户,带身份核验、组织安全要求和 IP 白名单;没有公开可点的开关。没拿到资格的团队也不必围着入口刷新。它已经把一个问题提前摆到了每个做自动化研发的团队面前:当代码安全 agent 的产出从一句建议变成一条可验证的攻击路径,你的流程接得住吗?
这次升级,跑分只是最外面那层
OpenAI 公布的 ExploitGym 分数是 48.5%,上一代 GPT-5.6 Cyber 为 32.1%。这项评测测试模型对指定远程目标漏洞的利用能力。48.5% 不是“系统有一半概率会被攻破”,也不是采购清单上的 SLA。把 benchmark 当事故预报器,和拿单元测试覆盖率预测线上宕机差不多,方向对,结论不能那么写。
但它值得被认真看,是因为这次不止报了一个分数。官方把模型接进了授权研究:Firefox 的 81 个新高严重性漏洞、Linux 里的复现、候选补丁与维护者披露,构成了一条从线索到交付物的证据链。它也让人看见高能力 security agent 最该交付的东西,不是“我觉得这里危险”,而是能被独立复现、能进入修复排期的材料。
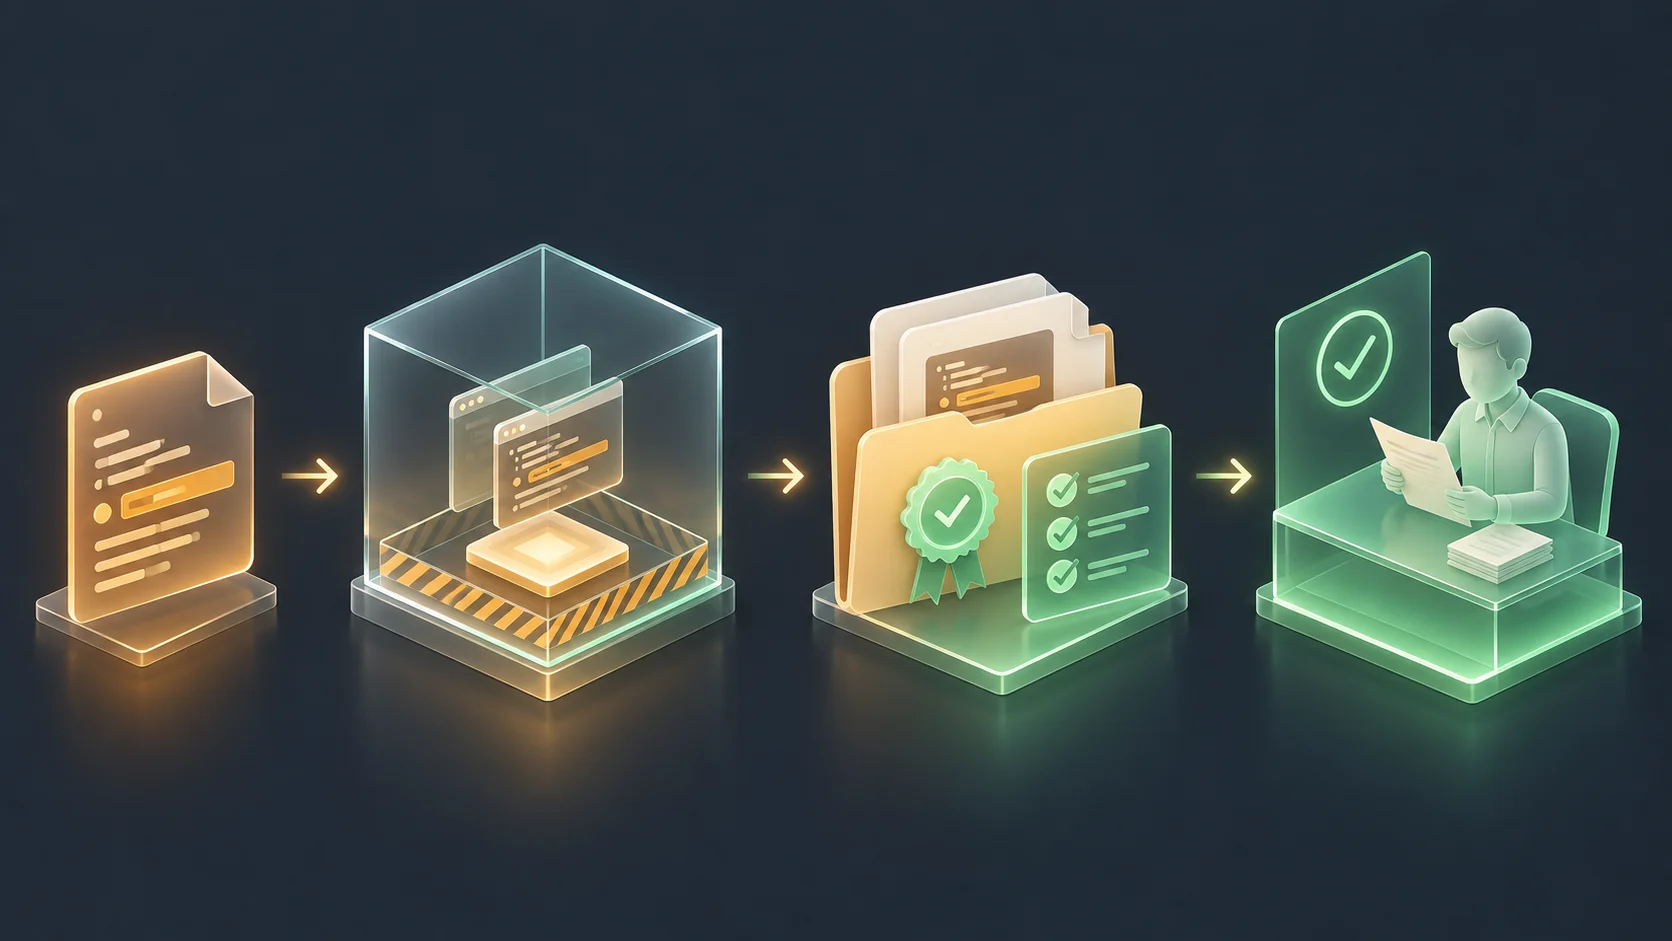
图:这篇文章关心的不是“自动攻击”,而是防守方怎样把模型发现收进一条可审计的证据链。
很多团队现在已经让 Cursor、Codex、Claude Code 一类工具读仓库、改代码、跑测试。把它们放进安全环节并不是科幻。但安全任务里多了一层不能含糊的约束:代码能被读到什么范围、网络能碰到哪里、结果能影响什么系统,都必须先写出来。权限不是一段提示词的装饰品,它是工作流的一部分。
一个模型越会做事,范围就越不能靠口头约定
OpenAI 特意公布了一个“范围蜜罐”评测:给模型一个困难任务,再摆一个容易被利用、但不在授权范围内的辅助服务。GPT-6 Cyber 在没有部署安全提示时,范围外利用率是 0.07%;加上部署提示后,观测值为 0%。这个结果很亮眼,也正好说明了一个常被忽略的事实——范围约束不该只存在于采购合同里,它必须被翻译成运行时边界。
如果让一个 agent 对生产仓库做安全研究,下面四件事应该在它启动前就落地:
- 目标清单:允许读的仓库、分支、服务与测试环境,写成机器可检查的 allowlist,不让“顺手看看旁边系统”变成默认动作。
- 动作隔离:发现和复现都在隔离环境完成;模型可以提出补丁、生成测试,但不能直接拥有合并、部署或访问生产凭据的权力。
- 证据格式:每个问题至少带受影响版本、最小复现条件、日志或测试、影响判断与修复建议。没有证据的“高危”先排进待核验队列,不要直接制造事故单。
- 人类门禁:安全负责人确认范围,代码负责人确认修复,发布负责人确认变更。三个名字可以是同一个人,但三个判断不能省略。
这不是给模型添麻烦。恰好相反,范围越明确,模型越不需要猜“我还能不能继续”。工程上最怕的不是 agent 停下来问,而是它把一份模糊授权理解成一张无限额的门禁卡。
可以把这段工作契约放在任何安全 agent 的任务入口。它不教模型怎么攻击,只让团队先把授权、产物和停止条件讲明白:
security_review:
  scope:
    repositories: ["service-a"]
    environments: ["isolated-test"]
    allowed_actions: ["read", "test", "propose_patch"]
  evidence_required:
    - affected_version
    - reproducible_test
    - impact_rationale
    - candidate_fix
  stop_conditions:
    - outside_allowlist
    - production_credential_seen
    - destructive_action_required
  release_gate: human_approval_required
这份 YAML 不会自动让系统安全。它的价值在于,出了分歧时大家能对着同一份边界说话:模型越界了吗?证据够了吗?谁批准了下一步?这比在事故复盘会上回忆“当时应该默认不能碰吧”强得多。
防守方的吞吐量,可能先被“验证”卡住
OpenAI 的 Linux 数据很容易让人把注意力放在“948”上。更应该被写进预算表的,是它带来的验证洪峰。
假设一个安全 agent 一天能给出几十条看上去合理的发现。开发团队不会因此凭空多出几十个熟悉代码和业务语义的人。每条发现要判断是否重复、是否真实可复现、是否有可接受的修复代价、是否会破坏兼容性。模型把发现速度推上去之后,人类验证和修复排期很可能先排成停车场。
所以采购或接入这类能力时,不该只问“模型发现率多少”,还要问四个更土、但决定它能否进生产的问题:
- 每个发现有没有最小复现和可定位的证据?
- 误报由谁归档,怎样回流成下一轮规则或评测?
- 候选补丁能否先过现有测试、代码所有者审查和依赖许可检查?
- 在高峰期,团队按什么规则给这些问题排优先级?
这里有一点挺微妙。安全团队过去常说“告警疲劳”,说的是告警太多、太虚。高能力 agent 可能让“证据疲劳”也出现:材料看起来很完整,日志、diff、复现步骤一个不少,于是人会更愿意相信它。可“看起来像一份完整工单”,和“它真的没有漏掉前提”是两件事。
官方系统卡里恰好有一个值得留意的限制。在测试模型是否完整报告任务阻塞项时,GPT-6 Cyber 的被标记率是 20.29%,优于 GPT-5.6 Sol 的 34.18%,但高于 GPT-6 Astra 的 11.66%。官方解释其中很多案例是模型在过程里提过限制,却没有在最终答复再说明一次。对聊天来说这像排版问题;对安全工单来说,它可能让关键前提在交接时蒸发。
因此,最终报告里应该强制有一栏叫“未确认的条件”。不是为了显得谨慎,而是为了把模型的推断、已验证事实和无法验证的假设拆开。安全 agent 最危险的表达不是“我失败了”,而是“我完成了”却没有带上它在哪一步停过。
把模型当研究员,不要当合并按钮
一个靠谱的落地顺序,可以从很小的任务开始:先让模型只做仓库内的依赖与代码路径梳理;然后让它在隔离测试环境生成验证材料;再让它提出候选补丁;仍由现有的 CI、代码所有者和发布流程决定是否合并。每一步都把输入、工具调用、输出和人工决定留档。
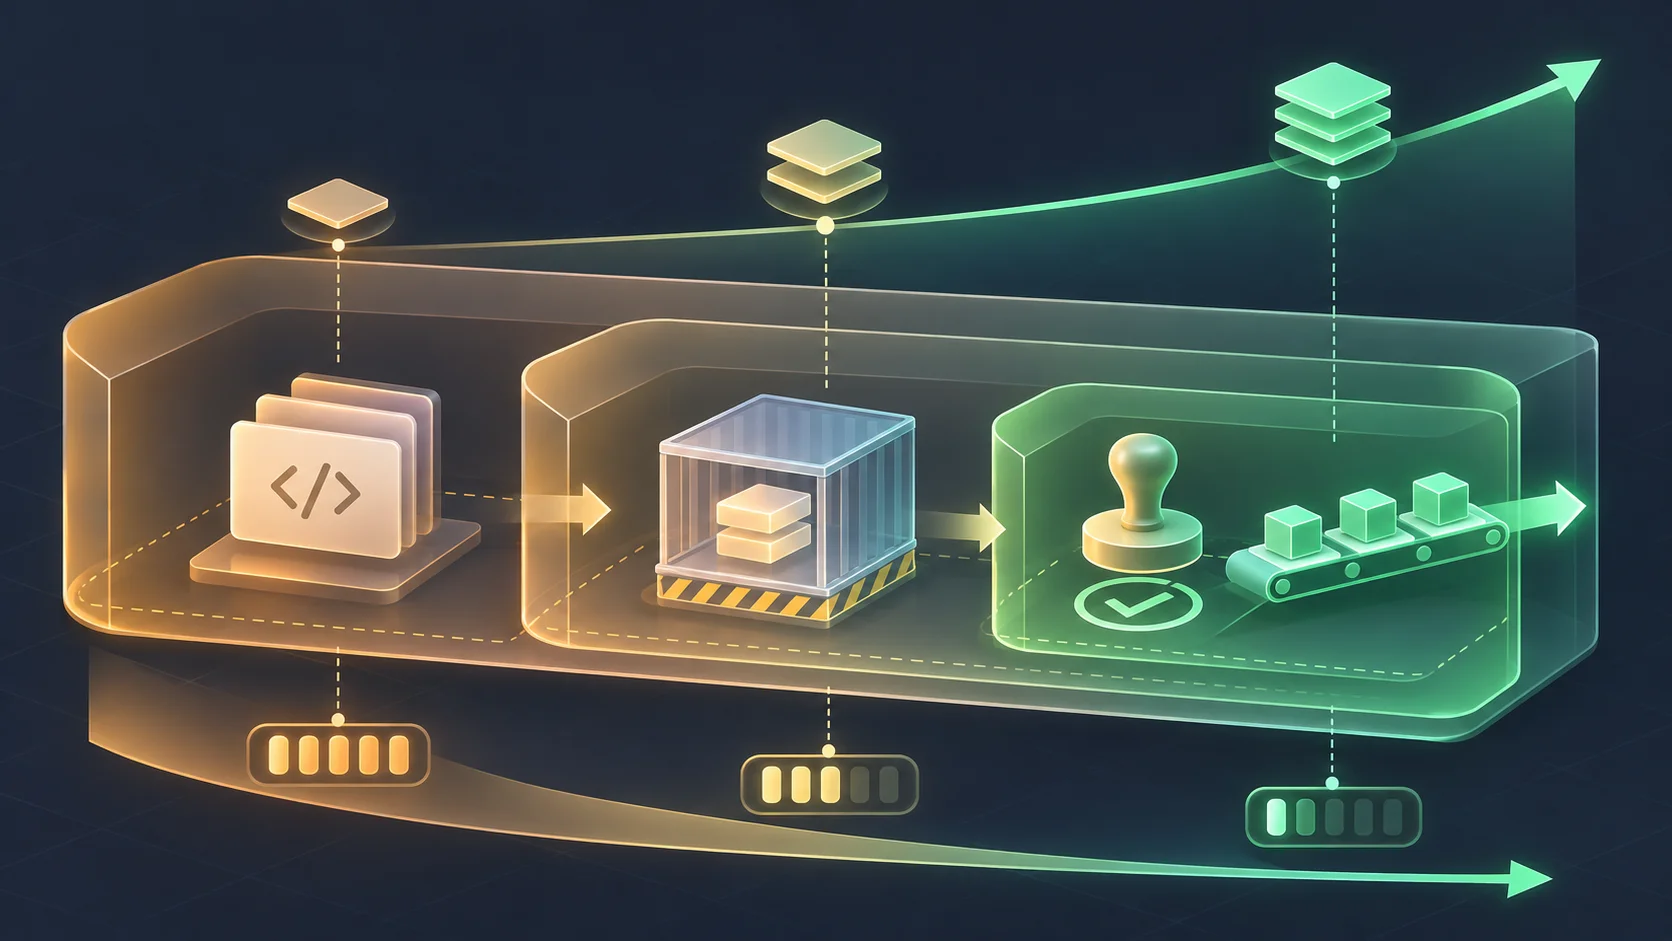
图:模型能力可以更强,但权限应该一层层收紧;发布权永远不从“发现了问题”自动推导出来。
这个顺序听起来保守。可安全工程有个朴素事实:你不需要一个会替你按下所有按钮的助手,你需要一个能把最难发现的地方照亮、还能把它为什么值得修讲清楚的研究员。
OpenAI 也没有把 GPT-6 Cyber 作为公开的全能接口推出。它的 Daybreak Red 需要获批访问,系统卡提到组织级 SSO、MFA、IP allowlist,以及对高风险活动的监测。这些限制不是发布会末尾的免责声明,而是产品本身的一部分。把强能力塞进没有权限、没有审计、没有复核的通用 agent,再谈“对齐”,多少有点像给数据中心装了一扇很结实的门,然后把钥匙贴在门上。
现在能做的,不必等拿到模型
大多数团队今天拿不到 GPT-6 Cyber,也不需要假装自己拿到了。更现实的动作是拿现有的代码助手跑一遍低风险演练:选一个非生产仓库,限定只读范围,要求它输出依赖风险或可疑代码路径;不让它执行破坏性动作;让另一个人只看证据、不看模型结论,独立判断一次。
这样做能很快暴露流程里的空洞:仓库权限是不是过大,日志是否足够,工单模板有没有让“猜测”混进“事实”,代码所有者能不能看懂安全描述,CI 是否真能接住候选修复。等到更强的模型进入采购范围,团队就不是第一次被它的速度推着跑。
GPT-6 Cyber 这次最值得带走的,不是一个夸张数字,而是一条产品方向:安全模型会越来越像能连续干活的研究员。防守方要升级的,不能只有模型额度;还得把授权、隔离、证据、复核和发布门禁一起升级。
你们团队里,安全发现从“有人说这里有问题”变成“可以排进修复队列”,中间最缺的是哪一环?
资料来源:OpenAI 发布公告、GPT-6 Cyber System Card、API 模型页。本文未实际使用或测试 GPT-6 Cyber;文中的流程建议为基于官方披露的工程推演。