
AI 代码审查进沙箱:让模型交出运行证据
让模型跑代码会把一次审查的成本拉高 10–40 倍,但它也把“我觉得这里有问题”换成了可回放的命令和输出。关键不是全量接入,而是放对门禁。
一个 PR 的 diff 看起来很干净,单元测试也绿了。可那段新分页代码把边界条件写反了,只有真实请求到了最后一页才会露馅。
这正是很多 AI 代码审查卡住的地方:模型能读出一种“像 bug 的形状”,却不知道它会不会真的在运行时炸掉。它给你一段建议,开发者再手动改、再跑测试。流程没有错,只是它更像一个很勤奋的阅卷老师,不是验证者。
OpenRouter 今天放出了一份 Python 代码审查器教程。核心想法很直接:不要只把 diff 丢给模型。把改动后的完整文件、相关测试和 diff 放进托管 Linux 沙箱,让模型写一小段检查、跑出结果,再把发现标成 confirmed 或 unconfirmed。Files、Shell 和 Apply Patch 仍是 beta,这条链路也还在变。
这不是“让 AI 自动修 PR”的新话术。更值得聊的是另一件事:当模型能运行代码,代码审查才第一次有了“证据层”。 代价也摆在桌面上——官方测得一次审查约 1–4 分钟、0.015–0.045 美元;只读 diff 的轻量审查大约 0.001 美元。贵了 10–40 倍,当然不能见 PR 就上。
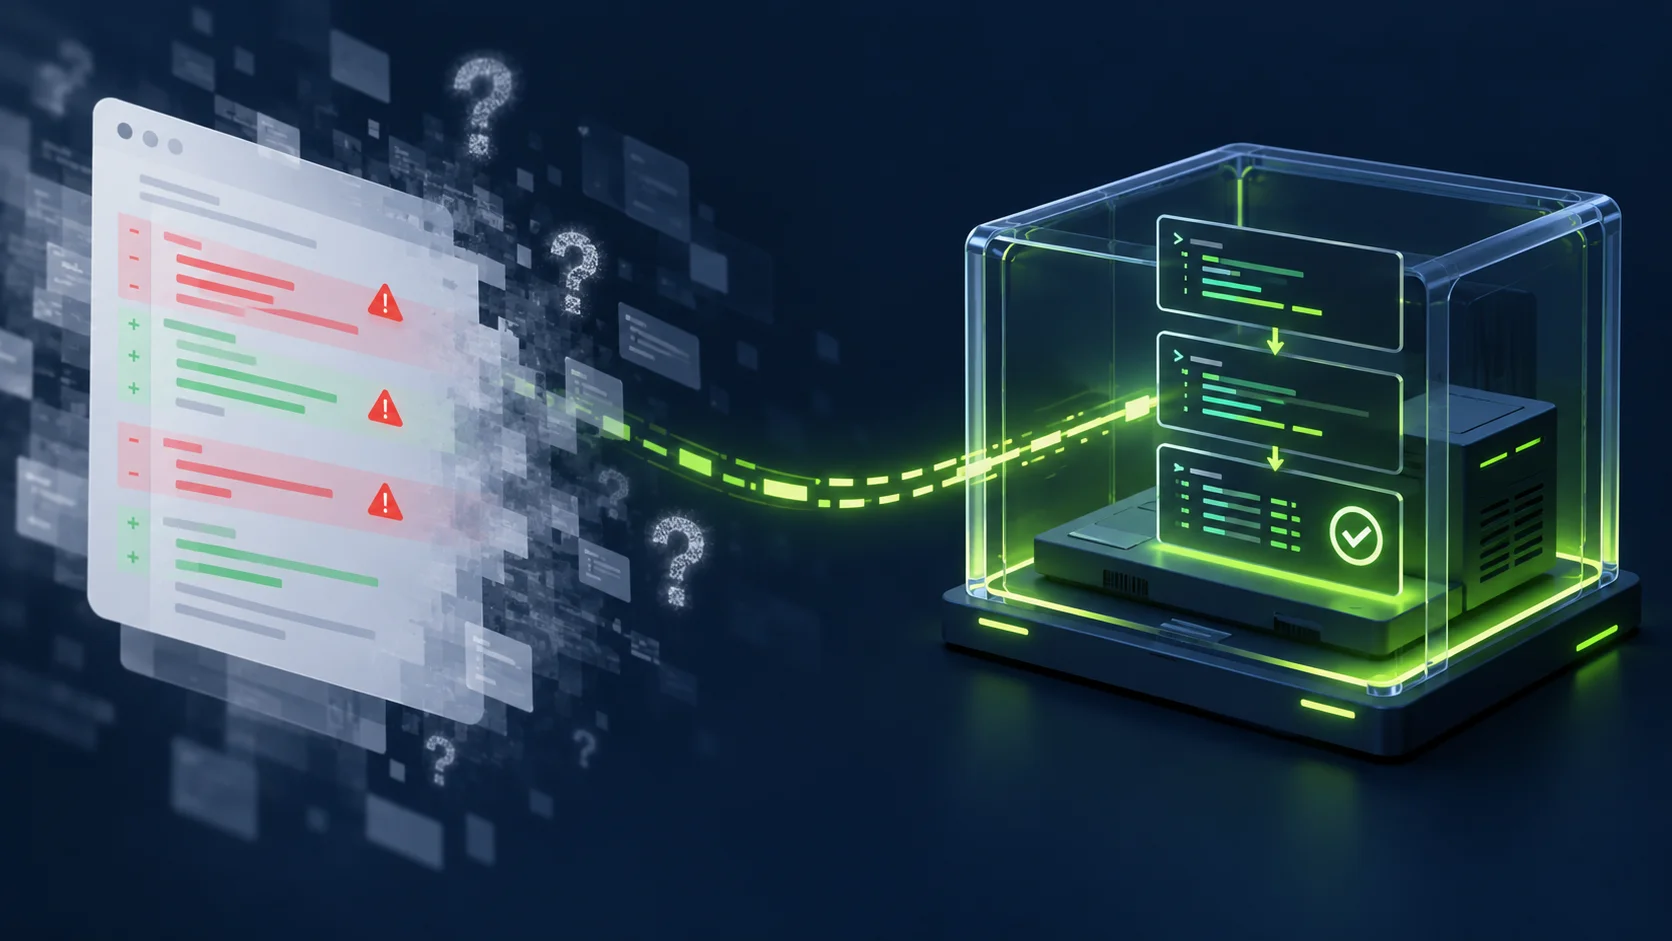
图:本文原创示意。把“读到异常”与“运行确认”拆成两个阶段,才知道模型的结论该停在哪里。
模型看懂了 diff,不等于它证明了 bug
只读 diff 的审查器有两个天然盲区。
它常常看不到足够的上下文。某个变量是不是已经校验过,某个 helper 会不会吞错误,某个类型在另一处有没有兜底,几行 diff 根本装不下。模型会用常识补空白,偶尔补得很漂亮,偶尔也会把不存在的风险讲得煞有介事。
更棘手的是,它不知道一个怀疑能否复现。SQL 拼接、分页差一、is not 比较、重试异常被吞掉,这些都可能在 diff 里看着可疑;真正的区别在于,能不能写出最小检查并让它失败。
OpenRouter 的示例把这一步前移。review.py 只有 233 行、只依赖 Python 标准库。它从 Git 拿到改动和文件名,连同可选的测试文件上传;沙箱内重建一个临时仓库树,模型调用 Shell 跑短检查;结束时通过函数工具提交结构化报告。官方说明里,报告会保存到 .git/ai-review.json,达到设定严重度时以退出码 1 让钩子或 CI 停下来。
你可以把它理解成给 AI 审查多加了一道很窄的门:模型不只说“这里可能错了”,还要交出它跑过什么、输出了什么、为什么这个输出能说明问题。
python3 review.py --base origin/main --context tests/test_orders.py这个命令本身不是魔法。--context 反而点出了关键:让模型运行,并不会自动补齐你的领域知识。支付状态机、权限策略、特定依赖版本,仍要由你选出能让判断成立的上下文。
官方在一个含 5 个植入缺陷的示例变更上测试了 4 个模型。完成的审查中,Claude Haiku 5.5 平均约 0.0153 美元、125 秒;GPT-6 Luna 约 0.0167 美元、156 秒;Claude Sonnet 5.5 约 0.0447 美元、60 秒。那是一套官方测试,不是你仓库的承诺书,但它把一个常被省略的问题说清了:运行证据不是免费午餐,模型选择、容器时间和回放成本都会进入账单。
什么时候值得多花这笔钱
我不会把沙箱式审查放到每个格式调整和文案改动上。它更适合三类变化。
会改变运行路径的改动。 比如认证分支、订单金额、数据库查询、重试和超时、分页、文件处理。这里一条可复现的输出,比十句“建议注意边界情况”有用得多。
已有最小验证入口的改动。 如果仓库已经有一段可跑的单测、一个脚本或一个可控的 fixture,模型更容易做出小而确定的检查。反过来,整个系统都靠外部服务、需要复杂数据准备的场景,先把测试入口补出来,别指望沙箱替你凭空造环境。
合并后的回滚成本高,但 PR 数量还可控。 核心服务、发布脚本、迁移和权限模块,适合多一道门。高频小改动的仓库可以先把它做成非阻断报告,收集一段时间的命中和误报,再决定是否拦截。
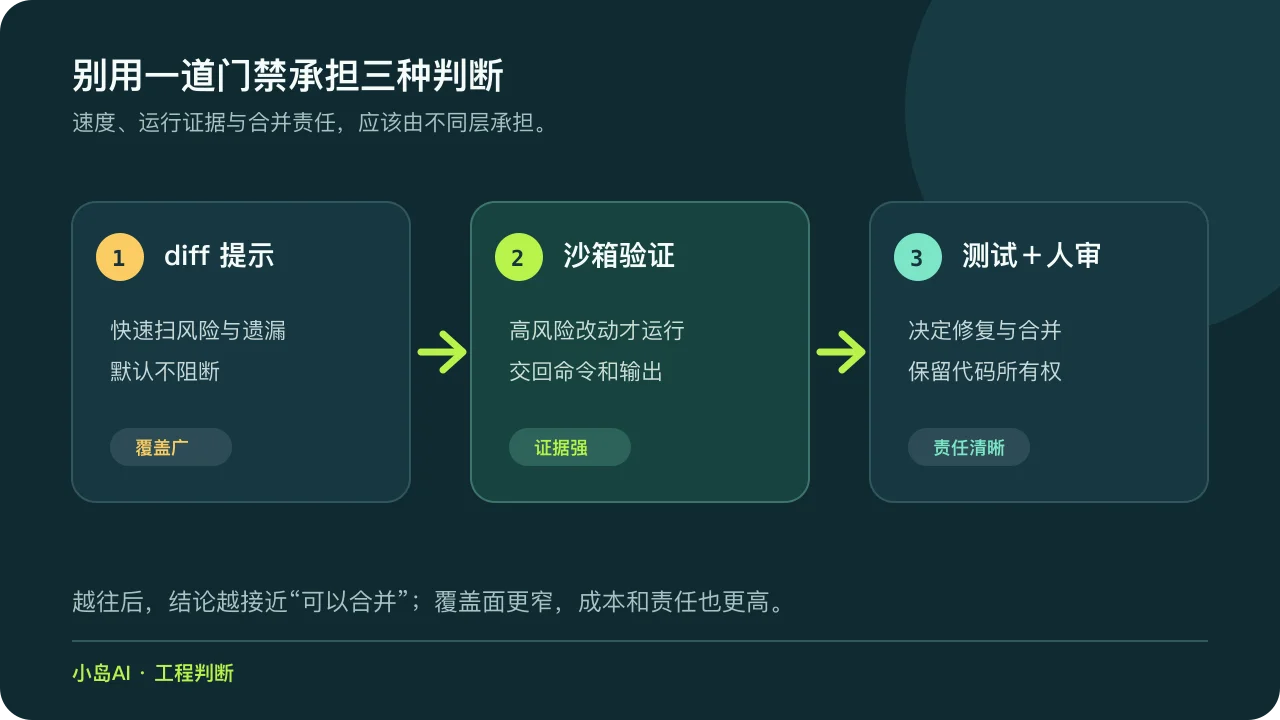
图:本文原创示意。三层不是替换关系;越靠后,结论越接近“可以合并”,但覆盖面和成本也越窄。
这里有个很容易混淆的点:模型在沙箱里跑通一个最小验证,证明的是“这个怀疑能复现”,不是“补丁已经可以上线”。官方示例的补丁会先应用到本机临时副本,再把结果回传给模型;即使传了 --apply,仍然要跑自己的测试。这个顺序是对的。
一条好门禁大概长这样:
- 普通 diff 审查负责提示风险,速度优先,不阻断。
- 沙箱审查只针对高风险改动,要求给出命令、输出和
confirmed状态。 - 项目自己的测试、代码所有者和发布规则决定是否合并。
让模型负责第二层,既不把它降格成聊天窗口,也不把 merge 按钮交出去。这个位置比较诚实。
别把沙箱当成“代码可以随便外发”的许可证
沙箱隔离的是执行环境,不会自动解决数据边界。
按官方说明,改动文件、上下文和 diff 会上传到 OpenRouter 工作区,并会发送给模型提供方;脚本会在结束时删除上传文件,但报告里可能仍有代码片段和 Shell 输出。带密钥、客户数据、专有算法或受监管信息的仓库,不能因为“容器没有出网”就直接放进去。
依赖也是另一道现实边界。教程里的沙箱默认不能访问外网,pip install 会失败。这个限制反而有价值:它逼你把审查任务写得足够小、足够可复现。需要第三方包时,应该显式设置网络允许名单,而不是为了让一次检查跑通,把整个互联网打开。
还有一层是代码所有权。跑在 GitHub Actions 里的审查器,不该信任 PR 自己改过的审查脚本;官方示例使用基准分支里的 review.py 来检查,避免被审查的改动顺手把裁判换掉。来自 fork 的 PR 也更适合跳过这类会读取上下文和调用密钥的工作流。
先试一周,别第一天就把它设成红灯
如果团队准备接入,我会用一个很克制的顺序:
- 第一周只对两类改动跑报告,例如 SQL 查询和重试逻辑,不阻断合并。
- 每次只记录四件事:模型发现了什么、其中多少能复现、人工接受了几条、耗时和成本是多少。
- 看到稳定的
confirmed发现后,再把一个明确类别设成门禁。不要把“模型写了一段像样的解释”也计进成功率。
官方教程把这个流程包装成一个可复制的脚本,挺方便。但真正能让它留下来的,不是 233 行代码,而是团队愿不愿意把“建议”和“验证”分开计账。
AI 审查不必每次都跑到容器里。可一旦某个改动足够贵、足够危险,或足够容易被表面测试骗过去,给模型一小块受限的运行环境,可能比再让它读一遍 diff 值得。
你们团队现在最希望 AI 帮忙拦住的,是哪一类“看起来没问题、上线后才出事”的改动?