
同时跑 Codex 和 Claude Code,工作区怎么不打架?
Orca 把多个终端 Agent 放到各自的 Git worktree。它解决的不是“多开窗口”,而是让并行改动还能比较、验收与回退。
同一个仓库里同时跑 Codex、Claude Code,最容易先坏掉的往往不是 Token,也不是机器风扇。
是工作区。
一个 Agent 正在改登录页,另一个 Agent 顺手升级依赖,第三个 Agent 又把同一份配置文件格式化了一遍。三个终端看着都在认真干活,最后留在你 Git diff 里的却是一锅很难分清来源的改动。让 Agent 并行,本来想省时间,结果把审核和回滚的成本全攒到了最后。
最近增长很快的开源项目 Orca 想解决的正是这个很土、但很关键的问题。它把 Codex、Claude Code、OpenCode 这类能在终端运行的 Agent 放进同一个工作台,但每个任务都落在独立的 Git worktree 里。官方 README 给的用法很直接:同一个提示可以发给最多五个 Agent,各自改各自的目录,最后比较结果、只合并赢的那一份。
截至本文写作时,它在 GitHub 上约有 11.2 万 Star;近一周增加约 7,200 个。这个数字只说明大家在看它,不说明它已经适合每个团队。真正值得借走的,是它对“并行”做的一个很朴素的约束:先把改动隔开,再谈谁做得更好。
图注:Orca 官方 README 的产品界面。本文未对该产品做独立性能或安全实测。
多开终端,不等于多 Agent 协作
很多人第一次并行跑 Agent 时,做法通常是复制三个终端,再给每个窗口发不同的任务。这一步没错,真正开始出问题的是几个任务都指向同一个 checkout。
Git 并不知道哪个文件是“给 Agent A 暂借的”。它只会忠实地记录工作目录里发生的一切。于是你会看到几种特别熟悉的场面:一个 Agent 的格式化把另一个 Agent 的局部修复淹没了;为了验证一个候选方案,又得手动 stash;某个 Agent 说“已完成”,但它依赖的是另一个 Agent 还没保存的文件状态。
这时最缺的不是一个更会分派任务的模型,而是一份可独立审查的改动边界。
Git worktree 很适合充当这条边界。它让同一个仓库在本地同时拥有多个工作目录,每个目录各自检出不同分支。你可以把“做功能”“查 bug”“写测试”放到不同 worktree,互不覆盖;需要比较时,再回到主工作区看各自的 diff 和测试结果。
Orca 的产品价值,至少在公开资料里,并不是发明了 worktree。它是把创建 worktree、启动不同 CLI Agent、查看输出、追问和审查 diff 串到了一处。对于已经在 Codex、Claude Code、OpenCode 之间切换的人,这比再记一套终端命令更像是一个控制台。
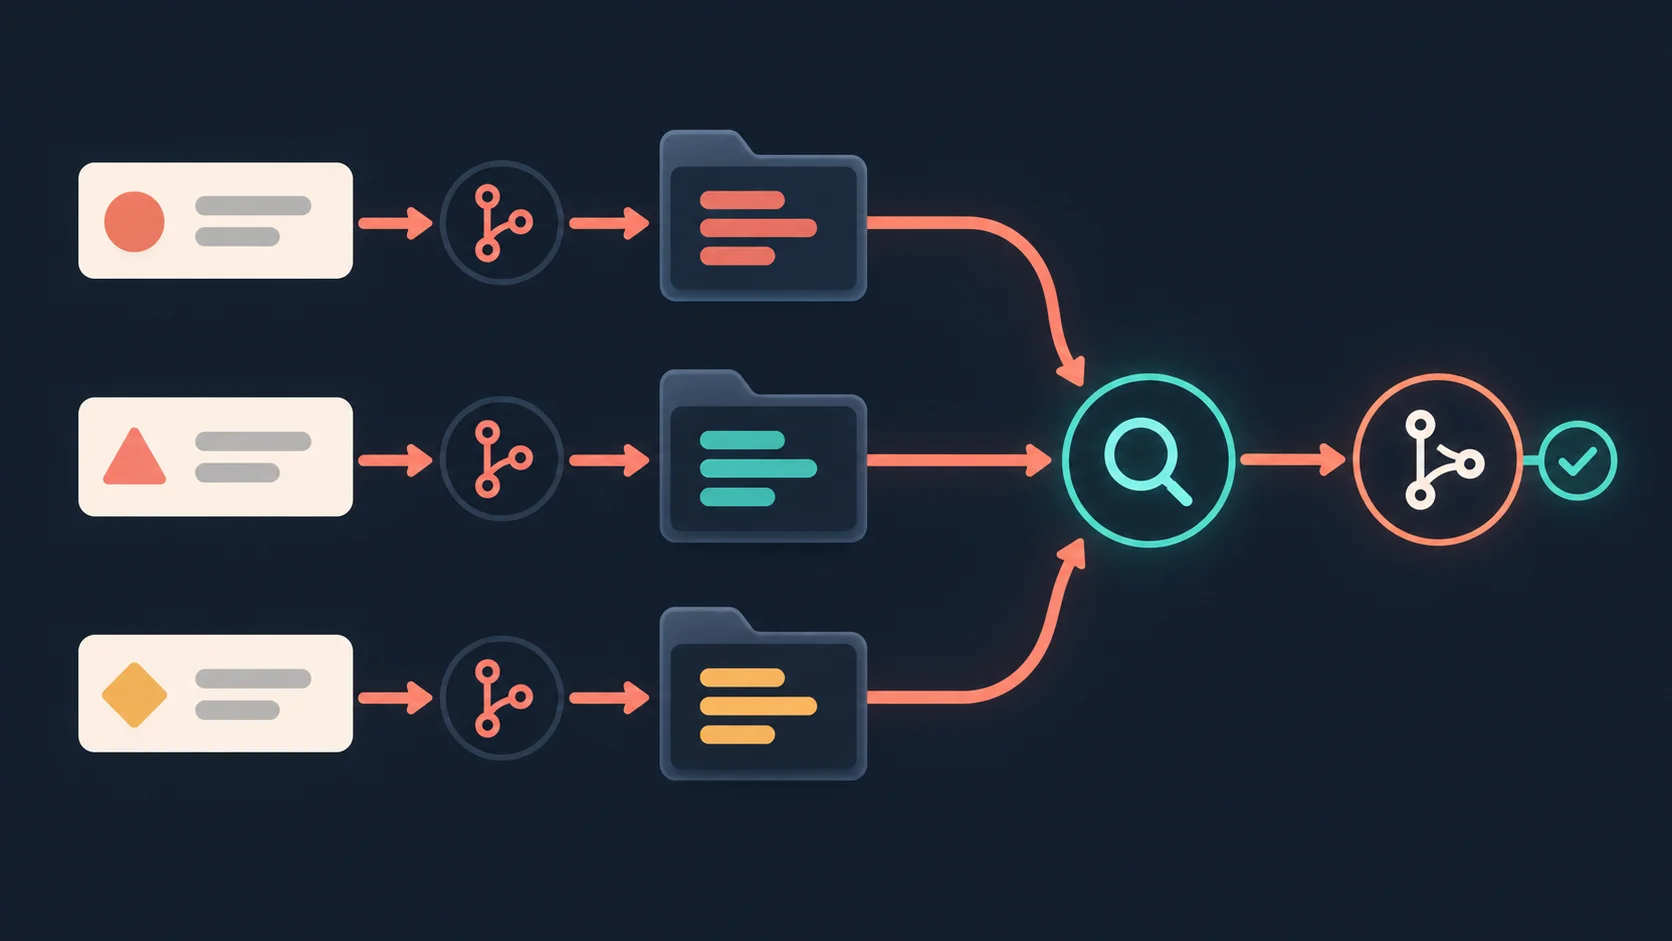
图注:并行任务需要隔离的是改动线,而不只是终端窗口。
真正该并行的,是可比较的候选方案
不是每件事都值得派五个 Agent。让多个 Agent 在同一个小 bug 上各写一遍,最后可能只得到五份语气不同、风险差不多的补丁。
比较适合并行的,通常有三类。
第一类是方案本来就有分叉的任务。比如一个页面性能问题,你不确定该先拆组件、改数据请求,还是砍掉某段动画。给三个隔离 worktree 各自一条假设,最后对比 Lighthouse、包体积和改动范围,结果比在同一个分支里不断覆写更干净。
第二类是主实现与验收可以分开的任务。一个 Agent 负责修复,另一个只负责补测试、找回归点,第三个只读 diff 提问题。这里不要把“审查 Agent”也给成同样的写权限;它的价值就在于能保持一点距离。
第三类是时间窗口短、但失败可丢弃的探索。做一个 UI 原型、迁移一段脚本、验证不同库的接法,都适合先让 Agent 在独立目录里试。没跑通就删掉那条分支,不用在主目录里清理半成品。
反过来,涉及数据库迁移、共享密钥、生产配置或跨仓库发布流程时,别把“并行”理解成同时放行。worktree 能隔开文件,隔不开外部系统。一次会改变共享环境的操作,仍然要有一个明确的执行者和审批点。
一套够用的起步法
如果你只是想试试,不需要先把团队工作流重建一遍。可以从一个仓库、两条互不依赖的任务开始:一条让 Agent 做实现,一条让 Agent 做测试或替代方案。
Orca 官方给出了 macOS 的安装方式,注意要使用完整的 cask 名称:
brew install --cask stablyai/orca/orca装好之后,先把它当作 worktree 的可视化入口,而不是“放进去就能自动交付”的黑盒。每个任务至少写清三件事:它可以改什么;它必须跑哪些验证;它交付时需要留下什么证据。前两件决定 Agent 的边界,最后一件决定你是否真的能比较它们。
一个很小的任务卡可以长这样:
任务:修复设置页保存后提示不刷新
允许修改:settings/ 与对应测试
验证:pnpm test settings;手动复现保存流程
交付:说明根因、列出改动文件、附测试输出
当两个 Agent 都完成后,不要只看谁的自然语言总结写得更像“已经解决”。先看各自 diff 是否只碰了授权范围,再跑同一套测试;如果都能过,才比较代码复杂度、依赖变化和回滚难度。能合并的是通过验收的工作树,不是最会写完成报告的聊天窗口。
它不替你解决三件事
第一,Orca 不能替你切任务。一个模糊的“把这里优化一下”即使丢给五个 Agent,也只会得到五种模糊的实现。并行之前先把验收条件写清楚,收益比多开一个窗口大得多。
第二,它不替你解决权限。官方资料提到它支持远程 SSH worktree、GitHub、Linear 和移动端继续跟进。连接越多,权限边界越要先问清;尤其别让一个方便的控制台变成默认拥有所有仓库和生产凭据的控制台。
第三,它不保证结果更好。官方 README 展示的是功能与使用方式,不是对特定代码库的成功率承诺。不同 Agent 在同一任务上的表现,仍会受上下文、提示、测试与仓库质量影响。没有一组固定的验证,所谓“并行比较”最后很容易退化成凭感觉选一个。
我更愿意把这种工具看成给多 Agent 加上的车道线。它不负责让每辆车开得更快,但至少别让大家在同一条窄路上互相蹭。
如果你已经同时用两个以上代码 Agent,你最想先隔开的,是功能开发、测试,还是代码审查?