
把整个仓库塞给 Kimi K3.1 Pro?100 万上下文先别这样用
Kimi K3.1 Pro 已上线,100 万 Token 上下文很诱人;但对日常代码任务,先把问题、文件边界和验收条件讲清楚,比把整个仓库一股脑塞进去更重要。
你大概见过这个场面:一个仓库接手三个月,目录树像一碗没拌开的面。线上报错只留下一行堆栈,产品又说「顺便把这个流程改成可配置」。于是很自然地想,既然 Kimi K3.1 Pro 给了 100 万 Token 上下文,干脆把整个仓库、日志和需求文档都扔进去,让它自己找路。
这次,容量真的够大。Kimi 昨天发布了 K3.1 Pro:官方称它是 3T 级开放权重模型,已经能在 Kimi、Kimi Work、Kimi Code 和 API 中使用;完整权重则计划在 11 月 4 日前发布。官方技术博客 还给了一个很硬的编码信号:在其公布的 Terminal-Bench 4.0 结果里,K3.1 Pro 在最高推理设置下拿到 65.7%。
这很值得试。但我更在意的不是那个分数,而是它把一个旧习惯又推到了眼前:上下文够不够大,和任务该不该全部塞进去,是两件事。
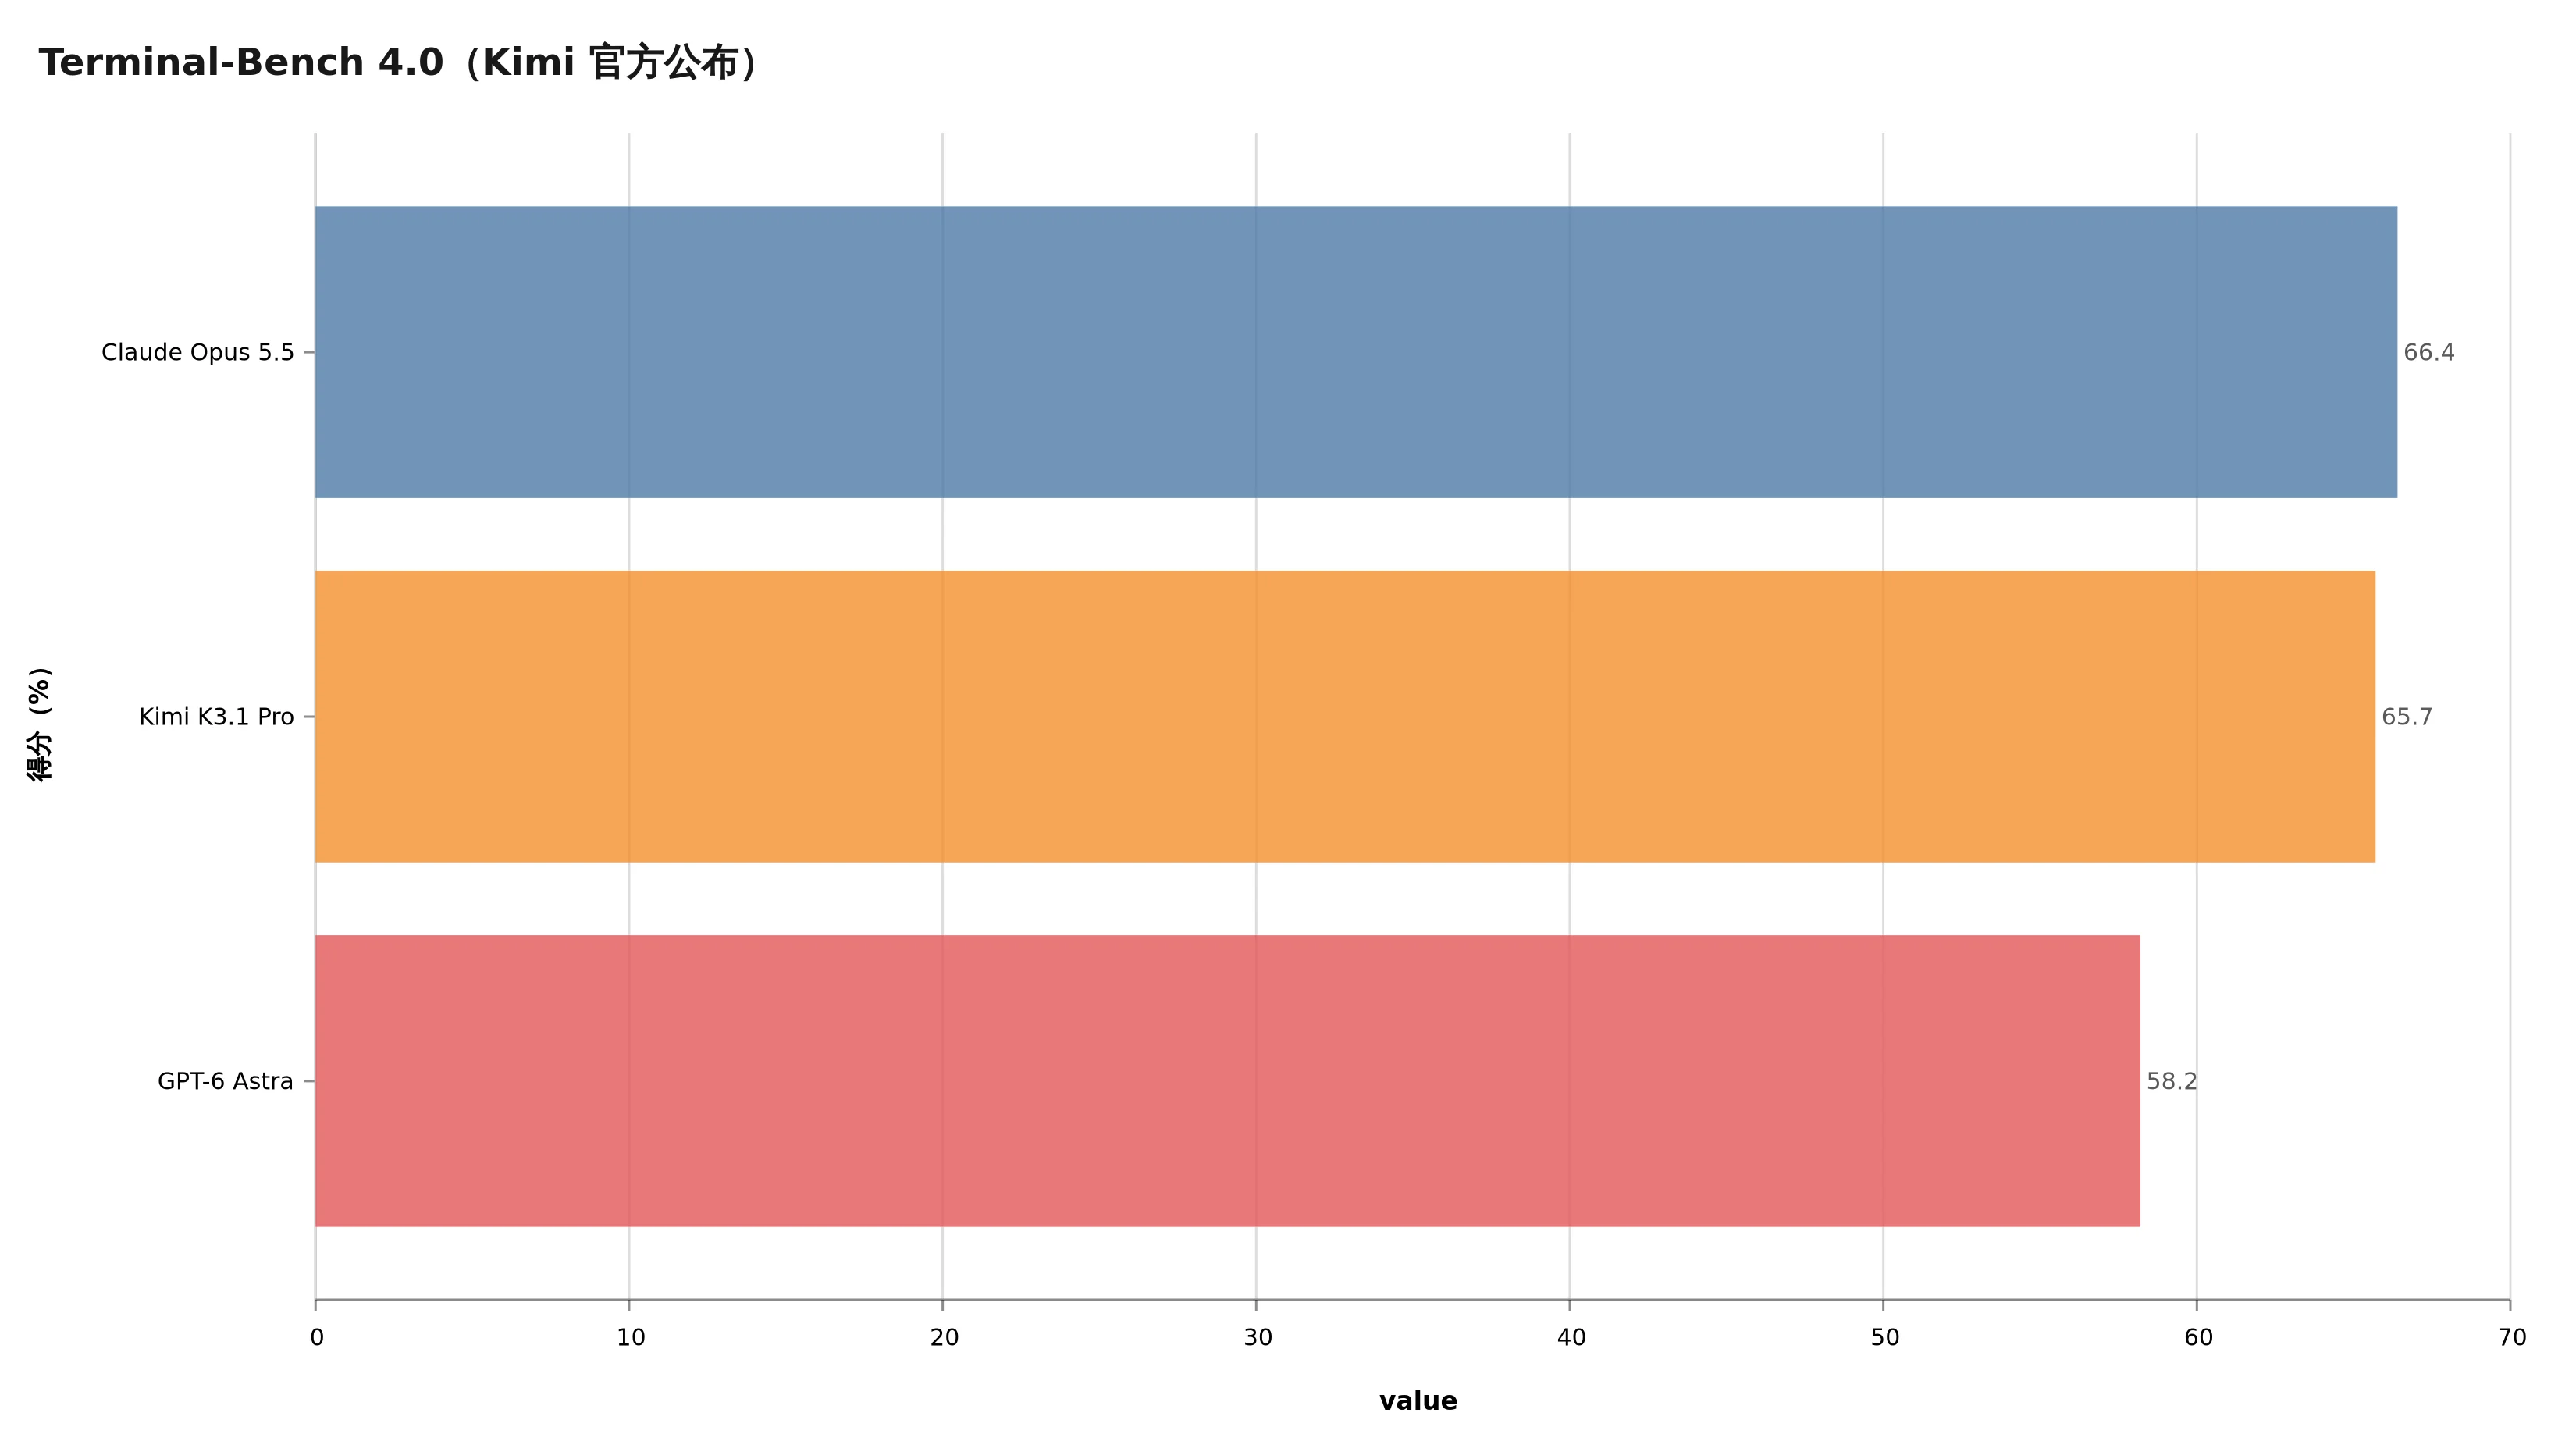
图:根据 Kimi 官方发布页列出的 Terminal-Bench 4.0 数据绘制。厂商结果可以用来判断是否值得试,不等于你的仓库会原样复现。
100 万 Token 解决的是「装不下」,不是「看得准」
上下文窗口像一张很大的工作台。以前,模型看到入口文件、两三个模块和报错日志,旁边那份关键配置可能根本放不下;现在你可以把更多代码、文档和历史决策同时放到桌上。
但工作台变大以后,新的问题是:桌上哪些东西和这次改动有关?
一个典型任务是修订单页的折扣计算。你把整个 monorepo 放进去,模型当然能看到前端、后端、脚本、旧的实验目录、几十份迁移文件。它也更容易被废弃接口、同名字段和测试夹具带偏。最后给出的改动看起来很完整,甚至补了测试;真正的问题却藏在当前生效的规则配置里,而那一层关系没有被你指出。
大窗口不会自动替你判断「当前生效的是哪一份」。它只是让模型有机会读到更多候选答案。
这也是我对 K3.1 Pro 最实际的期待:它适合接手跨文件、跨轮次、很难一次讲全的任务,而不是替我们取消任务拆分。官方在长程编码评测中也强调了工具使用和端到端执行;这些能力更需要一个清楚的目标,而不是一团更大的材料。Kimi Code 的模型说明 已把 K3.1 Pro 列为支持 100 万上下文的模型,但开关变大,不等于使用方式可以偷懒。
给代码 Agent 的材料,分三层交
如果你正在用 Kimi Code 或 API 处理陌生代码库,我建议把「能装多少」换成「这次该给多少」。这是一份可以直接带走的投喂清单。
任务边界。 用三句话写清楚要改什么、不能碰什么、怎样算完成。例如:
目标:修复订单页在会员折扣叠加时的金额计算。
限制:不要改动支付回调和数据库表结构。
验收:补充两组折扣叠加测试;金额结果与现网规则表一致。
这不是形式主义。没有验收条件,模型会把「看起来合理」当作完成;有了边界,后续的大上下文才有一个筛选器。
最小相关文件集。 入口组件、业务服务、当前规则配置、失败测试和那段真实日志,通常就够模型提出第一轮修改。让它先回答「我还缺什么」和「我准备改哪几个文件」,不要急着让它动手。
仓库级补充。 只在关系确实跨得很远时,才扩到这里。比如迁移一套鉴权机制、排查一个跨包的类型污染、梳理旧系统为什么在某些客户配置下失效。这时 100 万上下文的价值很大:你不必在每一轮对话都重新搬运背景,模型也能保留前面确认过的约束。
图:Kimi K3.1 Pro 官方发布主视觉。产品已可调用,完整权重仍以官方公布的 11 月 4 日前发布为准。
三层不是固定的三段 prompt。它更像一次渐进式代码审查:先让模型建立假设,再补证据,最后才让它执行。这样就算模型判断错了,你也能在第二层发现它读错了哪个文件,而不是等它在一大堆改动里埋下新问题。
先要计划,再要改动
大窗口最容易让人跳过一个很有用的回合:让模型先写出它的行动计划。不是那种泛泛的「我会分析代码」,而是要求它点名:准备读取哪几个目录,哪个文件决定业务规则,哪个测试能证明改动没有伤到别处。
如果这份计划里出现了不存在的文件、把旧版目录当成入口,或者完全没提到你给出的失败日志,先停在这里纠正。这个回合花掉的 token 很少,却能挡住后面一串看似勤快的错误改动。
计划对了,才授权它修改。改完以后也别只问「代码对不对」,让它把变更按「行为变化、风险、验证方式」重新讲一遍。你看到的是它的推理轨迹,测试看到的是实际结果;两边都过,才算值得提交。
什么时候该把窗口真的拉满
碰到下面这些情况,我会果断多给上下文。
交接型任务很适合。新同事接过来的仓库、历史决策散在 issue、设计文档和 commit 里;模型要先把「为什么会这样」还原出来,才能谈修改。大窗口能少掉许多重复解释。
长链路排查也很适合。一个按钮不显示,根因可能在构建开关、权限下发、接口字段和前端缓存之间。把每一段证据都单独抛给模型,前面的判断很容易丢;保留完整链路,才有机会让它主动发现矛盾。
有可靠验收的重构同样适合。你有测试套件、静态检查和可回滚的发布流程。此时可以让模型读得更广,再让测试替你收口。没有验收的重构不该因为窗口更大就变得激进。
反过来,改一个接口字段、补一个边界条件、定位一条确定的异常,给全仓库通常是噪声。把问题缩到几十个文件,往往比 100 万 Token 更快,也更容易复查。
别把「开放权重」和「今天能本地跑」混在一起
还有一个很容易被标题带走的点。K3.1 Pro 现在可在产品和 API 中使用,官方写的是完整模型权重将在 11 月 4 日前发布。所以今天适合做的是:用托管入口拿你自己的小任务试一轮,记录成本、速度、测试通过率和需要人工打断的次数。
如果你关心的是私有部署、推理框架适配或显存账单,先等权重、模型卡和社区实现一起落地再下结论。把「可调用」误读成「可顺手部署」,最后很容易把一场产品试用变成一笔没算完的基础设施账。
K3.1 Pro 还有 Highspeed 版本,官方称响应速度可达标准版的 2 到 3 倍。对反复对话、需要频繁确认边界的编码任务,这类响应差异会影响使用体验;但仍然先把第一层写清楚。模型更快地误解你,不会让修复更快完成。
大上下文真正带来的不是「以后不用整理材料」,而是你终于可以把那些原本不得不删掉的关键关系保留下来。把它留给跨模块因果、历史决策和可验证的长任务;一个明确的小 bug,就让它保持小。
你最近一次让代码 Agent 跑偏,是因为它没看到关键文件,还是因为它看到的东西太多?
— 小岛AI 记录一线实战、踩坑与成长