
端侧多模态上 35B,产品团队该重做什么
MiniCPM-V 4.7 在 iPhone 17 Pro Max 上报出 3GB 内存、13+ token/s 的端侧结果。35B 能跑起来以后,端侧产品该重排的是任务分流、设备策略和验收指标。
手机里的多模态模型,通常很擅长两件事,识别一张图,或者把一页纸上的字读出来。要它连续看图、读文档、再给一段有用的回答,产品团队往往还是会把请求送回云端。
MiniCPM-V 4.7 把这个分界线往前推了一截。面壁智能和 OpenBMB 在 10 月 12 日更新的官方说明里写到,35B-A3B 版本在 iPhone 17 Pro Max 上以 3GB 内存达到 13+ token/s 解码速度。它还是一个能看图、看文档、看视频的多模态模型。
这不是我的实测,也不是拿到一串漂亮数字就可以宣布端侧全面获胜。可它足够让做现场助手、离线扫描、相册理解或设备内知识检索的人重新问一个问题。
35B 级别的多模态能力能落到手机后,产品里哪一段流程还必须上云。
答案不会是全部,也不该是全部。值得重做的是任务分流,而不是把接口地址从云端改成 localhost 就收工。
3GB 不是把 35B 模型塞进了内存
35B-A3B 这个名字很容易让人误会。它确实是一个总参数规模很大的 MoE 模型,MoE 可以理解成模型里有很多专长不同的小组,每次回答只叫其中一部分上场。但不常被叫到,不代表这些专家的权重从此不占地方。
模型指南把麻烦讲得很坦白。设备内存装不下全部专家时,可以把权重放在 SSD,推理时按需读入。问题随即从算得动变成读得及不及时。专家一层层从存储里慢慢找,用户看到的就是输入框上那个很会转、但不怎么回话的圈。
MiniCPM-V 4.7 用的 LES,会根据跨层路由提前猜下一层可能需要哪些专家,把预取和当前计算并行起来。再叠加分层量化与投机采样,官方给出的端侧解码速度比未优化版本高出约五倍。
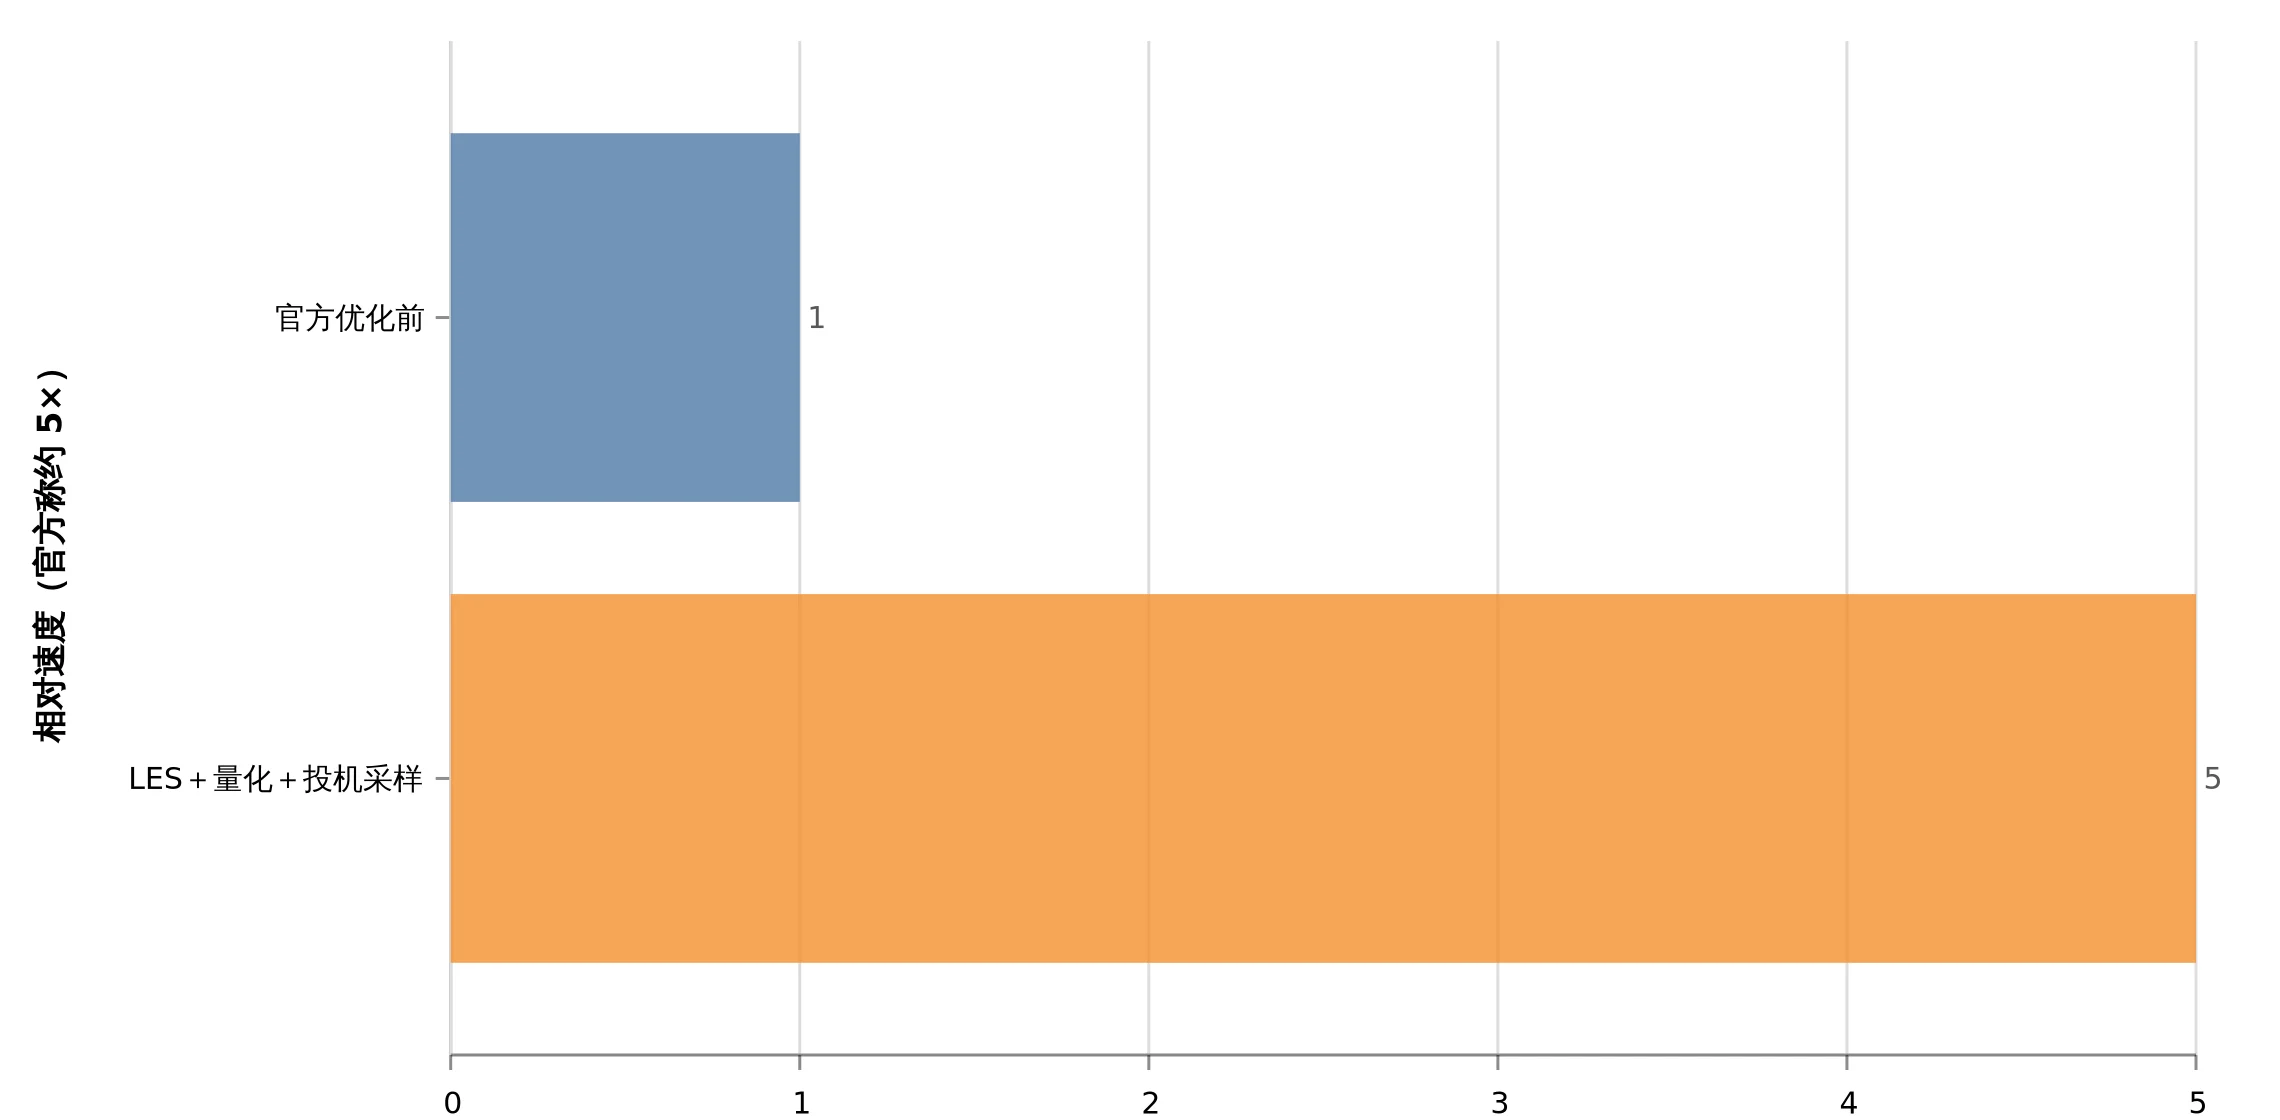
基于官方约五倍端侧真实加速说法绘制的相对速度图,不代表不同设备上的绝对速度。
这组数字最该改掉的认知,是把「激活参数少」直接等同于「部署很轻」。端侧 MoE 要同时面对存储读取、内存、首 token 等待、持续生成、温度和电量。3GB 是特定设备与官方方案下的运行内存结果,不是下载包大小,也不是所有安卓机都能照搬的承诺。
这条边界对产品选型很重要。若任务只是从一张小票里找金额,轻量模型、规则引擎,甚至传统 OCR 都可能更省电更快。35B 的价值出现在一张图里同时有布局、文字、指代关系和上下文时,例如把一页维修记录、一张设备照片和用户的问题合起来判断。模型越大,越不该被浪费在已经有确定解法的按钮上。
也别把端侧路线理解成只有「全本地」和「全云端」两个开关。图片可以在设备上做第一轮理解,用户确认后只把摘要或需要协作的部分送出。云端也可以只处理跨设备历史、复杂检索和用户主动发起的深度分析。这样设计的好处不是把每次联网都当成失败,而是让数据去向、等待时间和降级行为都成为产品可解释的一部分。
可以开始换题,不是全面换栈
对端侧产品来说,35B 多模态模型最有价值的地方,不是让每个请求都脱离云端,而是让一部分以前根本没法本地完成的任务有了候选方案。
第一类是用户不愿上传的内容。工作现场拍到的仪表、私人相册、带身份证明的文档,本来就不适合默认出设备。模型能在本地读图和提取关键信息,云端可以只接收用户确认后的结构化结果,甚至完全不参与。
第二类是网络不稳定时仍要完成的单次判断。物流现场、展会、工地和弱网环境里,用户不在乎模型是不是能长篇大论,更在乎相机按下后能不能给出一个可靠的下一步。官方模型支持 iOS、安卓和鸿蒙,也列出了 Intel、AMD、Arm、瑞芯微与后摩等平台,但这只说明适配入口已经打开,不等于你的目标设备都跑得出同样的体验。
第三类才是混合式工作流。轻量任务交给 1B,复杂图片、长文档或需要更强推理的时刻再调 35B-A3B。用户看到的是同一个按钮,背后却不能再用一个模型、一条延迟预算来管理所有请求。
这种分流不能只看模型名字。把你们最常见的 50 到 100 个真实输入分成三组,清晰可读的单图、需要多页上下文的文档、网络不稳定时采集的现场内容。每组分别看是否完成任务、用户等了多久、失败后有没有可理解的解释。把同一批输入交给本地 1B、本地 35B 和现有云端方案,团队才会看见真正的取舍,而不是在发布会图表前猜参数。
这里有个经常被省掉的产品细节。端侧模型的失败不是一条 HTTP 错误码。它可能是相册权限没开、系统回收了内存、下载的量化版本不完整,或者设备在高温时主动降频。每一种失败,用户下一步都不同。把它们全收敛成「生成失败,请重试」,模型做得再好也很难变成可托付的功能。
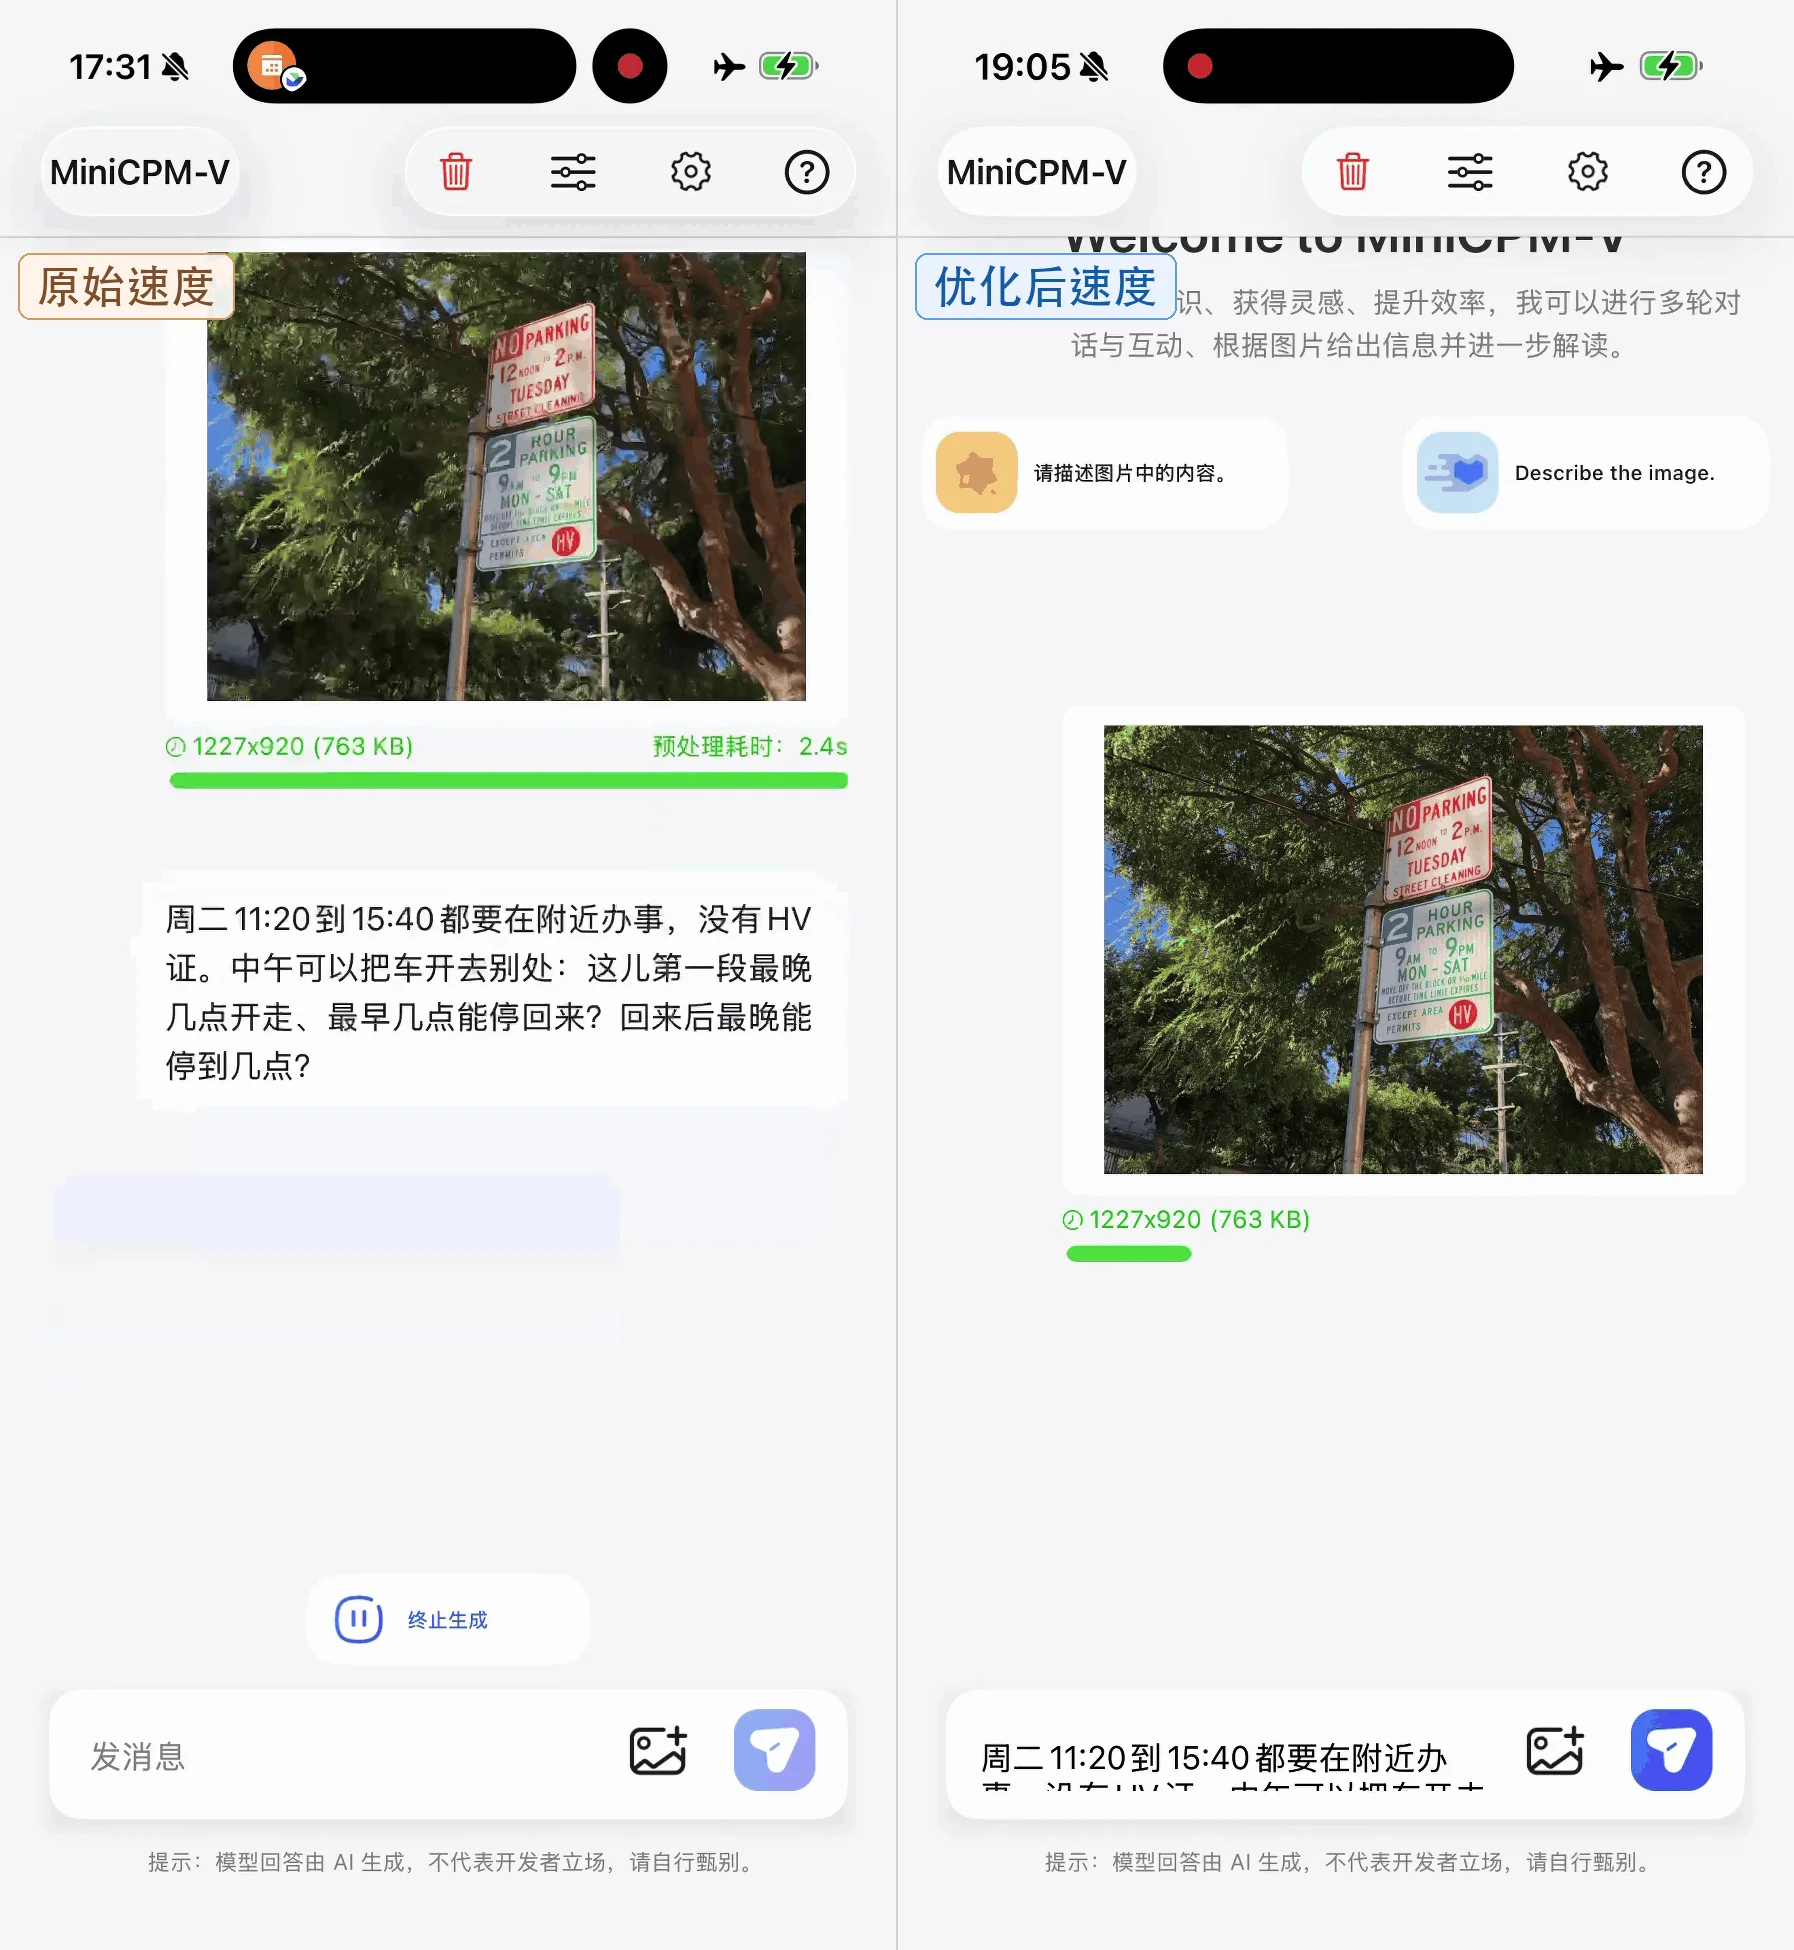
官方手机端演示截图。右侧为优化后速度,图中没有替代不同设备上的实测。
这也是为什么我不太赞成把这次更新写成「手机终于装下大模型」。装下是一个二元词,产品体验不是。真正发生变化的是,端侧模型可以开始参与任务设计,而不再只充当离线兜底。
压力从算力,挪到了设备节奏
云端接一个模型,团队最常看的数是吞吐和单次调用成本。端侧上 35B,多了一层更顽固的现实,设备每一次读取、发热和后台回收都会参与回答。
官方结果报的是解码速度,没有替你回答首 token 要等多久,也没有替你测连续拍十张图后的温度,更没有覆盖中低端安卓设备。把 13+ token/s 直接写进产品需求,和拿发布会跑分估计线上 P99 延迟,都是同一种乐观。
如果要做第一个版本,我会把验收从模型分数换成五句人话。
任务是否值得本地做。 只挑一项真正受隐私、弱网或上传等待影响的任务,不要一上来让模型接管整个 App。
目标设备是否足够具体。 以 2 到 3 个真实机型分档,高端机跑 35B,中端机退到 1B 或云端。没有分档,兼容性最终会变成客服问题。
用户等待是否被拆开记录。 分别记录首 token、连续生成、图片预处理、热状态和失败后的降级时间。只记录平均 token/s,看不见用户真正卡住的地方。
退出路线是否存在。 模型加载失败、设备过热、存储紧张时,界面要告诉用户正在换轻量模型还是转向云端,不能让一个没有结论的转圈替你解释系统状态。
模型输入是否被当成产品协议。 图片尺寸、页数、视频时长、可用内存和系统版本都要写进测试样本。端侧模型不是一个孤立的函数,同样一句问题,配上一张高分辨率图片和十页 PDF,走的就是两条完全不同的设备路径。没有这层约束,用户的真实输入会比演示样本更早把边界撞出来。
把这四项接进埋点后,产品团队还能得到一个比模型排行榜更有用的信号。用户愿不愿意在结果出来前继续等。只要本地处理让用户少等上传、少担心照片离开设备,又能给出足够可信的初步回答,等待几秒并不一定糟。反过来,如果任务只是一次简单识字,让手机为了调度专家而发热,哪怕模型分数再高,也是在用工程复杂度换一个没人需要的答案。
发布首周也不要盯总调用量。看用户在哪个输入类型上主动重试,哪个设备档最常被降级,哪些回答被用户复制、确认或继续追问。前两个数会告诉你系统哪里还不稳,后三个数才有机会说明模型真的帮用户完成了事情。端侧能力做成产品,靠的不是一次跑分,而是这些小反馈慢慢把分流规则磨出来。
还有一笔很少写进立项文档的账。模型权重、量化方式、运行时和提示词模板会一起决定设备上的表现。官方已经提供 GGUF、BNB、AWQ、GPTQ 等量化入口,也兼容 llama.cpp、Ollama、vLLM 和 SGLang。选择更多,版本组合也更多。一次模型升级后,不能只测回答有没有变聪明,还要回归相机输入、长文档、后台切换和断网恢复。
端侧试点因此更像一次产品实验,而不是一次模型替换。把一个具体任务、一小批设备和一条清楚的退路框住,先确认用户到底从本地处理里得到什么。把这件事写成一页可回看的验收记录,比留下一张运行截图更有用。若答案只是「参数看着很大」,项目会很快被电量、包体和售后磨平。若答案是「用户少等一次上传,也少交出一份不该离开设备的内容」,35B 才有机会成为体验的一部分。
这些都不华丽,却是端侧模型从 Demo 走到产品时最容易丢的一块。模型团队已经给出了权重、量化版本和端侧部署仓库。接下来该由产品和工程团队证明,哪些真实任务值得用它换回本地。
35B 跑进手机不是终点。它像把一条以前封死的岔路打开了,往里走之前,得先决定谁走、走多远、走不动时怎么回来。
如果你在做端侧 AI,最想从云端拿回来的那一个具体任务是什么呢?
小岛AI