
AI 写代码以后,PR 为什么更慢了?Vapi 用 3 条规则把合并时间砍半
Vapi 的内部审查机器人把平均 PR 合并时间从超过 130 小时降到 65 小时。真正能复用的不是机器人名字,而是它怎样处理权限、误报和证据。
AI 把写代码这一步推快了,很多团队却在另一个地方堵住了。
不是模型没写完,是 PR 打开以后,没人敢立刻点合并。改动变大了,文件变多了,测试绿了也不总代表事情真的没坏。审查人盯着一串由模型生成的 diff,看得越快,心里越没底。
Vapi 刚公开了一组挺具体的内部数据。他们的 PR 从打开到合并,平均曾超过 130 小时。接入内部的 Pedantic Review Bot 后,平均降到 65 小时。它不是一个放在 GitHub 边上刷存在感的评论机,做法里有三条规则,刚好能回答一个更现实的问题。
自动审查到底该替人省掉什么,又绝不能替人做什么。
先把边界说在前面。65 小时是 Vapi 自己的生产结果,不是买一个机器人就能复制的承诺。他们的代码库、人工队列、模型和流程都很具体。值得抄的是那套把机器人塞进流程的方式。原始案例把细节写得很直白,里面甚至保留了不少没跑好的实验。
机器人先吃掉等待,不抢走决定
做代码审查机器人时,很多人的第一反应是把速度拉满,最好 PR 一打开,十几秒内给一堆行内评论。
这很像给堵车的路口多装了一个催喇叭的机器人。声音很大,车未必走得更快。
Vapi 的判断反过来。他们原本的人工合并周期是按天算的,所以愿意让机器人花 20 分钟做一次审查。这个时间放在模型演示里不漂亮,放在一个要等几天的 review 队列前面却完全说得过去。
这里有个很实用的换算。机器人的延迟预算,不该由模型能跑多快决定,而该由团队原来要等多久决定。
如果人工 review 通常 4 小时才轮到,机器人用 8 分钟跑测试、追调用链、再给出少量证据充分的评论,已经是在替团队回收时间。反过来,人工本来 10 分钟能合的 PR,机器人跑 25 分钟还要求所有人等它结束,那就是给流水线加了一个新红灯。
所以接入前别先问模型选哪个,先看三个数。
- PR 从打开到第一次有人反馈,通常要多久
- 平均合并时间里,真正花在等待上的部分有多少
- 一条机器人评论被工程师验证和处理,平均又要花多久
第三个数很容易被忽略。它决定了机器人是帮你筛选,还是给每个 reviewer 发一份新的作业。
让模型跑代码,但别让它拿着合并权
Vapi 的机器人并不只读 diff。分析任务会检出 PR,必要时追踪调用者、运行它怀疑会失败的测试,或者写一个小复现。很多真正影响发布的问题,单看改动文本就是看不出来。
他们举过一个例子。某个改动把测试断言换成了 Storybook 故事,页面看起来有东西,测试运行器却根本不会收集这些故事。另一次流量切换里,两次写入顺序反了,本该零流量的版本会在很短的窗口里先接到全部流量。
这类问题有一个共同点,需要执行或检查真实工程约束,光让模型读一遍 diff 不够。
但给模型执行能力,不等于顺手把所有凭据也交出去。Vapi 把工作拆成两段。
第一段是分析 worker。它可以读代码和跑受限的验证动作,但没有 Git 凭据,发现只写到 JSON 文件。第二段只验证这个结构化结果并发布评论,它不会执行模型临时写出的命令,更不能批准 PR 或推送代码。
这个拆分看着有点啰嗦,实际上是自动化审查最该有的一道隔离墙。模型读到的是不可信代码和不可信 PR 描述,里面可能有提示注入,也可能藏着危险的脚本。让它去分析可以,让它带着发布权限直接做下一步,事情的性质就变了。
如果你的团队准备接入,最小版本可以先写成这样。
analysis_worker:
  permissions: read-code, run-allowlisted-checks
  secrets: none
  output: review-findings.json

comment_worker:
  permissions: post-comments
  input: validated-review-findings.json
  cannot: approve-pr, push-code, execute-model-output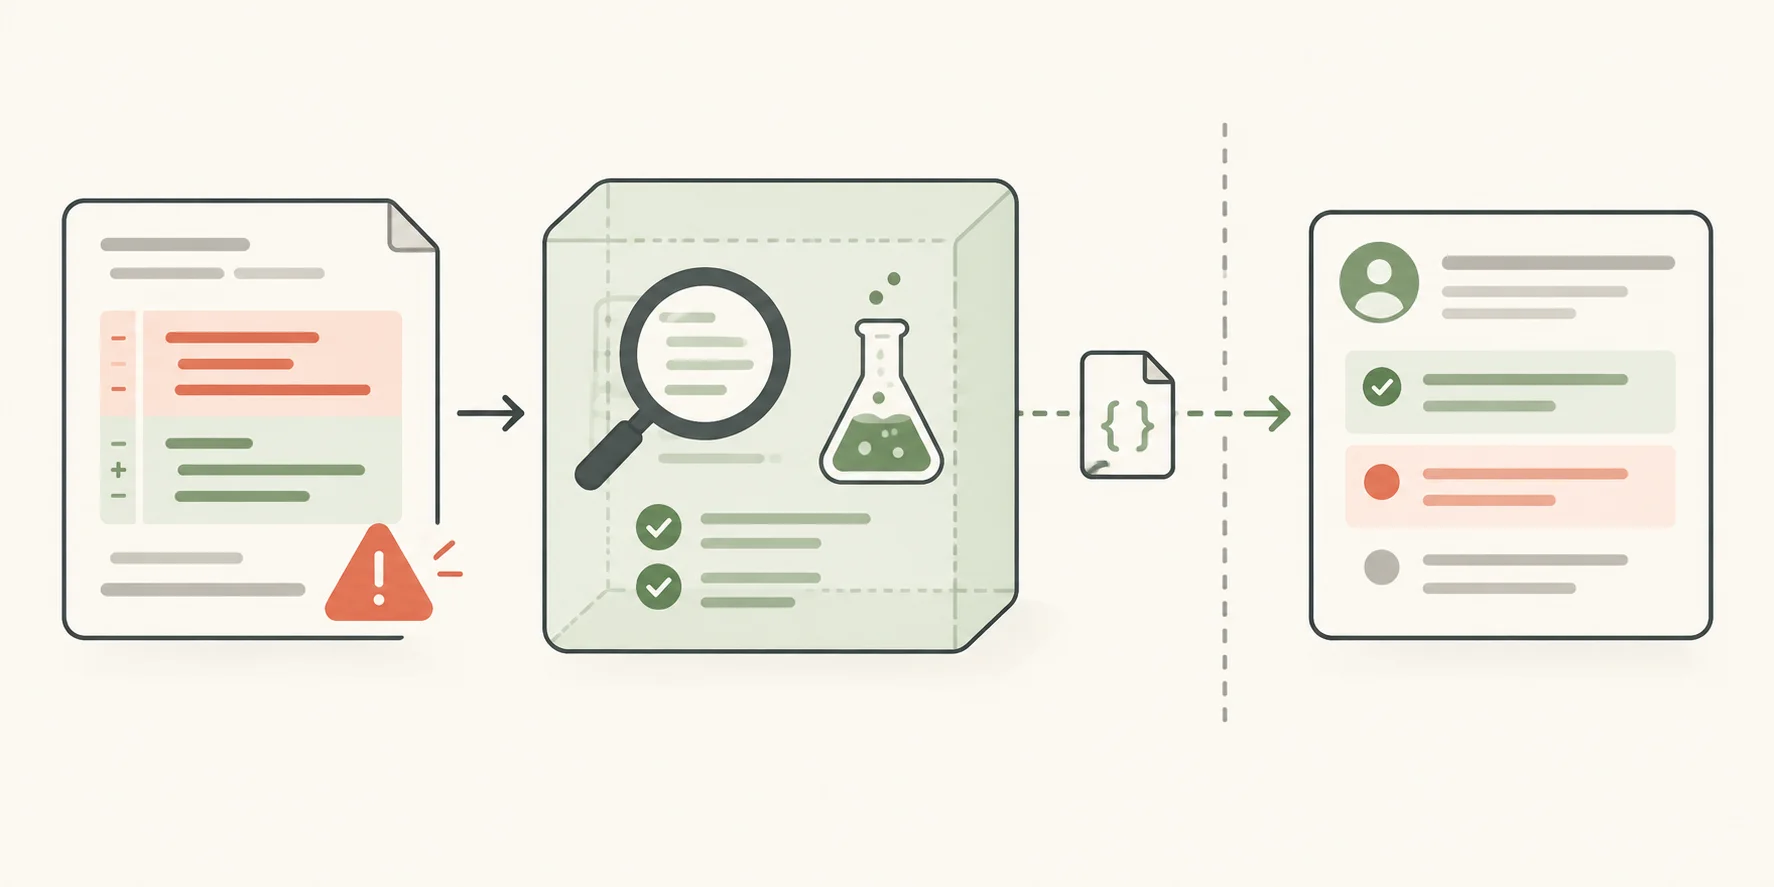
把不可信代码分析和评论发布拆成两段,模型只能通过结构化结果跨过边界。
这不是一份万能配置。它至少逼着团队先回答一个问题,机器人能读取什么、运行什么、发布什么,分别由谁承担风险。
误报不是瑕疵,是一笔会累积的账
自动审查最容易翻车的地方,不是漏掉 bug,而是报得太勤。
Vapi 的早期版本留下太多评论,连团队内部都觉得像粗心的 AI 输出。后来他们反复改提示词,把评论压短,要求问题更容易行动,也把修复范围限制在当前变更触及的代码附近。
他们做过一次很残酷的对照。在同一个 PR 上,只改开场指令,跑了 101 个版本,得到 803 条原始发现,归并为 57 个问题。复核后,32 个被判为真实问题,24 个是误报,还有 1 个无法判断。
一开始,报告把更激进的提示词评成赢家,因为它抓出的东西更多。团队没有接受这个结论。多报一个问题,即使它是真的,也要有人重新理解上下文、确认影响、决定要不要修。多报一个假的,代价更高。
审查机器人不能只按命中数计分,误报必须进入成本表。
这也解释了为什么很多团队一接机器人,前两周觉得很兴奋,第三周就开始静音。模型的输出量是显性的,工程师被打断的注意力是隐性的。后者没有被记录,系统会一直朝着更多评论优化。
给机器人设一个简单的验收口径,比继续堆 prompt 有用。
- 每条评论能否在一句话里说清问题和影响
- 能否附上测试、调用链或可复现步骤中的至少一项证据
- 被关闭为误报的比例有没有持续上升
- 评论是否说明问题由本次 PR 引入,还是原来就存在
最后一条尤其重要。Vapi 发现,只加一句允许报告父提交中已经存在的问题,就能让某些配置的输出明显变化。工程师当然可以顺手修旧坑,但那不该和本次 PR 是否可合并混成一个判断。
多跑几次,未必比一次拉满更贵
Vapi 还测了一个挺反常识的组合。同样的预算下,三次高努力度审查优于一次最高努力度审查。
在他们的测试里,三次 Sonnet 5.5 高努力度代码审查花了 12.32 美元,得到的严重性加权分是 44。一次最高努力度花了 12.30 美元,得到 35.5 分。设计审查也有类似结果。
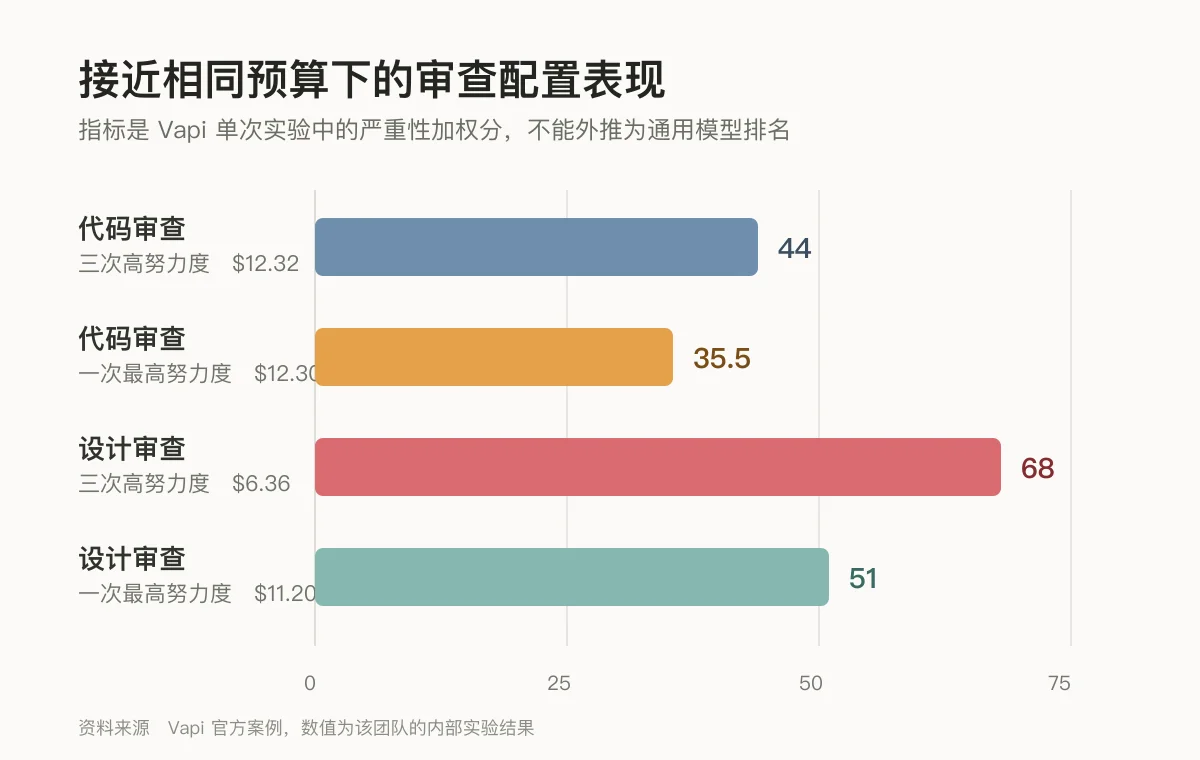
图中是 Vapi 的单次内部实验,比较的是接近预算下的配置表现,不是通用模型排名。
别急着把这条写进团队规范。那是 Vapi 在自己的改动和计分方式下得到的结果,甚至他们也承认单次实验会漏掉真正阻断合并的问题。
更值得带走的是实验方法。别拿通用榜单替你们的仓库做决定。挑一组已经知道结果的 PR,保留 diff、上下文和验证方式,比较模型、努力度和运行次数。再把误报、漏报、成本和人类处理时间一起算进去。
模型名称会换,代码库不会自动变得好审。把自己的 PR 当考题,才知道它到底有没有帮上忙。
先做一个安静的 reviewer
如果团队现在已经被 AI 生成的 PR 追着跑,我会建议从一个很小的版本开始。
先让机器人只给新 PR 做一次预审,不自动批准,不自动修复,不替人下合并结论。它只报告阻断级问题和少量高置信度问题。每周随机抽一些它没报问题的 PR 回看,也把被关闭的评论标成误报、已修复或暂缓。
跑两周以后,再看它有没有缩短等待,有没有减少返工,而不只是看它写了多少字。
AI 写代码已经把提交变便宜了。接下来更稀缺的,是一个能让团队放心点合并的流程。
你们的 PR 最常堵在哪一段,是没人有空看,还是大家看完也不敢点合并?
小岛 AI