
给 Agent 加分类和路由,OpenAI 这次把输出 token 免了
Decisions API 把分类、路由和评分拆成专用调用。它适合答案有边界的高频环节;生成、解释和新问题,仍该留给 Responses API。
一个 Agent 从收到输入到真的做事,中间经常要做一串很小的判断:这条消息该给哪个工作流?刚才的工具报错该重试、追问,还是转人工?一段外部内容能不能进入下一步?
很多团队会让通用模型把这些题也完整回答一遍。模型当然能答,可它会按“生成一段回答”的方式跑完。对一个只有四个选项的路由题来说,这多少有点像为了按电梯,先请人写一篇楼层分析报告。
OpenAI 昨天正式开放的 Decisions API ,瞄准的就是这块空档:你先把问题和允许答案写清,它返回一个选择、分数或概率,而不是一段需要再解析的自然语言。官方说,在部分场景里它比通过 Responses API 调 GPT-6 Luna 最多快 10 倍;输入价格是每百万 token 0.10 美元,缓存输入是 0.01 美元,且没有输出 token 费用。
这不是“更便宜的万能模型”。它更像把 Agent 里那一层本来就应该明确的判断,单独拎了出来。
先分清:你要的是答案,还是一个决定
最容易误用的地方,是把“模型能回答”当成“这里该用生成”。
如果你的问题是“把这封邮件总结一下,再拟一封回复”,显然要生成。答案事先不知道长什么样,也需要解释、措辞和上下文组织。
但如果你的问题是“这次工具调用是继续、重试、追问,还是转人工”,答案空间已经被你定义好了。模型要做的是在有限选项里判断,不是临场写作文。
Decisions API 把这类题分成三种返回方式:
predicate:问一个条件成立的概率。比如“这条工单是否涉及账户安全?”choice:从你给出的选项中选一个。比如“继续/重试/追问/升级人工”。score:按有序量表打分。比如把一段回复的风险分成低、中、高。
这里有个细节挺重要:choice 不只是给一个标签,官方说明里还会带各选项的概率和置信度。也就是说,路由规则终于可以从“模型说了算”变成“模型给判断,系统按阈值办事”。
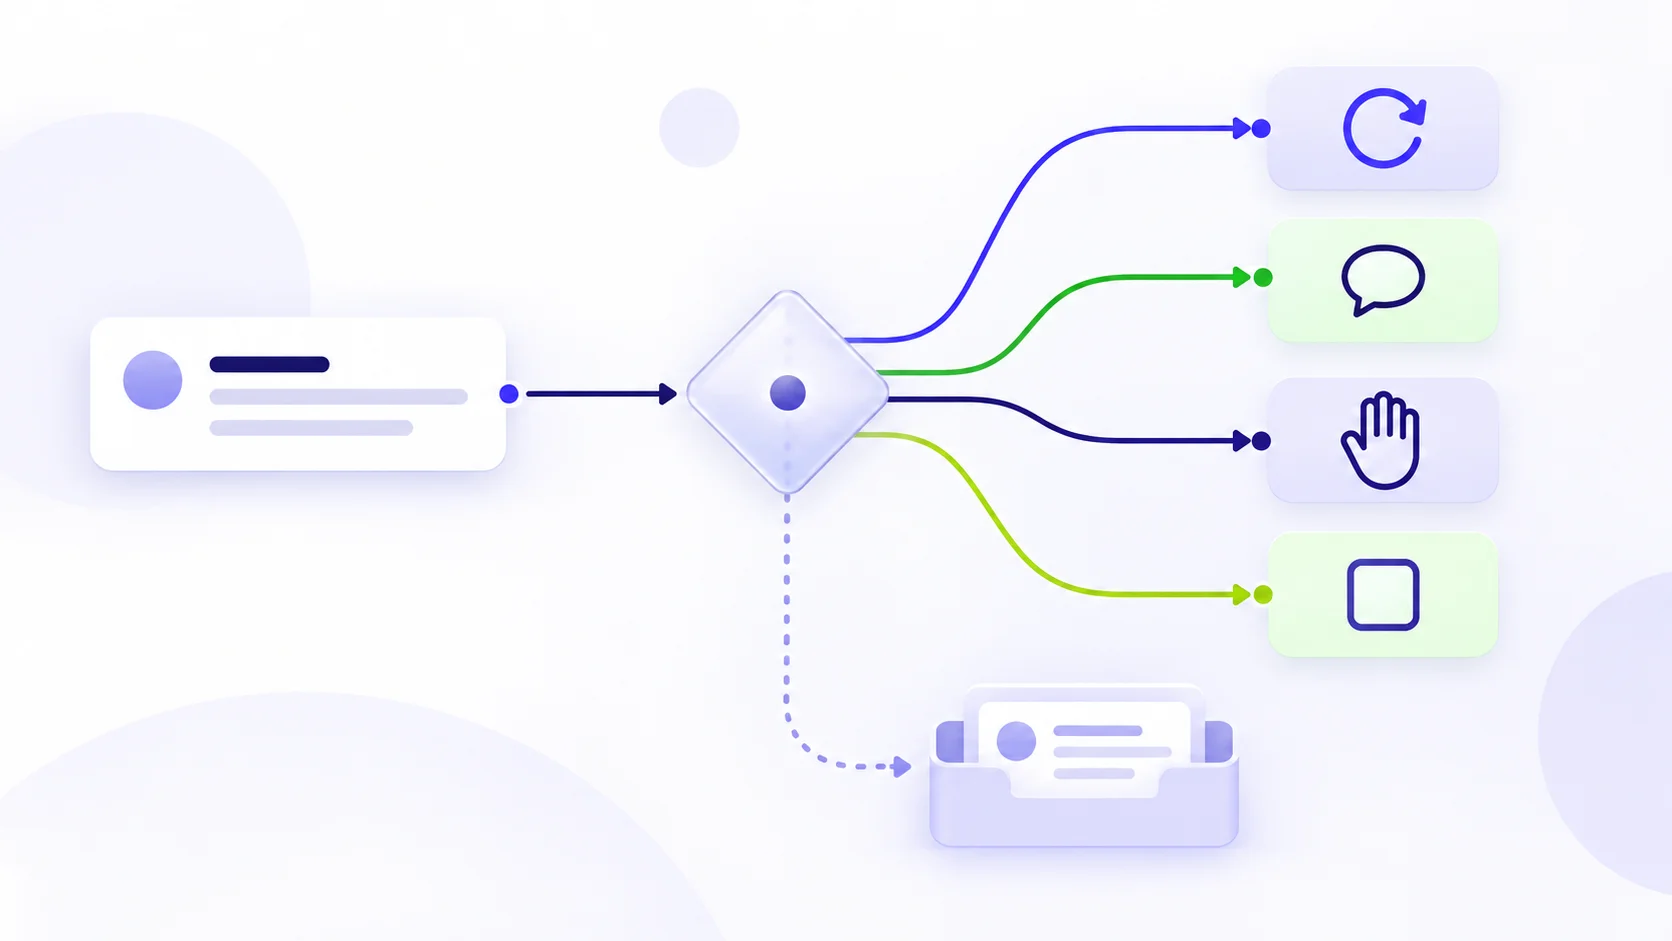
把模型判断与真正执行分开:低置信度不是硬接着跑,而是留给系统规则或人工升级。
最值得先拆出去的,是这三类节点
第一类是入口分类。客服、审批、内容审核、文档归档、故障工单,进来时都要判断归属。答案通常有限,速度又会影响后面整条链路。
第二类是编排路由。多工具 Agent 经常卡在“下一步做什么”:查知识库、调用业务 API、再问一句、还是停止。把可选动作写成固定集合,至少能让日志里留下一个可复盘的决策点。
第三类是执行前的窄门。比如一条 shell 命令是否该进沙盒、一笔自动退款是否需要人工确认、一段抓来的文本能否写入知识库。注意,模型判断不该取代权限和策略;它适合做额外信号,最终的允许条件仍要由硬规则兜底。
下面这段只是一个工作流设计示范,不是可直接复制的 SDK 调用。重点不在字段名,而在于把“能做什么”和“什么情况必须停住”写成系统可以验收的边界:
{
  "question": "下一步如何处理本次工具错误?",
  "type": "choice",
  "choices": ["retry_once", "ask_user", "escalate_human", "stop"],
  "context": {
    "tool": "billing_lookup",
    "error_code": "UPSTREAM_TIMEOUT",
    "retry_count": 1
  },
  "system_rule": "置信度低于阈值或涉及扣费时,一律转人工"
}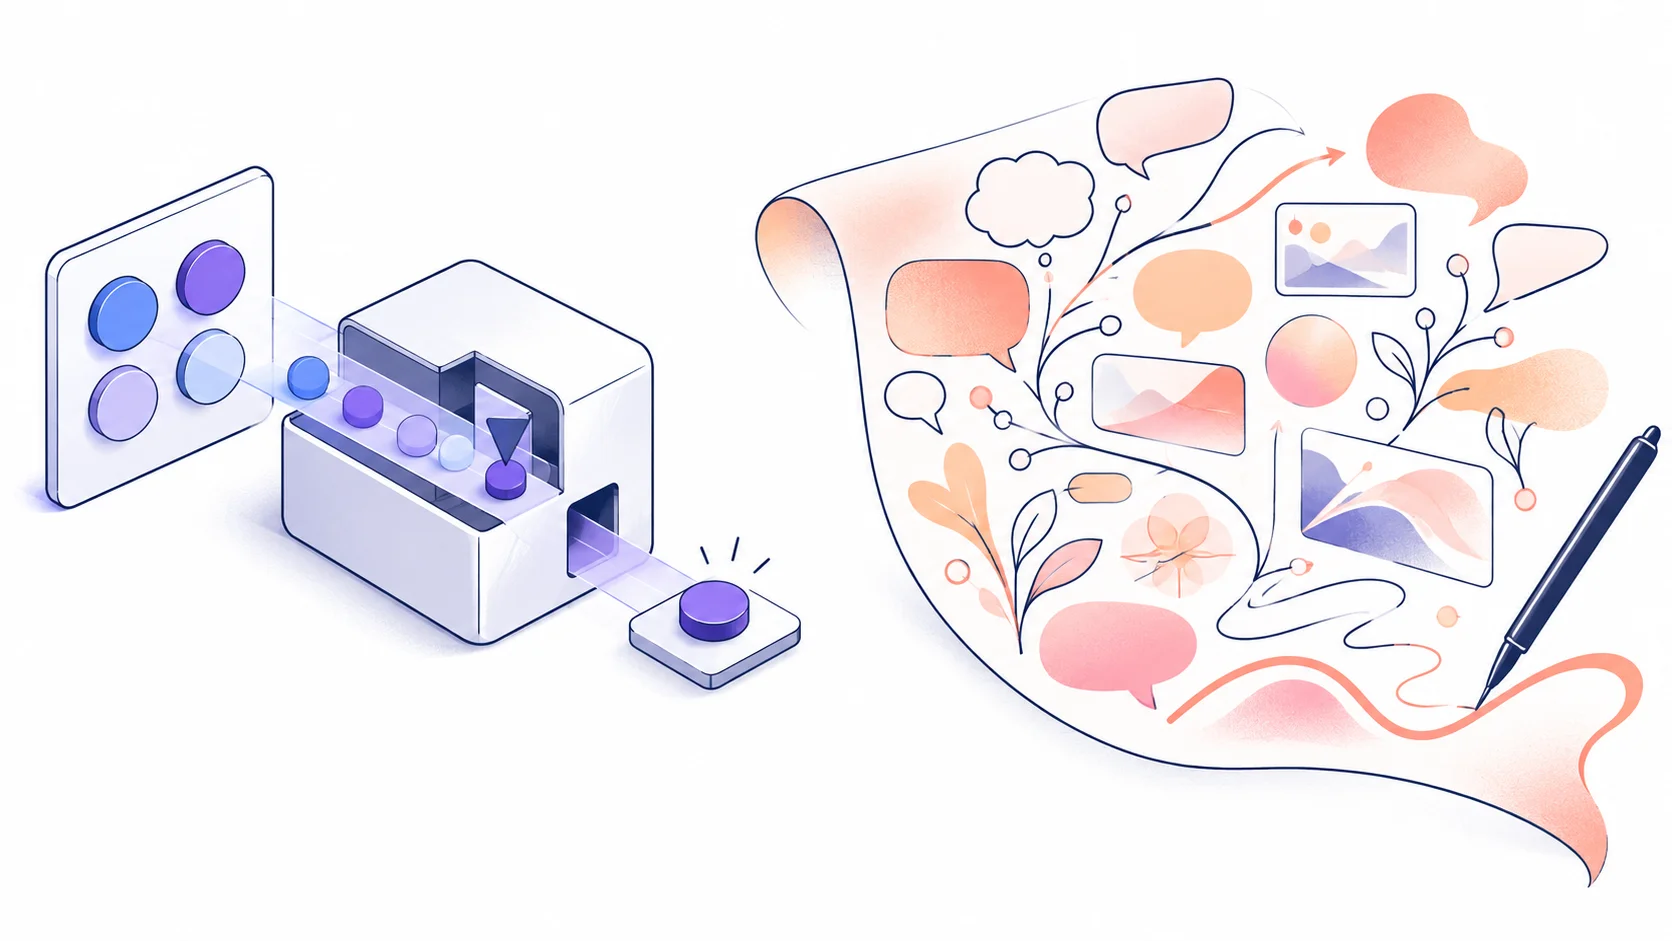
左边是答案有边界的判断;右边是需要组织语言、解释和创造内容的生成任务。两者不是替代关系。
别为了省钱,把该解释的地方也压成选项
专用决策调用最怕两种偷懒。
一种是选项本身没定义好。把 other 塞进所有分类题,看起来很完整,实际上只是把不确定性藏起来。先看近一百条真实输入,弄清楚哪些情况真的会发生,再决定选项该不该拆细。
另一种是把需要推理和解释的任务,硬压成“是/否”。例如“这份合同有没有风险”就不是一个好的一步判断题。它至少需要先抽取条款、解释风险来源,再决定是否交由法务。这里的 Decisions API 可以负责最后的升级路由,但不该假装替代前面的分析。
官方公告里提到单个请求最多能带 400 个问题,也支持文本、图片和原生 JSON。这个能力适合把同一份上下文下的多个独立判断放在一起做;它不等于可以跳过工作流里的依赖关系。一个决定会改变下一步输入时,还是应该让链路明确地走到下一节点。
上线前,先拿一条旧链路做对照
别一上来改掉所有 Agent 路由。找一个答案有限、量够大、又有人工处理记录的节点就行:例如工单分流、失败重试或风险升级。
用真实历史样本建一小份回归集,至少记下四个数:原有链路与新调用的 p95 延迟、单位任务成本、和人工结论的一致率、低置信度样本最后被怎么处理。别拿十条漂亮的合成样例给自己打高分,回归集里要保留那些曾经误路由的边角案例。官方客户案例里有 Box、Datadog、Ramp、Sierra 等团队的速度和成本数据,但那是各自任务上的早期结果,不是你的 SLA。
还有两个退出条件,最好在接入前就写进代码。一个是“未知”:当所有已定义选项都不贴切,不要逼模型在错误答案里挑一个;另一个是“低置信度”:它不该悄悄变成一次自动执行,而该落到追问、规则复核或人工队列。
这样做还有个很朴素的好处。以后有人问“为什么这笔操作没有自动放行”,你能拿出当时的问题、选项、置信度、阈值和最终去向,而不是只留下一段很难稳定解析的模型散文。
真正值得看的是:拆出去之后,系统是不是更容易解释“为什么这次继续、为什么那次停住”。如果只能省几毫秒,却让错误升级没有落点,那就只是把复杂度挪到了以后。
OpenAI 这次把输入价格、缓存和零输出 token 都摆得很直白。但对多数 Agent 来说,更大的变化不是账单,而是提醒我们:生成模型不必承包每一个小决定。
你们的工作流里,哪一个“本来只该四选一”的节点,还在让大模型写一整段话?
—— 小岛 AI