
给 AI 接网页时,API、脚本和 Agent 到底怎么选
一张选择清单,分清什么任务该走 API、固定步骤用脚本、页面会变再用浏览器 Agent;把验收和人工确认留在副作用之前。
你让 AI 去某个后台把本月数据导出来,顺便比一下异常项。它能打开网页、登录、找菜单、点下载,听着像是浏览器 Agent 的标准题。
把这类任务做成 Agent 后,真正的坑未必在「点不到按钮」。有 API 的事情可能被绕去点后台;每周固定跑一次的报表可能交给模型临场发挥;任务显示完成后才发现文件没下载、表单没保存,重试又多提交了一次。
这不是模型够不够聪明的问题,而是实现路径选错了。
Browser Use 在 10 月 18 日的一篇官方指南里把顺序说得很清楚:有合适 API,先用 API;没有 API、步骤又固定,用脚本;只有下一步确实无法预先定义时,才让浏览器 Agent 接管。
这篇不做 Browser Use 的安装教程,也不把官方说明写成自己的实测。只想把这条顺序翻成一张能带进项目评审的选择清单:让 AI 接网页之前,先问五个问题。
先别问「能不能做」,先问「下一步是不是已知」
网页自动化最容易被误解成二选一:手工点,或者上 Agent。中间其实还有一大片脚本的地盘。
先看 API。 如果服务已经提供了完成任务的接口,直接调用它。拉订单、取报表、写入状态,这些任务经由 API 的输入、输出与错误码都更清楚。你也更容易给权限做最小化配置,验收时只需核对返回值和服务端记录,不必猜浏览器当时看到了哪一个弹窗。
没有 API,再看脚本。 比如每周一从同一个后台下载同一份报表,页面路径、筛选项、下载按钮都稳定。用 Playwright、Selenium 或 Puppeteer 把步骤写死,改版了就修脚本。它有维护成本,但每一轮执行的路径都可预测。
最后才是 Agent。 你要到多个陌生站点找同一类资料;每个页面的字段结构不同;或者表单会根据上一步答案改变,没法提前列出所有点击。这时模型的判断能力才抵得上它的不确定性。
这条顺序不是说 Agent 只能留到项目最后。它很适合先把模糊流程跑出原型,帮你发现哪些页面和分支真的会变;等其中一段已经反复稳定出现,再把那段沉到 API 或脚本里。把可预测的部分固定下来,才不会让每次模型调用都从零做决定。
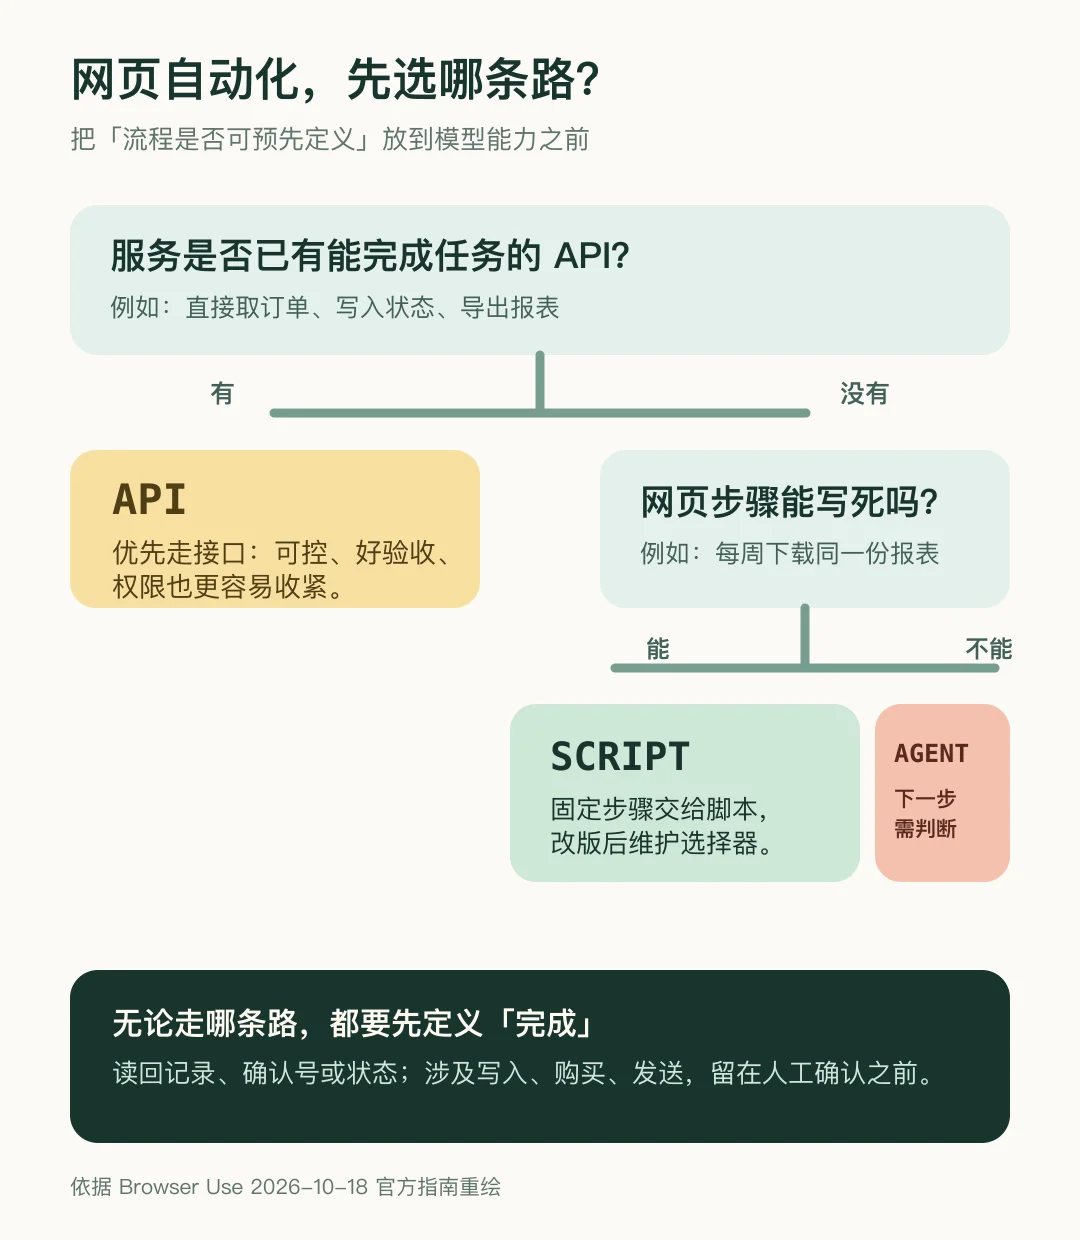
图:根据 Browser Use 官方流程重绘。三条路不是能力高低,而是对「流程是否可预先定义」的不同回答。
一个很实用的反向检查是:把任务写成「给定 A,依次做 B、C、D,得到 E」。如果中间每一步都能写完整,先不要引入 Agent;如果你在第二步就得写「看页面情况决定」,它才有出场理由。
Agent 不是浏览器,它是一个带判断的循环
很多方案只把注意力放在远程浏览器:能开页面、能点击、能截屏,似乎就已经接好了 Agent。其实浏览器只负责保存标签页、Cookie 和登录状态;真正决定系统会不会失控的,是外面的循环。
官方把这套组合拆成三层:模型负责判断下一步;浏览器提供页面、点击和输入;harness 负责把上下文和工具交给模型,执行动作,再把观察结果送回去。它还要在时间、步数或成本到上限时把任务停下。
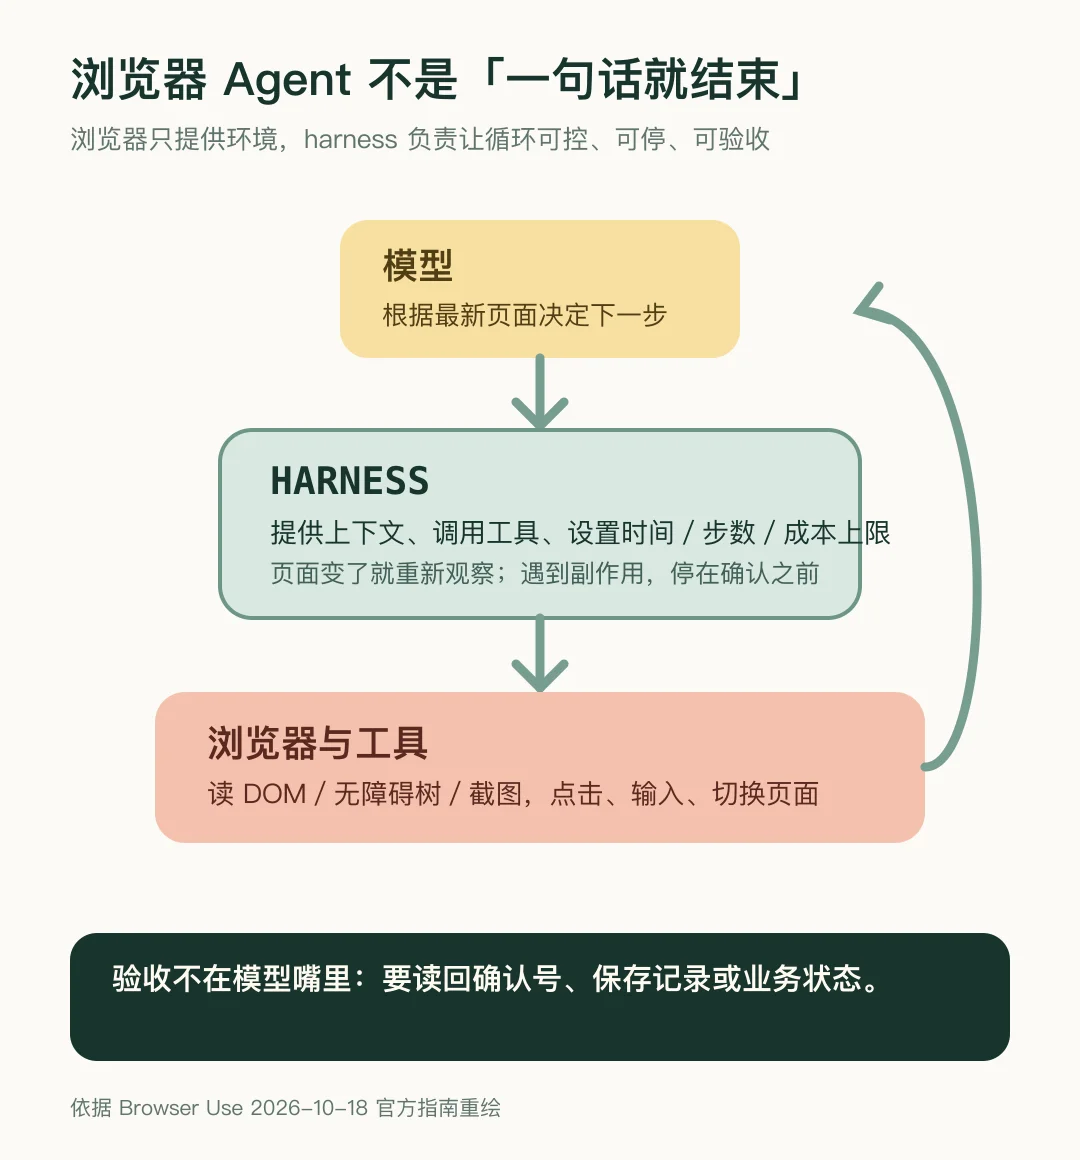
图:根据 Browser Use 官方说明重绘。一次执行不是「发一句提示词」,而是观察、决策、操作与验收的循环。
这里有个很小、但会直接影响复盘的区别。
只写「查到结果就结束」,Agent 可能把一个未保存的表单当成完成。把成功条件换成「页面出现确认号,并且在记录页能读回同一个状态」,你的 harness 才有地方落脚。再往前走一步:限制它只访问哪些域名、最多走多少步、花多少钱;登录过期或需要验证码时暂停;涉及提交、付款、删改、发消息等副作用时停在确认前。
模型可能会偶尔选错控件,网页也可能突然弹出覆盖层。每次页面变化后重新取 DOM、无障碍树或截图,听起来像是实现细节,实际是在给下一步判断换一张新地图。尤其是靠截图点坐标时,缩放后的小按钮会更难命中;能用结构化页面信息时,通常不必让模型在像素里猜。
「运行成功」和「业务完成」中间,至少隔着一道验收
浏览器任务的危险不在报错,而在它没报错却干错了。
官方列了几个很现实的例子:Agent 可能选错商品、漏掉必填项,或者表单尚未保存就宣称结束。若上一轮其实已经提交成功,盲目重试还可能产生重复订单、重复申请或重复写入。
所以把验收写在 Prompt 里还不够,最好把它做成系统规则:
- 读数据:返回值要和源页面的关键字段抽样比对。能解析成 JSON,不代表内容正确。
- 写数据:提交后读回记录、确认号或状态;读不到就标记「待人工确认」,不要直接重跑。
- 有资金、身份或对外发送动作:只让 Agent 填到最后一步,提交按钮留给人确认。
- 遇到验证码、登录过期、站点拦截:暂停并上报原因,不要让它反复撞同一扇门。
网页内容本身也应该当作不可信输入。页面、邮件或文档里可能夹着试图改写任务目标的指令;这类问题通常被称为提示注入。模型再强,也不能把外部页面的文字自动升级成系统指令。限制账号权限、限制可访问站点、把敏感动作放到人工批准之后,都是基本护栏。相关防护思路可以看 Anthropic 对提示注入的公开说明。
大家已经用它做什么,不等于你也该照搬
Browser Use 同篇文章公开了一个截至 10 月 18 日的 Cloud 使用快照:登录与验证相关步骤约占 18%,结构化数据提取约 14%,开放问题研究和求职表单各约 6%,报告与文件检索约 5%,预订与购买约 3%,另有约 15% 未分类。
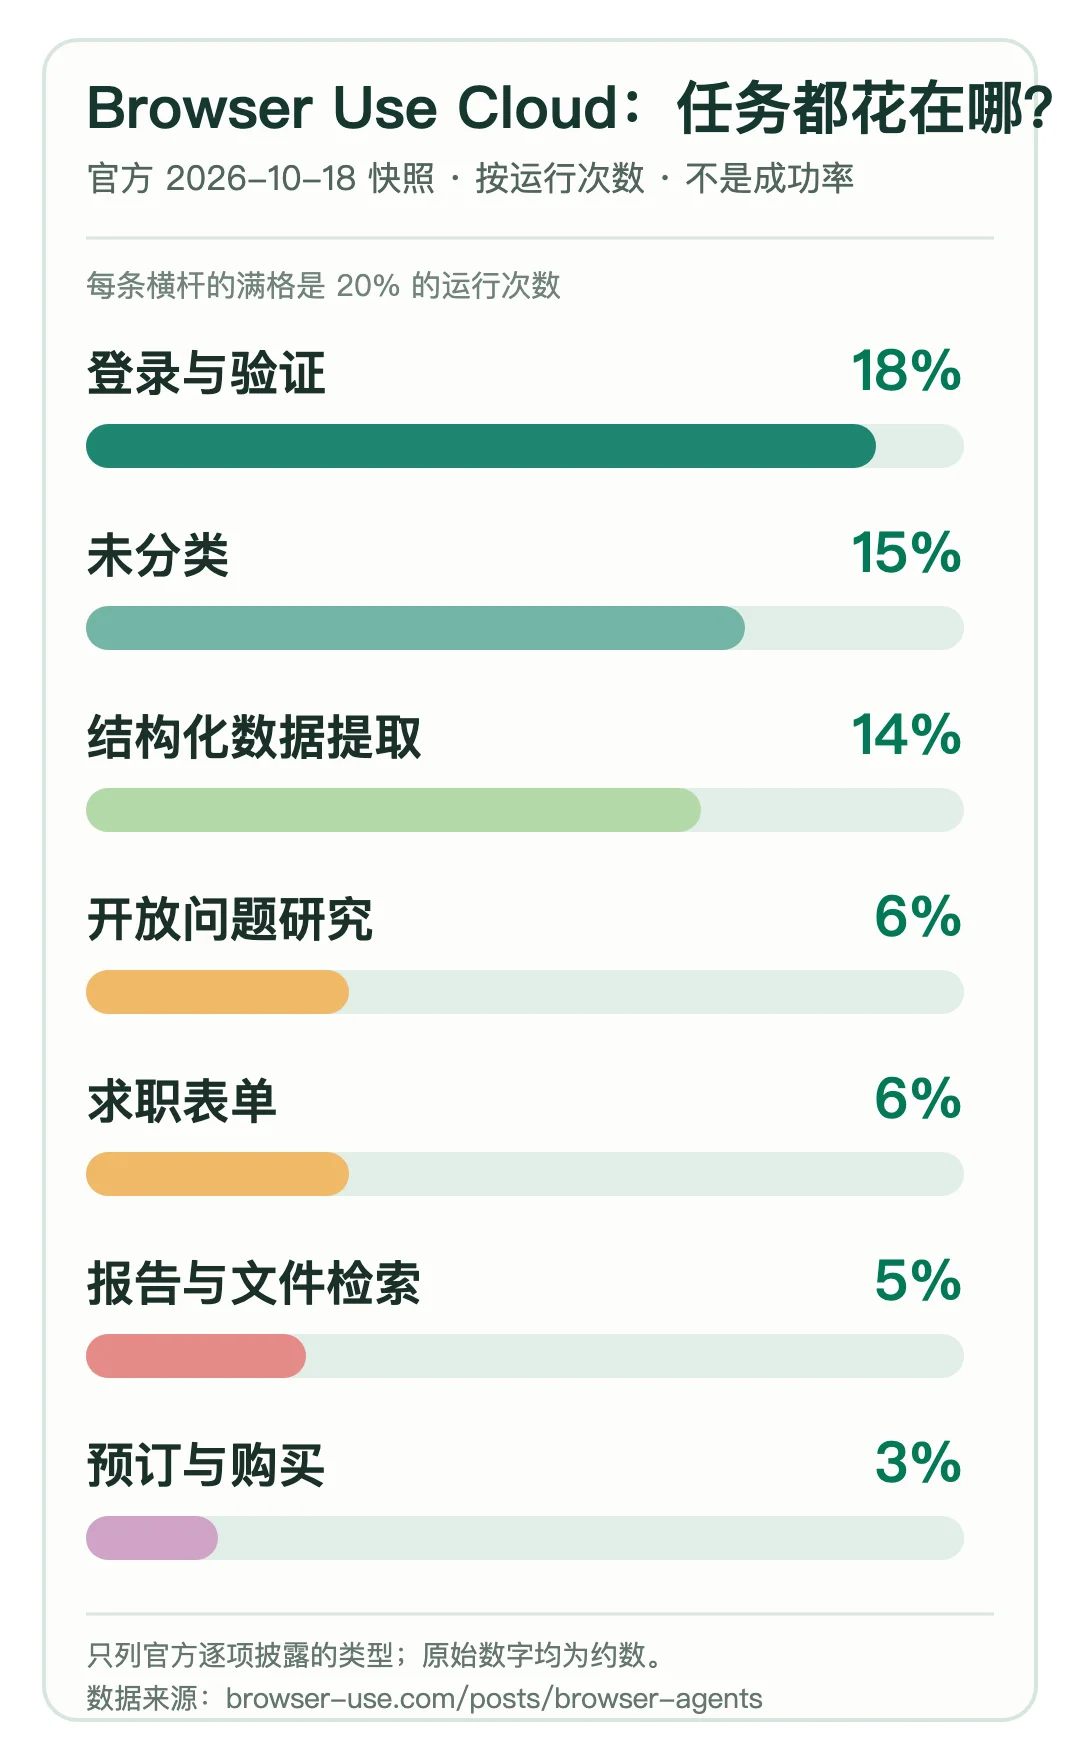
图:根据 Browser Use 官方文中的 Cloud 使用快照重绘。它描述的是运行任务的类型,不是成功率,也不能外推成所有浏览器 Agent 的市场份额。
这组数最有意思的地方,不是「登录」排第一。它提醒我们:浏览器 Agent 经常卡在系统之间的缝里——数据躺在没有 API 的仪表盘,任务跨了好几个站点,或者最后一步必须等一个真人给验证码。
也正因为如此,第一版别从代替人下单开始。先挑一个只读、可回放、结果容易核对的任务:比如从指定页面抽取价格和库存,要求返回固定字段;跑三次,对照源页面;再记下已验证成功数、总耗时、模型与浏览器成本,以及人手修了几次。数据稳定以后,再扩大到更多网站和可写操作。
可以直接抄进需求文档的五问
下次有人说「给这个流程接个浏览器 Agent」,先把下面五问写进方案里:
- 服务有 API 吗? 有,就先调用 API;不要为了「看起来像人」多绕一层页面。
- 步骤能写死吗? 能,优先脚本;把变化留给选择器维护,而不是留给模型猜。
- Agent 的判断到底用在哪一步? 说不清这一点,说明它大概率只是昂贵的脚本替代品。
- 什么才算真的完成? 定义可读回的业务结果,不接受只看到「任务结束」。
- 副作用在哪里停? 写入、发送、购买、删除之前,谁来确认,失败后能不能安全重试?
Browser Agent 的价值不是让所有网页都自动化,而是处理那些路径会变、但业务目标仍然清楚的网页任务。把 API、脚本和 Agent 放在各自该在的位置,模型才不会被迫去做一把昂贵又不稳定的鼠标。
如果你正在接浏览器自动化,最难定义的那个「完成」条件是什么?
小岛AI