
改一行 device 就迁生产?TorchNeuron 还卡着 3 道门
AWS 把 Trainium 接进原生 PyTorch,XLA 改造少了;算子、性能与分布式验证,仍得由团队自己跑完。
一套在 GPU 上跑稳的 PyTorch 训练任务,要不要迁到 Trainium?以前最容易把人劝退的,往往不是芯片参数,而是那套额外的 XLA 路径:设备语义、编译、分布式、调试和现有训练脚本,多少都得重新认识一遍。
今天 PyTorch 与 AWS 公布 TorchNeuron。演示里,模型从 .to("cuda") 换到 .to("neuron"),原来熟悉的 torch.nn、torch.optim、torch.distributed 与 torch.profiler 都还在。对维护训练平台的人,这当然是个好消息:评估新硬件时,终于不必先把整套工作流翻修一遍。
但这件事最容易被标题带偏。代码改得少,只说明迁移入口变窄了,不说明生产风险自动消失。 TorchNeuron 的公共 Beta 要到 10 月 20 日开放,目标设备是 Trainium2 与 Trainium3。它很适合拿一条代表性任务做试迁;把它直接当成“GPU 脚本原封不动搬家”的通行证,就有点太着急了。
这篇不聊芯片跑分。只把真正影响迁移决定的三道门摆出来:算子和语义过不过、性能是否真的划算、分布式生产链条能不能扛住。读完你应该能决定一件事:下周要不要为这条训练任务开一个小型验证分支。
先把“原生 PyTorch”翻译成人话
TorchNeuron 接在 PyTorch 的官方硬件扩展点上。你仍然写 PyTorch 模型,PyTorch 的 dispatcher 再把 neuron 设备上的算子送去 Neuron 后端;稳定的子图可以交给 torch.compile,底层再由 Neuron 编译器生成设备可执行文件。官方给出的架构很直白:上面还是模型和 PyTorch API,中间才是 TorchNeuron,下面才是运行时和 Trainium。
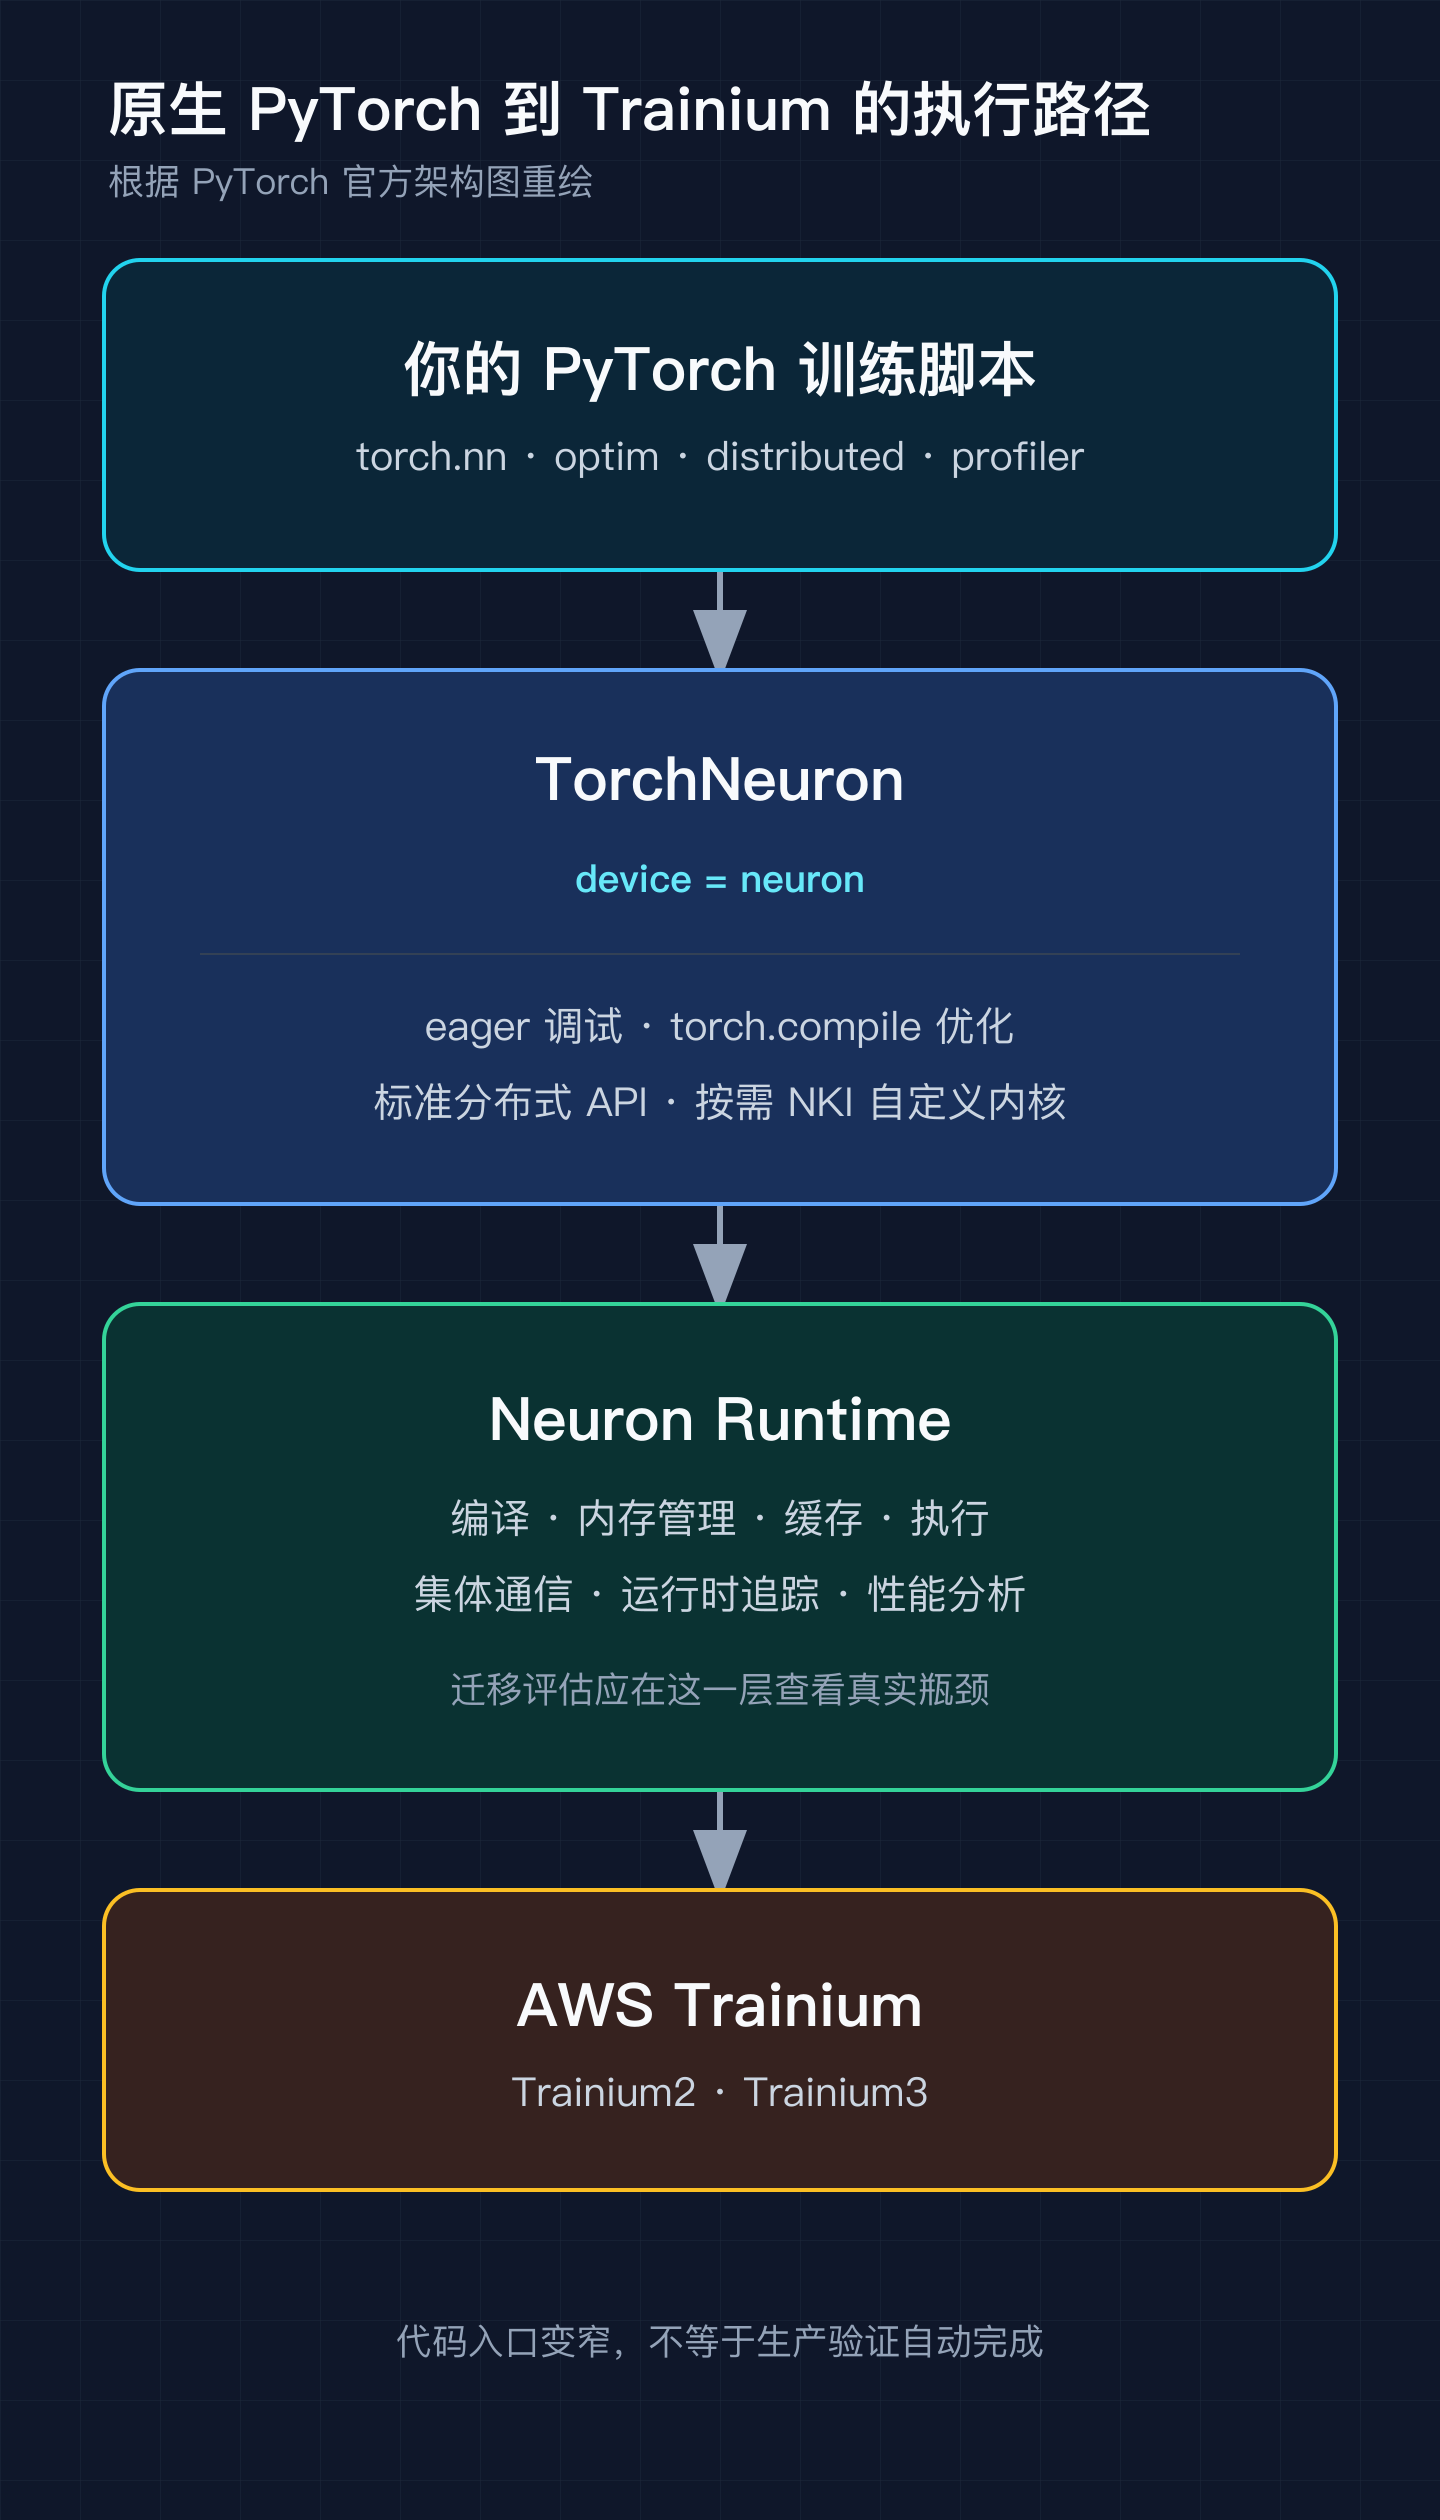
图注:按 PyTorch 官方架构图重绘。模型代码仍面向 PyTorch;TorchNeuron 负责把设备、编译与运行时接到 Trainium。
对日常开发,最实际的变化是可以分两种方式工作。
- eager 模式适合先把事情跑通。Python 控制流、打印和断点还在,定位一个数值不对的 batch 不需要先猜图编译阶段发生了什么。
- **
torch.compile**适合模型结构稳定之后再追性能。官方说明它会抓取前向与反向图,交给 Neuron 后端和编译器优化;你也可以只编译稳定的一段,而不是把整个训练脚本一次性押上去。
官方示例里的核心代码确实很短:
torch.compiler.set_default_backend("neuron")
model = MyModel().to("neuron")
model = torch.compile(model)这段代码的价值,不是“少敲几行字”,而是把迁移顺序改对了:先在相同的 PyTorch 语义里验证,再决定哪些路径值得专门优化。 以前迁硬件常常从改框架开始;现在可以从一条真实任务开始。
第一门:你的模型不是“能加载”就算兼容
官方做了很大范围的覆盖测试:持续扫约 10 万个 Hugging Face 模型,覆盖其按下载量统计的 99.9% 实际使用量;也跑了 ATen、Dynamo、分布式和 profiler 的上游测试。这个投入很有分量,但它仍然不是你们工作负载的验收报告。
公开的 2026 年 8 月测试口径里,约 15.4 万条结果中有约 6.9 万条因有效理由跳过。其中约 3 万条是 PyTorch 自己的资格条件跳过,例如 CUDA-only 或 CPU-only 的测试;余下约 3.9 万条是 Neuron 主动跳过,而其中约 2.2 万条与尚无原生 Neuron lowering 的算子有关。
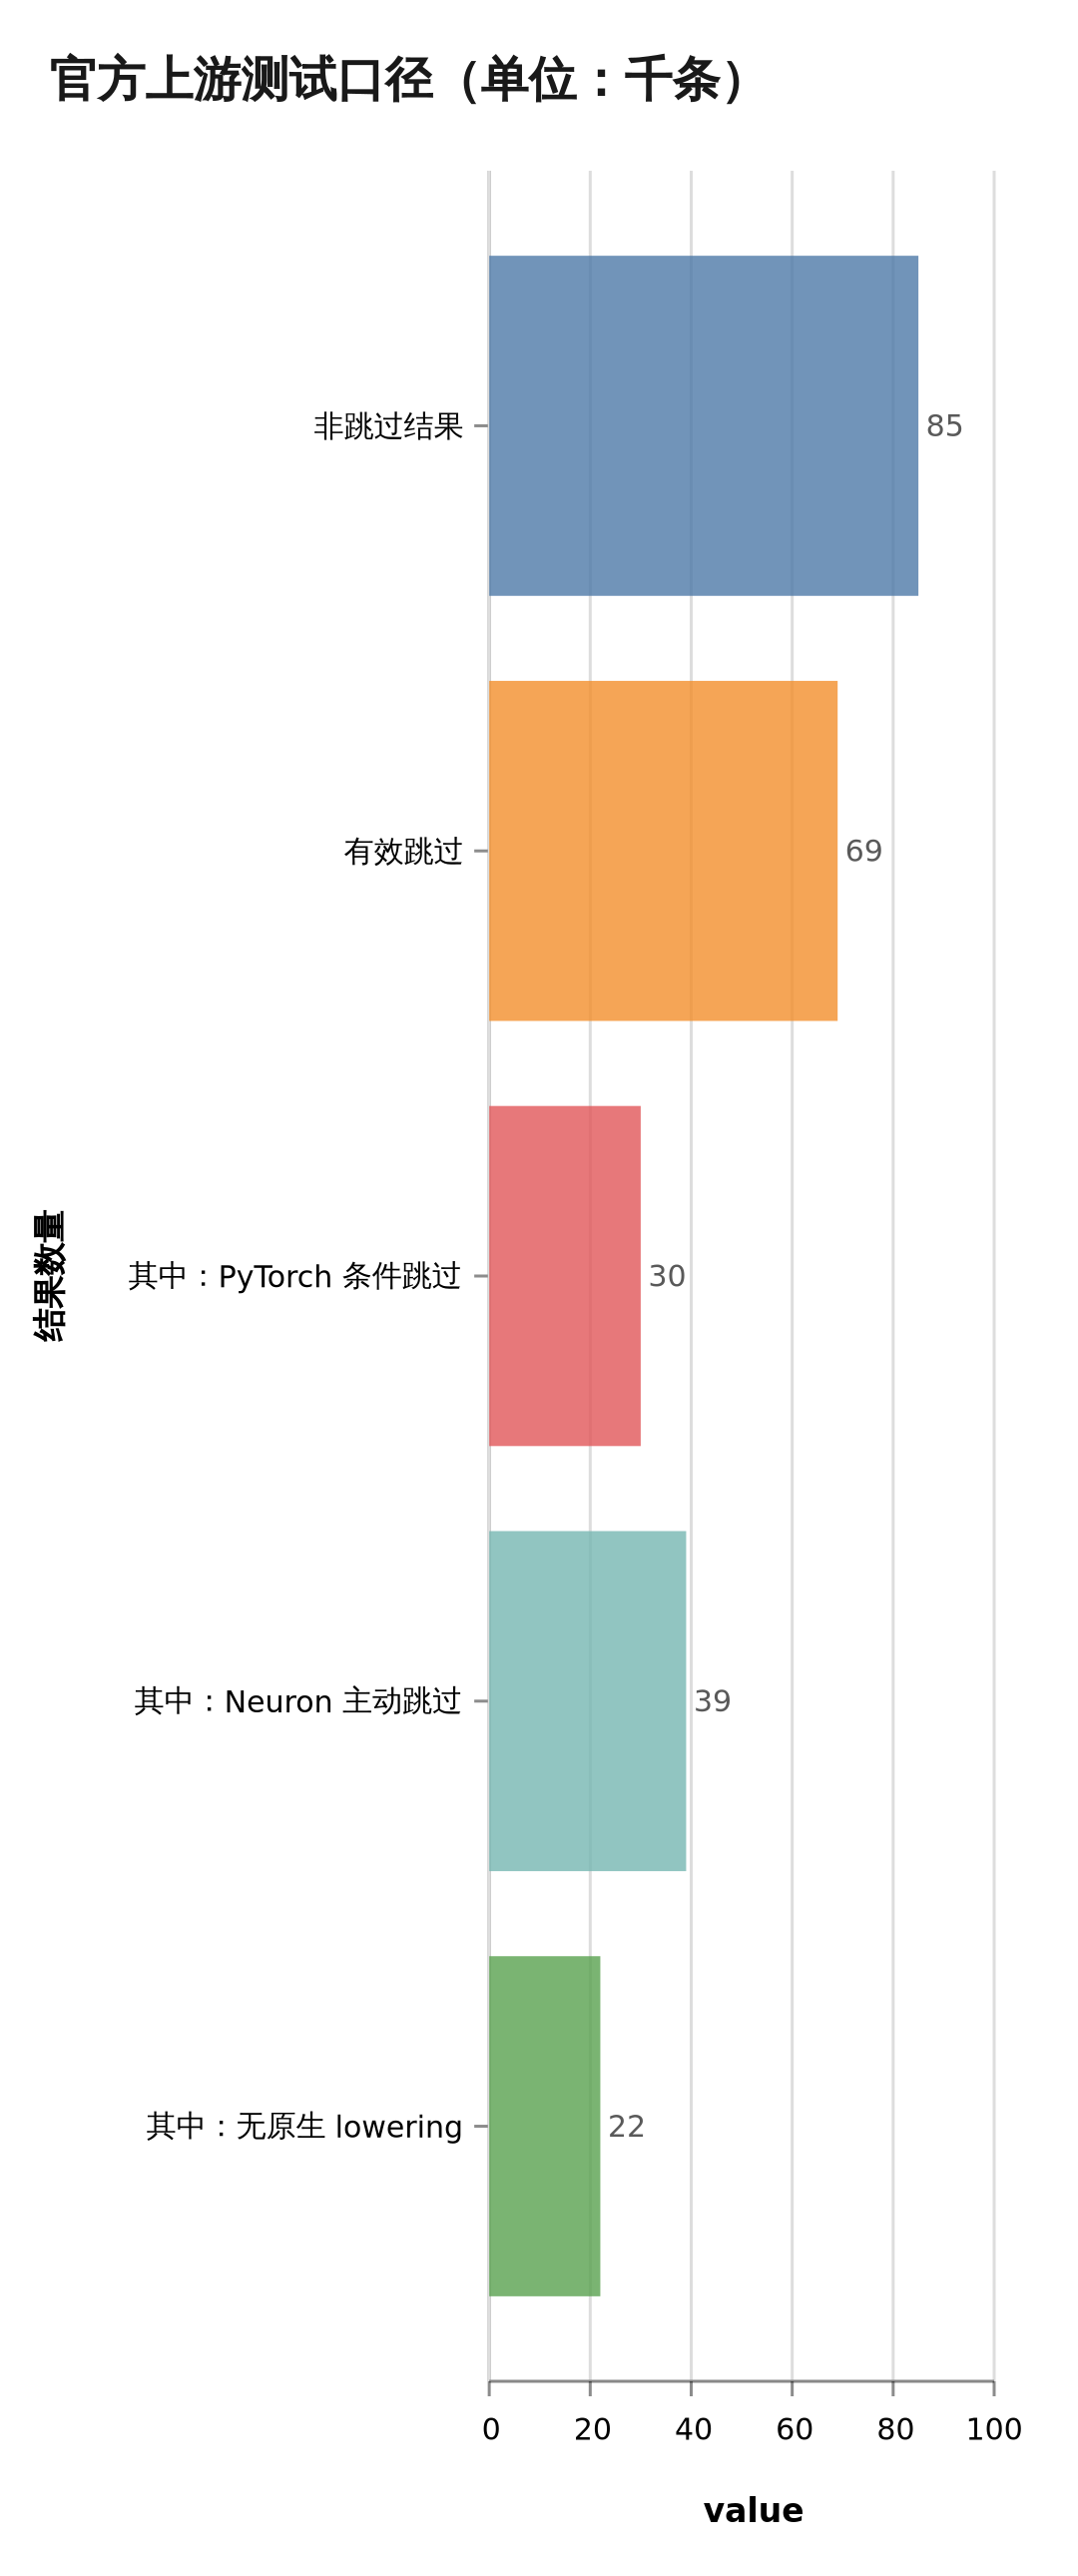
图注:按 PyTorch 官方文章的 2026 年 8 月测试口径重绘。39k 是 69k 有效跳过中的子集,22k 又是其中“无原生 lowering”的子集;它们不是互相独立的兼容率。
这里最该避免的,是把图读成一个漂亮的百分比。“非跳过”不等于你的模型已通过,“跳过”也不等于训练一定失败。 它只提醒了一件很具体的事:通用 API 能接住,不代表每个边缘算子、每个 shape 路径和每种精度组合都已经被后端实现。
官方也明确列出首版暂不支持或有限制的方向:稀疏张量及其算子、NestedTensor、前向模式自动微分、任意注意力掩码、逐通道量化,以及动态和符号形状等。你的训练脚本如果靠动态 padding、变长 batch、稀疏特征,或者在研究阶段频繁改模型分支,就别只跑一遍 forward 就下结论。
我会给这一步留一套很朴素的门槛:拿一小份固定数据和固定随机种子,在 GPU 与 Trainium 上分别跑若干 step;对齐 loss 曲线、关键 tensor 的容差、梯度是否出现 NaN/Inf,以及保存再加载 checkpoint 后的继续训练结果。没有这份 golden batch,后面的压测数字再好看,也很难解释“快”到底是在算同一件事,还是在悄悄换了一件事。
第二门:把“编译成功”与“单位工作成本下降”拆开看
TorchNeuron 提供 eager、Adaptive Eager 和 torch.compile。三者不是谁更高级,而是面对不同阶段的工具:eager 方便定位;Adaptive Eager 试图在保留交互感的同时减少小算子的启动成本;torch.compile 则面对稳定图做更深的优化。团队一上来就只测编译态,往往会把算子缺口、动态 shape 触发的重编译,和单纯的 batch 设置问题混在一起。
官方给了一个很吸引人的客户数字:Deepgram 表示,在其评测中,Trainium 每美元可处理的输入音频秒数约比既有 GPU 基线多 60%。这个数字可以当作“值得测”的理由,不能拿来替你做预算。它绑定了音频模型、输入分布、实例规格、网络位置和该团队自己的优化程度;换一个模型,结论可能完全变样。
真正该比较的是一份你们自己的记录,而不是供应商的单点故事。每次试跑都把判断条件与容易误读的指标写在一起:
- 正确性:固定数据切片、随机种子、精度和 checkpoint;别只比一次 loss 数字。
- 吞吐:固定全局 batch、序列长度和 warm-up 后的统计窗口;别用首次编译完成前的速度做结论。
- 延迟:固定请求形状和并发,记录 P50/P95;平均值常常盖住尾部问题。
- 成本:把实例、存储、数据传输、值班和调优时间一起记;机器小时价只是其中一项。
- 可观测性:保留 profiler trace、编译日志和失败样本;“任务没有报错”不构成解释。
官方把 Neuron 的硬件事件接进 torch.profiler,并能在 Neuron Explorer 里追到框架、运行时、硬件之间的时间线。这点很重要,因为迁移后的慢并不总在模型本身:可能是数据没有喂满,可能是 collective 在等,也可能是某段图退回到不理想的路径。没有 trace 的成本评估,最后通常会变成“感觉这台机器不太快”。
实践上可以先挑一段结构稳定、占总时长又足够高的子图启用 torch.compile。把第一次编译的时间单独记账,随后再看热身后的吞吐和尾延迟。若一整天只会跑一次的离线任务,编译成本和迭代摩擦的权重就更高;若是长时间训练或持续推理,稳定态的吞吐才值得占主导。
第三门:单卡跑通后,才轮到生产链条
迁移最容易在“单机小样本没问题”处产生错觉。真正进生产,还要经过数据加载、分布式通信、checkpoint、失败恢复、版本回滚和监控告警。TorchNeuron 的公告里列出 DDP、FSDP2、DTensor、张量并行、流水线并行以及常见的组合方式,并说明跨节点通信走 EFA;这降低了你继续使用标准 PyTorch 分布式抽象的门槛,但并不会替你证明当前拓扑、数据分片和恢复流程没有漏洞。
一个很实用的顺序是:先在单节点把 golden batch 跑稳;再加一个最小分布式规模,确认 sampler、梯度同步和 checkpoint 恢复;最后才碰目标规模。每往前一层,都保留同一份输入、同一套指标和一条清晰的回退路径。这样一旦 loss 漂了、吞吐掉了,排查范围不会从“整个集群”开始。
对已经使用 XLA 路径的团队,别把这理解成今晚就要重写。官方文档把原生 PyTorch 作为后续方向,也列出了旧路径的迁移边界。更稳妥的做法是把现有任务按三类分开:
- 新项目或刚开始做大规模训练的模型:优先试。代码资产还没被旧后端绑紧,验证成本相对低。
- 结构稳定、但 GPU 成本已经成为明确问题的成熟任务:值得立项试迁。先用真实输入跑完三道门,再算成本账。
- 依赖动态/符号 shape、稀疏算子或特殊注意力掩码的任务:先等支持边界更清楚,或者只迁其中稳定的子模块;别为了硬件切换,把研究节奏拖慢。
给一个 72 小时试迁窗口,不要给一次豪赌
如果团队要试,我会把目标压得很小:不是“迁完模型”,而是“拿到一份可讨论的迁移证据”。
第 1 天:选一条代表性任务。 固定 commit、数据切片、环境版本和验收阈值。跑 eager 路径,记录正确性差异和任何不支持的算子。此时的产出不是性能 PPT,而是一张失败清单。
第 2 天:只优化稳定路径。 对已经验证的子图开启 torch.compile,在热身后测吞吐、显存/设备内存、尾延迟和编译时间。用 profiler 确认瓶颈确实在模型或设备侧,而不是卡在数据和通信。
第 3 天:验证最小生产形态。 加上真正会使用的分布式配置、checkpoint 恢复和一次故障回退。若指标、稳定性和成本三项里有两项没有明确收益,就把结论写成“暂缓”,这同样是一次成功的评估。
TorchNeuron 把一件长期很重的活变轻了一截:从 GPU 到 Trainium,不再天然等于重写一门方言。可生产迁移从来不是把 .to("cuda") 换成 .to("neuron") 的语法题。它要的是一份自己的兼容清单、一条可解释的性能曲线,以及一次真的能恢复的分布式演练。
你们的训练栈里,哪一处最可能卡在这三道门之外:算子、数据、通信,还是 checkpoint?
小岛AI|记录一线实战、踩坑与成长