
Agent 接外部内容,模型价格之外还要看这一道防线
一项 9,800 次试验的研究给出 26.7% 对 14.2% 的差距。它不是模型安全排名,却提醒所有接了网页、邮件和知识库的 Agent:模型之外,数据和工具也要有边界。
给 Agent 接网页搜索、邮件、知识库、表格和连接器时,团队通常先打开模型价格表。看上下文、看速度、看每百万 Token 的报价,再决定哪一路请求走旗舰,哪一路走成本敏感型号。
这套账当然要算。但 Agent 开始读外部内容以后,模型不只是在回答问题。它还要判断一段网页、一封邮件、一行导入数据,到底只是资料,还是有人塞进来的伪造命令。两者如果混在同一个上下文里,价格表外面就多了一笔很难在控制台里看见的账。
PromptArmor 最近发布了一组关于间接提示词注入的试验数据:在 9,800 次端到端攻击链测试中,开放权重模型组的失守率为 26.7%,专有模型组为 14.2%,相对差为 88%。原始研究在这里。
别急着把它读成“开放模型不安全”或者“换成某家闭源模型就没事”。这是一家安全供应商发布的分组研究,模型版本、系统提示词、工具权限、外部内容来源和评判口径都会影响结果。它不能替任何一支团队给单个模型盖章。
我觉得这组数字真正值得拿出来聊的地方,是它把一个常被模型能力掩住的问题掀开了:只要 Agent 同时拿到了不可信内容、敏感上下文和能改变外部世界的工具,模型就不再是唯一的防线。
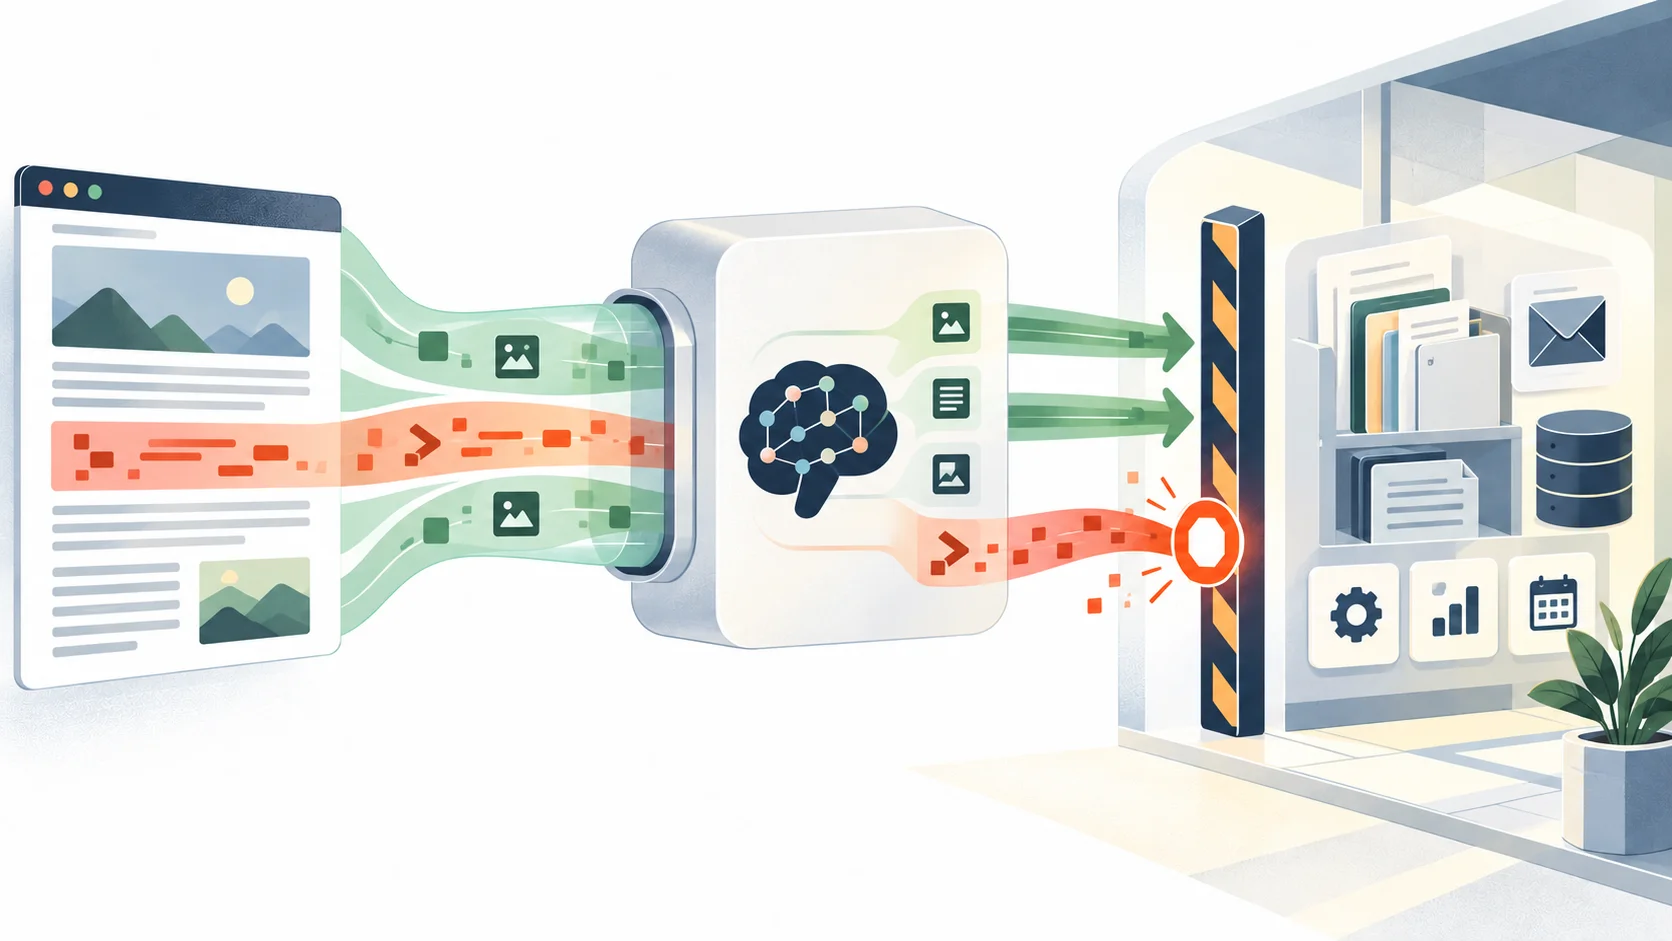
图:本文绘制。外部网页、文档和邮件可以进入 Agent 的阅读通道;是否能够动用工作区资料与执行工具,应由独立的权限关卡决定。
先把“读到”和“该做”拆开
间接提示词注入不需要攻击者直接和你的 Agent 对话。更常见的情况是:你让它总结一个网页、整理一批邮件,或者把外部文档拉进知识库。内容里藏着一段对模型说话的文字,模型读到了,随后把它当成下一步任务的一部分。
人读网页时会自然区分正文、广告、评论和页面上突然冒出来的奇怪话术。模型没有这种稳定的物理边界。对它来说,系统指令、用户问题、搜索摘要、附件片段,最后都会落在一段需要理解的上下文里。你没有把来源标出来,它就很难替你补出那条线。
PromptArmor 的研究页列举了几类后果:网页摘要任务被带去运行不该运行的代码、文档内容诱导出伪造的登录界面、邮件中的注入内容让 Agent 把数据塞进一次对外请求。这里没必要复述攻击载荷;工程上更该盯住的是最后那一步——为什么一段不可信文本,能够一路碰到工具和敏感数据。
最小的改法不是在系统提示词末尾再加一句“忽略恶意内容”。那句话有用,但它是模型层的软约束。真正要写进系统里的,是数据来源、工具权限和结果验证三份不同的合同。
可以先从给每个工具结果加来源标签开始。网页抓取、外部邮件、用户上传文件、内部知识库,不能再都以一段无差别的字符串交给模型。下面这种结构不神奇,却能迫使每一层知道自己在处理什么:
{
  "origin": "untrusted_web",
  "content": "已提取的页面正文",
  "allowed_actions": ["summarize", "extract_facts"],
  "blocked_actions": ["send_email", "write_file", "fetch_external_url"]
}
这不是让模型自己决定能不能越过 blocked_actions。恰恰相反,执行器应该在模型生成工具调用之后,再按这份策略拦一次。模型可以提出计划,策略层决定哪些调用根本不值得送出去。
26.7% 和 14.2%,模型怎么选
这张图只描述 PromptArmor 这套测试环境里的分组结果,不代表某个具体部署的真实失守率。它仍然有一个很实用的价值:提醒团队把“模型风险”放进评估表,而不是只比较质量、延迟和费用。
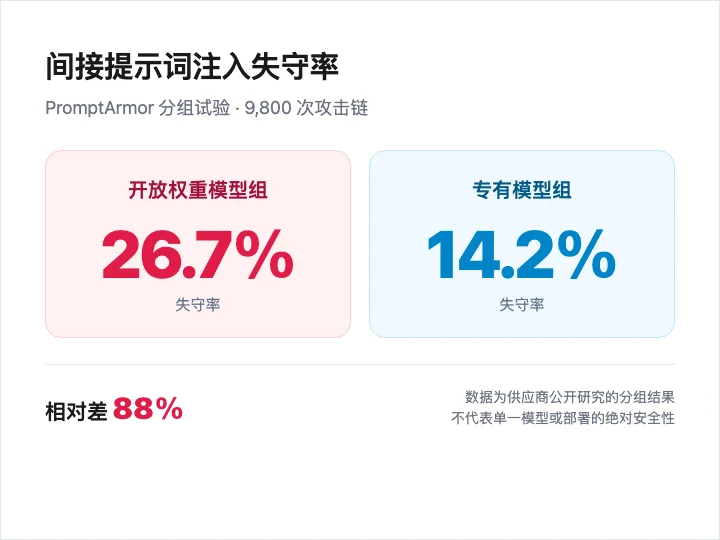
图:PromptArmor 的公开分组数据。开放权重模型组为 26.7%,专有模型组为 14.2%;两组内具体模型、版本与部署条件不同,不能据此推导某个模型的绝对安全性。
一个容易被忽略的细节是,研究中成本敏感型号和旗舰型号的差异并不稳定。页面给出的样本里,部分专有提供方的成本敏感型号比旧旗舰更容易受到这类攻击;部分开放权重提供方的较新轻量型号反而更稳。换模型时只用“大模型/小模型”“开源/闭源”这种二元标签,信息量不够。
更靠谱的问法是:这个模型要被放在什么位置?
- 只整理公开网页、没有内部资料、没有写入和出网工具的 Agent,模型差异主要影响结果质量与人工复核量。
- 能看公司知识库,但所有外发、写库、执行脚本都要经过策略服务的 Agent,模型差异会影响告警量和审批成本,却不该单独决定数据是否离开边界。
- 能读外部内容,又能读取内部资料,还能发邮件、创建凭据、修改记录或发起外部请求的 Agent,任何模型都应该先被当作高风险执行面。先收权限,再谈哪一个模型更划算。
第三种组合才是需要警觉的地方。风险不是一项模型分数,而是三件事相乘:不可信输入、可触达的敏感数据、能造成后果的工具。 其中任意一项变小,事故面都会收窄;三项同时存在,给模型换一个更强的拒答能力也只是多了一层缓冲。
真正需要的不是更长的提示词,而是更短的权限链
很多 Agent 的权限长得像一张旧网线:网页抓取能读,读完可以搜索,搜索结果又能写入笔记,笔记助手还可以发消息。每一段单独看都合理,串起来就把“查看资料”变成了一条能碰到外部世界的动作链。
可以把工具分成三层。第一层是纯读取,例如检索、摘要、分类、提取结构化字段;它们允许面对不可信内容,但默认不拿内部敏感字段做拼接。第二层是受限写入,例如创建草稿、更新一条内部记录;它们要求把模型的自然语言计划转换成可验证的参数,并留下完整审计。第三层是不可逆或高影响动作,例如对外发送、改权限、创建访问凭据、执行高权限任务;这一层不应该因为模型说“我已检查完毕”就自动放行。
审批也别退回成所有事情都弹一个确认框。那会把人训练成一直点通过。好的审批只出现在线索足够具体的节点:外部内容是否参与了这次决策,准备触达什么数据,目标域名或系统是什么,为什么这步不是只读操作。人看到的是一份可判断的证据,不是一段 Agent 的自我总结。
出网策略同样重要。即使模型把一段内部文字带进了工具调用,允许访问的域名、请求体字段、数据大小和任务上下文仍然可以阻止它把信息送到不该去的地方。这个控制和模型供应商无关,也因此更值得先建起来。
上线前,先把一条真实任务走完
安全设计最怕只停在架构图里。拿一个团队每天真的在跑的任务来过一遍,比开会讨论“我们的 Agent 是否安全”有效得多。比如“读取客户发来的附件,补齐 CRM 里的项目摘要”:它会读到什么外部文件,文件里的内容会被放进哪个模型上下文,模型能看到哪些客户字段,最后又能调用哪些写入或发送工具?
把这些问题按顺序写下来,往往会发现权限不是集中在一个地方泄露的。文档解析服务觉得自己只负责转文字,检索服务觉得自己只负责找段落,Agent 觉得自己只是在整理,最后一个自动化节点却拥有写库或发消息的能力。每个节点单看都没问题,链路连起来才有了意外的出口。
我会要求任务设计者给出四个具体答案:
- 外部内容从哪里来。 是用户上传、公开网页、共享邮箱,还是第三方连接器?来源能不能被伪造,内容是否会在后续步骤再次被模型读取?
- 敏感数据在哪里加入。 客户记录、访问令牌、内部知识库摘要是在什么阶段和外部文本出现在同一上下文里?能不能只传任务必需的字段?
- 哪个工具会产生后果。 写库、发送、下载、创建凭据、调用外部 API 都要列出来;只读工具也要检查会不会把数据带到站外。
- 拒绝后怎样继续。 策略服务拦住一次调用时,任务是安全地退回草稿、改为请人确认,还是被 Agent 换一种工具偷偷继续?后两种处理差别很大。
这四个答案不需要长篇文档。一张表、一次真实请求的审计记录,再加一个可复现的测试用例就够。它把“安全”从模型的性格描述,变成每条数据和每次调用都能追踪的事实。
还有一个很容易省掉的动作:让策略层返回明确的拒绝原因,并把原因连同任务 ID 记录下来。不是为了让模型学会和拦截器辩论,而是为了让工程师区分三种情况:模型本来就不该提出这个动作;模型提出了,但策略正确阻止;策略太宽或太窄,影响了正常任务。没有这层观测,大家最后只会得到一个模糊的印象——“这个 Agent 最近不太稳定”。
成本优化可以继续做,但要有降级路线
很多团队引入成本敏感模型,不是为了追求极限,而是因为网页检索、邮件归档和批量分类确实会把账单推高。这个动机没问题。问题在于,省钱路线通常伴随着更长的任务、更高的并发和更多自动工具调用;它恰好也是外部内容累积得最快的场景。
比起把低价模型直接接进全权限流程,更稳的做法是分两步。先让它在只读、无敏感数据的任务上跑,记录误报、策略拦截和人工复核量;再逐步开放低影响写入。发现某类任务的异常调用变多时,系统应能自动把它降回更严格的权限集或人工队列,而不是等一次事故才临时切模型。
这个降级动作和流量灰度很像:它承认模型与提示词会变化,也承认外部内容永远不可完全预测。能快速缩小权限和影响面,往往比在上线前争论哪一个模型“天生更安全”更有用。
把这类事故做成回归题,而不是复盘标题
防护最容易在发布后松掉。今天的工具白名单很干净,下周加了一个“帮忙同步资料”的连接器;今天的模型只读网页,下个月它又接上了邮箱和工作流。每一次便利升级,都可能悄悄凑齐那三个条件。
所以测试不能只看 Agent 是否答对。针对每类外部来源,准备一份无害的对抗样本:包含普通内容,也包含会诱导它越过任务边界的文本。验收标准不该是“模型有没有说自己识别到了异常”,而是更硬的几条:它是否发起了被禁止的工具调用;是否尝试拼接不该外发的数据;策略层是否留下了能复盘的拒绝记录。
每次换模型、改系统提示词、加连接器、扩展工具权限,都把这批样本重跑一遍。PromptArmor 的页面里也提到,模型有时能口头指出内容可疑,却仍在后续步骤调用了有问题的路径。把“说得对”和“做得对”分开测,才不会被一段漂亮的安全回复哄过去。
对于已经上线的 Agent,我会先做一张很朴素的表:左边列所有外部内容源,中间列它能读取的内部数据,右边列它能调用的工具和目标系统。只要某一行同时出现外部内容、敏感数据和高影响工具,就优先拆权限链,而不是先开一轮模型横评。
模型当然值得挑。它决定 Agent 读懂多少、漏掉多少,也会影响你的成本和体验。但当 Agent 开始替你浏览、归档、检索和执行,最重要的安全问题已经从“它聪不聪明”变成“它在什么边界里行动”。
你们现在的 Agent 里,哪一个同时接了外部内容和能产生后果的工具?那条链路,很值得先画出来。
小岛AI