
Agent 要接网页搜索,DeepSeek 的 Search/Fetch 值不值得换?
DeepSeek 把搜索和网页抓取拆成了原生接口。对做 Agent 的团队,重点不是立刻换供应商,而是先用来源、失败、限速和成本四项验收,判断它能否进入生产链路。
给 Agent 接网页访问,最容易出现一种看似能跑、实际上很危险的状态。
它能搜到几个链接,也会给出一段很像答案的总结。可一旦追问“这条规则来自哪一页”“页面是什么时候更新的”“链接失效时该怎么办”,链路就突然只剩模型的一段话。拿去做研究助手、产品问答或内部情报,这样的答案很难交接。
DeepSeek 在 10 月 17 日开放了Search 与 Fetch API。前者按查询返回结构化网页结果,后者把一个网页抓成 Markdown。它们可以让 Agent 自己完成“找页面—读页面”的两步,但新接口上线,不等于现有检索层就该立刻下线。
真正要回答的问题是:它能不能成为你生产链路里一个可观测、可回退的网页提供方?
官方品牌主视觉,来源:DeepSeek API 文档。
搜到内容,不等于拿到了可交付的来源
Search 返回的不只是标题和链接。官方文档列出了url、date、authority、snippet、summary等字段;需要时还可以通过need_content请求正文。它给 Agent 的是一组候选材料,不是一份已经审过的结论。
这一区别很要紧。很多 Agent 把搜索结果拼进上下文后,马上让模型写答案,最后只留下几句自然语言。下一轮用户追问来源,系统又从头搜一次;页面变了、排序变了,答案的依据也跟着漂了。
接入时,建议把每次检索的最小记录固定下来:查询词、命中的 URL、页面日期、authority、采用或拒绝的理由,以及最后回答实际引用了哪几页。authority大于等于 3 是官方给出的“极权威”标识,但它只是搜索侧信号,不能替代你自己的来源策略。
need_content也该被当成一个明确选择,而不是默认总开关。列表页、商品页和聚合页即使有正文,未必适合整段送进上下文;先拿轻量结果做筛选,再 Fetch 少量候选页,通常比一次把所有内容塞给模型更容易控制上下文和成本。
例如,法规、价格和产品规格可以要求至少有一个官方页面;新闻类问题可以允许一手报道加交叉来源;没有日期或没有可追溯 URL 的结果,最多当线索,别直接作为结论。这部分规则不属于模型提示词的装饰,它决定出错时团队能否回放。
Fetch 省掉了抓页面的麻烦,但没替你消灭失败
Fetch 的输入很简单:给一个 HTTP 或 HTTPS URL,接口返回标题和 Markdown 正文。对 RAG 和研究型 Agent 来说,这一步很舒服,至少不用先把网页塞给浏览器再自己抽正文。
不过,官方错误表也把边界写得很直白。目标站点的访问策略可能让请求返回 403;页面不可用、无法提取 Markdown 或内容类型不支持时会是 404;超时、限速和下游故障也分别有 408、429、504。把 Fetch 当成“只要给 URL 就一定能读”的工具,迟早会在生产里撞墙。
所以接口层应该写清降级路径,而不是让模型猜:
Search 拿到候选 URL
  → Fetch 成功:保存正文摘要和来源元数据
  → Fetch 404/403:保留 URL,回退到摘要或换候选页
  → Fetch 429/5xx:进入退避队列,不把失败伪装成“没有资料”
这里最容易被省略的是最后一行。没有资料、抓取失败、搜索无结果,是三种不同的运行状态。用户看到的回答可以简短,内部日志不能混成一个“空”。
先算并发,再谈单次价格
Search 和 Fetch 都按成功请求计费:官方当前标价是每 1000 次成功请求 5 元。Search 没有结果、Fetch 拿不到正文、请求失败或超时,都不计费;count只影响返回多少结果,不改变这次成功请求的单价。
这对预算当然友好,但也很容易让人只盯住“每千次 5 元”。多 Agent 链路里的真实单位不是一次用户提问,而是一条任务里触发了几轮搜索、挑了几个 URL、又抓了几页正文。成本账本至少该分别记search_success、fetch_success、fetch_404和fetch_429,否则月底只能看到一笔总数,找不到是哪类任务把请求放大了。
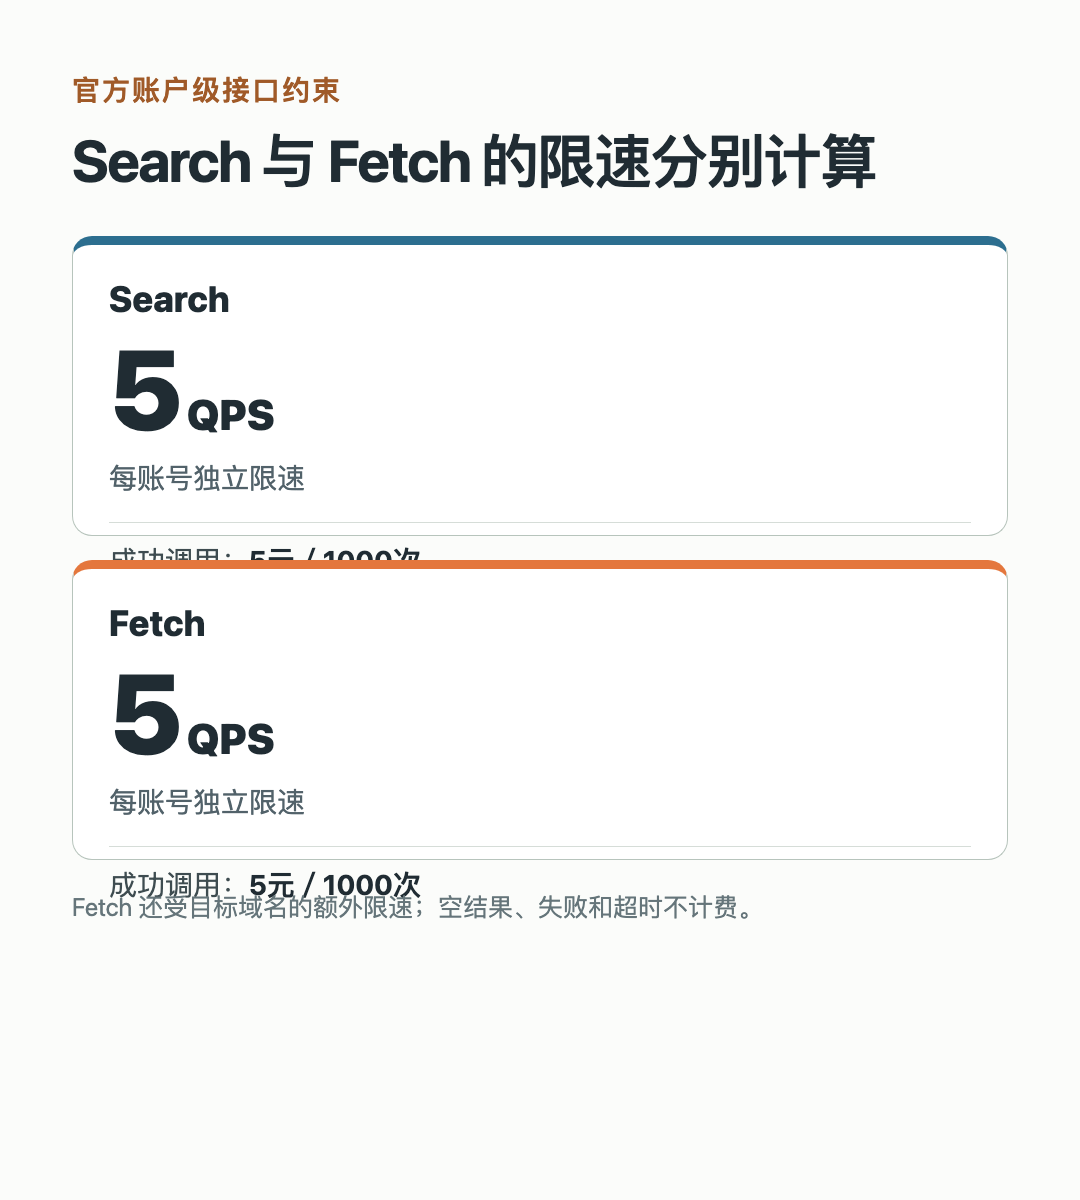
数据来源:DeepSeek 官方文档。Search 与 Fetch 各自为每账号 5 QPS;Fetch 还会受到目标域名的额外限速。
图里的两个“5”也不是可以放心忽略的数字。单个对话里没什么感觉,可一旦研究、客服、监控 Agent 同时工作,Search 和 Fetch 会分别碰到账号级阈值;Fetch 还可能碰到某个目标域名自己的阈值。共享队列、按域名限速、429 后的退避和上限告警,最好在接入当天就加上。
还有一个很实际的细节:官方把“成功请求”定义得很具体。Search 必须真正返回结果,Fetch 必须真正返回网页正文,才会产生计费。监控里因此不能只放请求总量;把空结果、抽取失败与超时分开,才能同时看清可靠性和花费。
不要把“接口通了”当作迁移完成
如果你已经在用别的搜索或抓取服务,我会把 DeepSeek 放进影子流量,而不是先改生产配置。挑一批真实任务:时效新闻、指定站点检索、长网页正文、被访问策略拦住的页面。每次同时跑旧链路和新链路,但先不让新结果影响用户答案。
验收时看四件事就够了:
- 返回结果有没有稳定的 URL、日期和可展示来源;
- Fetch 失败时,系统能否说明失败类型并走回退,而不是静默编一段;
- 多任务并发下,429 比例和等待时间是否在你能接受的范围;
- 每个真实任务的 Search/Fetch 成功次数,能否对应到成本和最终回答里的引用。
前两项过不了,模型回答再流畅也没有意义。第三项过不了,产品一热就会把好好的检索服务推到限速边缘。第四项过不了,团队无法知道“便宜”究竟是每次任务更省,还是只把失败和重试藏进了总账。
反过来,如果你的现有服务依赖图片、视频、特定垂直库、海外地域覆盖,或者已经有一套成熟的抓取成功率与来源合规能力,也不用为了原生接口三个字强行迁移。新接口可以先成为一个备选提供方,和现有链路一起接受同一套任务集。
现在可以接,但先别急着替换
DeepSeek 把网页搜索与抓取开放成独立 API,真正有价值的不是少写几段胶水代码,而是 Agent 终于能围绕结构化检索结果和 Markdown 正文建立一条可管理的网页链路。
我的判断是:可以接入,先跑影子流量;不要只因为接口上线就替换生产检索层。把来源、失败、并发和成本都记下来,再决定谁做默认提供方。那时做出的选择,才不会被一场发布会牵着走。
如果你的 Agent 今天已经能联网,它会把“抓不到网页”与“网页里没有答案”分开记录吗?
小岛 AI
记录一线实战、踩坑与成长