
OpenAI 撤下 3 份数学手稿,AI 科研成果该怎么验证
722 份手稿不是一个可以直接引用的结论库。顺着 OpenAI 的版本记录看一遍,你能把 AI 生成的研究成果分成可读、可验、可用三层。
OpenAI 在 GitHub 上一次放出大批数学手稿,最容易把人看晕的不是数学,而是数字。
新闻里常见的是 722 份手稿、372 组成果。打开仓库现在的 README,目录已经写成 719 份。不是页面出错,而是仓库真的在变化。10 月 7 日的版本记录里,OpenAI 撤下了 3 份手稿,修订了另外 14 份,还把 13 份依赖这些修订成果的手稿更新了引用。
这件事反而比「AI 一次写了多少数学」更值得盯住。
如果你在团队里用模型整理技术调研、生成实验报告,或者接收 Agent 交回来的长文档,真正要做的选择从来不是「信 AI 还是不信 AI」。问题是,这份东西现在处在什么验证层级,能不能进入下一步决策。
OpenAI 这次仓库给了一份很直白的现场教材。
一份手稿,不等于一条可用结论
先把官方材料放回原话里看。
OpenAI 的公告说,他们把内部前沿模型得到的一批数学结果放进了公开 GitHub 仓库,并会持续补充 Lean 形式化版本。Lean 是一种能让计算机检查证明步骤的语言,你可以把它理解成,程序不替数学家判断问题值不值得研究,却能严格检查一串形式推导有没有按规则走。
而仓库 README同时写了两个很重要的限定。
第一,成果处在不同验证阶段,不是每一份都有 Lean 形式化。第二,尚未形式化的结果可能有问题,仓库会继续修正。
这两句没有那么戏剧化,甚至有点像开源项目里的普通免责声明。可它们决定了该怎么读这批材料。
一份 PDF 能证明三件不同的事。
它至少存在,能被别人阅读。
它的核心结论可能被 Lean 形式化,程序可以重新检查对应的证明对象。
它还可能经过领域专家复核、被独立复现,并在后续工作里经得住引用。
这三层不是同一个状态。把第一层直接说成第三层,和把 CI 跑绿当成用户真的能完成任务,差不多都是把中间最费劲的部分省略了。
图为 OpenAI 官方页面配图。真正决定验证状态的,是仓库目录、形式化记录和修订历史。
719 这个数字,比 722 更有信息量
仓库的 history 文件没有绕弯子。
其中一篇手稿出现符号错误,影响了一个抵消论证,也连带影响两篇依赖它的工作。于是三篇被撤下。与此同时,14 篇手稿完成了证明修补、陈述修正、前提澄清或引用更正。还有 13 篇只是因为依赖关系变了,需要更新引用和版本日期。
这里没有必要把一次撤稿写成 AI 不行,也没必要把 719 当成某种胜利数字。
它更像一次正常的工程维护。系统输出一大批互相关联的结果后,真正麻烦的是改动沿着依赖关系往哪里传播。代码仓库里有测试、提交记录和依赖更新,研究仓库也需要有撤回、修订、历史版本和可追的引用。
OpenAI 甚至保留了已发布版本的访问路径。这一点很像生产事故复盘里不能把日志一删了之。你要知道哪一版有问题、错误从哪里来、哪些下游结论受到了影响,才有资格说修好了。
对 AI 生成的研究成果,最危险的状态不是被改掉,而是只剩一张漂亮的结论图,却找不到版本、前提和修订轨迹。
这里也要把边界说清。仓库有版本记录,不等于每个数学命题已经获得学界共识。Lean 覆盖了顶层结果的一部分,也不等于每一层背景假设、每个自然语言表述和每个研究价值判断都已经被机器或人完整检查。本文不替任何一篇手稿背书,只讨论一件更通用的事,面对模型产出的高价值材料,怎样把「看起来很厉害」拆成可以逐步验证的对象。
形式化证明也不是万能通行证
仓库当前写的是,约 42% 的顶层结果已经形式化,具体是 300 / 719。这个数字很好,也很容易被误读。
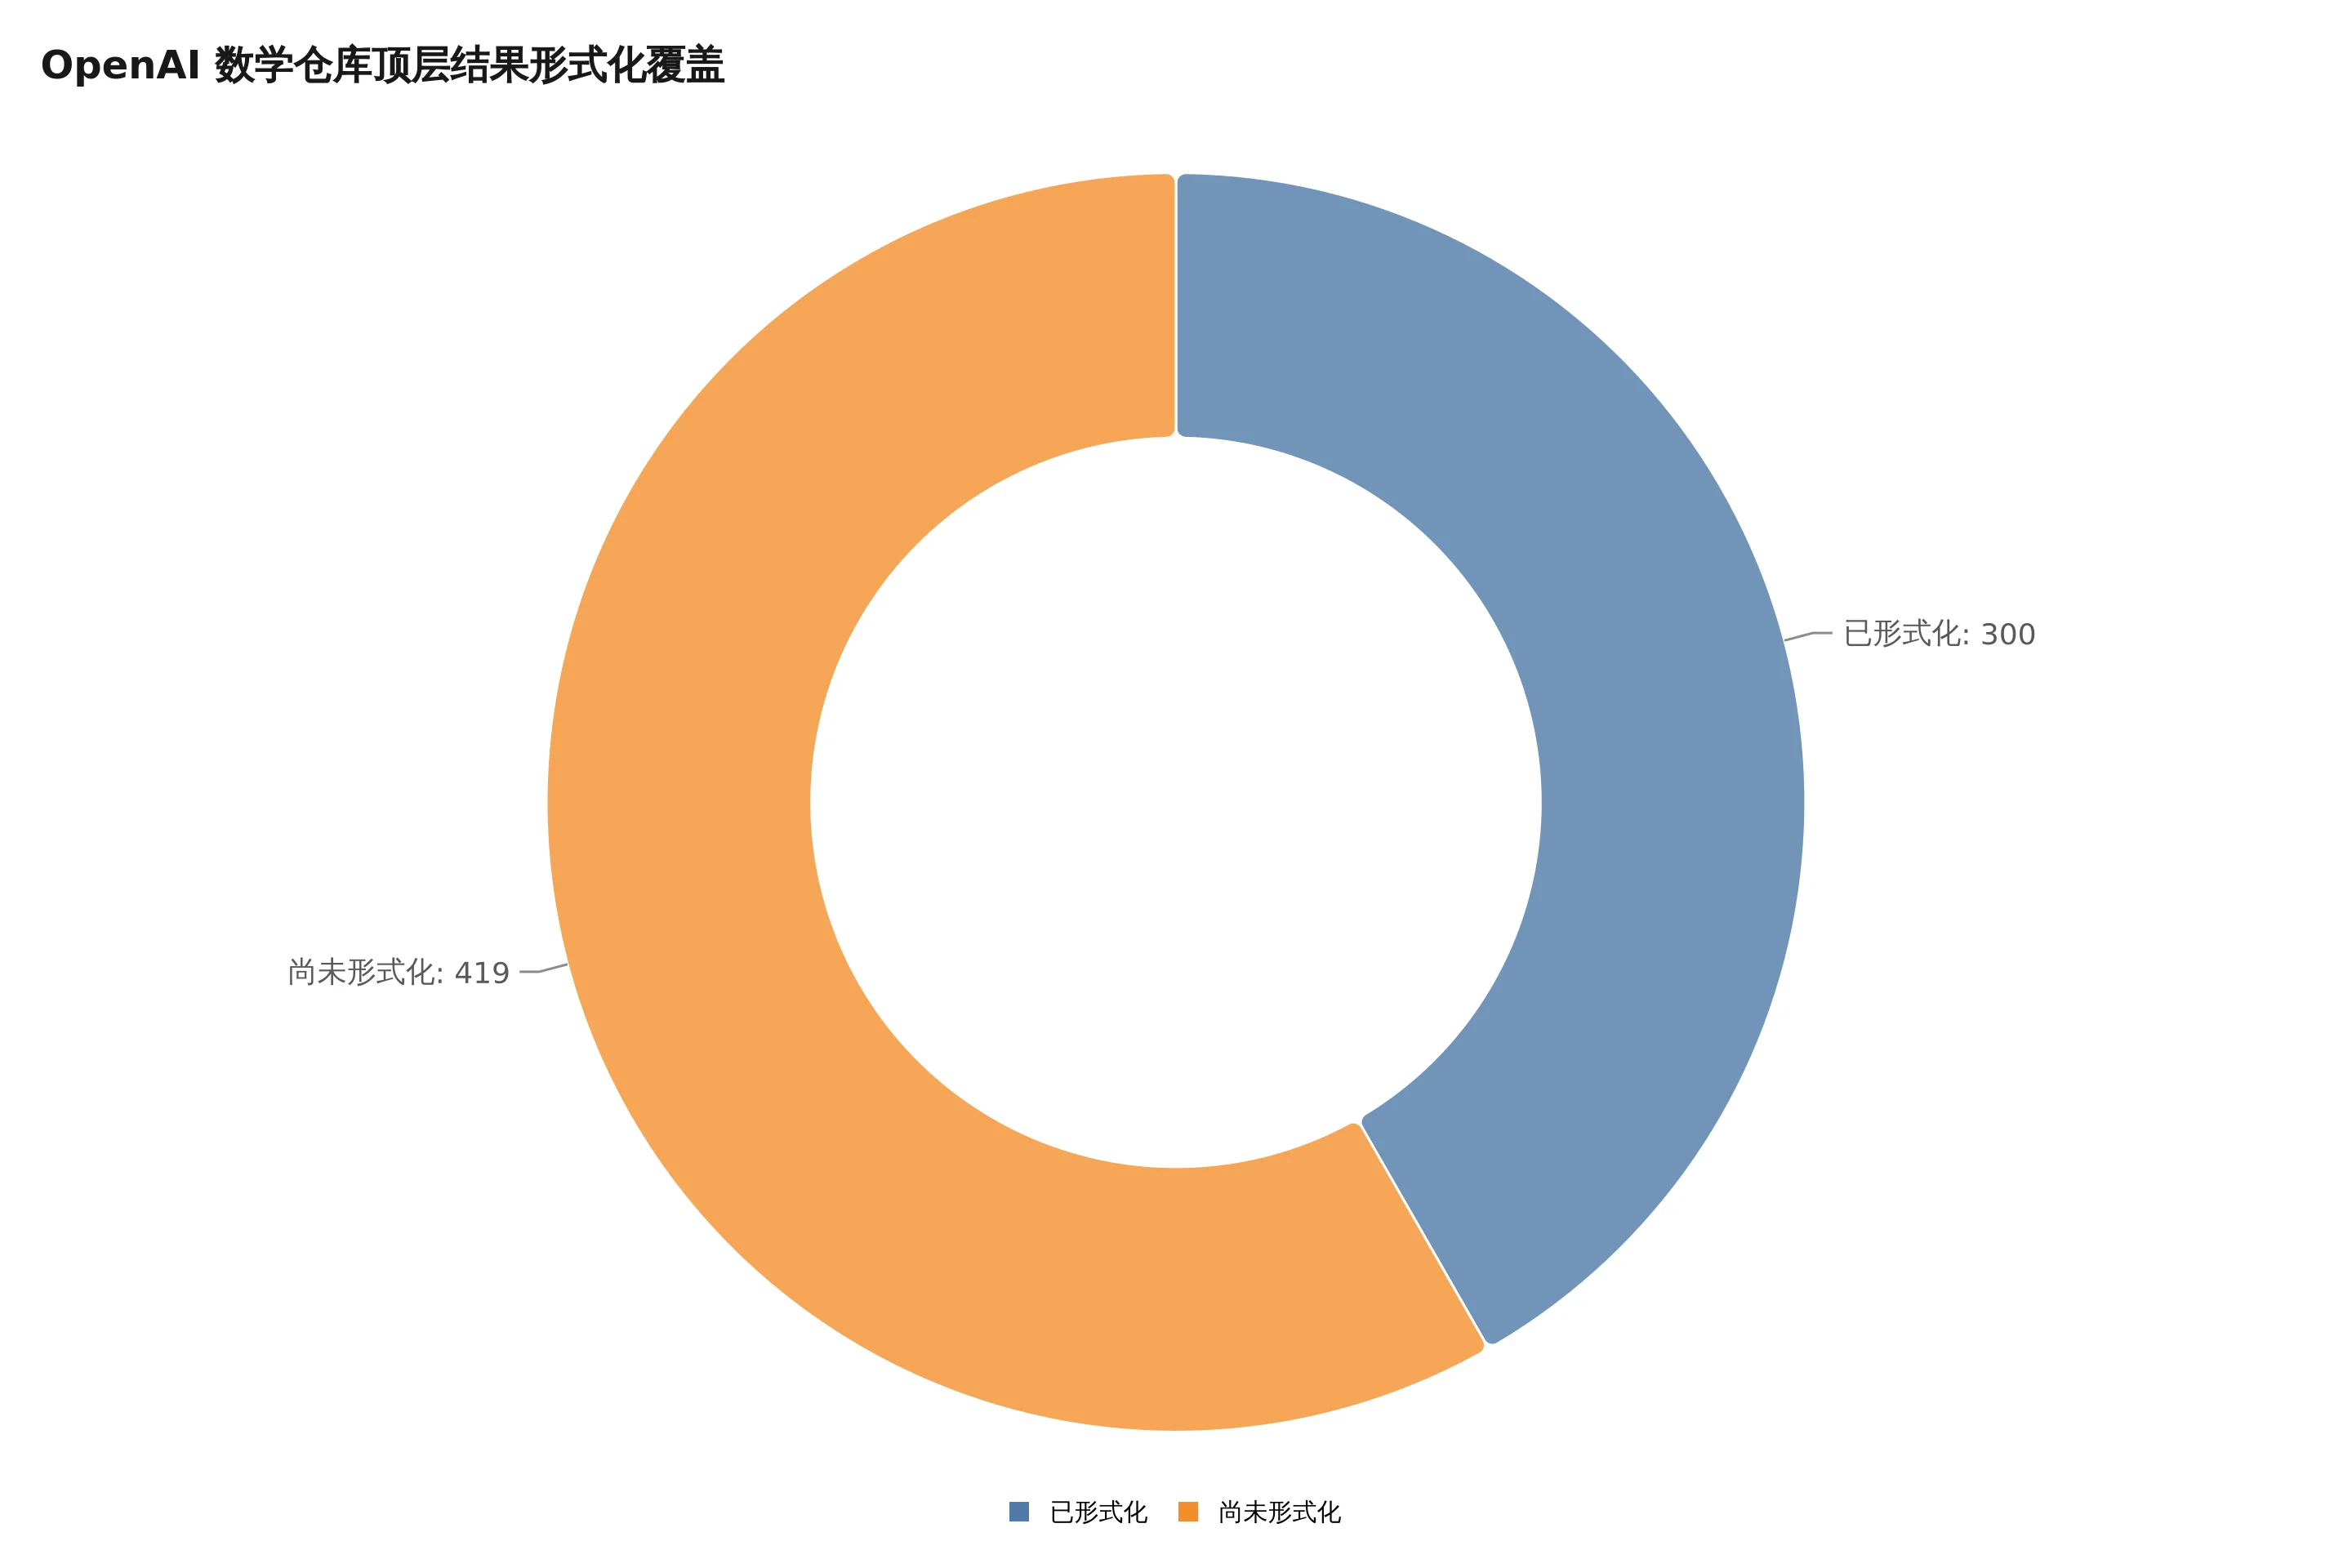
数据来自 openai/math README。图只说明当前顶层结果的形式化覆盖,不表示其余结果无价值,也不替代领域复核。
形式化证明能大幅提高「这份形式陈述能否从给定公理和定义推出」的可信度。对复杂推导来说,这是一种很硬的证据。可它不自动回答另一些问题。
问题本身是不是表述对了。
把自然语言里的研究意图翻成形式陈述时,有没有漏掉关键条件。
这个结果和现实任务、已有文献、后续应用之间,到底有什么关系。
这就像类型检查能挡住一大类错误,但不会替你决定产品需求有没有写错。两者都重要,谁也不该冒充另一个。
所以我会把这批材料按一个很朴素的顺序读。
先看它是不是有固定版本、作者说明和可追的目录。
再看核心结论有没有形式化链接,形式化覆盖的是顶层结论还是局部引理。
再看有没有独立研究者的复核、复现或后续引用。
不需要你先懂代数几何。你只是要避免在一个还在修订的仓库里,提前替别人宣布成果已经尘埃落定。
这套方法也该用在你的 Agent 身上
数学仓库离大多数工程团队有点远,可它暴露的问题一点都不远。
一个 Agent 给你交回调研报告、SQL 分析、架构方案或代码修改时,很多人只问「写得像不像」。这通常是最不重要的一问。
更有用的是顺手补四个字段。
它基于哪些确定版本的输入。
有哪些自动校验已经通过。
哪些关键结论还只是模型的推断。
一旦来源、数据或提示词变化,哪些段落需要重新跑。
这不是要把每个文档都变成学术论文。只是给「完成」加上一个可检查的定义。
比如一份竞品调研可以附上抓取时间和原始链接,一段数据分析可以附上查询版本和结果快照,一个自动改代码的 Agent 可以交回测试报告、差异文件和未覆盖的风险。它们都比一句「已完成」有用得多。
OpenAI 这次最值得抄的,不是让模型去批量写手稿,而是把结果当作会修订、会撤回、会留下痕迹的产物来管理。
AI 能把产出速度推得很高。验证、版本和责任链跟不上,速度只会把不确定性一起放大。
下一次你收到一份漂亮得有点过分的 AI 输出,可能不用急着问它对不对。先问一句,这份结论在哪个版本里,谁能把它重新验一遍?
这比盯着 722 还是 719,更接近真正的答案。