
做 AI 搜索,读写分开才扛得住整库重建
Perplexity 改造存储的重点不只是自研数据库,而是把文档状态、批量更新和在线读取拆开。本文给出判断是否该拆读写的四个信号,以及不能照搬的边界。
你给知识库换一次 embedding,或者把分块策略从一段切成三段。任务一开,旧数据开始回填,线上搜索却突然慢了半拍。
这不是模型变笨了。很多时候,是重建任务和用户查询在抢同一条存储读写路径。
Perplexity 这两天公开了它们替换 DynamoDB 的存储改造。官方给出的生产前后数据很夸张:批量读取的中位延迟从 31.4ms 降到 5.60ms,p99 从 123ms 降到 24.2ms。好家伙,表面看是自研数据库赢了,真正值得抄作业的却不是 CobbleDB 这个名字。
是他们把一件常被揉成一团的事,硬生生拆开了:文档状态归文档状态,重建和发货归重建和发货,用户发起搜索时只走一条为读取准备的热路径。
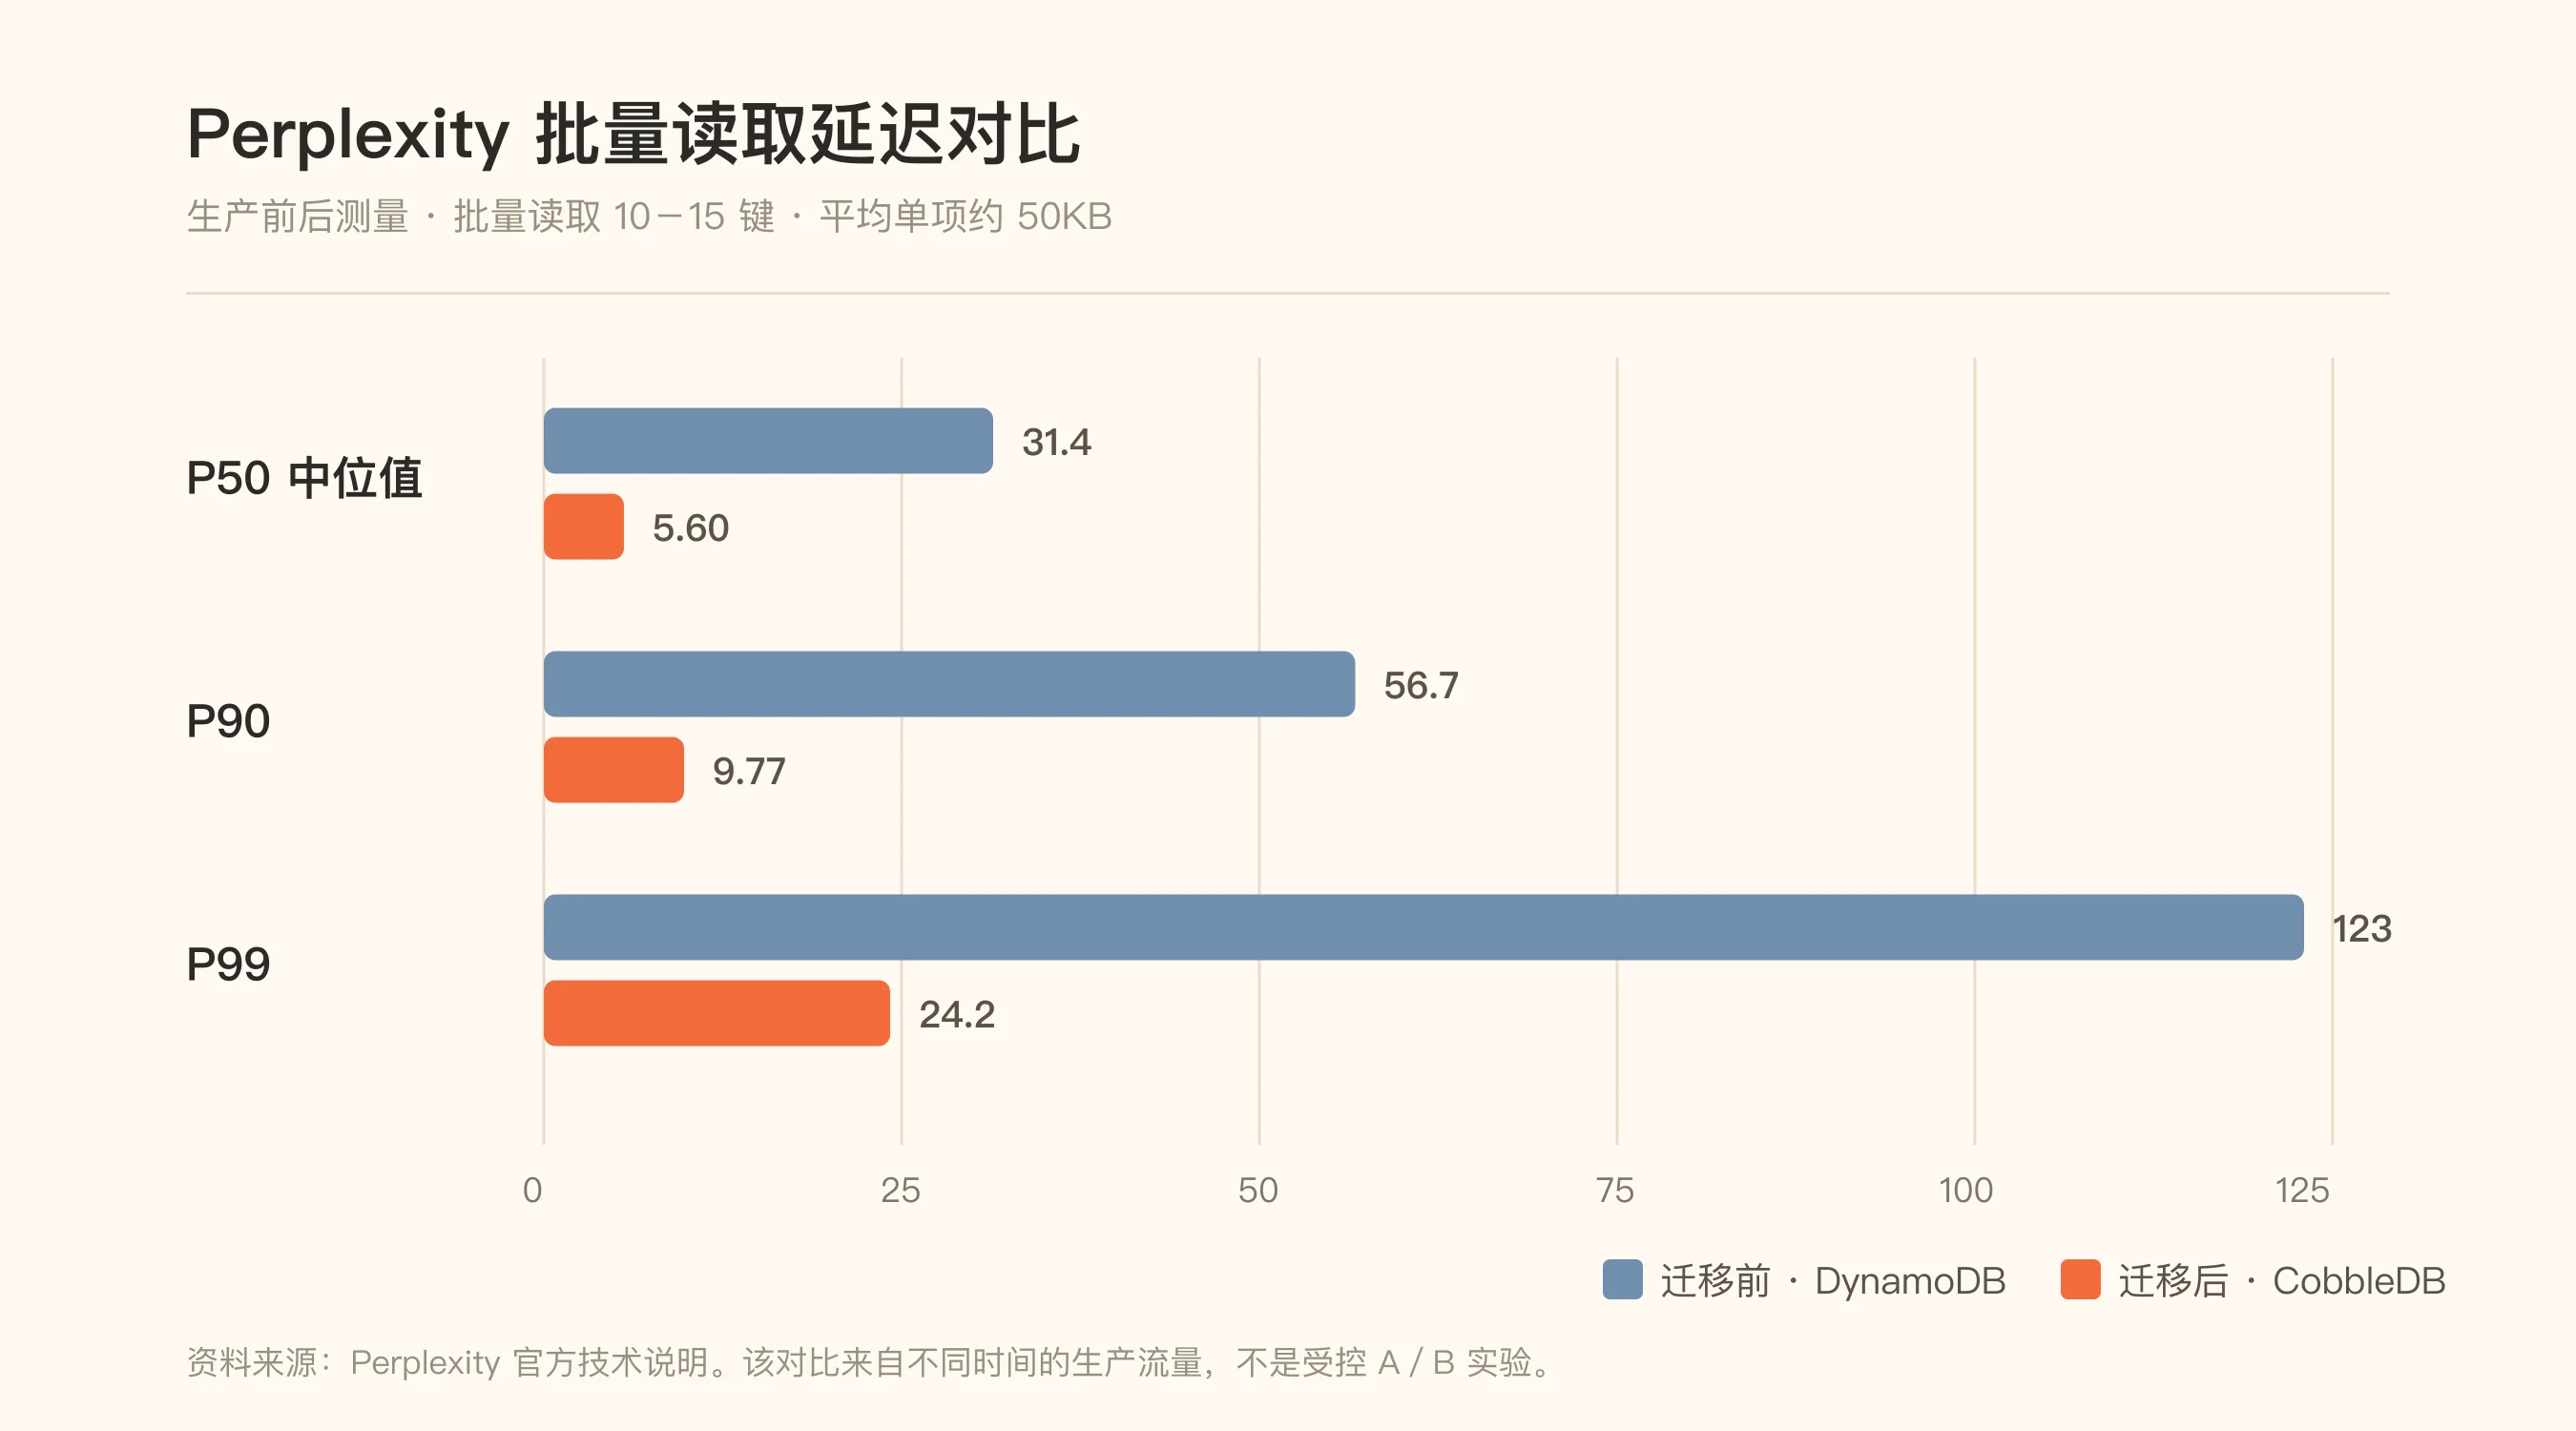
图:Perplexity 公布的批量读取生产前后数据。两套系统不是同一时刻的受控 A/B,因此它是很有价值的运行信号,不是任何团队都能原样复现的承诺。
先别急着怪 DynamoDB
在这次改造前,DynamoDB 没有失职。它替 Perplexity 扛住了高可用,也省掉了自运维分布式数据库的麻烦。
问题出在 AI 搜索的读取姿势比较怪。一次查询会拿到 100 到 120 个页面键,再切成多个 10 到 20 键的小批次去取预先处理好的段落和向量。单项平均大约 50KB。你不是随手查一条订单,而是在等一批内容都回来,才好继续排名和组织答案。
一批读取里只要有一个慢副本、一次跨可用区跳转,或者缓存没命中,后面的回答就得一起等。更麻烦的是,爬虫持续抓新页面,换分块算法、换 embedding 模型、补新字段,都可能让整片语料重新处理。那些大写入若直接落进给用户服务的热表,在线读取自然被挤到边上。
所以要问的不是“要不要造一个数据库”。先问一句更朴素的话:你是否把重建工作塞进了必须低延迟返回的路径?
它们拆开的,其实是三份责任
Perplexity 的新路径可以粗暴地记成三层。
Pillar 保存版本化的文档状态,知道哪一页、哪个块、哪版 embedding 才是当前可发布的。Lorry 负责把这些变更整理成按分区对齐的批次,写到对象存储。CobbleDB 只负责查询时的热读取,按页面键把准备好的段落和向量尽快拿出来。
这三层名字不重要,分工才重要。
- 文档状态层回答“什么是正确版本”。
- 更新交付层回答“怎么把大量变更可重放地送过去”。
- 在线读取层回答“用户现在要的那一批内容在哪”。
以前把三句话交给同一张表去回答,短期当然省事。直到某次全量回填撞上了晚高峰查询,才发现同一套吞吐、重试和副本策略要同时照顾两种彼此拧巴的工作。
CobbleDB 的读取层则很偏科。它按分区分组,把键并行送到节点;节点用 RocksDB 的 MultiGet 一次取多个键;优先读同可用区副本,某个副本慢时再向另一份副本发对冲读取。热数据在内存,未命中走本地 NVMe。
厉害了,但这不是“自建永远比托管快”。它只是承认了一件事:当你的请求长期稳定地长成同一种形状,通用接口留出的余量会变成成本和尾延迟。
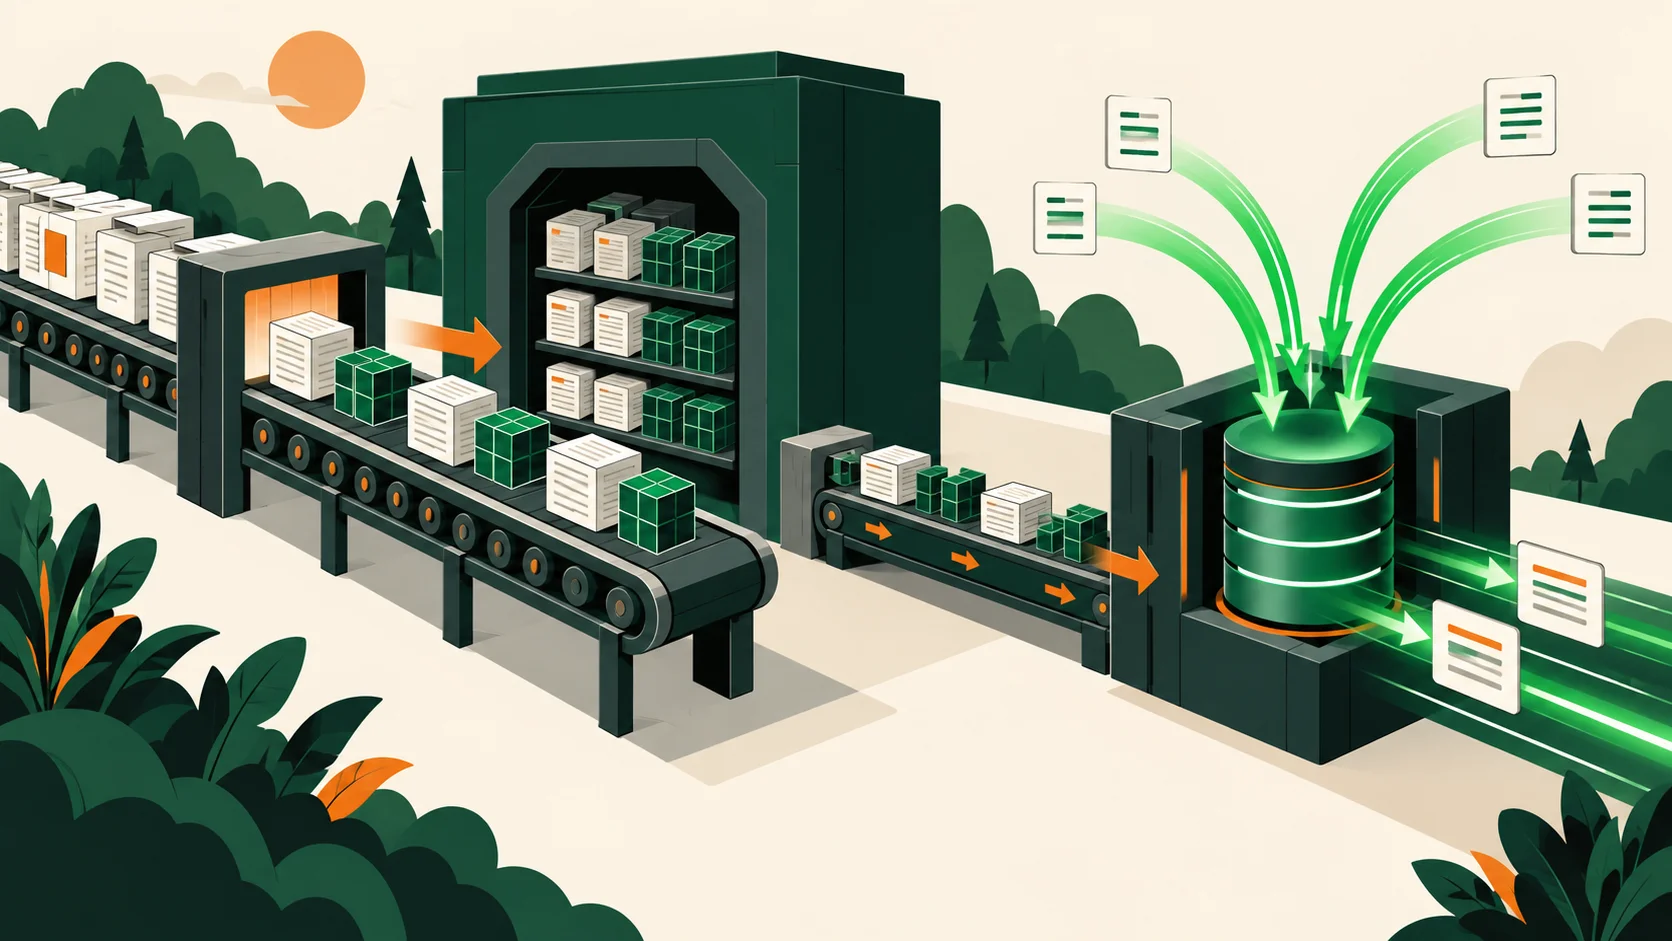
图:适合检索系统的分流思路。先把正确版本沉到可追溯的状态层,再异步、分批地推入在线热存储。
什么时候该把读路径和写路径拆开
不需要等到几十万请求每秒才动手。下面四个信号里,如果你中了两个,就值得把“拆一条更新通道”放进下个迭代。
第一,模型升级总会带来大回填。 你换 embedding、chunk 规则或 metadata 字段,不是修一行数据,而是在重算一片语料。此时最需要的是可重放的更新日志、批次和版本,而不是让每一条变更立刻去碰在线服务。
第二,在线查询读的是预计算结果。 用户每次都要取一批固定形态的段落、向量或页面摘要。读法很窄,像批量取键,而不是任意条件查询。这个时候,围绕批量读取调缓存、分区和副本,才有可兑现的收益。
第三,尾延迟开始比平均值更扎眼。 平均值还看着棒棒的,p99 却随着回填或副本抖动往上飘。对检索来说,整批里最慢的那个才是用户真正等到的时间。
第四,你能接受短暂的最终一致。 页面刚更新的几秒到几分钟里,新内容晚一点进入搜索结果,很多知识库可以接受;订单、余额、扣费和强事务工作流不行。这个边界不能含糊。
动作不必一步到位造 CobbleDB。先做最小版本就行:给索引或热表前面加一条带版本的导出日志,让回填任务按批次消费;在线查询只读已经准备好的版本;把延迟分位数、消费积压和版本滞后放在同一张监控面板。哪怕底层还是托管服务,读写也已经不再互相掐架。
有三个坑,照着 Perplexity 反而容易翻车
第一,CobbleDB 明说了自己不是通用数据库。它不追求事务,也允许副本短暂不一致。把这种设计搬去支付、权限或库存,基本是在给故障复盘攒素材。
第二,官方数字是生产前后测量,不是同一批请求在受控环境里的正面对撞。Perplexity 也写清楚了这一点。它们的工作负载是 10 到 15 键的批量读取,平均单项约 50KB;你的检索如果是一堆小对象、随机查询或强过滤,收益曲线可能完全不同。
第三,智能体不是这条架构的替代品。数百个持续运行的编码 Agent 帮它们审查变更、盯住 CI 和恢复演练、补测试和运维文档。架构决策、关键审查、生产授权仍在人手里。把 Agent 当成“多招几个自动程序员”就想跳过这些门,多少有点子天真。
这篇故事里最值钱的角色分工,不是两个人加几百个 Agent 的传奇数字,而是人守住决定和上线,Agent 去做持续检查和跟进。这个次序别倒过来。
把判断留在这里
Perplexity 的改造把批量读取压低了,也估算出相对 DynamoDB 至少 20% 的成本节省。它们计划开源 CobbleDB,不过现在还没到可以直接拿来替换生产库的阶段。
对多数团队,最有用的结论反而更小:下一次你要全库重嵌入时,别只盯着模型价格和 GPU 队列。先看那批写入会不会挤进用户正在等的读路径。
如果你的检索服务也经历过一次“回填一开,p99 就抬头”的时刻,你会拆队列、换存储,还是干脆把重建留到半夜?