
产品出海要翻55种语言,本地模型该不该上?
Google 的语言能力已扩到 300 多种,但产品团队真正要决定的,是哪些翻译该留在自己手里。用一张验收单判断 TranslateGemma 值不值得进本地化流程。
产品一出海,翻译很快就从一个按钮变成一堆小麻烦。
帮助中心要翻,客服模板要翻,商店页要翻,截图里的字也要翻。前几天还能把文案扔给在线服务,等内容里混进未发布功能、价格、客户案例和内部术语,问题就来了,哪些内容能出公司,哪些不能?哪种语言可以自动过,哪种还得人工盯?
Google 9 月 15 日发布的语言能力更新给了一个挺大的数字,技术已覆盖 300 多种语言、70 多亿人和全球约 86% 的人口。公告里还提到,Google Translate 已支持 250 多种语言,Gemini 3.5 Live Translate 做到了 70 种语言、2,000 多个语言对的实时口语翻译。
好家伙,语言模型这条线已经从“能不能翻”卷到“在断网时、在设备上、在一句话里混着两种语言时,能不能还翻得像人话”。
不过这篇不准备复读 300 多种语言。对做产品的人,真正有用的是公告里顺手带出的另一个选择,本地翻译模型到底什么时候该上。
先把一件事摆正。Google 的 TranslateGemma 不是今天刚发布的模型,它在今年 1 月就公开了。这次是 Google 用整个语言技术版图重新提到了它。官方模型说明给出的规格是 4B、12B、27B,面向 55 种语言训练和评估。4B 偏移动端与边缘设备,12B 偏消费级笔记本,27B 追求更高保真度,需要单张 H100 或云端 TPU。
这个位置有点子牛逼。不是又多了一个聊天框,而是把翻译从“每次都要把文本送去某个 API”变成“可以放进自己的设备或基础设施里的一层能力”。数据路径变短了,代价也跟着从调用费变成显存、部署、版本和验收责任。
别把一个翻译入口塞给所有文本
很多团队做国际化,最容易犯的错不是译得不够快,而是把所有文本当成同一种东西。
一类是公开、可回滚、容错高的内容。比如旧博客、功能帮助页、长尾 FAQ。这类文本最适合拿本地模型试水,错了能改,慢一点也不至于把线上交易弄出事故。
一类是有产品语气和术语账本的内容。比如按钮名称、套餐描述、开发者文档、错误信息。它们未必保密,却很怕前后不一致。中文里同一个“工作区”被翻成 workspace、space、project,用户的脑子就要多开三个标签页。这里模型的角色不是替你拍板,而是先产出候选,再去吃团队维护的术语表、禁止词和界面长度限制。
还有一类是敏感或高风险文本。未发布路线图、客户材料、合同、医疗和法律内容,都不该因为“支持 55 种语言”就一把梭。离线部署能缩短数据路径,不等于自动满足合规,也不等于翻对了就能发。隐私评审、访问控制和人工复核,少一个都不行。
所以本地模型不是云端翻译的替身,更像给团队多开了一条可控车道。该跑哪条,取决于文本的风险和验收成本,不取决于发布会上的语言数量。
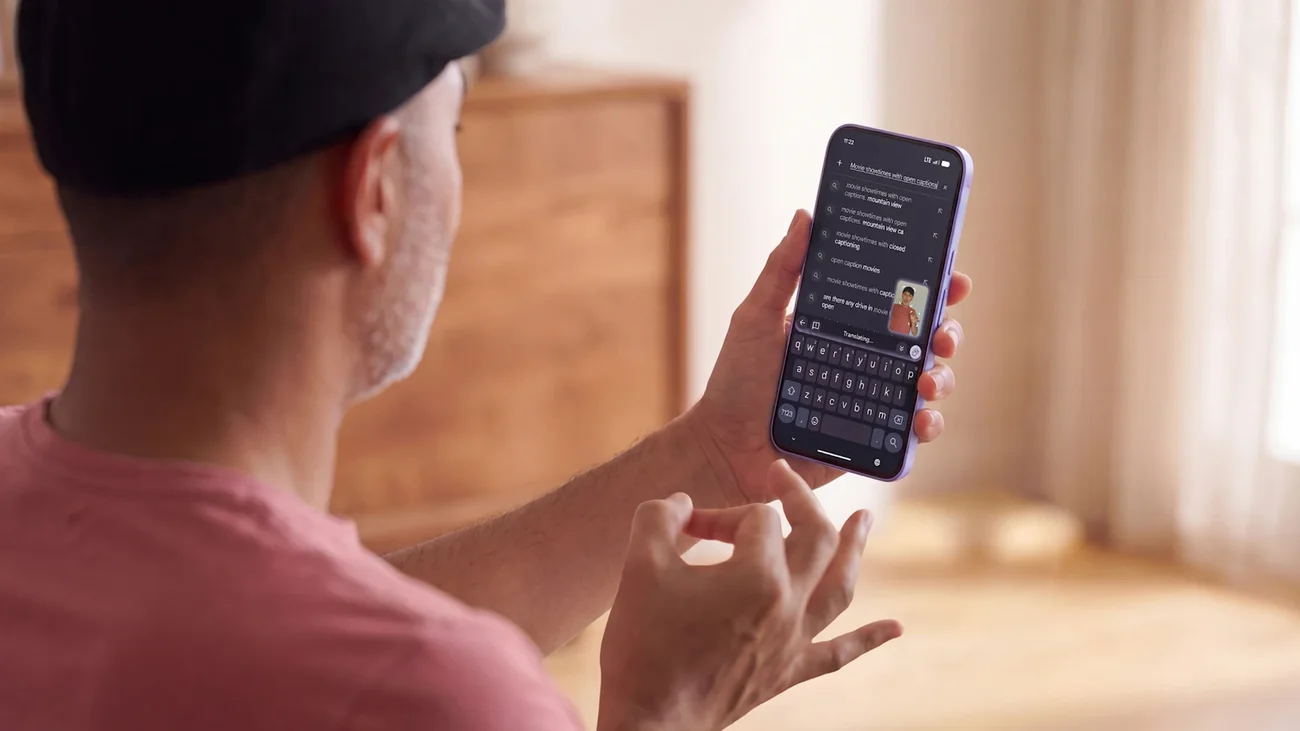
官方语言能力公告中的移动端翻译场景。它讲的是覆盖与交互,不替代产品文本的验收。
四个问题,十分钟就能做一次取舍
如果团队正准备试 TranslateGemma,可以先别搭一整套平台。拿最近要翻的一批真实内容,过一遍这四问。
第一问,文本能不能离开你的系统。
能公开的内容,在线服务和本地模型都可比。不能离开的内容,先把候选缩到自托管或受控环境,再讨论质量。很多选型会从模型名字开始,顺序反了,数据边界先定,模型才有资格进场。
第二问,翻译错一处会损失什么。
把“不好看”和“会误导用户”分开。前者可以批量抽检,后者要做关键字段白名单和人工签出。比如价格、付款、删除、权限、合规承诺,这些词即使模型整体得分很好,也值得单独建用例。
第三问,你翻的是哪一对语言,哪一种领域。
Google 对 TranslateGemma 的公开评估覆盖 55 种语言,并说明在近 500 个额外语言对上做过训练,但那些扩展语言对还没有确认的评测指标。这里不要替官方补结论。英语到中文顺,不能推出中文到某个低资源语言也顺;通用文本不错,也不能推出产品条款不错。拿你自己的 30 到 50 条高频句子测,才是开始。
第四问,谁负责把结果放上去。
翻译流程最怕一个没有名字的“自动发布”。给每条输出留下源语言、目标语言、模型版本、提示词或模板版本、术语表版本、审核人和回滚入口。看着像多写几列,真出问题时,它能让人不用在一堆导出的 CSV 里考古。
这四问没有一个在比跑分,却决定了模型有没有资格碰生产内容。
4B、12B、27B,不是从小到大排队买
官方材料给了一个足够清楚的分工。4B 适合设备端和边缘场景,12B 的定位是消费级笔记本,27B 是高保真度云端推理。选择时可以把它们看成三种试验成本,而不是三档会员。
想验证离线是否可行,先从 4B 开始,测延迟、内存和最常见的语言对。想验证术语一致性和长文质量,12B 才是更值得花时间的比较对象。27B 只有在文本价值高、已有稳定部署环境,并且小模型的差异已经被真实样本证实时,才值得进入候选。
Google 称 12B TranslateGemma 在 WMT24++ 的 MetricX 评测中优于 Gemma 3 27B 基线。这个结果挺好,但它只回答了公开基准里的相对表现。它没有替你回答“我家产品的按钮长度会不会溢出”“品牌名会不会被改写”“截图里的文案还能不能对应 UI”。这些得由自己的验收集回答。
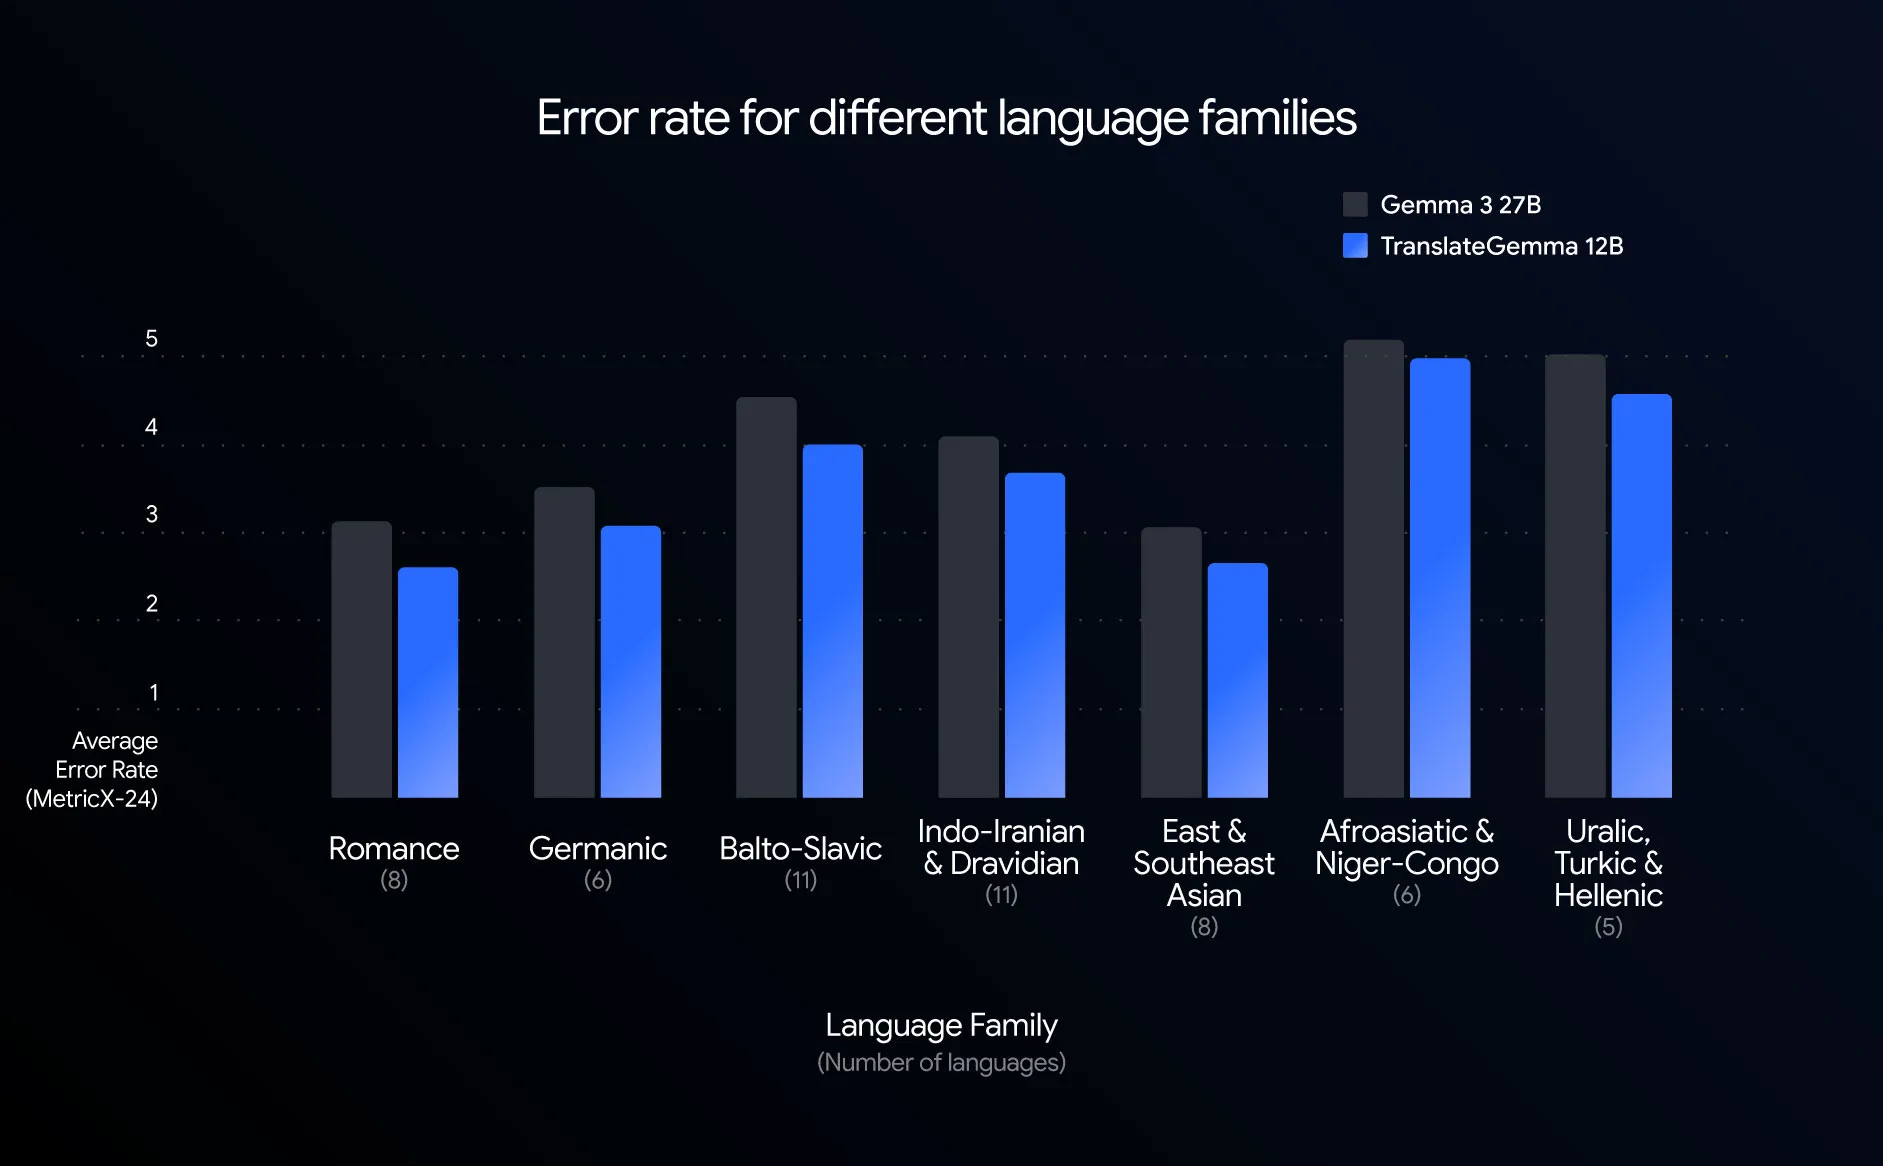
Google 官方基准图显示 TranslateGemma 12B 与 Gemma 3 27B 的平均错误率对比。它是公开评测证据,不是任何产品语言对的上线承诺。
别迷信参数,也别迷信一眼看上去很顺的译文。翻译最阴险的 bug,往往不是病句,而是看上去完全没问题、却把权限范围、金额单位或否定词悄悄换掉了。= =
先做一个小而硬的验收集
这篇没有本地实测,不能替任何团队宣布 TranslateGemma 在你们的语言对和硬件上可用。官方模型卡也提醒,下载 Hugging Face 权重前需要接受 Google 的使用许可。4B 官方模型卡里保留了 Transformers 和 vLLM 的接入入口,这些只是起跑线,不是验收结论。
真正建议拿走的是下面这个最小测试包。选 30 到 50 条真实但可脱敏的文本,里面至少混进产品名、变量、日期、金额、否定句、界面长度受限的按钮和一段带图片文字的素材。每条标好正确的目标语言和不能动的术语。
然后比三件事,是否忠实,关键含义有没有跑偏;是否一致,同一个词有没有在多处变脸;是否可用,长度、格式、链接、变量和截图里的文字能不能直接进入产品。只看“读起来顺不顺”会漏掉最贵的那类错误。
Google 这次把语言能力扩得很远,挺让人兴奋。但产品团队不需要因为 300 多种语言就急着把翻译架构推倒重来。
从一批能回滚的内容开始,把数据路径、术语和验收责任写清楚。模型能留在本地,是一个新的选项,不是一张免检通行证。
你们团队现在最难翻的内容,是语言本身,还是那张永远没人维护的术语表?