
同传上了 2.3 秒,真正要验收的是什么
Qwen3.8-LiveTranslate 把延迟降至 2.3 秒。给跨语会议、直播和客服接入时,仍要把听清、等得住、分得对三条验收线写进上线单。
做跨语会议、海外直播或者语音客服的人,大概都被这个问题追过。
同传到底够不够实时。
产品同学会盯着屏幕上的译文有没有跟上,工程师会盯着 WebSocket 里不断进出的音频包,主持人则只在乎嘉宾讲完一个梗以后,现场还能不能笑在同一拍上。三个问题听着像一件事,落到线上却常常各管各的。
Qwen 刚发的 Qwen3.8-LiveTranslate 把字均延迟 LAAL 从 2.8 秒压到 2.3 秒。好家伙,半秒在发布页上很短,放在会议里却可能刚好跨过「译文还像跟读」和「听众开始回头看原文」那道坎。
但我更在意的不是这个数字,而是它顺手暴露了一件事。实时同传从来不是一个延迟 KPI,它至少同时在验三条线,听清、等得住、分得对。
本文没有做独立实测,下面只基于 Qwen 官方发布和平台文档,把这次更新翻成一张能拿去开评审会的验收单。别让一个 2.3 秒把整场上线讨论提前散会。
半秒的价值,先别算在海报上
LAAL 是字均延迟,用来描述一段译文相对原话平均落后了多久。Qwen 公开的多语评测图里,Qwen3.8-LiveTranslate 是 2.3 秒,上一代是 2.8 秒,图上还列了另外几套主流系统。这个改进值得看,尤其是它没有只报一个更快的首字返回时间。
可线上用户感受到的等待,往往比 LAAL 多好几层。麦克风采集有缓冲,浏览器和服务端之间有网络抖动,模型要先判断一句话是不是说完了,译文语音还得排队播放。嘉宾抢话时,上一位的尾音甚至会压住下一位的译文。你后台看到 2.3 秒,观众耳朵里可能已经是另一回事了。
所以评审时可以先问一个很朴素的问题。你们要的是「字幕尽快出现」,还是「听众能稳定跟着说话人听下去」。前者可以只盯文本首包和 LAAL,后者还得把停顿、断句、重连后的补偿和语音播放队列一起放进表里。
Qwen 这次用 Interleave 把音频、原文和译文放进同一条流里处理,已经听过的音频和已经产出的译文可以复用。官方给出的方向很清楚,减少串行传递,少等一段,少丢一段。这个设计图比「快了半秒」更有信息量,它说明模型希望把理解、翻译和输出靠近,而不是把三个服务各自催快一点。
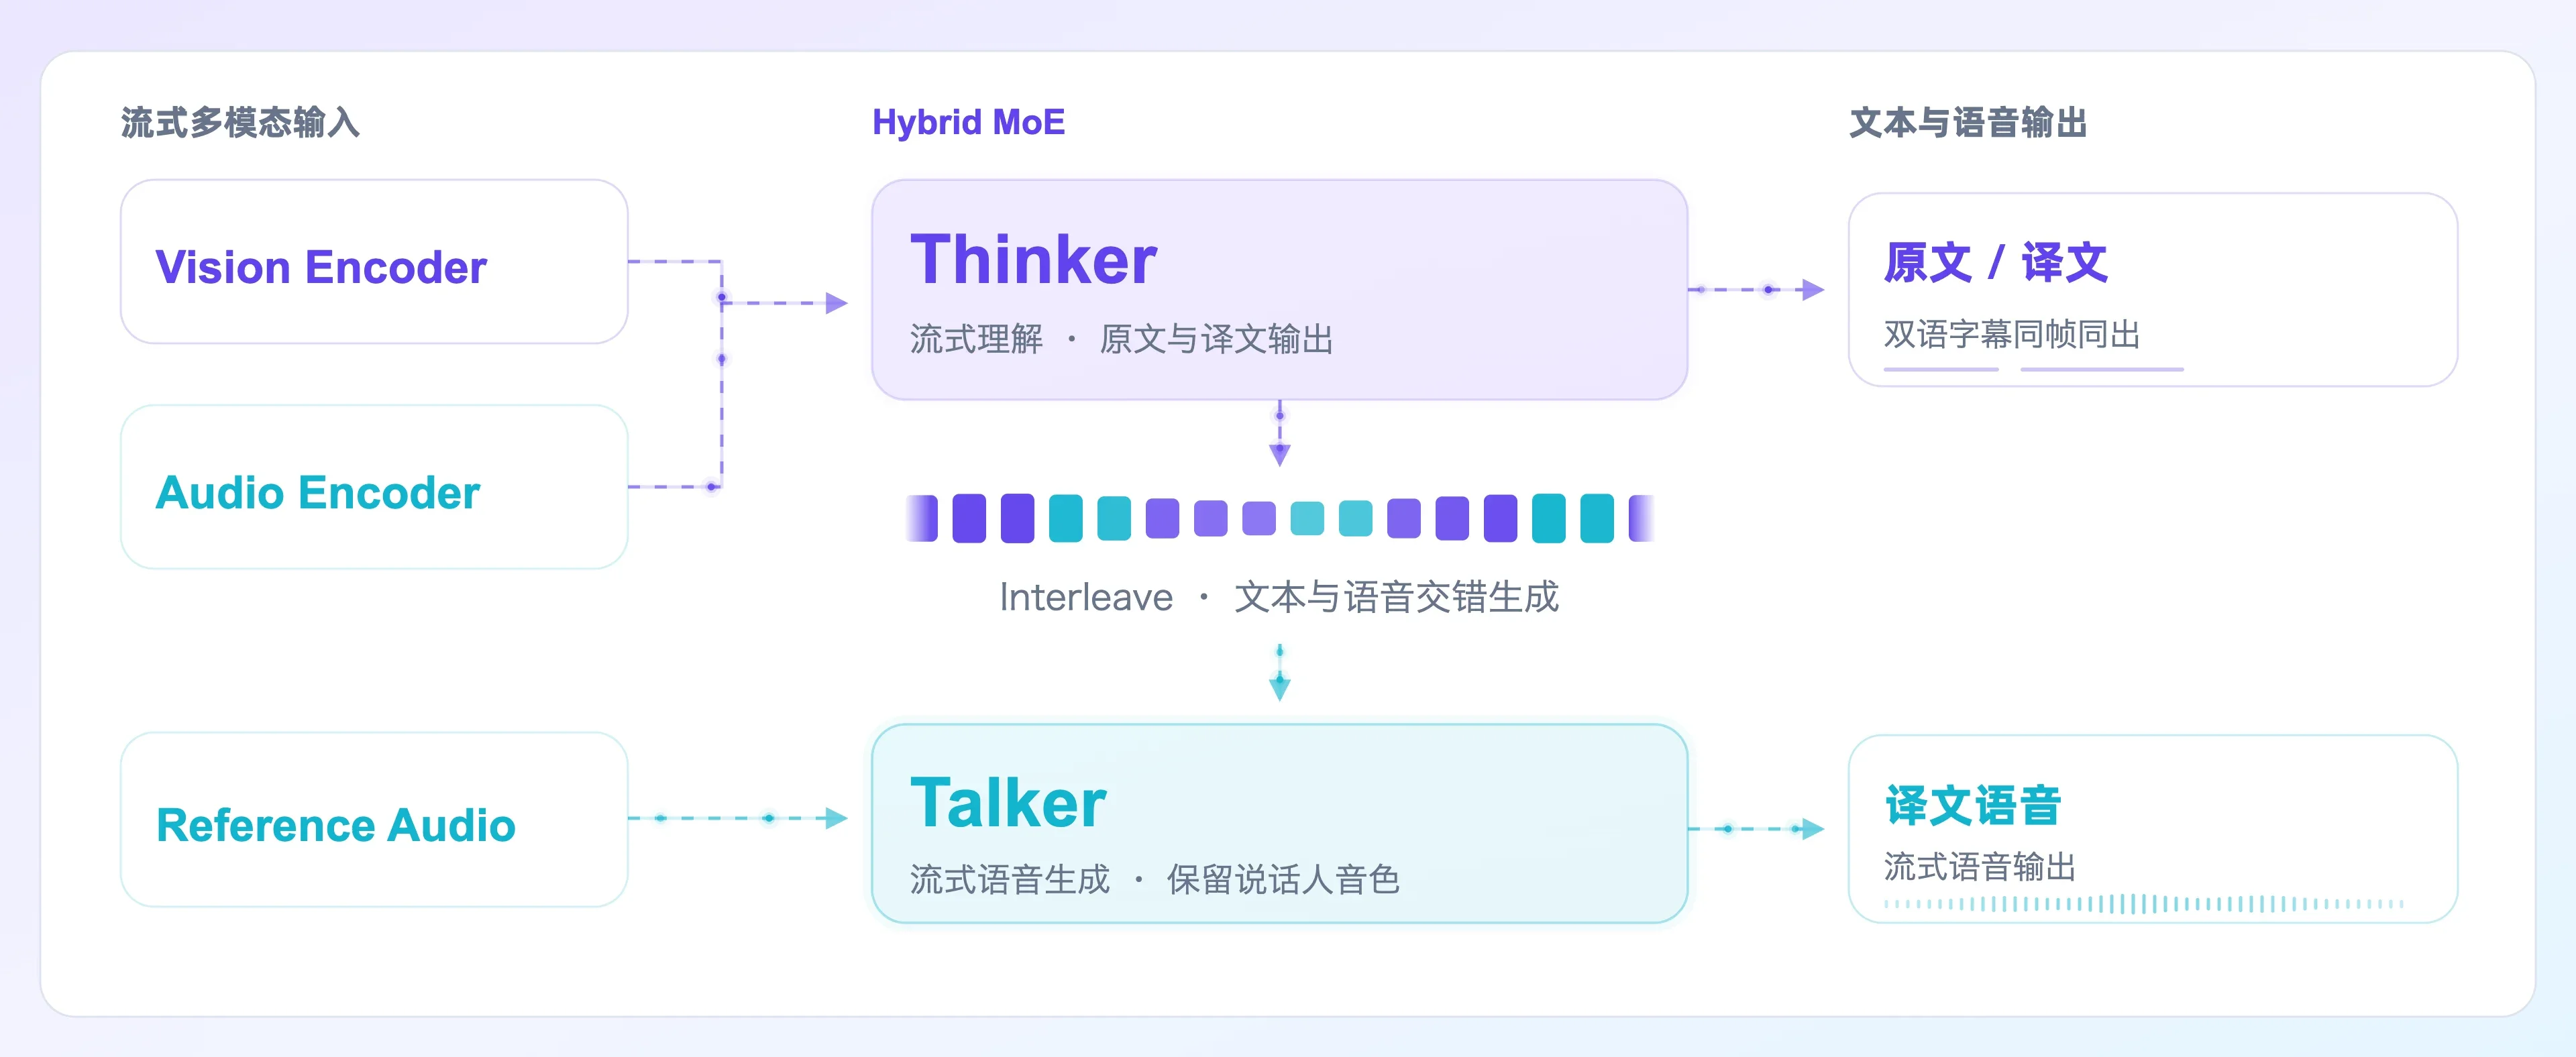
Qwen 官方架构图,输入侧同时接收视觉与音频信息,输出侧保留原文、译文与译文语音。
不过交织得更紧,也会让出问题时更难拆。传统管线常写成 ASR、LLM、TTS 三段,分别是自动语音识别、语言模型和语音合成,慢是慢,至少能知道错在识别、翻译还是合成。端到端的语音到语音 S2S 单模型把链路压短后,用户体验会更顺,排障却更像在一个黑箱里听回声。这个取舍没有标准答案,跟你的产品形态有关。
如果是一场高互动的产品发布、直播连麦或者跨语客服,低等待比「每个环节都可替换」更值钱,单模型路线值得优先验证。要是你做的是视频配音、播客本地化,或者客户要求每一步都留可审计文本,平台文档也明确把文件型 HTTP 和可拆分管线留了出来。别为了追实时,把本来需要可回放、可改词的工作塞进同一条流里。
听清,先处理人和词
真正会让一场同传翻车的,通常不是一句简单的中译英。
两个人同时接话,主持人省掉主语,嘉宾忽然报出一个没进词库的产品名,屏幕上又闪过缩写。此时翻译质量还只是其中一半,另一半是系统有没有把一句话送回正确的人。
Qwen3.8-LiveTranslate 新增实时说话人分离,服务端能同时回源语言原文、译文和说话人标识。官方在 14 个语向的多说话人长音频集上,用忠实度、流畅度、简洁度和 DER 来比较。DER 可以粗暴理解成「谁说了什么」被分错的比例,数值越低越好。
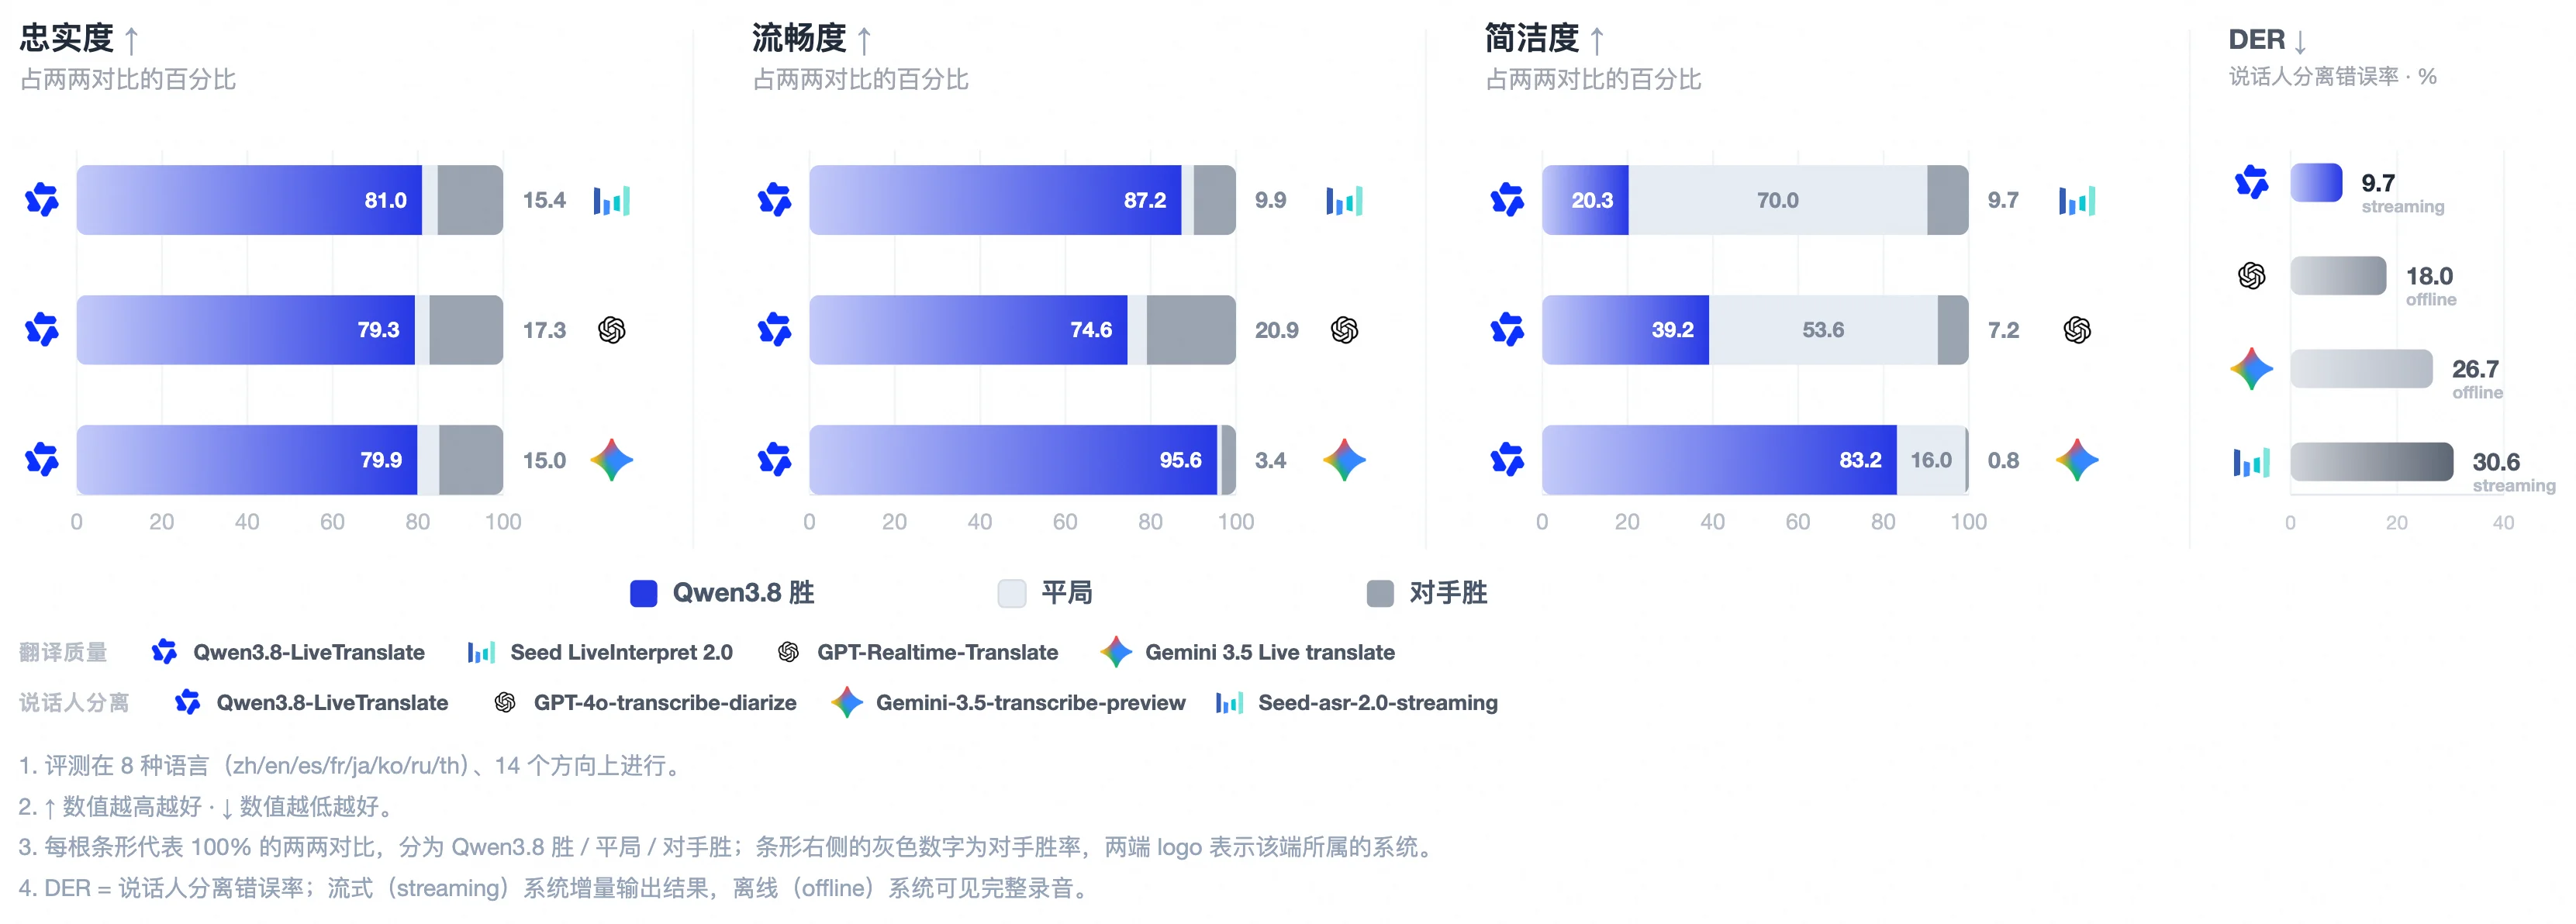
官方比较了翻译表现与说话人分离错误率。图表是厂商基准,不替代自己的真实会话验收。
这张图最值得带进评审会的,不是某一行赢了谁。它提醒你把说话人分离单独立项。很多团队只会抽几段干净音频,看译文大意对不对。到了多人会议,字幕归属一旦错位,哪怕每句话都翻得像模像样,用户也会立刻失去信任。真人在发言,字幕却挂在另一个人的名字下,这种体验比错一个术语还扎眼。
术语也是同一类问题。官方示例里提供了 corpus 热词配置,允许把行业词、产品名和固定译法放进会话。这个小口子别忽略。模型带着长上下文能缓解指代和前后不一致,热词则是把你已经知道、而模型未必知道的业务知识提前交给它。一个负责证券会议的人,和一个负责游戏直播的人,不该把词表当成同一份 Excel。
这里有个很实用的分工。模型负责在流里维持语义,业务方负责维护易错词、嘉宾名单、品牌写法和禁译词。不要幻想后者会被新模型自动吞掉。很多线上事故并不神秘,就是发布前没人把客户名送进那张表。
等得住,别只测安静房间
Qwen 官方在 FLEURS 的 70 个语言方向上给出翻译质量、LAAL、语音识别错误率和语音自然度比较。Qwen3.8-LiveTranslate 在该图中显示 LAAL 为 2.3 秒,识别错误率为 6.6,语音自然度 UTMOS 为 4.0。图里有明确的测试范围和对比口径,这些都比一句「更低延迟」靠谱得多。
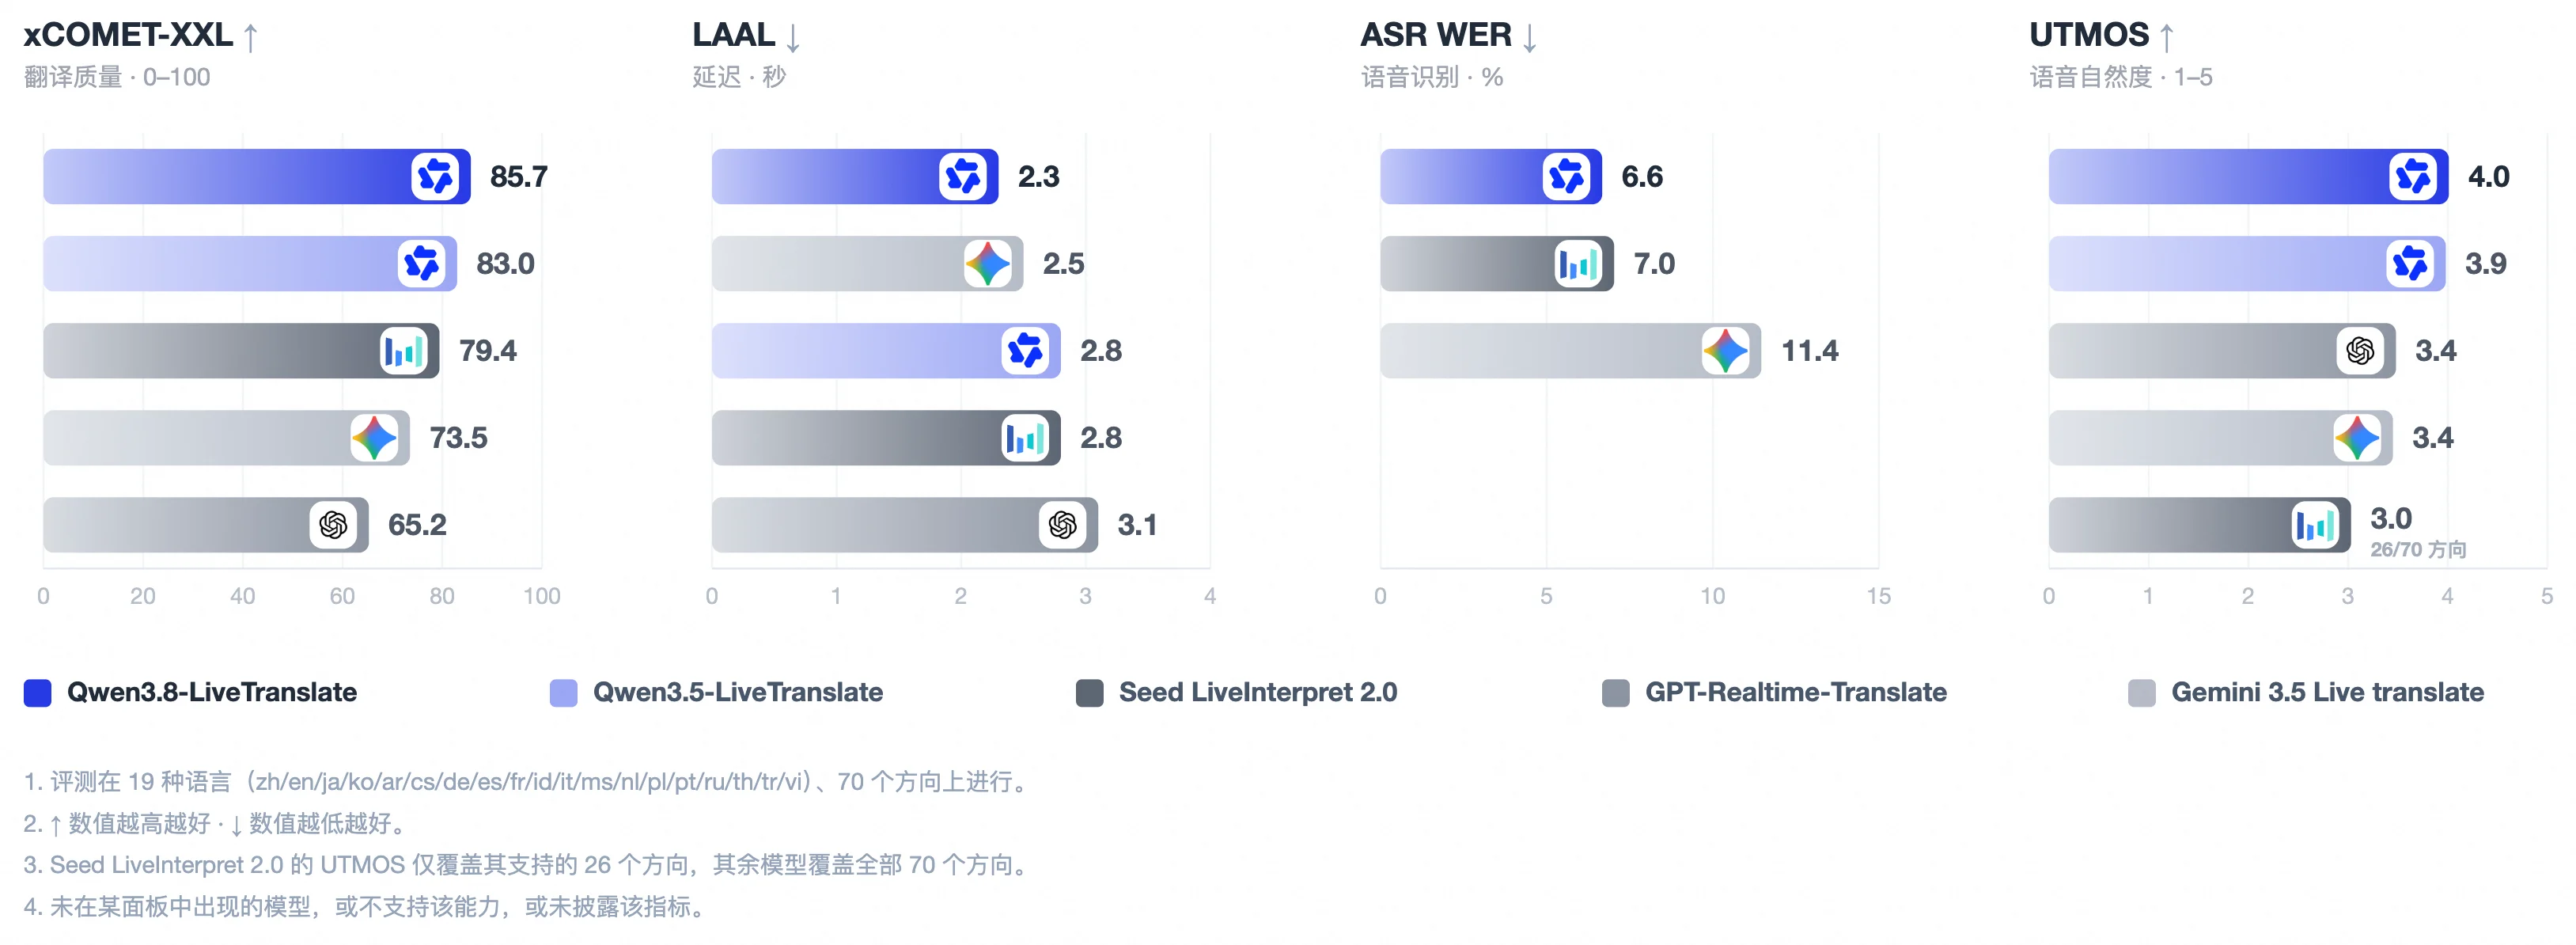
官方 FLEURS 图同时展示质量、延迟、识别和语音自然度,四个维度不能拿一个数字代替。
但基准里的流畅音频,不等于你的线上流。会议里会有口音、叠音、键盘声、回声、弱网切换,还有发言人讲到一半突然共享屏幕。平台文档说,这个模型可接收音频和图像输入,视觉上下文能帮助处理屏幕文字、唇动和歧义。这个能力值得测,可也不能替你决定什么时候采帧、丢帧,网络卡住时优先保音频还是保画面。
尤其是连续播放的产品,别只录一段十秒样本就下结论。真正该做的是找一段二十分钟以上的多人素材,塞进真实网络和真实终端。观察字幕会不会积压,语音会不会越播越晚,重连以后有没有漏句,发言人切换会不会把名字拖到下一轮。听起来很土,棒棒的,就是这些土问题决定现场会不会尴尬。
你可以把第一轮验收单写成下面这样,先让产品、客户端和服务端拿着同一张纸说话。
实时同传上线验收单

听清
多人交替发言时,原文、译文与说话人标签能否稳定对应
品牌名、嘉宾名和行业词能否通过热词表保持一致

等得住
连续二十分钟后,文本与语音是否仍然追得上现场
弱网、短暂断连和重连后,是否漏句或重复播放

分得对
双语同屏是否让用户能核对原文
音频输出语种、音色和字幕语种是否符合当次场景
这张单没有把「模型能不能翻」放在第一行,是故意的。能翻只是门票。用户真正愿不愿意继续戴着耳机,是另外两条线一起决定的。
60 种输入,不等于 60 种声音
发布里还有一个很容易被一句「覆盖 60 种语言」带过去的细节。模型支持 60 种输入音频和文本输出语言,语音输出只有 29 种。做字幕产品时,这往往不是问题。做同传耳返、导览设备和直播配音时,它就是产品边界。
这不是挑刺,是把承诺写完整。你可以让更多语言进来,再把译文以文字展示出来,可当用户期待的是听到目标语种的自然语音,就得先确认那个语种在 29 种音频输出里。两种能力在发布会上放在同一句里很顺,放到客户合同和 UI 文案里就必须分开。
同样要分开的,还有「同传」与「语音助手」。Qwen 的语音到语音文档把实时翻译和实时对话分成不同的推荐模型,前者用 LiveTranslate,后者用音频对话模型。翻译项目一旦又想插工具调用、联网搜索、复杂问答,很容易把路线搞混。模型能听见,不代表它适合接业务动作。
所以接入前先写清一个选择。你的产品是在帮人把话传过去,还是在替人继续把事办下去。前者优先看延迟、语言、说话人和术语。后者还得回头看工具调用、权限、状态和失败回退。把这两个场景绑成一个「万能语音 Agent」,后面多半会得到一堆谁也不敢改的开关。
Qwen 官方已经给出 WebSocket 接入和会话配置示例,平台也标明了模型名、上下文窗口及实时调用方式。想试的人可以从 实时音视频翻译文档 和 模型能力与计费页 开始,不需要先把整套产品改写一遍。
2.3 秒之后,才轮到上线
我挺喜欢这次发布没有只给出一个语种列表。说话人分离、双语同屏、长上下文消歧,这几个词摆在一起,至少承认了同传不是把音频扔进一个翻译接口就结束。
可模型页再漂亮,也代替不了你们自己的验收现场。厂商图表回答的是它在公开基准上做得怎样,你的业务还要回答高峰时有多少房间同时开、热词谁来维护、错译后用户能不能快速发现、断流以后怎么补回。
先把这三条线写进上线单,再去享受那半秒的改善。实时系统最怕的不是慢一点,而是看起来已经很快,结果所有人都忘了问它有没有把话送到对的人那里。
如果你正在做跨语会议、直播或客服,最难验收的那一条是什么,延迟、术语,还是多人抢话后的归属?