
写代码的 Agent,今天能接 Step 5 吗?答案不在 1M 上下文
Step 5 Preview 把长上下文、多轮工具调用和持续执行摆到台前。值不值得接入,不看参数海报,看任务能否验收、过程能否恢复、成本能否按成功交付计算。
一个写代码的 Agent,连续跑了 3 个多小时。
它读 ESP32-S3 的文档,动串口,调摄像头,拿设备截图,模拟鼠标,再根据报错改代码。这个过程听着像产品宣传片,阶跃今天发布的 Step 5 Preview 官方介绍 里,确实就是这么展示的。
好家伙,大家看到的第一屏大概都是 600B 总参数、27B 激活参数、100 万 Token 上下文。数字很有气势,模型也很新。可如果你正在让 Claude Code、Codex 或 Cursor 干活,真正要问的其实更具体。
今天要不要把 Step 5 接进你的 Agent 流程。
我的答案是,可以接一个小而硬的试点,不要急着搬主流程。它值得被认真看待,却还不该只凭一张参数海报就拿走生产权限。
这篇就聊这件事。不是复读发布会,而是把 Step 5 翻成一张能放进工程评审会的接入单。
长上下文只是入场券
阶跃把 Step 5 Preview 定位成面向真实 Agent 任务的旗舰模型。它采用稀疏 MoE 架构,600B 是总参数,实际每次推理激活 27B。MoE 可以把它理解成一个很大的专家团,来了一个问题,只叫其中一小部分人进会议室。总规模负责覆盖面,激活规模更贴近每次调用要付出的推理工作量。
官方给出的卖点也很明确,文本和视觉都能接,100 万 Token 上下文,目标是 AI 编程、软件工程、专业知识工作和金融研究。官方还称它在 Artificial Analysis Intelligence Index 得到 44 分,单任务成本约为 Claude Opus 5 的八分之一。
这里得把手刹拉一下。
这些数字来自厂商公告,其中的评测设置、任务构成和成本口径,适合当候选模型的信号,不适合直接当你家业务的预算。尤其是 Agent,账单不只来自一轮回答,还来自检索、工具调用、重试、失败回滚和人工复核。一个输入便宜的模型,如果把同一件事重跑三遍,财务同学也不会因为它有 100 万上下文就露出笑容。
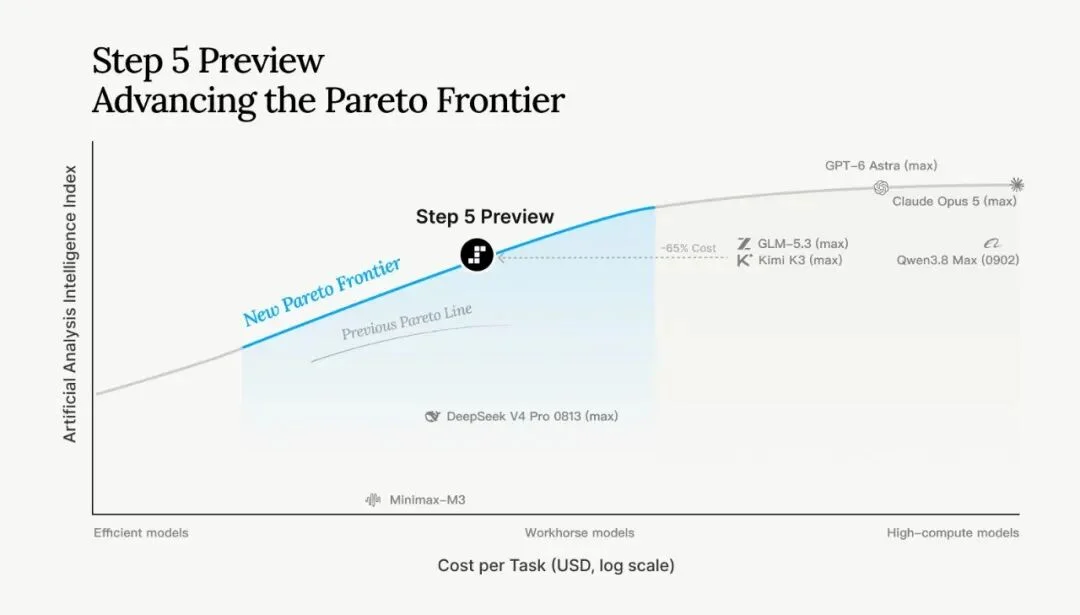
图里呈现的是阶跃引用的模型能力与单位任务成本关系。它能帮我们看见方向,但不能替代自己的任务验收。
我有时候觉得,长上下文是这一代 Agent 最容易被误解的东西。它像给工位换了一张超级长的桌子,资料、日志、截图都摊得开。桌子变长很爽,可你上次调通的命令、哪个文件刚改过、失败后该从哪里继续,不会自动因此变得可靠。
上下文容量解决的是装得下。持续交付还要解决记得住、接得上、验得过。
这恰好也是 Step 5 值得试的地方。它把长上下文、多轮工具调用和持续执行放到同一张考卷上,方向比只看一次回答对不对更接近真实工作。可它也把一个事实摆到了我们面前,模型能跑得更久以后,工程侧的欠账会更明显。
22 小时那件事,比排行榜更值得盯
官方展示里有一段很抓人。给 Step 5 Preview 一张 NVIDIA H100 和 24 小时,它从零开始优化一个 MLA GPU Kernel。模型会写代码、运行、测吞吐,再丢掉变慢的候选版本。公告称它约 22 小时后把峰值做到 508 TFLOPS,高于 Claude Opus 5 在同一展示中的 493 TFLOPS。
厉害了,但我不会把这句话翻译成 Step 5 已经能替代工程师守着任务跑一整天。
原因不复杂。长任务最难的部分,往往不在模型还能不能继续生成,而在任务有没有一条可以回到现场的轨迹。模型优化到第 17 小时时,工具超时了怎么办。缓存写了一半怎么办。编译器版本变了怎么办。它刚刚测到的好结果,是偶然波动,还是一个能复现的版本。
很多 Agent 看起来像在持续工作,实际更像记忆很长的临时工。聊天记录还在,真正能恢复的状态却没留下。等它在一个边角报错,就会把前面十几轮的劳动一起带进海里。很安静,也很贵。
官方主图把 Step 5 放在效率前沿的位置。对使用者来说,真正的前沿是失败后还能不能回到上一个可验收状态。
阶跃的另一个官方实验更接近这个问题。他们让 Step 5 Preview 自己决定如何调用数据标注 API、调整后训练数据,再按下游表现继续迭代。公告称,一个 Qwen3-30B-A3B 基础模型在 AIME24 上从 53.3 分提高到 60 分。
这段展示有意思的地方,不是 60 这个数字本身,而是模型在做一条循环。观察结果,提出下一步,调用外部能力,再回来看结果。这个循环一旦要进入生产,模型本身只占其中一段。其余的,是谁给它工具权限,谁记录它做过什么,谁在它跑偏时按下暂停。
有点子牛逼的模型,最怕配上一套全靠祈祷的执行器。这个组合在 demo 里很丝滑,在事故复盘里就容易变成一声叹息。
接入之前,我只看三张卡
如果团队想从今天开始试 Step 5,我不会先办一场模型选型辩论赛。先挑一个两三天内能结束的任务,把下面三张卡写清楚。没有这三张卡,模型越强,试点越像把油门焊在地板上。
任务卡,输入是什么,最终要交出哪个文件、代码改动或可验证结论。不要给它一团模糊的「帮我把项目弄好」。可以给它一个有测试集的 Bug、一段要迁移的页面,或者一份要追溯来源的报告。
任务卡要把成功从「它看起来忙了很久」换成一个可检查的产物。Step 5 官方展示的 ESP32 键盘和 GPU Kernel 都有这个特点,任务目标够具体,运行结果能测。模型在中间绕路没关系,交付物得能落在版本库、测试报告或设备状态上。
过程卡,每次工具调用后的关键状态放在哪里,失败时从哪一轮恢复,什么时候停止重试。
这张卡是给长任务留的救生艇。命令输出、文件差异、网页截图、外部 API 返回值,不能只藏在对话上下文里。把它们写进可追溯的日志或工件目录,再给每种失败设一个重试上限。模型不会因为上下文很长就自动学会适可而止,很多朋友应该都见过它在同一个报错前来回横跳,横跳得还挺认真。
验收卡,用原来的模型或人工流程做基线,只记成功交付的比例、耗时和总成本,再把人工复核时间一起算进去。
这张卡能挡住最常见的幻觉。官方公告中的 22 小时、508 TFLOPS 和八分之一成本,都可以作为你设计试验的参考,却不能替你的基线。你的代码库、工具权限、网络延迟和错误分布,跟演示环境不是一回事。把一次成功跑通当成胜利,太早了。看十次、二十次之后的成功率,再决定它配不配进入更关键的流程。
这三张卡没有多神秘,甚至有点土。可工程上最值钱的东西经常就这么土。Agent 不是聊天窗口里突然长出来的一个魔法员工,它是一个会调用外部世界的程序。外部世界有超时、有脏数据、有权限边界,还有周五傍晚的发布窗口。。。这些都不会被更大的上下文自动抹平。
真要把试点做得更稳一点,可以让 Step 5 和现在的流程并排跑一小批已经有答案的任务。不是把线上故障直接交出去,也不是看它能不能写出一段漂亮的解释,而是让它做同一批有测试、有人工结果的修复、迁移或资料核验。把每次中断的位置、恢复所花的轮数、人工接手的时间都记下来。十来个任务后再看,模型替你省下的是不是完整的一段工作,而不只是一段很会讲道理的过程。
这个办法不酷,甚至有点笨。可模型厂商的 demo 负责把天花板举高,团队自己的小样本负责确认脚下地板还在。两件事缺一件,跑得再久也容易踩空。
所以今天到底接不接
如果你的任务需要跨仓库读代码、反复运行测试、看图或文档,再通过几个固定工具完成明确交付,Step 5 Preview 值得放进候选池。它对长任务的强调,至少说明厂商在往正确的方向发力。官方还计划在 10 月 15 日释放权重,想做私有部署或更深定制的团队,也多了一个值得继续盯的时间点。
如果你现在连任务验收、日志留存和权限范围都还没写清楚,先别急着换模型。此时换成 Step 5,可能只是让同一套混乱跑得更久一点。这个判断听着有点扫兴,可模型能力越往前,越该把「它能做什么」和「我们允许它做到哪一步」分开。
我自己更愿意把今天的发布看成一次提醒。长任务 Agent 的竞争,已经从谁能在终端里写出第一段代码,走到谁能把几十轮操作留成一条可恢复、可审计、可验收的轨迹。
100 万 Token 是一张很长的桌子。别让团队把救生艇落在桌子底下。
你手里的 Agent 最近一次失败,是答错了,还是在第十几轮工具调用后再也找不回现场?