
日常改 Bug,Sonnet 5.5 值得接班吗
新模型逼近旗舰的分数很诱人,但官方脚注里还有一个越改越扣分的案例。哪些 Bug 适合交给 Sonnet,哪些要留给 Opus,附一张可复制的任务卡。
一个表单提交失败的 Bug,你已经有复现步骤、报错堆栈,也知道正常结果该长什么样。打开 Claude,模型列表里多了 Sonnet 5.5。
这种活,还要继续交给 Opus 吗?
我的判断是,复现和验收都清楚的日常修复,Sonnet 5.5 已经值得拿来试着接班。至于那些连问题出在哪一层都没搞清楚、牵涉业务取舍的任务,我会继续把 Opus 留在候选里。
这篇没有 Sonnet 5.5 的项目实测,依据是官方发布材料。下面的任务卡和分工建议是我的工程判断,可以拿去试,但不能当成已经验证过的提效承诺。
9 月 28 日,Anthropic 正式发布 Sonnet 5.5。它对产品定位的区分挺直接,Sonnet 擅长范围明确的日常任务,Opus 更适合需要持续判断的复杂工作。
这句话比「又一个模型登顶」更有用。改一个明确的 Bug,和替一个项目找出真正的问题,虽然都在编辑器里发生,交付难度差得远。
好家伙,模型列表越来越长,分给模型的活倒是得越写越清楚。
先看支撑「值得试」的证据。官方列出的 CursorBench 4.0 评测取材于真实编码会话,Sonnet 5、Sonnet 5.5、Opus 5.5 的得分分别是 34.1%、55.5%、57.8%。这组数字说明新 Sonnet 在这套评测里进步明显,和旗舰的分差也不大。
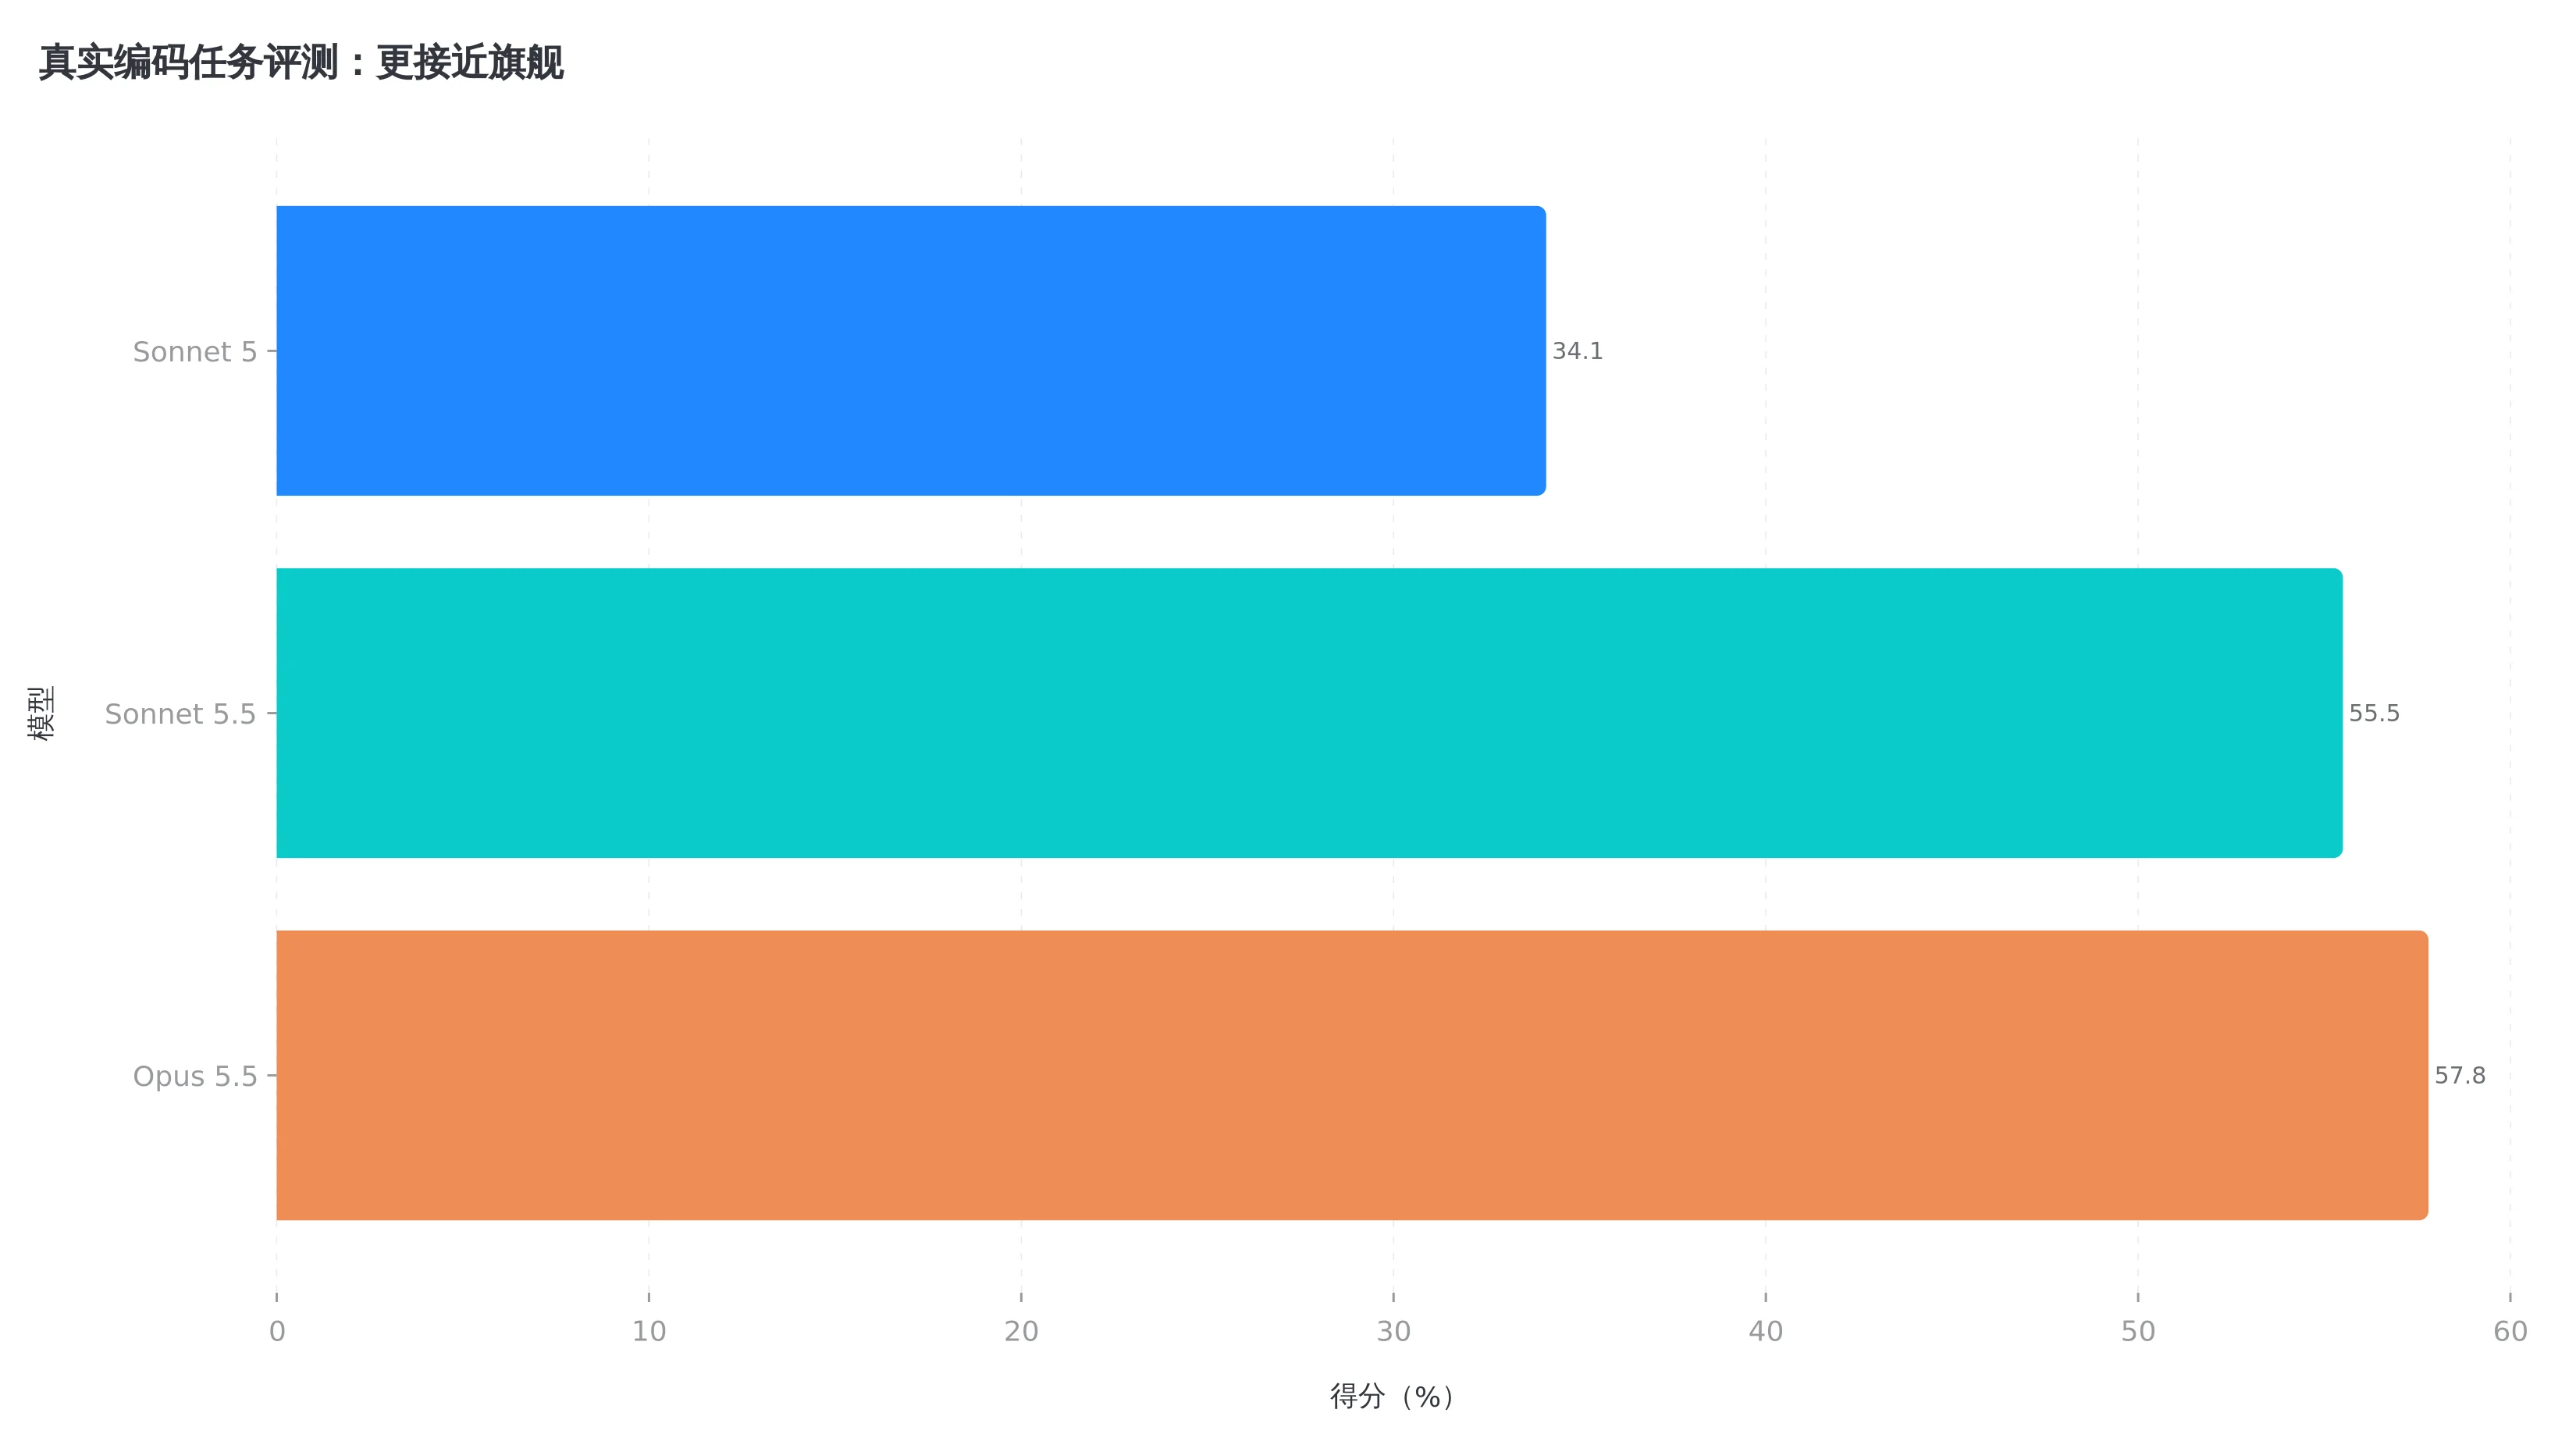
但表单 Bug 的代码仓库、历史包袱、测试覆盖率,都不会自动出现在这张图里。我的用法会很朴素,拿它当挑选试用对象的理由,真正决定接不接班,还得回到那份代码差异。
你可以想象这样一个示例。用户输入合法邮箱,点击提交,页面却显示校验失败。需求方给了期望行为,日志能定位到校验函数,仓库里有对应测试。
模型要做的事就相对集中。读相关实现,复现错误,调整条件,补上回归测试,再说明改了哪里。你不需要它重新设计注册流程,也不需要它对整个前端架构发表看法。
这种任务适合试着交给 Sonnet,因为你有办法判断它交回来的东西对不对。模型再会解释,也得让同一份输入经过修复后产生正确输出。
换一个问题,用户说「注册转化最近变差了,帮我优化一下」。
这就麻烦了。是校验拦得太严,接口变慢,移动端布局挡住按钮,还是新增的验证步骤让人放弃?就算模型读完代码,也可能需要埋点、产品目标和真实用户反馈才能决定改什么。
把这种任务扔给便宜模型,再靠反复催它「继续想」,很可能只是在延长一段没有方向的工作。此时我更愿意让判断能力更强的模型协助调查,或者让人把缺失信息补齐。换回 Opus 也不会凭空长出你没提供的数据。
所以,任务大小看文件数不太准。只改一行配置,也可能牵动整个登录系统。跨几个文件补同一个回归测试,反而可能边界很清楚。
真正的分界是,你现在能不能写出「做到什么就算完成」。
这也是发布页里一个脚注吸引我的原因。
在 FrontierCode 1.1 的主集上,Sonnet 5.5 的 Xhigh 档得分是 52.1%,Max 档是 46.2%。这里的 effort,可以理解为模型投入推理的档位。开得更高,通常会花更多精力分析和检查,但它不承诺每类任务都更好。
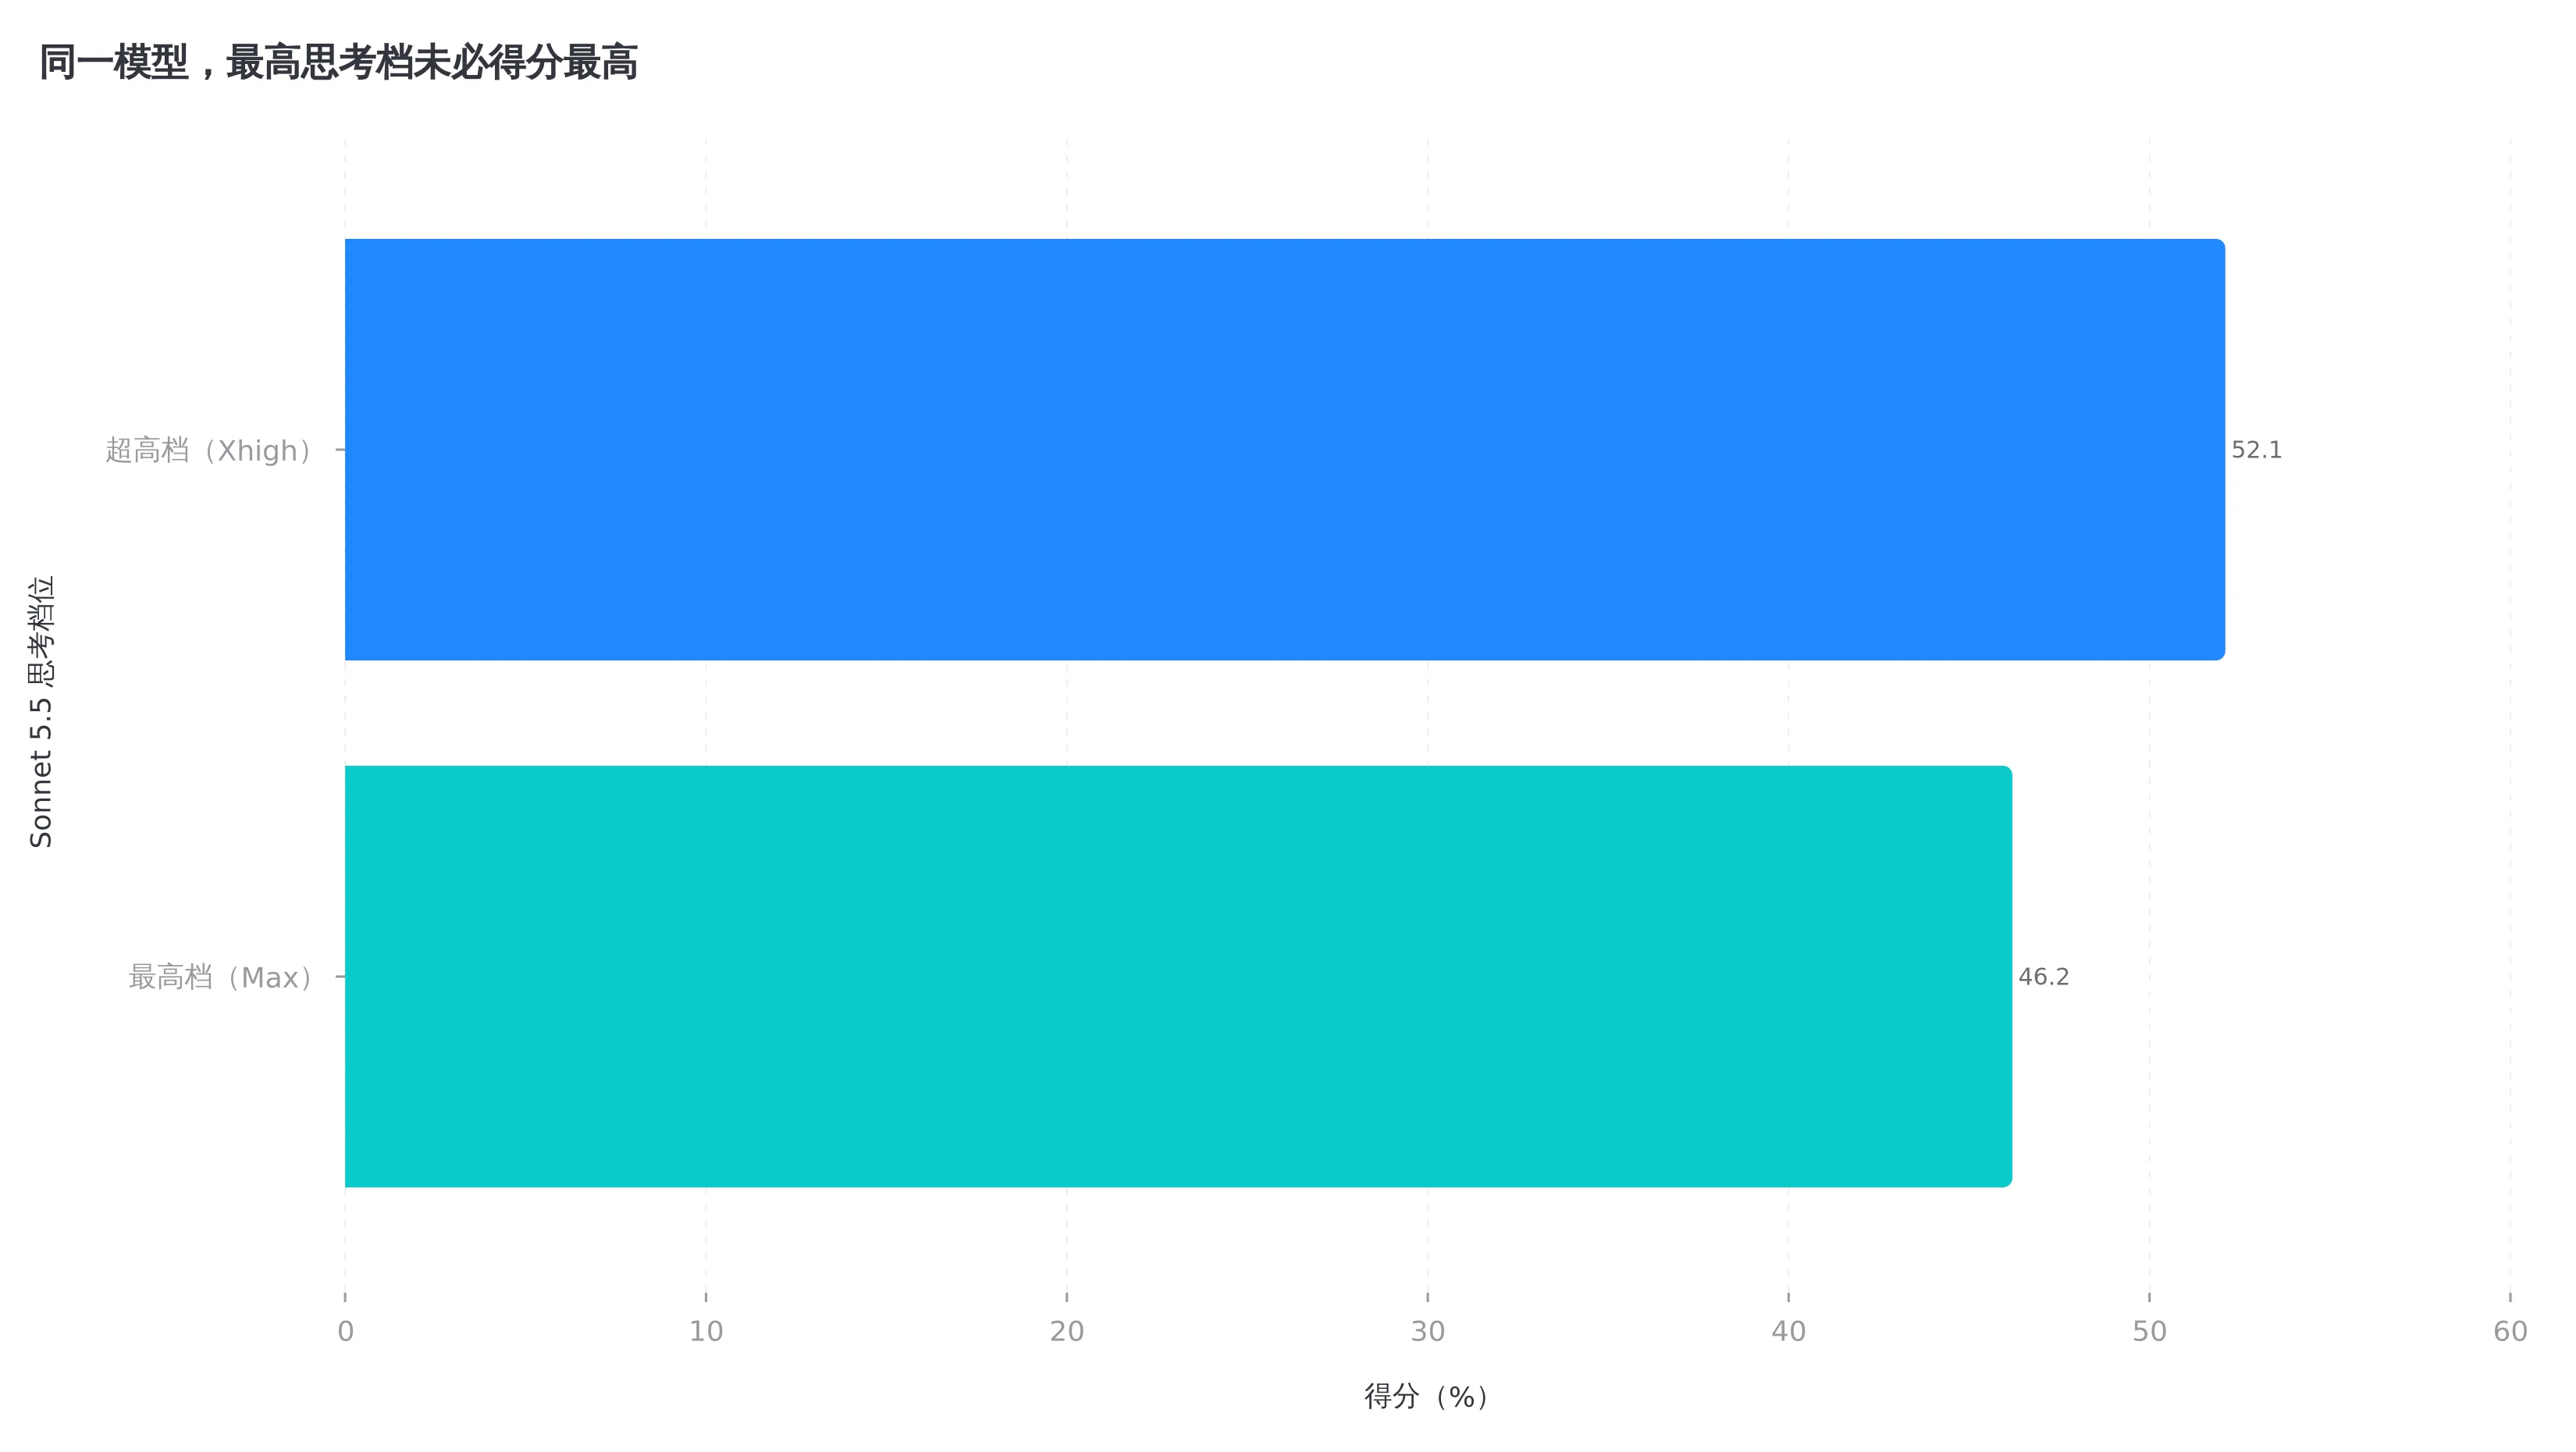
官方脚注 2 解释,这套评测会惩罚超出任务范围的修改。Max 档更常发起多代理代码审查,在 Cognition 检查的两个案例里,这引出了超时或额外编辑,导致丢分。
注意,不能由此推导成「Max 一定更差」,更不能推导成「多代理审查没用」。证据只到这几个案例和这套规则。
可它戳中了日常开发里很熟悉的尴尬。你让 AI 修一个判断条件,它顺便整理命名、抽一层公共函数,再调整几个不相关的测试。每一项单独看都挺合理,合在一起,你得重新审一大片代码。
厉害了,Bug 还没验完,审查工作先扩容了。
我不想把这种行为一概叫作能力差。模型可能确实看到了值得改的东西。只是发布窗口、兼容要求和团队分工,都藏在任务外面,它未必知道。
把额外发现留下,把额外修改拦住,往往比再加一句「认真一点」更有帮助。
回到开头的表单 Bug。我会把任务写成下面这样。这是自行整理的中文模板,不是官方提示词;方括号里的内容需要换成你项目里真实的信息。
本次只修复一个问题。

复现条件
[输入、操作步骤、实际报错]

期望结果
[相同输入应得到的可观察结果]

已知线索
[相关路径、日志、已有测试]

修改边界
先检查相关实现,再提出最小修复。
不做无关重构,不升级依赖,不改公共接口。
发现额外问题,写进单独建议,不直接修改。
需要超出边界时,说明原因,等我确认。

验收方式
[本项目真实可运行的测试命令]
说明修复前后的差异与实际运行结果。
无法运行时如实说明,不把推测写成通过。

交付内容
修改文件、原因、验证结果、剩余不确定项。
满足验收后停止,不继续寻找其他优化。
模板最有用的地方,是把「你帮我搞定」变成能核对的约定。它也不会自动形成权限隔离,该限制的写入权限和执行环境仍要靠工具配置。
比如你写了「不改公共接口」,模型发现不改接口就修不了,这次工作的合理结果可以是停下来报告。它没有提交代码,不代表没有推进。至少把原本含糊的需求冲突暴露出来了。
反过来,如果测试命令本身坏了,它应该告诉你依赖缺失还是环境不对,而不是为了交差顺手改掉测试配置。遇到这种情况,我会把环境修复另开成一个任务,避免最后不知道到底验证了哪一件事。
说到这儿,有人会觉得,写这些还不如自己改。
这个反应很正常。一个肉眼就能确定的小错,手改可能更快。我也不会为了用新模型,把两分钟的修改变成半小时的任务编排。
值得写清楚的,是那些你准备反复交出去的活。今天的模板保存下来,下次替换复现条件、路径和验收命令就能继续用。它帮你省掉的,是每次把 AI 的工作拉回正题那几轮对话。
如果已经在用 Opus,试 Sonnet 时也不用一口气改掉所有默认设置。
我会挑几条最近已经解决、又能在隔离分支里重放的 Bug。保留修复前版本和验收标准,用同一份任务描述分别跑,暂时别把已知答案交给模型。这是建议的试验方法,这篇尚未执行。
看结果时,除了测试是否通过,再读一次改动范围。有没有删除本来应该保留的断言?有没有把错误吞掉,让页面表面正常?有没有为了一个边界条件,改了整套公共逻辑?
测试全绿值得高兴,但测试能覆盖多少东西,仍由你的仓库决定。对登录、支付、数据删除等后果较重的代码,人工审查要保留,不能因为这次模型回答很自信就省掉。
还有一种情况得单独拿出来说,仓库压根没有能用的回归测试。别急着让模型同时定义正确答案、写实现、再证明自己正确,那样很容易从头到尾只验证了同一个误解。
以这个表单为例,人可以先确定几组输入,哪些应通过,哪些必须拒绝,旧用户的历史数据怎么处理。涉及业务规则的答案由人确认,再让模型把它们变成测试。若产品自己还没决定空值是否合法,换成任何旗舰都只能替你猜。
重放旧 Bug 时,也要记录代码版本和环境。一个模型跑在修复前版本,另一个跑在已经包含修复的分支,后面的成功率比较就没意义了。已有修改应当保留,各自用独立分支或副本,别让两个模型覆盖彼此的工作。
交付时最好保留原始测试输出和代码差异。过几天发现回归问题,才能追问当时究竟没测到,还是测到了却忽略了。只剩一句「全部通过」的聊天记录,很难帮你还原现场。
然后记下你介入了什么。是补了它不知道的业务信息,纠正了错误定位,还是删掉了它热心添加的重构?这几种返工,指向的解决办法并不相同。
缺资料就补资料,范围总跑偏就收紧任务;线索完整仍反复判断错,再考虑换模型。否则每次失败都归因于「模型不够强」,你会一直换模型,却一直重复同一种沟通。
我会给接班留一个很具体的条件,同类任务里,它能稳定交付范围内的修复,而且需要我返工的部分可以接受。样本少时只能算试用观察,别急着写成全团队结论。
如果复杂调查仍要靠 Opus,就把它留给复杂调查。日常修复里 Sonnet 没省下多少核对时间,也完全可以继续用原来的组合。模型厂商完成了一次发布,你的项目没有必须迁移的义务。
新 Sonnet 值得试的地方,是边界清楚的活终于多了一个更强的候选。 把任务分清,再看实际交付,远比盯着一个总分替整个工作流选冠军靠谱。
你平时让 AI 改 Bug,最常返工的是修错地方,还是它顺手改了太多?