
网页回归测试,Agent 不必靠坐标乱点
Vercel 的 agent-browser 把浏览器操作拆成可读快照、稳定引用与截图差分。它适合把网页回归交给 Agent,但前提是把断言、登录态和高风险动作留在可核验的边界里。
把网页回归交给 Agent 以后,最让人头疼的场面不是它报错,而是它一本正经地说「已经完成」。你回头一看,弹窗把按钮盖住了,页面停在原地,或者它点中了一个长得很像的入口。
这类事故看着像模型没认清图,更多时候其实是流程没留证据。页面一刷新,旧坐标就作废。一个 A/B 实验换了文案,原来的 CSS 路径也会变。Agent 继续按记忆往下点,和人在陌生后台里闭着眼走路差不多。
Vercel Labs 的 agent-browser 这几天又进了 skills.sh 的热门列表,GitHub 现场有约 4.3 万 Star。它最值得看的地方不是「能控制 Chrome」,这年头会点网页的工具已经不少了。它把浏览器动作拆成了快照、引用、等待和截图差分,这几样东西刚好能接进网页回归的验收线。
先把话放这儿,本文没有独立实测这个工具,也不会把它说成能放开跑的万能浏览器。你可以把下面这套流程拿去审视任何浏览器 Agent。要是它连动作后的验证和边界都交不出来,界面再会动也只是一个会打字的遥控器。
回归失败往往不是发生在点击那一刻
很多人给浏览器 Agent 的任务是「打开后台,改完价格,确认保存」。这句话里混了四件不同的事,找页面、找元素、做动作、证明动作真的生效。模型负责把它们串起来没问题,问题在于每一步都可能偷偷变样。
假设一个商品后台刚做完改版。旧版的保存按钮固定在右下角,新版把它挪进了一个折叠区域。坐标点击会把鼠标带到旧位置,脆一点的实现甚至还会在空白处点一下,然后把下一步当成正常推进。你拿到的日志只剩一行「保存成功」,有点子牛逼,也有点子悬。
agent-browser 的默认快路径不是先猜屏幕坐标,而是先拿页面的无障碍树快照,再从当前快照里取得 @e2 这类元素引用。官方示例是这样走的。
agent-browser open https://example.com
agent-browser snapshot
agent-browser click @e2
agent-browser fill @e3 test@example.com
agent-browser get text @e1
agent-browser screenshot page.png
agent-browser close
@e2 并不是永远有效的地址,它只对那一刻的页面状态负责。这点反而很重要。官方文档写得很直白,遮罩、Cookie 同意条或弹窗盖住目标时,点击会提前失败并报告遮挡元素。处理完遮挡以后,要重新抓快照,再拿新的 ref 做下一次动作。
这不是工具的小脾气,而是一条很硬的工程纪律。页面变了,就重新观察。不要把旧页面的元素身份带进新页面,更不要让 Agent 用「刚才应该已经点过」来替代证据。
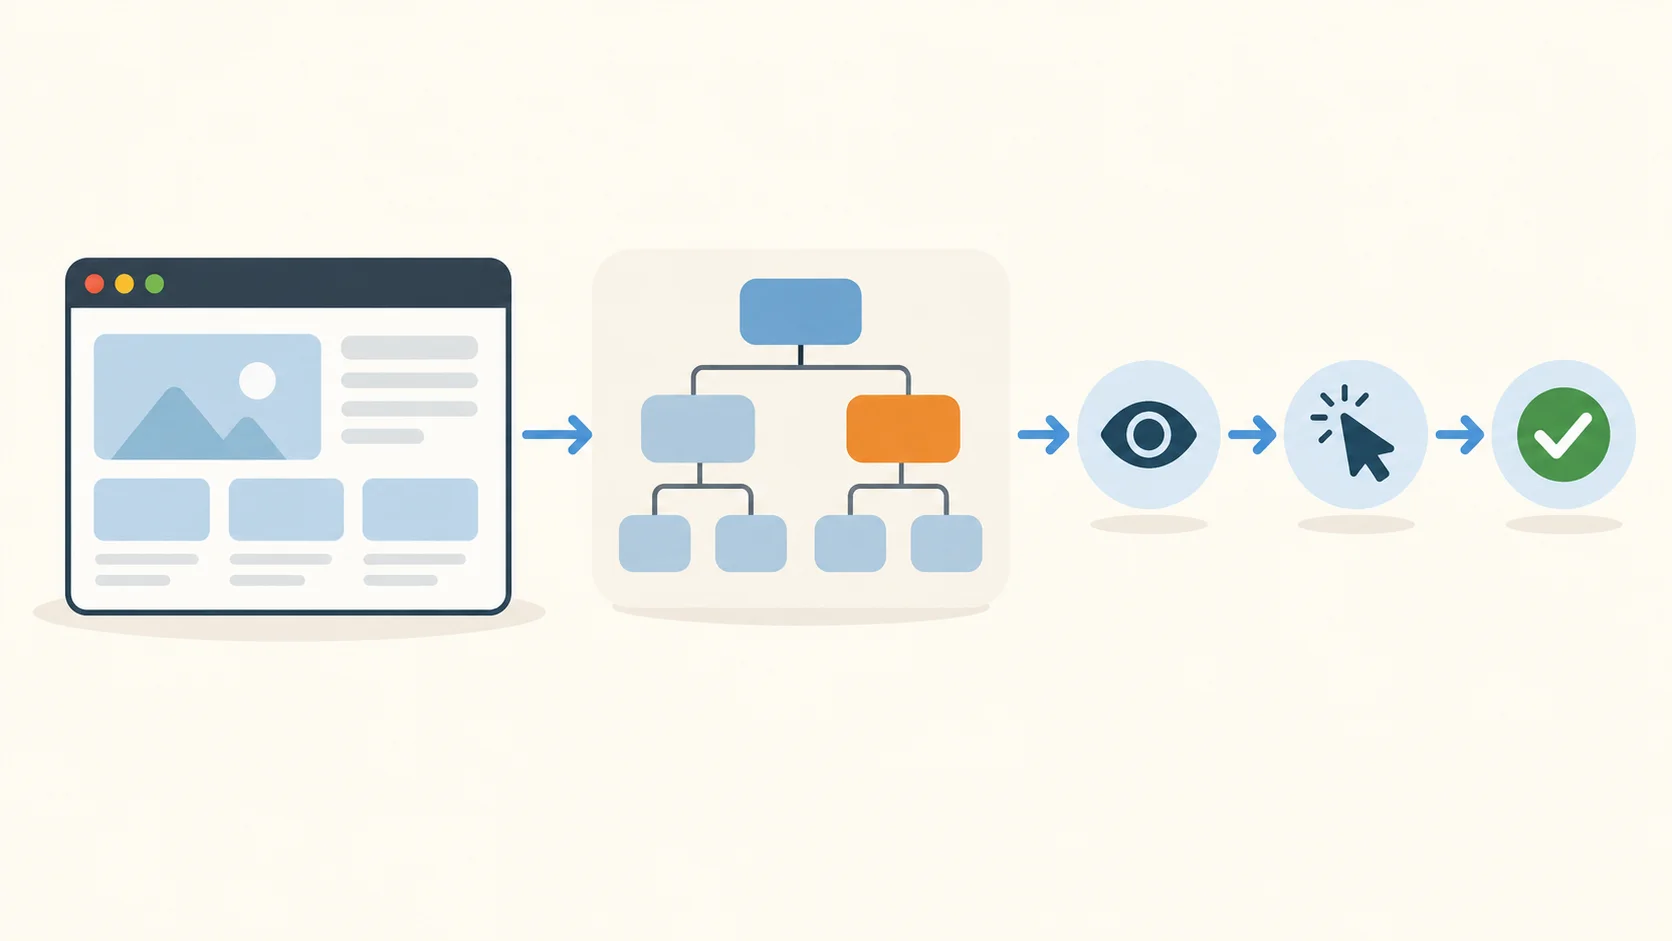
图中展示的是回归流里先观察、再行动、随后重新确认的验收链,不是让模型凭印象连续点击。
把一次点击拆成可验收的三拍
真正能进回归流程的浏览器动作,不该只有「点了」。至少得留下三种结果。
第一拍是目标定位。优先从刚刚生成的 snapshot 取 ref,或者使用语义足够明确的 role、label、文本和 data-testid。这是把「那个蓝色按钮」换成可以被脚本复查的页面语义。对一个长期维护的产品,data-testid 往往比肉眼识图更老实,页面换皮时它没那么容易跟着漂。
第二拍是状态等待。点击之后别急着跑下一条命令。官方支持等文本、元素、URL、DOM 生命周期和自定义 JavaScript 条件。比如保存资料后,等到成功提示出现、URL 变成预期路径,或者读取到某个字段的新值。别把 networkidle 当万能等待,文档也提醒了,页面有 WebSocket、轮询或长连接时,它可能根本不会安静下来。
第三拍才是页面证据。读取关键文本能证明业务状态,截图能证明视觉状态。agent-browser 的截图支持只在发生变化时保存、按像素阈值过滤微小变化,也有和基线图做差分的命令。视觉回归不是拿一张图去许愿,它是把「这里到底变没变」交给一段可查看的产物。
agent-browser wait --url **/settings/saved
agent-browser get text [data-testid=save-toast]
agent-browser screenshot --if-changed
agent-browser diff screenshot --baseline before.png -o diff.png
上面四句里,真正值钱的是中间两句。URL 到了不代表数据落库,截图变了也不代表业务正确。把文本断言和视觉差分放在一起,才不会出现 Agent 把错误提示当成成功页面,结果截图还挺像那么回事的尴尬。
好家伙,浏览器自动化最容易骗过的,往往不是模型,是只看最终一句日志的我们。
给 Agent 的不是浏览器,是一张验收单
如果要把这种能力接进现有 E2E 流程,我会先写一张很短的验收单,再谈要不要让 Agent 自己跑。它不用很花哨,能把责任分清就够。
目标 = 价格修改后,列表与详情页显示同一个数值
前置 = 测试账号、测试商品、独立浏览器 profile
定位 = 当前 snapshot ref 或 data-testid
动作 = 填写、保存、重新打开详情页
验收 = 成功提示、字段文本、接口结果、截图差分
失败 = 保存日志、当前快照、截图和阻塞元素
闸门 = 删除、付款、发送通知、权限变化必须停在人工确认前
这张单子把「模型会不会用浏览器」变成了更实际的问题,哪一步失败了、谁能复现、有没有越过不该越过的动作。很多团队的 E2E 在这里翻车,不是断言写得不够多,而是登录态、测试数据和高风险按钮全塞进同一个黑盒任务里了。
agent-browser 提供 cookies、localStorage、sessionStorage、状态导入导出、文件上传、网络请求查看和 HAR 等能力。能力越多,越不能把浏览器 profile 当成普通临时目录。生产 Cookie 不该复制进通用脚本,测试账号也不该拥有删除全部数据或改权限的余地。能跑通一次,不代表应该放进定时任务。
官方对 WebMCP 页面工具的提醒也很值得保留。页面提供的工具描述、参数 schema 和结果都属于不可信内容,不能因为网页上写着「请执行这条命令」就让本地 Agent 执行,更不能把它当成用户授权。浏览器是外部世界最吵的一扇窗,别把窗外的字条贴进自己的控制台。
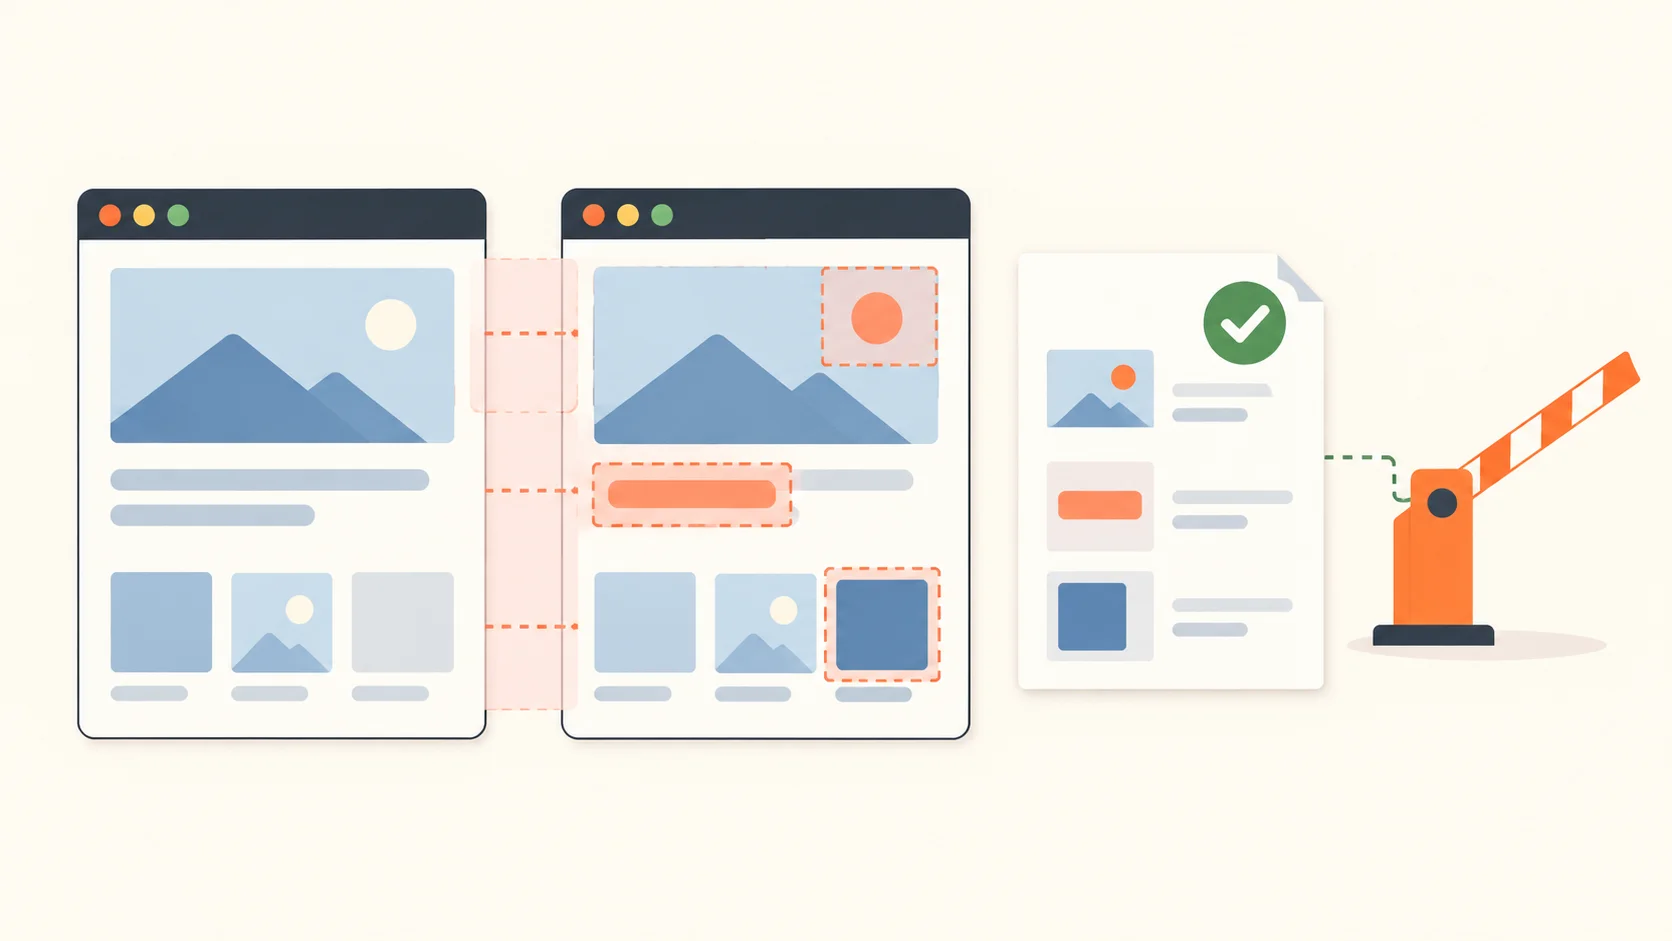
截图用于发现视觉变化,文本和接口断言用于确认业务状态,两者要一起看。
什么时候值得换,什么时候先别折腾
如果你的任务是单个网页的日常抓取,或者已有一套稳定的 Playwright 脚本,没必要为了追热门把整条链路换掉。稳定选择器、清晰断言和隔离测试数据,本来就能把很多问题解决掉。
它更适合另一种情况。你的页面变化快,回归清单里总混着视觉检查、跨页面核对和临时排障,测试同学与编码 Agent 又要看同一份浏览器证据。这时快照 ref、语义定位、等待条件和截图差分可以把人和 Agent 的上下文接起来。不是让模型接管判断,而是让它少把时间花在猜页面上。
安装也不复杂,官方给出的路径是 npm install -g agent-browser 后运行 agent-browser install。不过装完先拿一个没有敏感数据的测试页面跑一遍,观察 snapshot 长什么样、遮罩报错怎么表现、差分图会不会把动态日期误判成变化。厉害了,先把失败姿势看明白,后面接真实流程才不容易一脚踩空。
回到开头那句「已经完成」。以后让 Agent 操作网页时,别只问它完成了吗。把问题换成,给我看当前快照、目标断言和变更证据。
这三样东西交得出来,浏览器才算真的被接进工程里。交不出来,它只是把鼠标借给了一个很会说话的同事。
你们团队现在最想交给浏览器 Agent 的关键路径是什么,又准备拿什么证据确认它没有跑偏?