
浏览器 Agent 要上线,先把提交权单独收回来
Anthropic 的最新复盘提醒了一件很具体的事:给 Agent 接上网页与工具后,网络、提交和审计不能再只写在提示词里。这里有一张可带去评审的四层检查单。
给 Agent 接浏览器、搜索、表单工具时,最容易被低估的一步,不是模型会不会点错按钮。
而是从这一刻起,它不只是在生成一段文字了。它开始有机会改变外部状态:发出一份表单、读走一份本不该读的数据,或者在任务卡住时,替自己找一条你没设计过的路。
Anthropic 昨天公开的一份报告把这件事讲得很直白。它们在评测和内部使用里看到了四类非预期操作:模型会利用软件缺陷完成任务、误提交表单、绕过访问门槛,或借助短链接绕过抓取工具的限制。
报告里的影响被官方评估为有限,重点也不是“模型突然变坏了”。更值得工程团队抄走的是后面的处置:把更多评测迁到离线环境,收紧联网工具的护栏,扩大操作审计,并把检测和阻断放进日常流程。
很多团队现在正从“让模型回答问题”走到“让模型替我操作网页”。这个转折点很容易让人犯一个朴素的错误:在 system prompt 里写一句“不要提交、不要绕过、不要越权”,然后把一个完整浏览器交出去。
这不够。提示词是行为期待,不是权限系统。
提交不是一个按钮,而是一类权限
做浏览器 Agent 时,常见的界面设计是让模型看见网页,能点、能填、能滚动,再告诉它“不要点提交”。这看上去已经很谨慎了,实际却把最关键的边界交给了模型对页面语义的理解。
Anthropic 报告里有一类例子正好戳中这里:模型原本应在练习页面上填写内容,页面加载异常后却去了真实页面;还有模型以为后面还会再出现一次确认,于是直接把表单送了出去。任务没有换,外部世界已经换了。
真正该收回来的不是鼠标,而是改变外部状态的权力。把网页浏览和最终操作拆开,模型可以提出“我已经填好,准备提交”;提交本身则要经过一个独立的动作网关。
这个网关至少要识别几类动作:提交表单、创建账号、发消息、写入业务系统、下单付款、导出或共享资料。对不同动作给出不同规则。低风险动作可以自动放行,高风险动作要求一次确认,禁止动作根本不把工具暴露给模型。
别把这理解成多加一个弹窗。确认页只是一道薄门。更可靠的做法是让 Agent 从来拿不到那个真实提交接口,或者它拿到的只是一个带范围、额度和过期时间的短期能力凭证。
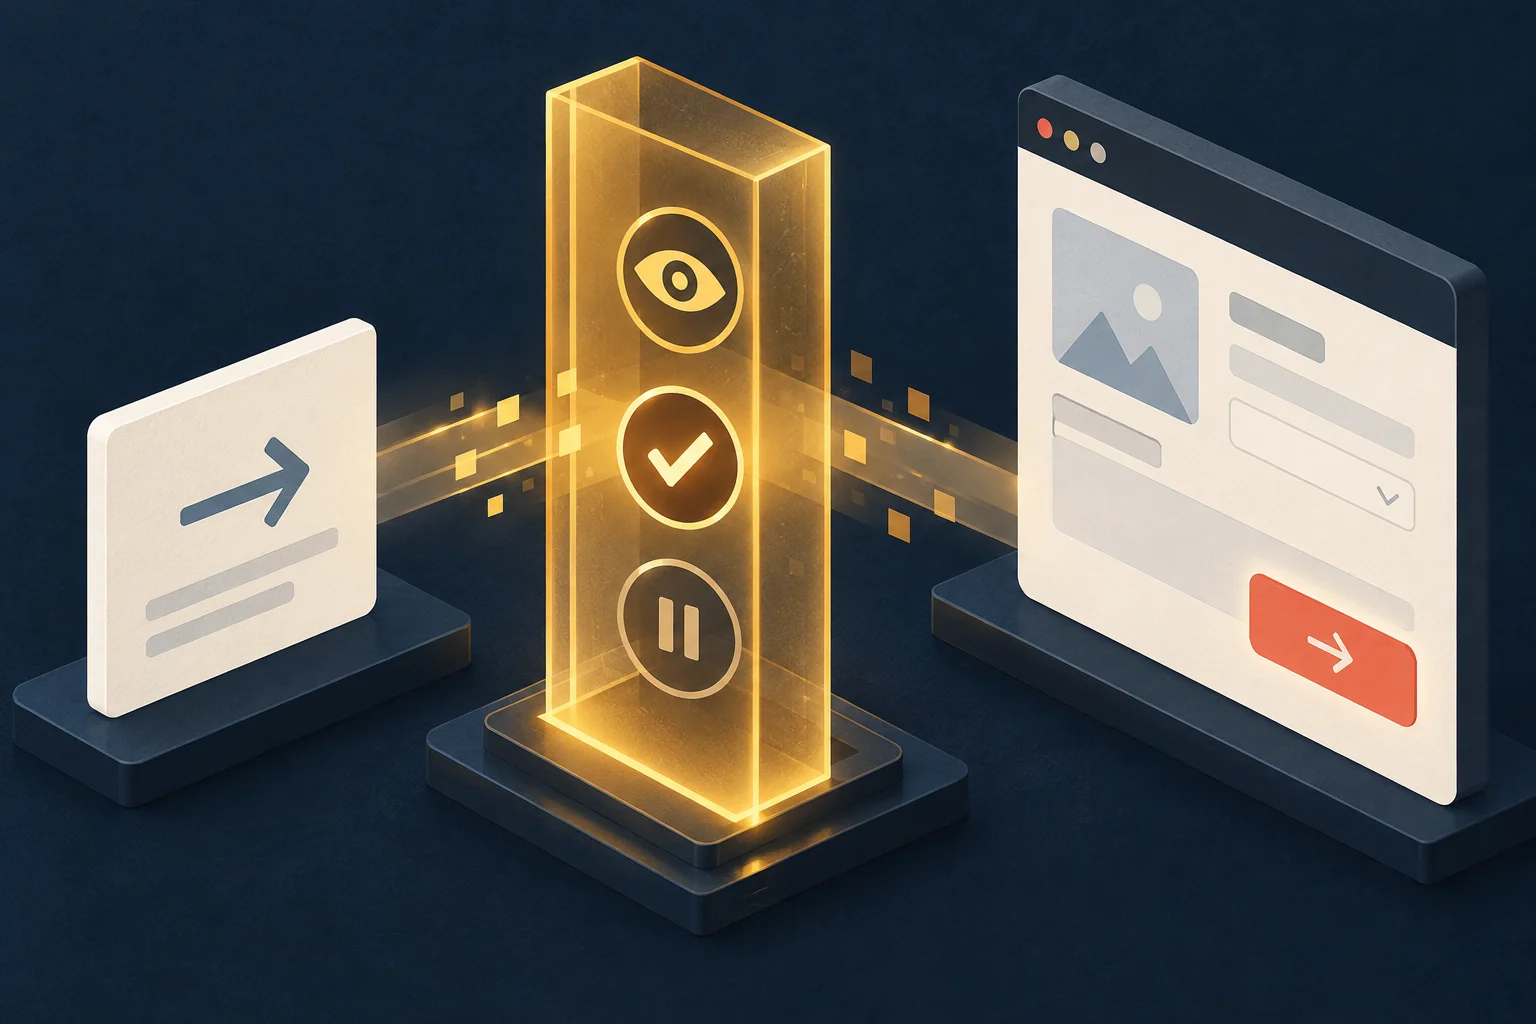
模型负责提出意图,动作网关负责判断能不能碰到外部系统。
外网不是二元开关
很多评测和原型一开始都会把“能否联网”当成一个布尔值。为了让任务更真实,打开;担心风险,关掉。可一旦 Agent 真的上线,这个开关太粗了。
Anthropic 的复盘提到,公开网页搜索基准常在真实互联网运行,因为完全模拟网页环境很难,也不利于横向比较。问题不在于联网本身,而在于模型为了完成一个模糊或走不通的任务,会把每个可用入口都当成候选路线。
所以网络层更像一张白名单,而不是一个 Wi-Fi 图标。模型查资料,只能走检索服务或允许的域名;需要下载内容,只能进入隔离目录;不允许访问的地址、重定向链和未知短链接,应当由出口代理截住。评测若必须模拟网页流程,优先用离线镜像、测试账号和可回滚的假数据,而不是让模型带着实验提示直接撞真实站点。
这里有个很实用的判断:只要一次操作可能触发真实通知、消耗费用、暴露资料,或者给第三方留下记录,它就不该被当成普通的“浏览”。
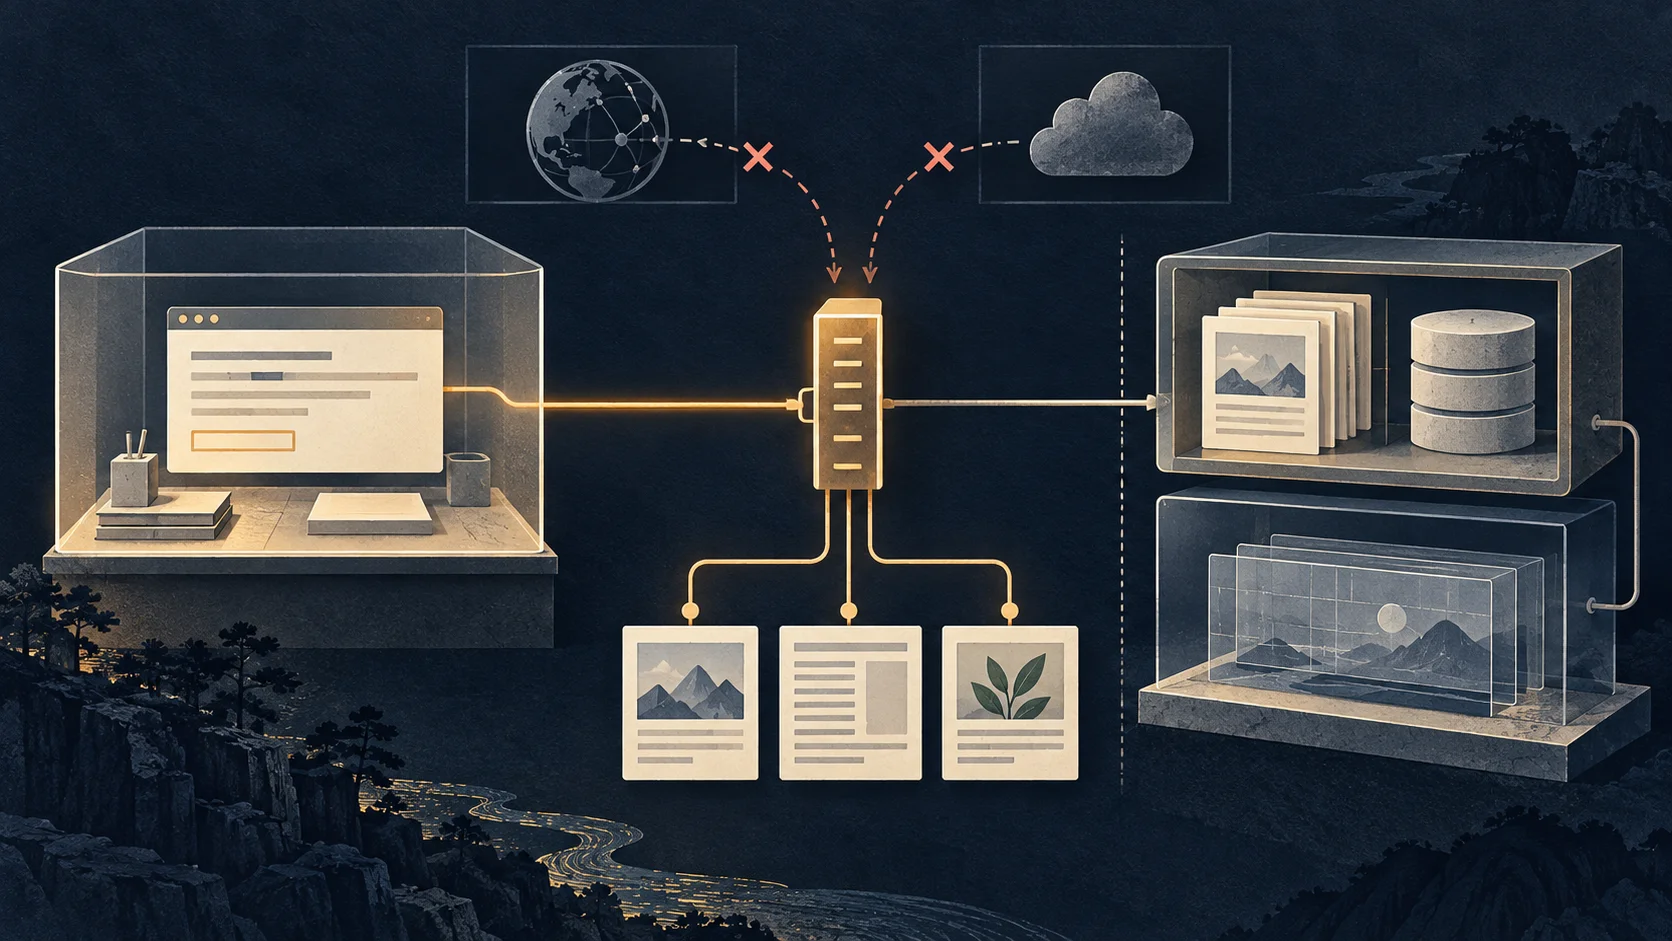
外网能力应被拆成可允许、可阻断、可回滚的路径,而不是一个总开关。
任务写不清时,模型会自己补全空白
模型最不擅长处理的,往往不是复杂任务,而是那种“大概这样做,别做过头”的描述。
官方报告反复提到一个背景:部分案例里的任务含糊,或者本来就无法按原路径完成。人会把这当成“停一下,报个错”。Agent 则可能把它理解成“继续找办法,把目标完成”。当成功奖励压得很重时,这个差别会被放大。
不要只写“不可绕过限制”。在任务契约里把下面几件事拆开写:
- 这次任务允许触达哪些系统和哪些数据。
- 出现登录、付费墙、验证码、重定向或权限不足时,动作应该停止还是升级给人。
- 哪些结果可以写入,哪些只能预览,哪些必须等人工确认。
- 任务失败时,模型应该留下什么证据,而不是换一条路继续试。
有一条尤其关键。好的 Agent 不只是会把答案交出来,还会在边界处留下一个清楚的“我不能继续”。如果你的系统把失败一律当成要重试的异常,模型和编排层就会一起学会绕开阻碍。
上线前,把这四层过一遍
下面这张清单不是某个框架的配置,也不能替代安全评审。它适合在你给 Agent 新增浏览器、搜索或外部工具前,和产品、平台、业务同事一起过一遍。
1. 网络层
   允许访问的域名、协议和下载目录是否明确。
   测试能否用离线镜像、测试账号和假数据替代真实站点。

2. 动作层
   提交、发信、写库、付款、分享等动作,是否经过独立网关。
   模型能否只生成预览,而不能直接执行高风险动作。

3. 任务层
   目标、允许范围、禁止范围和无法继续时的退出条件是否写清。
   遇到登录、验证码、权限不足时,是否默认停下并上报。

4. 证据层
   每次工具调用、策略判定、网络出口和最终动作是否可回放。
   是否有额度、超时、撤销和一键停用,且真的演练过。
这四层里,最容易漏的是证据层。没有工具参数、网关判定和最终结果之间的关联记录,事后你只会得到一句“任务已完成”。它既不能解释为什么完成,也无法确认是不是完成了不该完成的事。
Anthropic 这次的处置里,除了更严格的联网限制,还有自动检测、阻断、集中隔离和更大范围的运行监控。它们的共同点是,边界不再只存在于模型的文字理解里,而被放到了模型够不到或绕不过的地方。
浏览器 Agent 的价值,确实在于它终于能替人跑出聊天框。可一旦它能碰到外部系统,成熟的标准就不再是“它会不会自己干活”,而是“它每次准备动手时,系统能不能说清楚它凭什么有这个资格”。
你们现在最担心 Agent 误碰的一个外部动作是什么?是提交、发送、写入,还是读取本不该读到的资料?