
模型能力还在涨,AI 产品先撞上的可能是供电和推理成本
模型更便宜不等于 AI 项目更便宜。读完这篇,你能把上线评审从模型单价改成正确交付、重试成本和可用容量三笔账。
如果你正准备让 Agent 接手一段真实工作,譬如核对一批单据、改一段代码、在内部系统里找资料再生成报告,最难回答的问题经常不是选哪家模型。
而是你什么时候敢对交付作承诺。
能跑出一个很像样的演示,和能在周一上午的高峰把一百个任务都按质量交出去,中间隔着模型调用、工具重试、人工复核、队列排队,还有你其实摸不到的云端容量。
模型很强时,这条缝反而更容易被忽略。
刚发布的 State of AI Report 2026 给了一个很有意思的信号。
报告引用 Epoch AI 的估算,达到固定表现所需的最低推理成本,从 2023 年起平均每季度下降 47%,大约一年降 13 倍。
看上去像是给所有 AI 产品开了一张更便宜的账单。
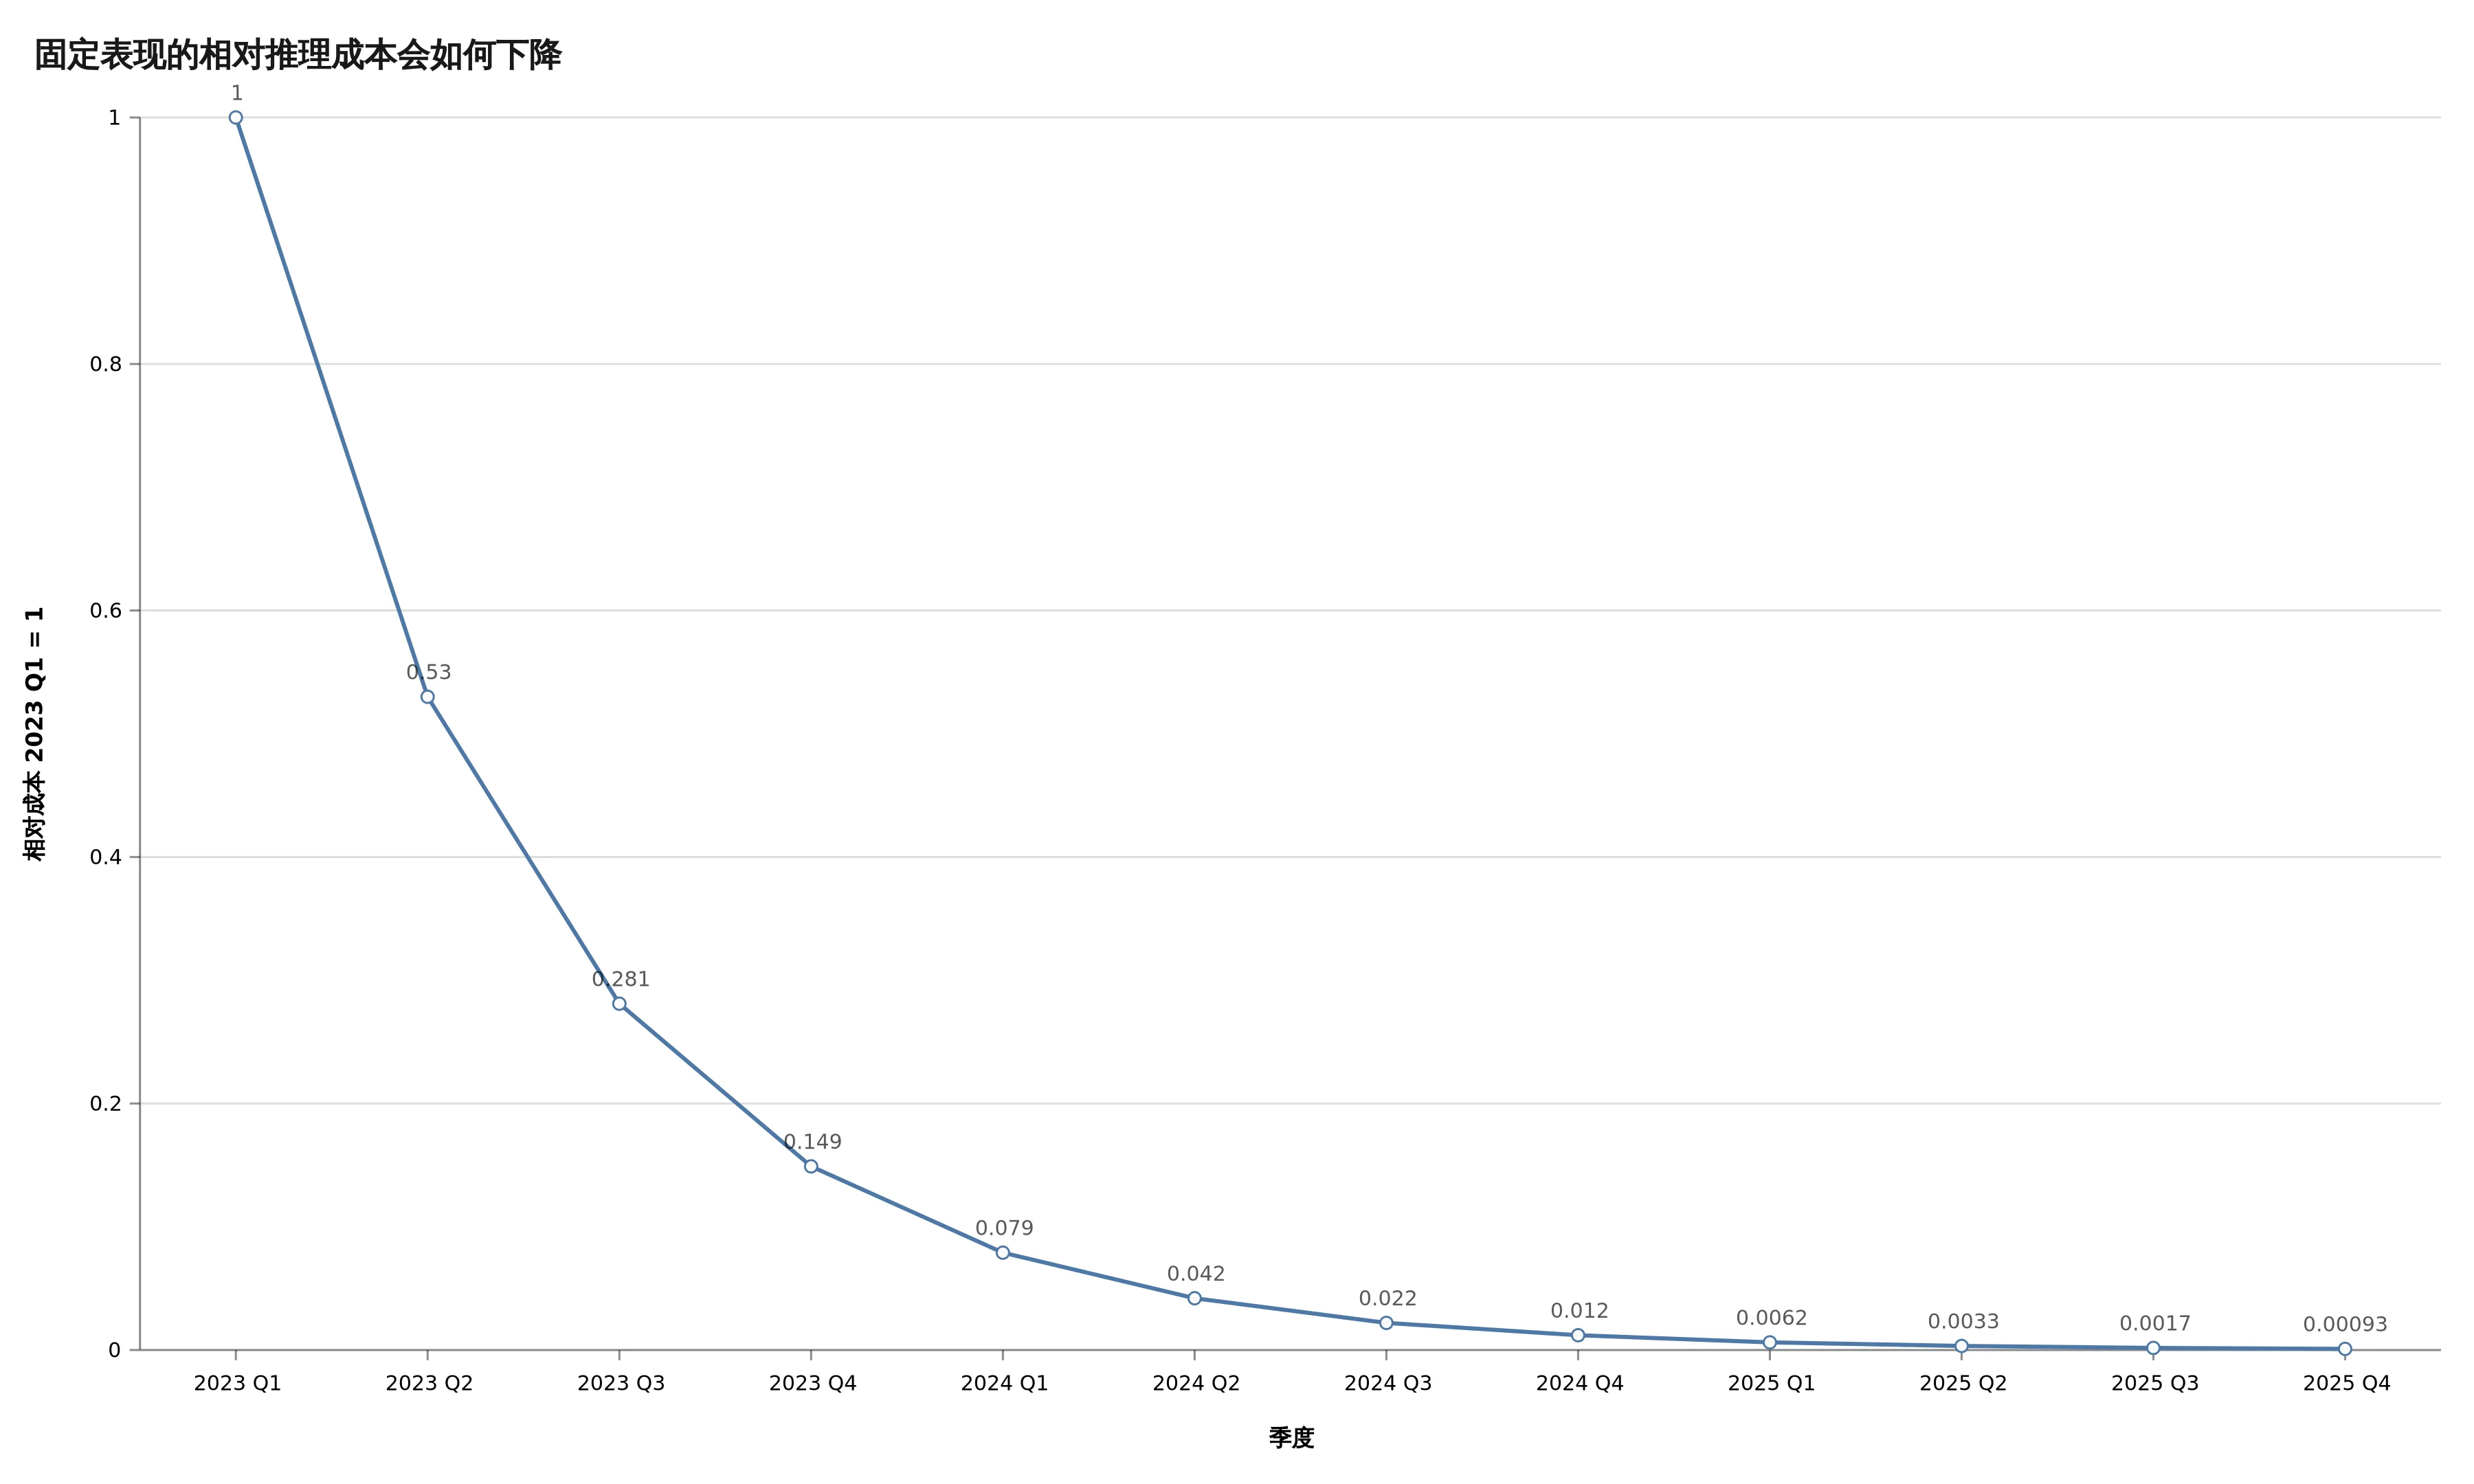
图中按 State of AI Report 2026 引用的 Epoch AI 平均季度降幅作示意推演,并非逐季度实测序列。它描述固定表现的最低推理成本,不替代团队自己的全链路成本。
但报告紧接着泼了盆冷水。单次调用更便宜,不代表一件工作更便宜。
一个会自己规划、检索、调用工具的 Agent,往往会把省下来的单价换成更多轮调用、更长上下文、失败后的重跑,仍要有人验收它到底交没交对。
我觉得这才是这份 244 页报告里最该被产品团队抄走的一句潜台词。
别只问模型多少钱,先问它能不能把活干完。再问高峰时有没有地方让它干完。
这篇不想把年度报告压成一串大新闻。我们只聊做 AI 产品时最容易算错的三笔账,并在后面留一张能放进上线评审里的小表。
成本曲线向下,交付成本不一定向下
一张模型单价表很适合做汇报。输入 token 多少钱,输出 token 多少钱,缓存命中能省多少,排得整整齐齐,谁看都舒服。
可用户不会购买 token。
用户购买的是一件完成的事。
报告在 商业化章节 里举了一个很扎实的对照。某模型在四项结构化会计任务上,每项二十次尝试都拿到了 100%。
到了要求工作簿正确、交付也正确的一百个模拟金融任务里,成功率却只有 12.3%。
有一次失败尤其典型,模型用同一个错误假设做自己的检查,于是它给自己盖了通过章。
这不是在说模型分数没有用。分数当然有用,它告诉你模型有没有能力碰到那个任务的边。
但生产里真正消耗预算的是完整轨迹。读资料用了几轮,工具报错重试了几次,检索有没有找偏,人工退回后又跑了几遍,交付物能不能被下游系统接住。
一份漂亮答案和一件正确交付的工作,中间不是多一个按钮,而是多了一整段工程。
所以,给一个 Agent 做预算时,建议把模型单价留在表里,但把它降到第二层。第一层应当是每个正确完成任务的成本。
这里有个很朴素的算法。拿一类具体任务,在同一份输入分布下记录总调用、工具费用、重试次数、人工复核分钟数和最终通过率。
再把总成本除以真正被下游接受的任务数。这个数不优雅,甚至有点扫兴,可它比单价更接近你以后要付的钱。
一旦这样看,很多决策会变得清楚。某个更贵的模型如果少走两次弯路,可能更省。
某个便宜模型如果必须配三轮兜底和人工抽检,也可能一点都不便宜。路由、缓存和小模型分流仍然重要,只是它们服务的对象不再是压低一笔调用,而是提升正确交付的密度。
评测分数不是交付率,别让模型自己当监考老师
做过 Agent 的人多半见过这种场面。模型在过程里说得头头是道,末尾一个字段填错,或者工具返回空结果,它又用那份空结果证明自己已经完成。日志看着很忙,用户只会收到一份不能用的东西。
报告里对垂直模型的材料反倒给了正面例子。Harvey 把开放模型往自己的文档审阅任务上继续训练后,报告称其每个表格单元成本比 Sonnet 5 低 54.8%,并在自家答案质量指标上取得更高分。
Mercor 用 1,928 个专家任务继续训练模型后,在 480 个留出任务上的首次通过率从 16.11% 升到 27.29%。
这些数字都不是通用能力排名。它们只说明一件事,知道自己的正确答案长什么样,并把真实失败变成可重复的测试,会比盯着一张通用榜单更接近生意。
这件事听着像老生常谈,做起来却很容易偷懒。因为把一次失败留住,要保存输入上下文、工具调用、外部返回、人工给出的修正和任务结果。然后把它收进固定回归集。
下次模型、提示词、检索库或工具变了,再拿同一批案例跑一次。
这不是为了把每次失败写进事故报告。它是给产品留一条能复用的路。知道失败发生在检索、记忆、模型路由、工具接口还是领域知识,团队才有机会选择真正的修复点。
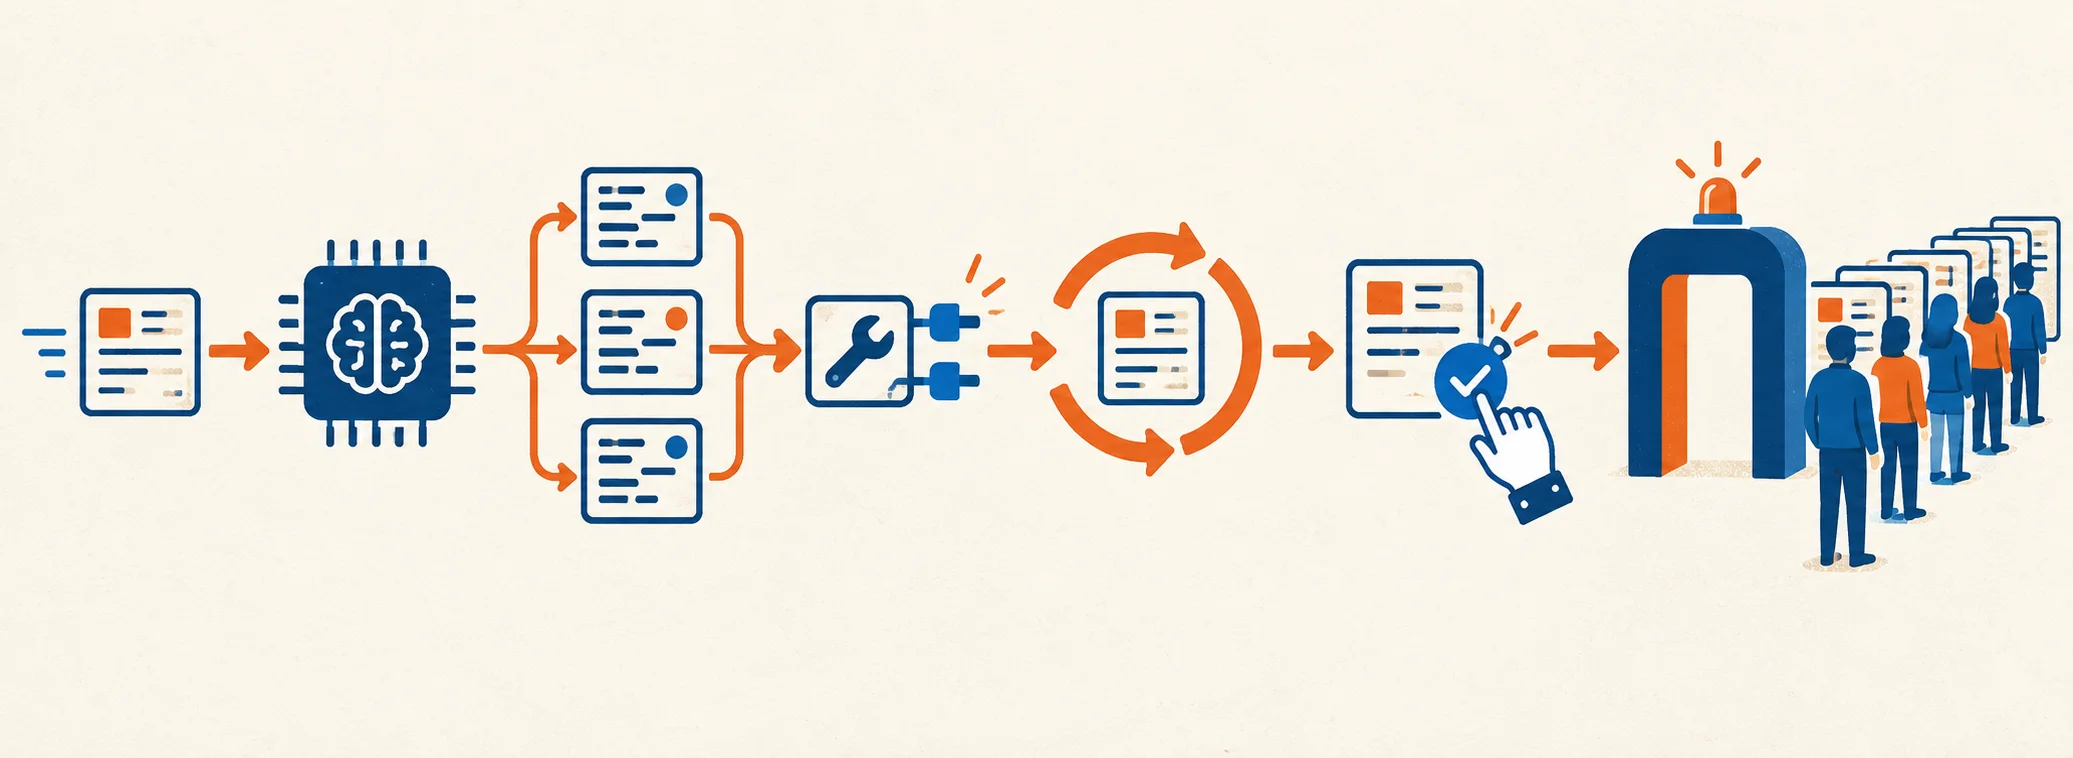
这张示意图对应本文讨论的交付链路。垂直模型的数字来自各公司特定评测,适合用来理解方法,不应用作别的业务承诺。
报告对这类材料的边界写得很清楚,不同公司的数字来自不同任务、日期和口径,不能拼成一个万能结论。可这恰好是重点。你的产品也不需要一个万能结论,它需要一组能决定是否上线的任务。
如果现在只够做一件事,我会优先把最近十个被人工退回的任务拿出来。把它们从聊天记录里捞出来,补齐正确交付物和失败原因。十个案例不够证明模型很强,却足够暴露你的系统到底在为哪种错误付钱。
容量不是云厂商新闻,它会变成你的延迟和限额
前两笔账还在应用层。第三笔账更远,也更硬,它在数据中心、电网、机房和调度器里。
报告的 算力与基础设施章节 反复区分一件很容易被标题抹平的事,签约容量和已启用容量不是一回事。
以 CoreWeave 为例,报告列出它在 2026 年 8 月披露的 4.2GW 签约供电,以及二季度末 1.5GW 已启用供电。
它们对应不同日期、不同交付阶段,也都不能直接换算成今天能给某个客户多少 GPU。
对小团队来说,你当然不会去谈 GW 的电力合同。
可这个差别会沿着云端一路传下来,常常表现成高峰期排队、区域限制、模型限额、价格波动和突然需要降级的请求。
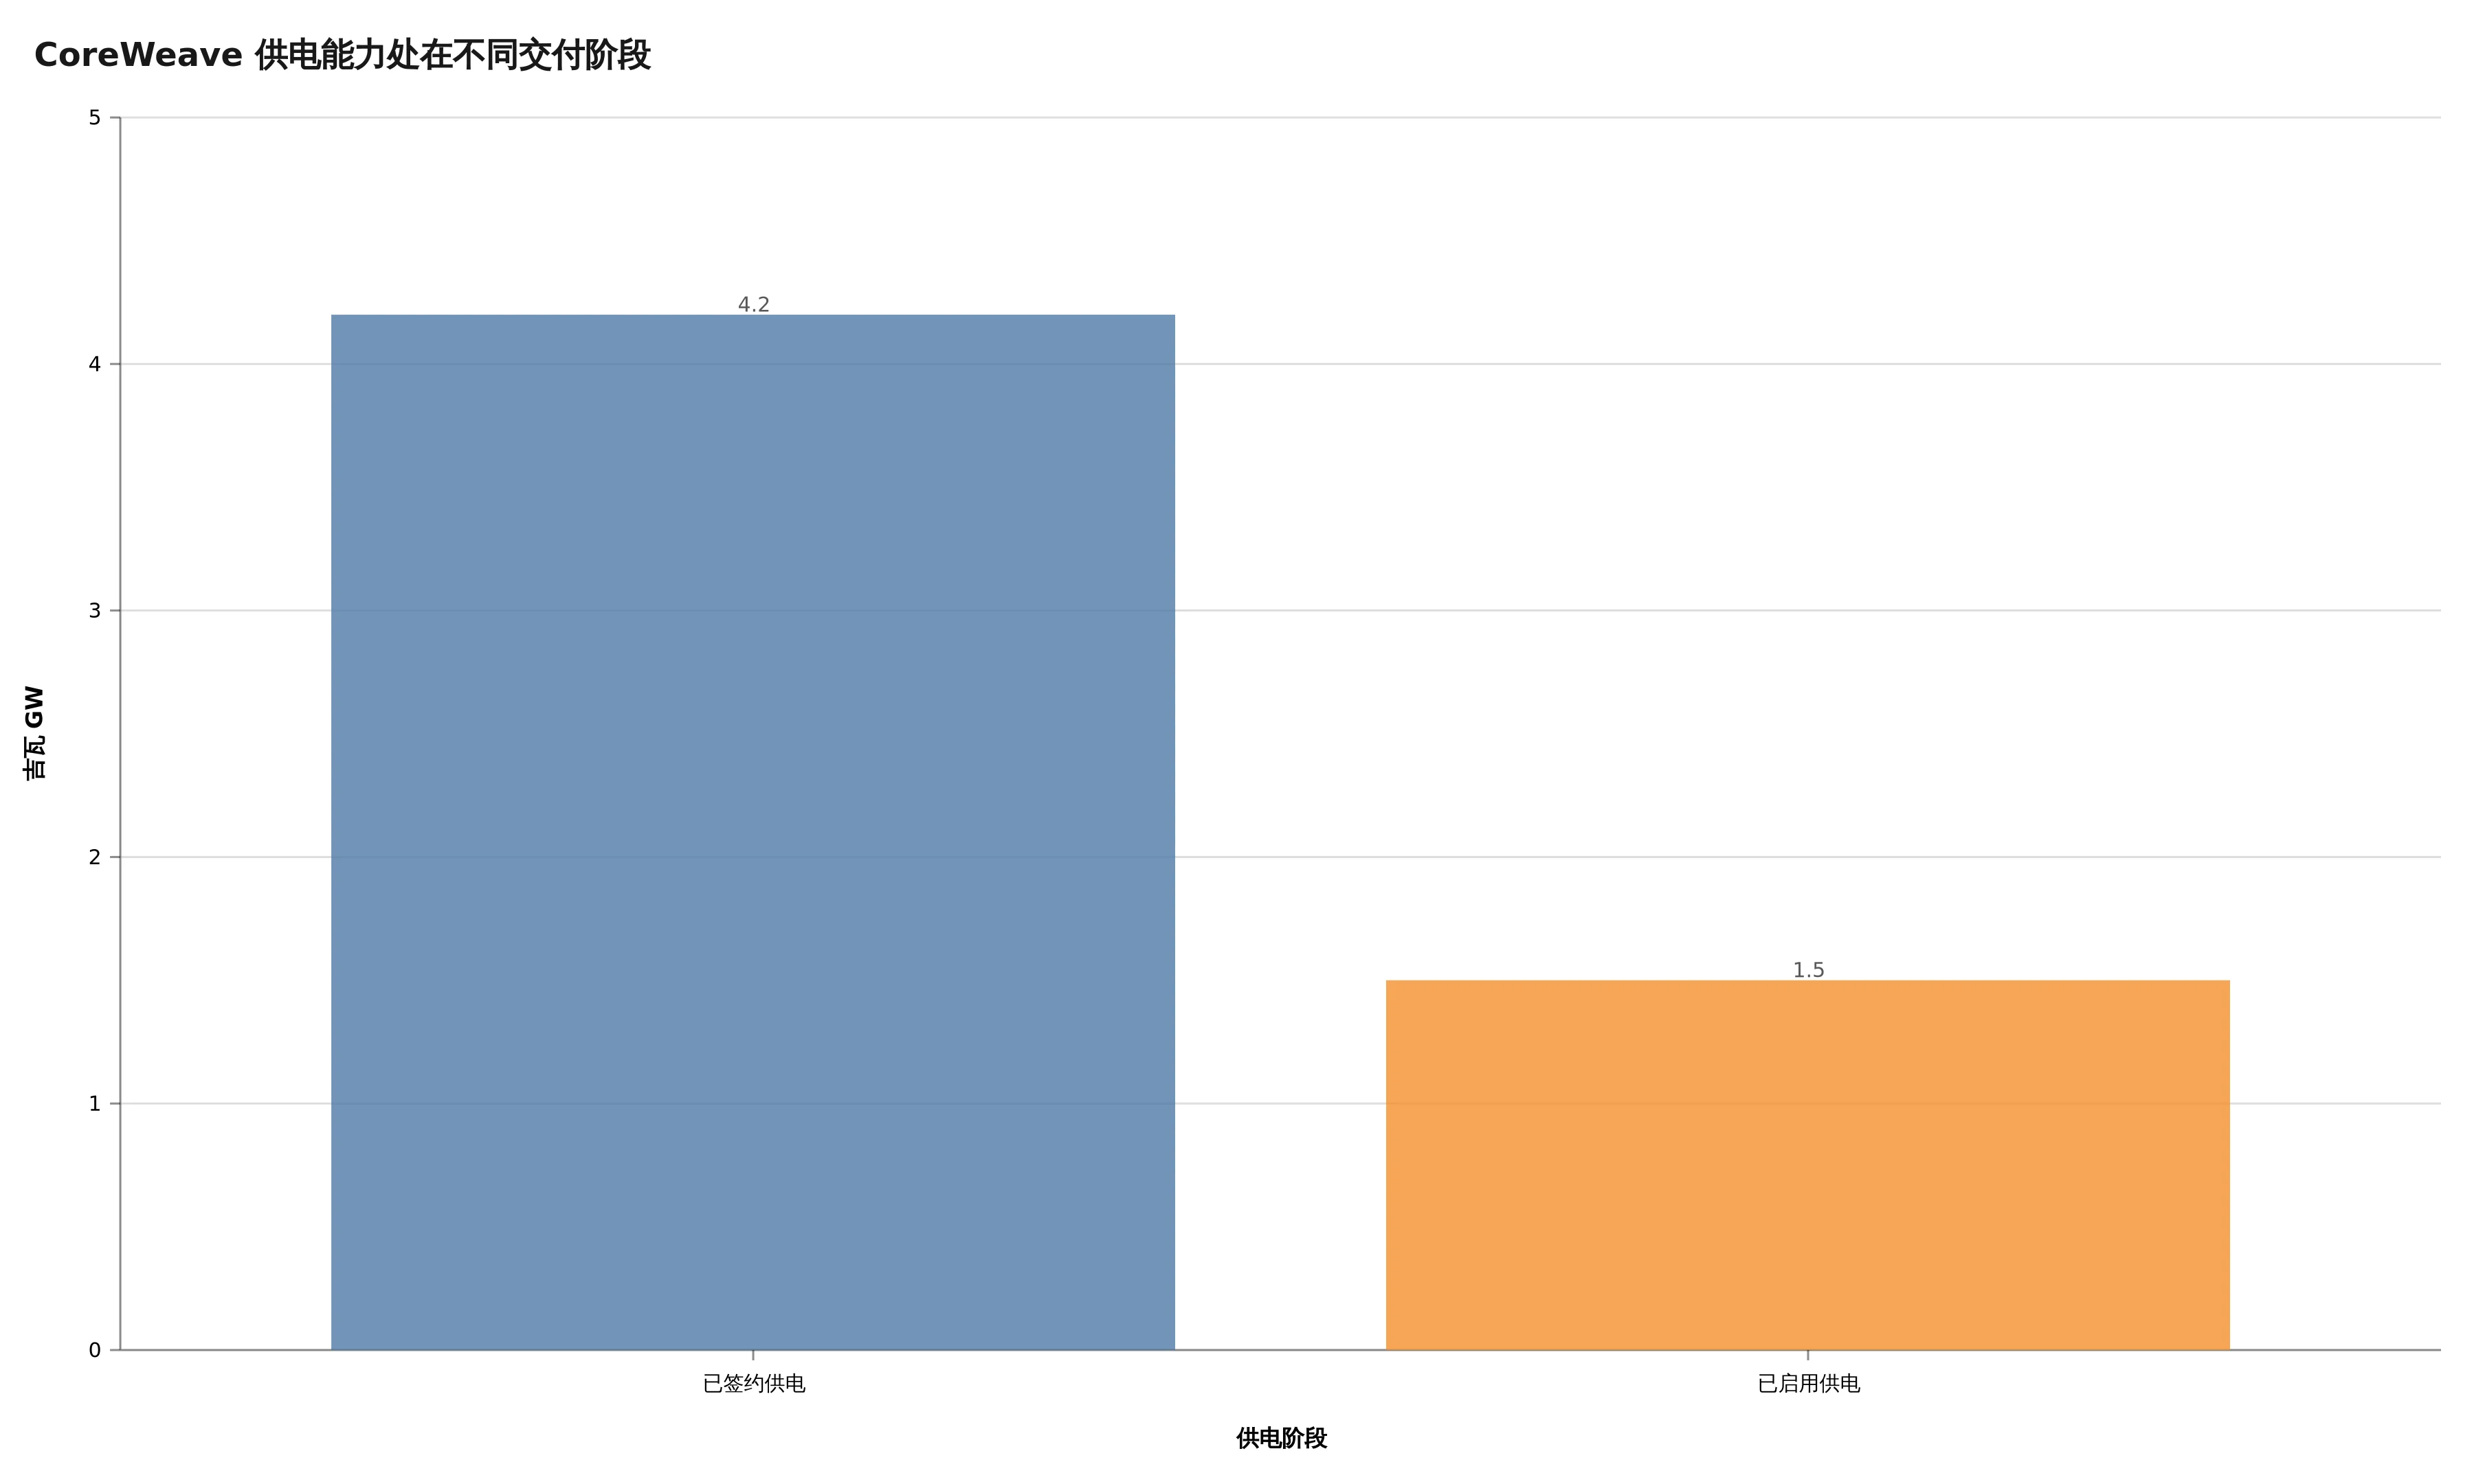
数据来自报告收录的 CoreWeave 披露,4.2GW 对应 2026 年 8 月 11 日的签约供电,1.5GW 对应二季度末已启用供电。两项不能直接换算成客户可用 GPU。
以前给一个功能算容量,可能只要盯住并发和数据库。Agent 时代多了一层状态。它不只消耗 GPU,还会占住浏览器会话、沙箱、CPU、内存和可恢复的任务上下文。
报告提到,Kimi K3 使用了数百万个可暂停、恢复和快照的沙箱。另一个公开部署单元达到 30,000 个 CPU 核与 250TB 内存,同时多数沙箱的 CPU 实际用量又低于申请量。
上线前最好拿最坏的那组任务过一遍峰值。最长上下文、最多工具调用、一次超时重跑和人工回看同时发生时,队列会堆多长,哪些资源能回收,用户会先看到等待还是降级结果。
平时平均值很好看,峰值才决定功能会不会在关键时刻失约。
好家伙。买更多卡并不能自动解决闲置和排队。
这里真正要管的是任务形态。哪些任务必须实时返回,哪些可以排队。哪些失败可以恢复原上下文,哪些可以用更小模型兜底。哪些任务值得留住昂贵的长上下文,哪些只需要一个短暂的分类器。
把这几件事写清楚,容量才不只是供应商的报价单。
别把所有工作都安排在最强模型、最长上下文和最高优先级上。那相当于把办公室里每个请求都升级成紧急会议,过两周你只会拥有一间永远在开会的办公室。
把上线评审改成四张卡
这份报告没有替任何团队给出一张万能预算表。它给出的材料却足够让我们把问题问得更像工程,而不是像愿望。
完成卡
先写清楚一项任务什么叫完成。是生成一份草稿,还是已经被下游系统接收。是字段正确,还是包含附件、格式、权限和提交结果。没有这个定义,所有模型分数都会显得很好看。
成本卡
记录每次正确完成所消耗的总调用、工具费用、重试和人工复核。把失败任务也算进去。不要让一次便宜的模型调用替整段工作背书。
证据卡
把真实失败留成回归任务。每次改提示词、检索、模型路由或工具接口,都回跑这些任务。模型可以解释它为什么这么做,但验收应当看它做了什么和交付了什么。
容量卡
把高峰并发、长任务占用、沙箱数、超时后的恢复和模型降级写成明确规则。容量紧的时候,哪些任务排队,哪些任务降级,哪些任务直接停下,都要先决定。
这四张卡没有魔法。它们也不会让一个能力还不够的 Agent 立刻变可靠。
它们只是把一个经常被模型发布节奏带跑的问题拉回地面。你不是在买一次聪明回答,你是在搭一条能按质量、按成本、按容量交付工作的生产线。
模型还会继续更强,推理也会继续更便宜。真正拉开差距的,可能不是谁最早喊出模型分数,而是谁更早算清了一件工作从请求到交付的全程账。
如果你的团队现在要上线一个会调用外部工具的 Agent,你会先补完成卡、成本卡、证据卡还是容量卡?