
AI 写代码太快,代码评审该从盯 diff 换成验收
Tessl 团队把人从 500 行的 AI diff 里拉出来,改在生成前审意图、生成后看证据。本文给一份可贴进 PR 的验收模板,也说清哪些风险仍要回到代码里看。
AI 写代码最尴尬的时刻,不是它写错了,而是它写得太快。
一个 PR 里堆了几百行改动,reviewer 不是真的看不懂语法;更难的是,他得一边翻 diff,一边猜这次改动原本要让什么成立。功能有没有对用户生效,权限有没有越界,错误状态有没有被吞掉,测试到底测到了需求还是只测到了新实现。代码量一多,人的注意力就被迫花在“复述代码做了什么”上。
Tessl 最近写了一篇很坦率的团队复盘:他们合入的 PR 数量是一年前的四倍,几乎所有代码都由 AI 生成、人参与协作。继续加 reviewer、加 AI review bot、加更长的生成清单,都没把瓶颈搬走。团队后来干了一件看着有点倒着来的事:不再把逐行读代码当作审查的中心,改为在代码生成前审意图,生成后验收证据。原文
这不是“以后不用看 diff”——那种口号很省事,也很容易出事故。更准确地说,AI 把“能写出多少行”这件事提速后,代码评审该把最贵的人类判断力挪到更早的位置。
diff 回答了“改了什么”,却不负责“该不该这么改”
普通开发流程里,需求、方案和代码之间有很多人肉停顿。有人问一句“为什么要这样做”,有人在设计稿或 ticket 上补一句约束。AI 一次能吐出一大段实现后,这些停顿反而容易被省掉:需求只有一句自然语言,代码已经排成队等着合并。
于是 reviewer 面对的常常不是一个 bug,而是一道逆向题:从 400、500 行 diff 里,反推作者和 Agent 当初理解的需求。Tessl 在文中提到,ticket 往往写得不完整,代码的真实行为又会慢慢偏离 ticket;光靠“看起来合理”的实现,很难证明它满足了真正的业务目标。
他们把人工判断前移。代码动手前,先确认三件事:这次改动要让用户看到什么行为;哪些边界绝对不能碰;什么证据可以证明已经做到。生成以后,每条验收条件都要有能复核的结果,而不只是 Agent 在 PR 里写一句“已完成”。
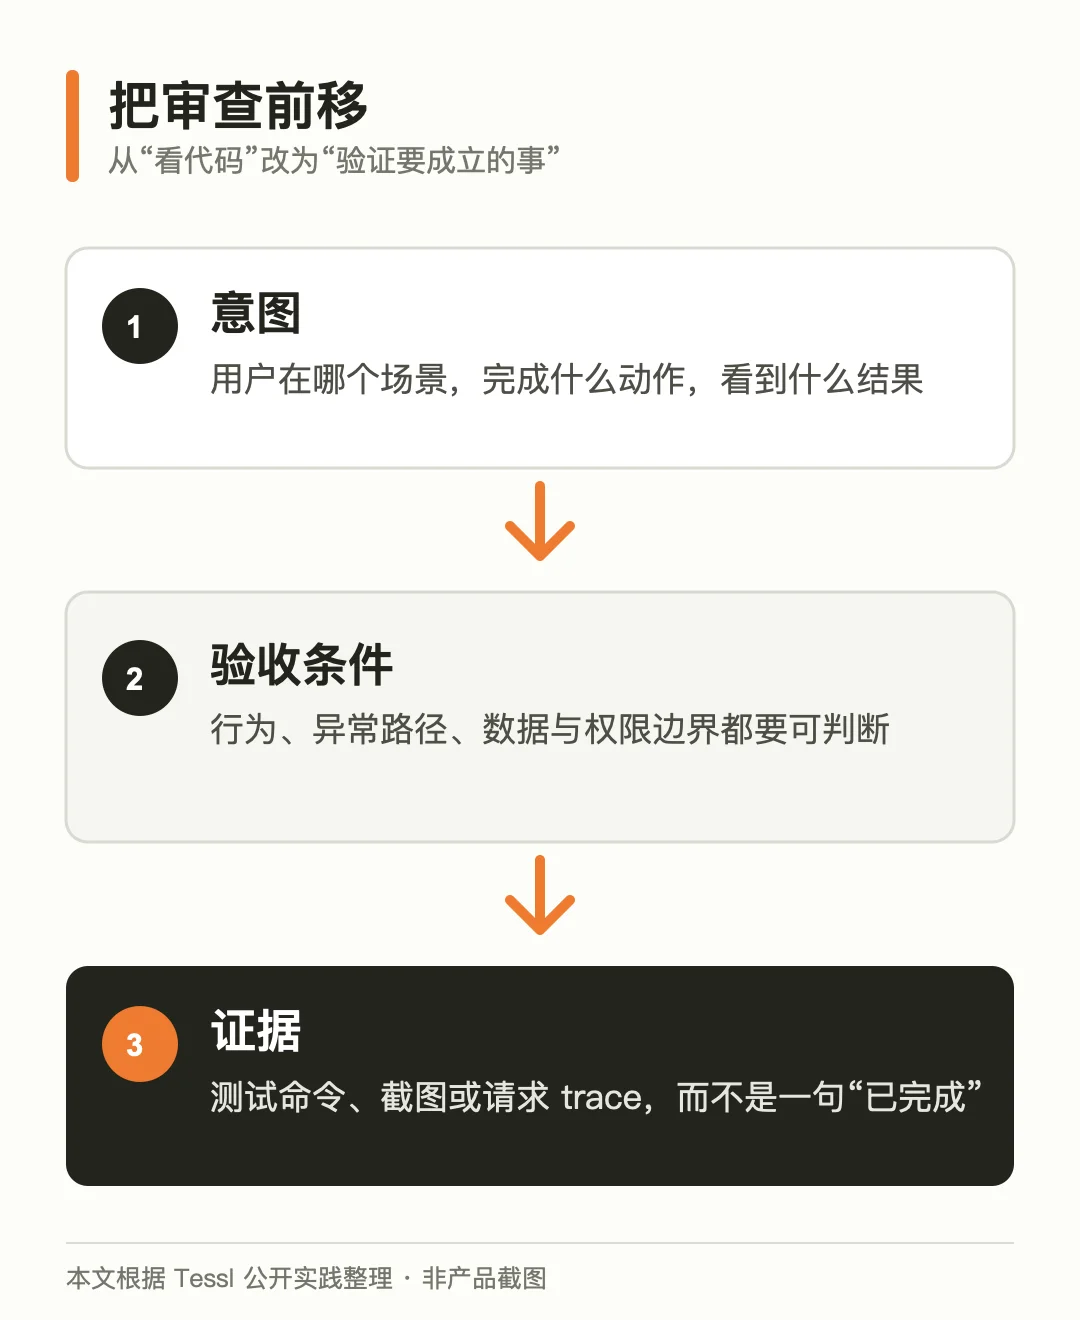
本文根据 Tessl 公开实践整理:先定义意图,再写验收条件,最后交付可复核的证据。
这张图里最值得借的不是产品界面,而是顺序。它把“先讲清什么算完成”放在“现在代码长什么样”前面。一个功能如果连验收句子都写不清,审查者看再久的 diff,也只能判断它像不像一段正常的代码。
给 PR 一张能被验证的任务卡
不需要等团队采购新平台才开始。先把下面这段放进一个改动范围清晰的 PR 描述里,已经能让对话从“帮我看下代码”变成“这四件事有没有发生”。模板是本文根据原文做的中文整理,不是 Tessl 官方命令或实测结果。
## 这次要让什么成立
用户在 <场景> 下,能完成 <动作>,并看到 <结果>。

## 不该改变什么
- <原有行为 / 兼容性>
- <权限、数据或性能边界>

## 验收条件与证据
- [ ] <可观察的行为>:<测试命令、截图或请求 trace>
- [ ] <异常路径>:<错误响应或回归测试>
- [ ] <数据 / 权限约束>:<检查方式>

## 仍需人工判断
- <产品取舍、灰度范围、不可自动化的风险>
这里的关键不是把清单写得更长。每一条都得能被判定:要么通过,要么失败,要么证据不足。比如“优化登录体验”不是验收条件;“首次访问没有保存主题时使用浅色模式,切换后刷新仍保留选择,并且键盘可操作”才是。原文的示例也是这种粒度:条件、截图、日志或请求记录彼此对得上。
这样做还有一个很现实的好处:当 Agent 生成的实现偏了,你能在一段意图文字上把方向拧回来,而不是等几百行代码写完,再开一场“这需求到底是谁理解错了”的会。后者在项目群里通常比 bug 本身更耗电。
把反复出现的评论,变成没人需要重复说的话
Tessl 还有一招很适合已经被 review 评论淹过的人:去翻重复出现的评论,把它们写成不变量(invariant)。原文给的例子非常朴素:涉及金额必须使用 Money 类型;不允许直接写 users 表;必须使用结构化日志,不能随手 print。
它们不性感,甚至有点无聊。可无聊正好是优点:规则足够明确,机器能在每次改动上执行,资深工程师就不用第七次留言“这个字段为什么又绕过了金额类型”。原文建议从最近 1,000 条 review 评论里找最常出现的 20 条,先把已经被团队反复执行的标准写下来,而不是凭空发明一套“AI 时代最佳实践”。
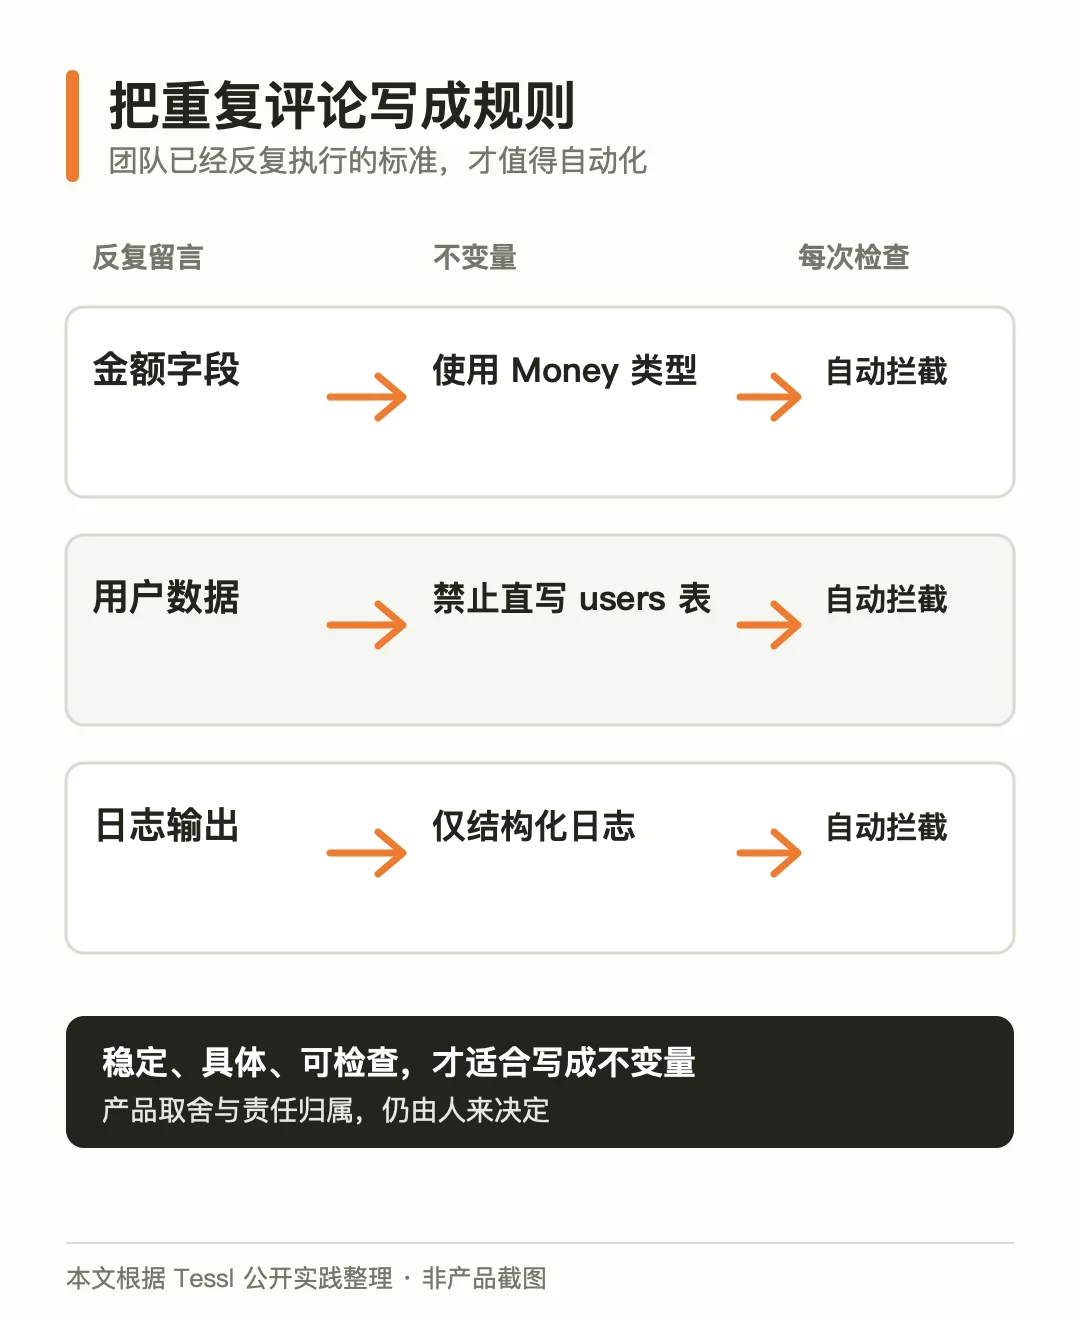
本文根据 Tessl 公开实践整理:稳定、具体、可检查的重复评论,才适合写成不变量。
我会给这一步加一个小限制:不变量只适合稳定、可检查的约束。金额类型、日志格式、禁止直写某张表,都适合。产品优先级、用户体验取舍、一次迁移该不该拆两步,这些问题没有一句正则或一个 linter 能替负责人做决定。把所有判断都写成规则,最后会得到一张很长的流程图,和一群不知道谁负责改规则的人。
什么时候仍然得回去看代码
“有验收证据”不等于“可以放心合并”。下面几类改动,reviewer 还是要打开 diff,必要时多找一双眼睛:
- 数据迁移、删除和回填:验收通过不代表回滚路径存在。
- 鉴权、付款、隐私数据和外部副作用:产品行为正确,也可能把边界开错。
- 依赖升级、生成配置和文件范围异常:任务卡写的是 A,提交里却夹进了 B,证据未必会主动告诉你。
- 测试只验证了 Agent 刚写的实现:它可能精确证明了错误的假设。
所以更好的顺序不是“意图取代代码”,而是“先用意图和证据缩小人该看的地方,再把人的时间留给风险、取舍和异常”。Tessl 把它概括成五件事:在 PR 前让方案被挑战,记录意图,把重复评论编码为规则,让人审决策,并且给规则指定负责人。这里没有魔法,只有把原来散落在评论区里的责任,搬到可以复用的位置。
如果你的团队已经让 AI 写进了日常 PR,不妨挑一个低风险功能试一次:不是让 Agent 多写一轮总结,而是要求它先交一张任务卡,再交每条条件的证据。合并后回头看,最常被问的那一句到底是什么。它很可能就是下一条该被写成规则的不变量。
你们团队最近最常在 AI 生成的 PR 里重复哪一类评论?
小岛 AI|记录一线实战、踩坑与成长