
自己部署 DeepSeek:DeepInfer 开源后,真正要补的是服务层
DeepInfer 把 DeepSeek-V4.1-Flash 的推理引擎拿了出来,但线上服务最费功夫的缓存、拆分调度和流量均衡仍要自己接。本文给出判断迁移范围的三道门。
python examples/offline_inference.py 这一行摆在 DeepInfer 的 README 里,很容易让人产生一种危险的错觉:DeepSeek 的生产推理框架开源了,模型服务这件事是不是就突然简单了?
先别急着把它塞进迁移计划。DeepInfer 确实把 DeepSeek-V4.1-Flash 背后很硬的一段东西拿了出来:内核、模型运行时、并行、调度、投机解码、结构化输出。可同一份 README 也把另一句话写得很清楚:一个完整在线推理服务需要的 KV cache、视觉编码/预填充/解码拆分,以及跨数据并行副本的负载均衡,并不包含在这次交付里。
这两句放在一起看,反而是这次开源最有价值的地方。它不是又多了一个“装一下就起飞”的框架;它把推理集群里哪些属于引擎、哪些属于服务层,硬生生切开给我们看了。
如果你只是调用 DeepSeek API,这篇可以直接收起来。真正值得往下看的,是已经在自建模型服务、准备评估 V4.1-Flash,或者手里有一套 vLLM/SGLang 服务栈的人:DeepInfer 到底该放到什么位置,才不会从一次技术兴奋变成一场生产事故。
先把“模型能跑”与“请求能接住”分开
模型权重、推理引擎、在线服务,经常被一锅端地叫作“部署”。这会制造很多误判。
模型解决的是“这件事能不能生成出来”。推理引擎解决的是“单机或一组加速器怎样把计算、采样和批处理跑得更有效率”。在线服务要面对的则是另一套麻烦:不同长度的请求一起涌进来,前缀缓存究竟落在哪儿,用户是否被均匀分配,某台机器掉了以后长请求怎么办,客户端拿到的流式 JSON 是否仍然符合约定。
DeepInfer 本次开源,正处在第二层。官方 README 当前只列出 DeepSeek-V4.1-Flash,支持 NVIDIA SM100 或昇腾 950;构建路径也很明确:Linux、Python 3.12、GCC 13 以上,NVIDIA 路线还要 CUDA 13。它不是一个“任意模型、任意显卡、复制命令就能变成 API 平台”的通用包。
这不是挑刺。边界越清楚,工程师越省时间。
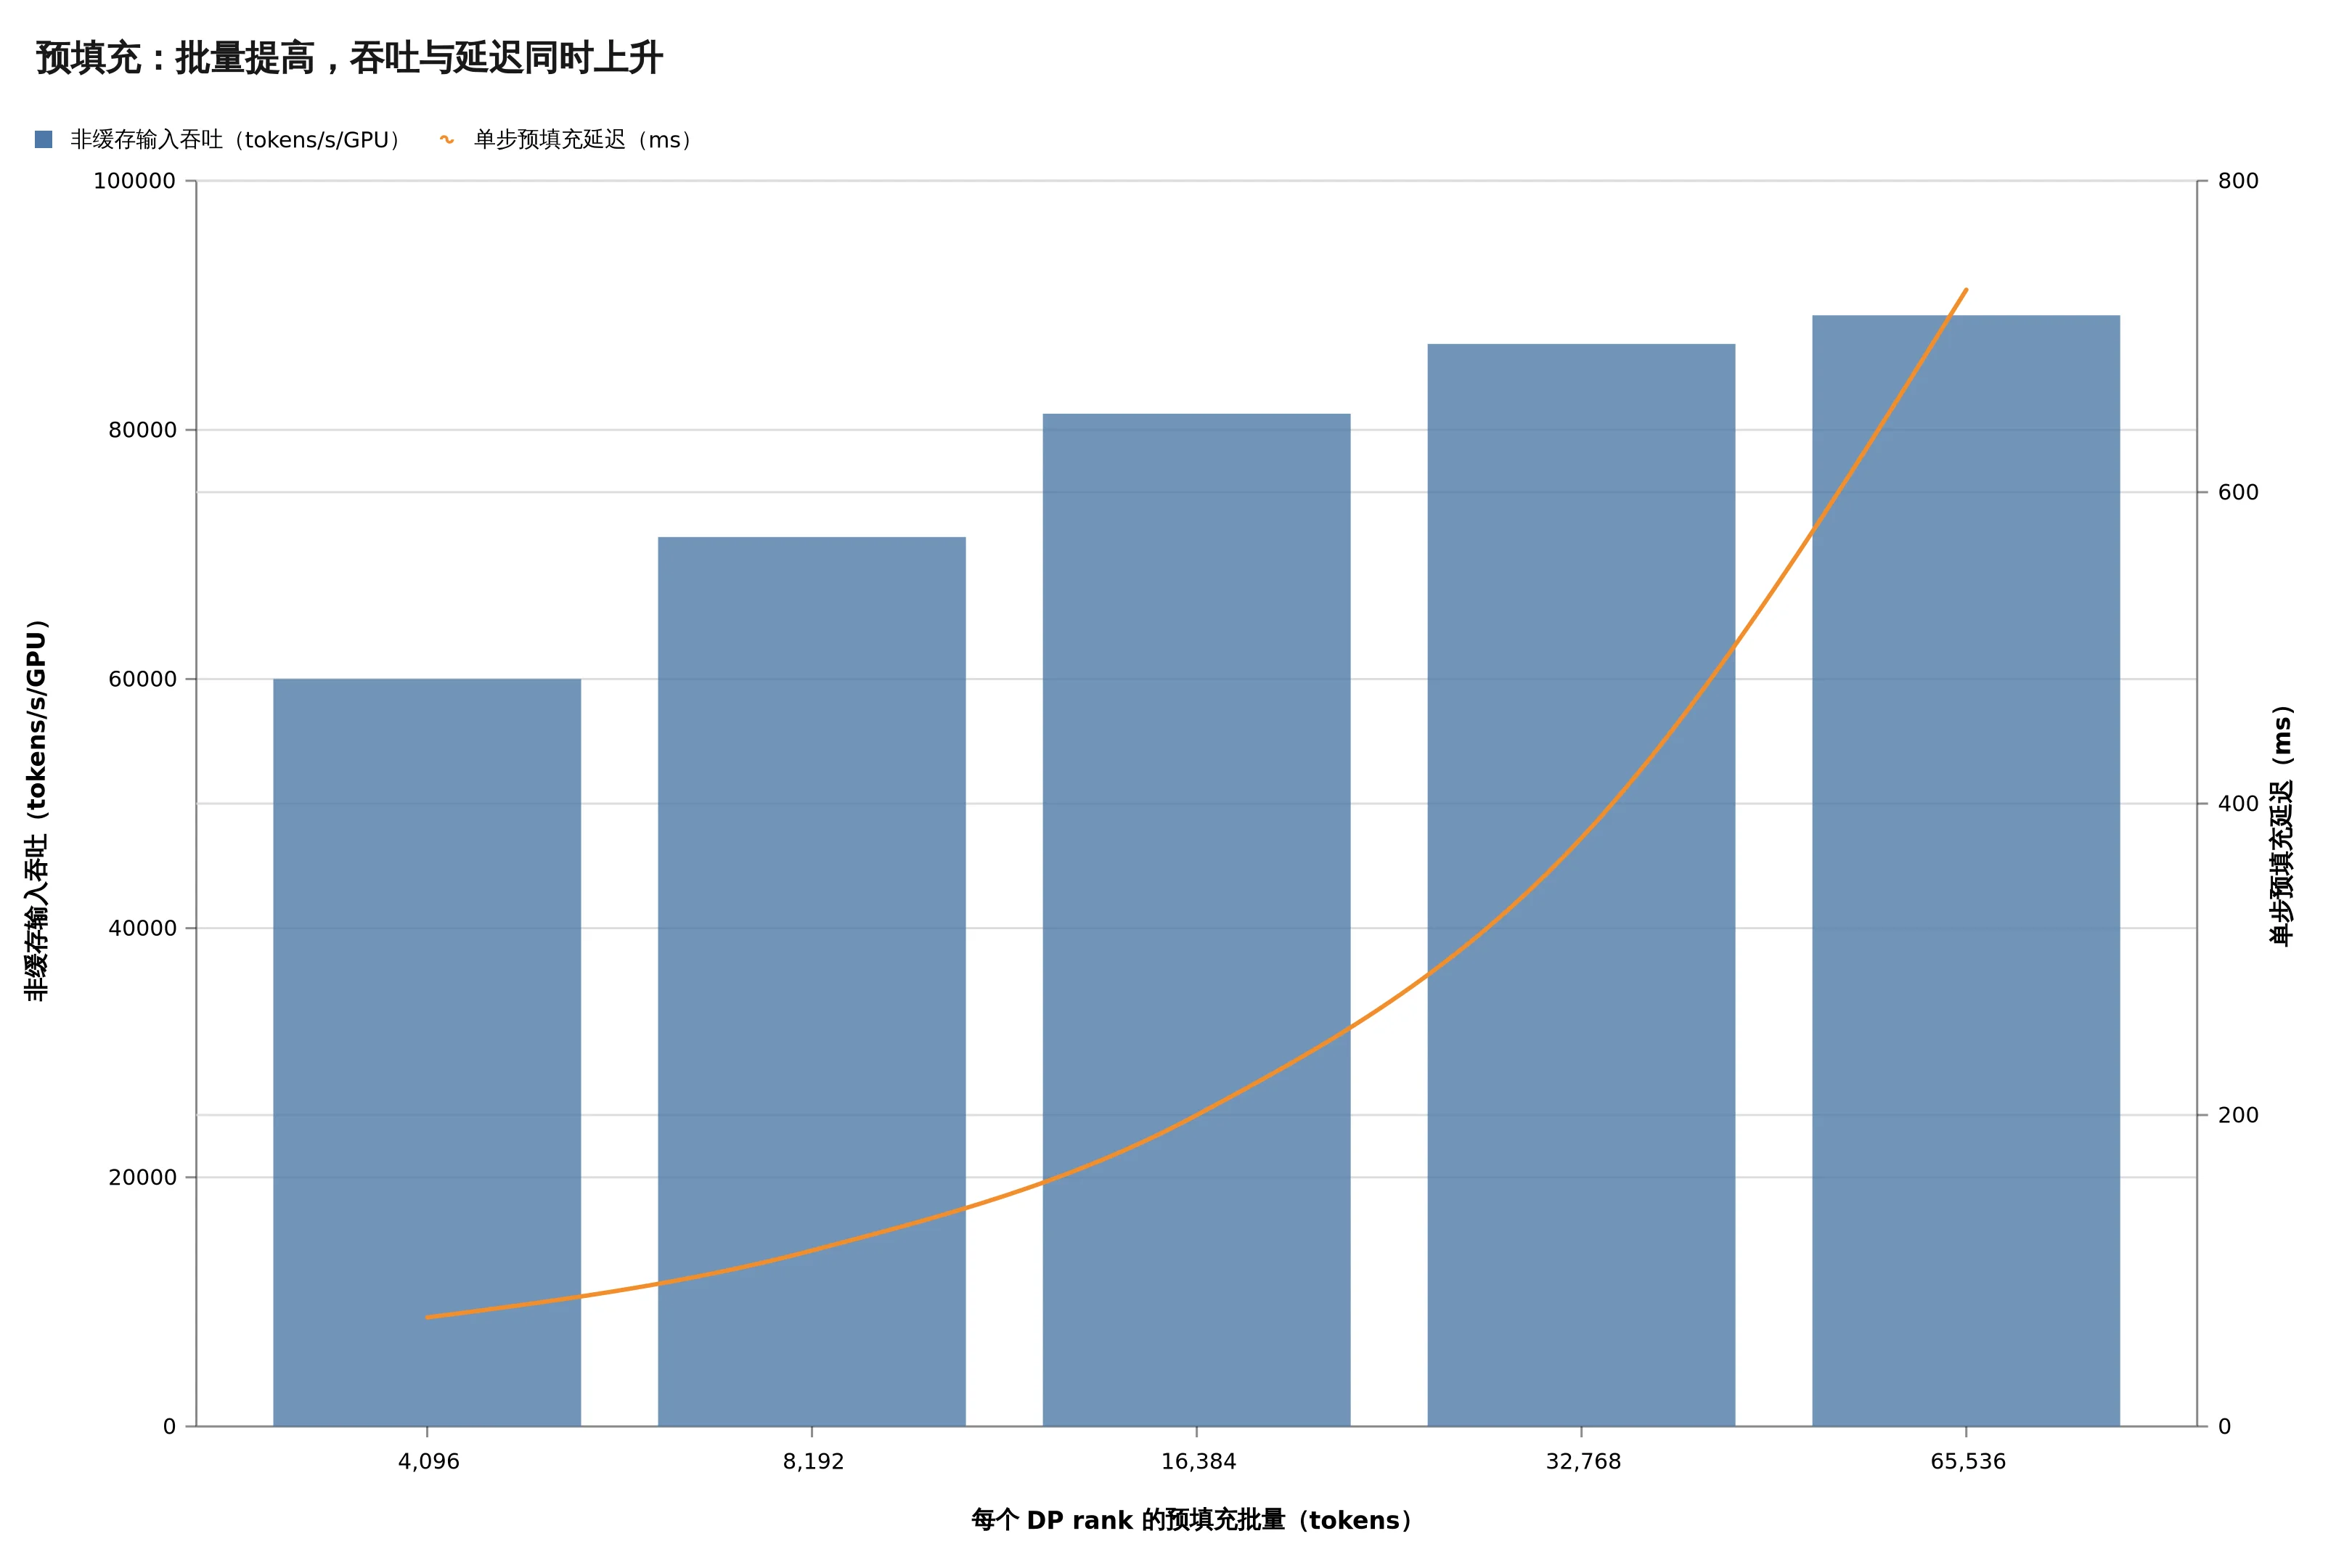
上图来自 DeepInfer 官方仓库:性能数据的硬件与拓扑口径必须一起读,不能只截一个吞吐数字。
官方列出的能力其实很有分量:为 DeepSeek 模型准备的优化内核、Attention DP/balanced CP、MoE 的专家并行与负载均衡、异步调度、批次不变推理、固定 seed 下的确定性采样,以及 JSON Schema、正则和 EBNF 的结构化输出。对要把模型接进 Agent 工作流的人来说,后两项尤其不只是“跑得快一点”——同一输入能否稳定复现、工具参数能否稳定符合 schema,决定了很多线上问题能不能排查。
但这些能力组成的是引擎能力,不自动等于服务责任已经被解决。
真正昂贵的部分,通常不在那条启动命令里
DeepSeek 随仓库放出的部署问答,把自家生产系统讲得很坦白。它把视觉编码、Prefill(读入上下文)和 Decode(逐 token 生成)分开部署;同时又给这三段各自配负载均衡,还把 KV cache 放到专用的 3FS 存储集群。
为什么要搞得这么复杂?因为用户的请求并不整齐。有人只问一句,有人把几十页材料塞进上下文,有人沿着同一条 Agent 任务反复续聊。Prefill 很怕长输入,Decode 很怕长时间挂着许多活跃请求;如果它们抢同一拨资源,首 token 时间、每 token 间隔和整体吞吐会互相拖拽。
KV cache 也是同样的故事。缓存命中当然很香,但“把缓存留久一点”不是一个开关。DeepSeek 官方说,自己的系统对 Agent 流量保留约 3 天、对聊天流量保留约 7 天,并用大量 SSD 存储、独立缓存节点、回收策略和跨节点拉取来维持它。缓存变长以后,成本、容量、命中判断、失效和故障恢复会一起找上门。
所以看到“支持缓存”时,应该接着问的不是“开不开”,而是:缓存属于谁?命中是否会把流量黏死在少数机器上?扩容时原来的上下文怎么处理?储存坏了,用户是重算、降级,还是失败?这才是模型服务最容易被藏起来的账单。
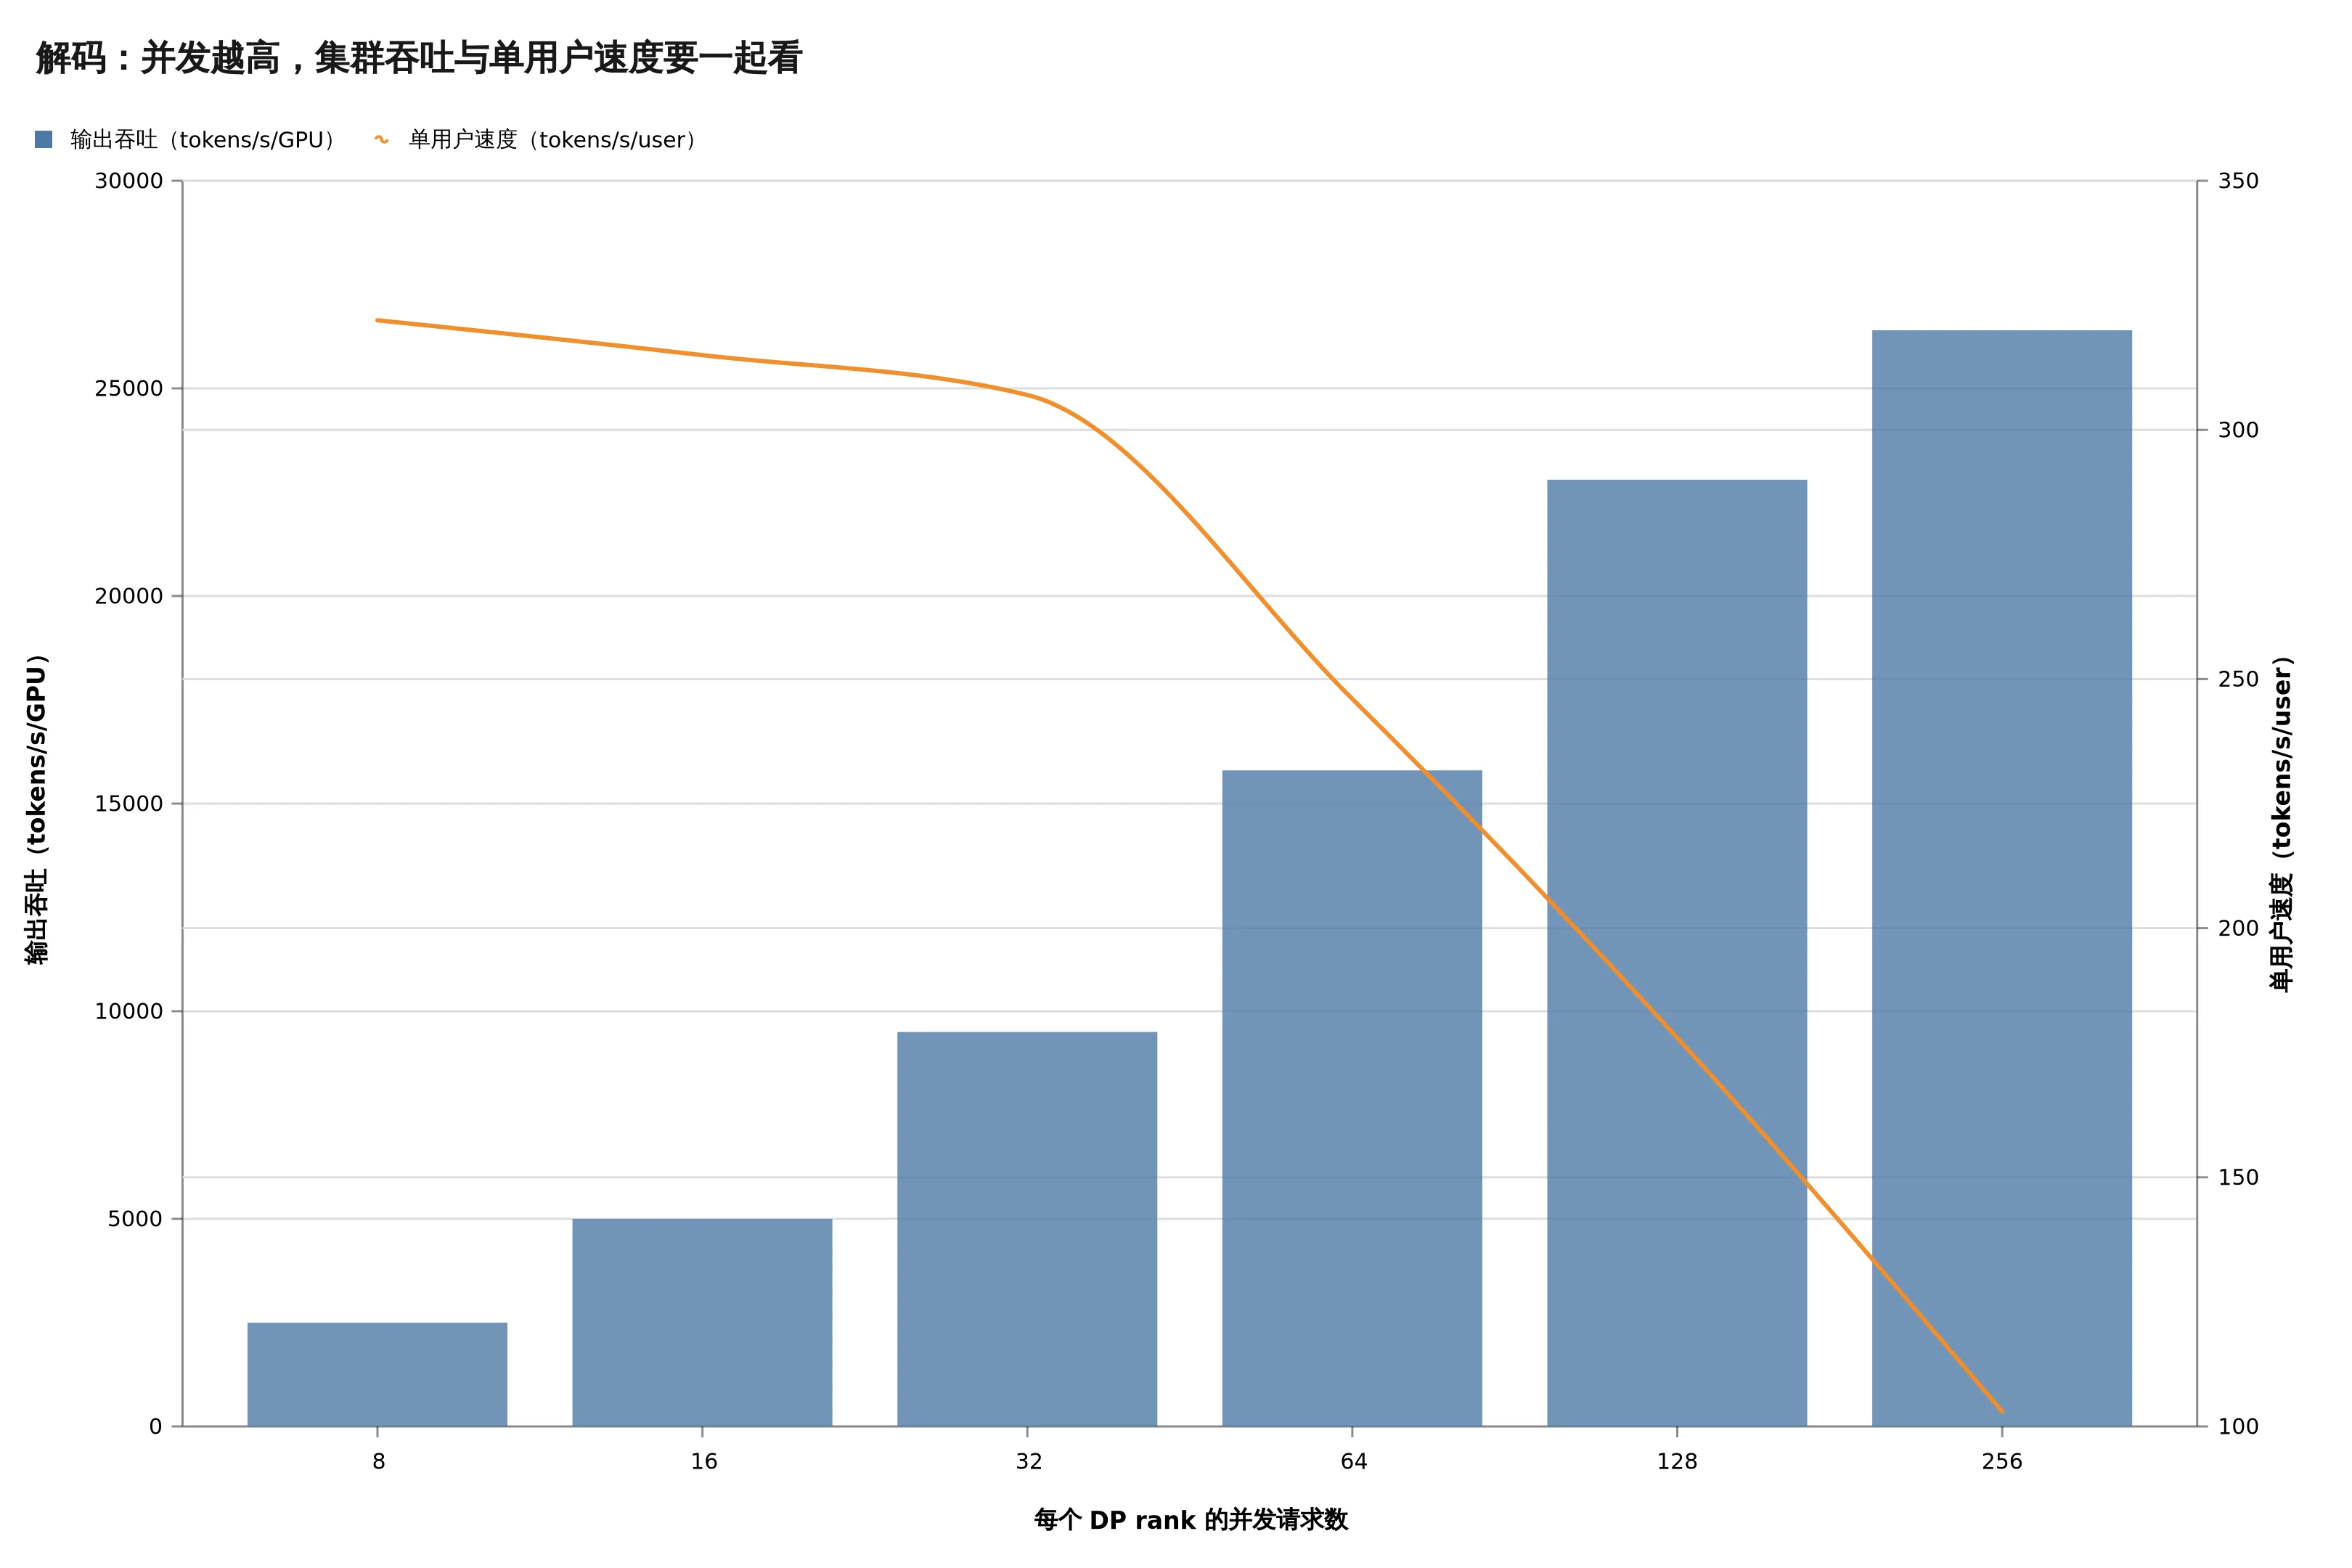
同样来自官方仓库。图中的解码数据使用 64 张 SM100;它说明的是特定拓扑下的取舍,不是任何集群都能复制的“速度承诺”。
部署问答还给了一个挺有教育意义的口径:在其推荐的高效解码配置下,最小高效单元约为 64 张预填充 GPU 加 64 张解码 GPU。这个数字不该被读成“自建 DeepSeek 至少需要 128 张卡”。它只是在提醒我们,生产系统里的“高效”永远带着硬件、网络和调度条件。把厂商集群里的最佳结构直接压缩到一台机器上,通常只会得到一台很忙、很困惑的机器。
DeepInfer 值不值得碰,先过三道门
第一道是兼容门:你的模型与硬件是不是它真正支持的组合。
当前仓库写的是 V4.1-Flash、SM100 与昇腾 950。若团队的目标模型、卡型、CUDA 版本或运行环境不在这条线上,先别谈“替换”。先做一次干净的离线构建,记录编译器、驱动、模型版本与生成结果。能跑通 offline_inference.py 很重要,但它只证明第一道门开了。
第二道是可验证门:你要验证的到底是引擎,还是服务。
如果目标是研究 DeepSeek 的内核、MoE 并行、投机解码、结构化输出,DeepInfer 很值得拉一个隔离环境慢慢看。官方还提供 DEEPINFER_BATCH_INVARIANT=1 和固定 seq_seed 的确定性采样配置(NVIDIA 路线),这对复现和回归比较很有帮助。把同一批 prompt、同一套 schema、同一批工具参数固定下来,比上来就比较“体感更快”靠谱得多。
如果目标是承接真实用户请求,测试集就得再往前一步:长短输入混合时的 TTFT、生成中的 TBT、缓存命中与回退、结构化输出失败率、流式中断后的重试行为、每个成功请求的成本。只跑一次吞吐 benchmark,回答不了这些问题。
第三道是服务门:谁接住 README 明列未交付的部分。
KV cache、Prefill/Decode 拆分、跨副本负载均衡,不是“以后再加”的边角料。它们决定了系统高峰时怎么排队、扩容时怎么迁移、故障时是否能把用户请求从坏节点挪开。如果团队已有成熟服务层,DeepInfer 可能是一个可替换或可对照的引擎候选;如果这些部件都还不存在,那么最合适的产物不是线上替换,而是一份清楚的缺口清单。
这个顺序很朴素:先让模型在受控环境里跑起来,再让指标说话,最后才让真实流量靠近它。跳过中间两步,开源项目再漂亮也救不了值班表。
这张缺口清单最好不是一句“后续补齐”。可以把它写成一次影子实验的验收卡:输入按短上下文、16K–64K、64K–256K 和更长请求分组;输出分别覆盖普通文本、固定 seed 的回归样本、JSON Schema 和工具参数;服务侧同时记录 TTFT、TBT、成功率、超时/中断类型、缓存命中与单位成功请求成本。DeepSeek 的生产问答正是按不同上下文长度分层调度;团队不需要照搬它的规模,但应该照搬这种把工作负载拆开看的习惯。
还有两项经常被漏掉。一是回滚:候选引擎不应独自拥有请求入口,开关要能把一批流量立刻送回旧服务。二是版本归因:模型权重、DeepInfer commit、驱动、编译参数和 schema 版本要一并记录。否则同一次效果波动发生后,大家只能围着一张吞吐图猜是模型、内核还是缓存出了问题。
一个更稳的试法:把它放到影子流量后面
不必因为它来自 DeepSeek 就一刀切换,也不必因为它暂时不是完整服务就当作无关。比较合理的做法,是给它安排一个影子流量位置。
先用官方支持的模型与硬件完成离线基线:同一请求的输出格式是否正确、固定 seed 是否能复现、长输入和 schema 约束是否出现异常。然后让它只接收线上请求的副本,不返回给用户;和现有引擎同时记录 TTFT、TBT、错误类型、缓存命中、显存与单位成功请求成本。
接着再决定服务层的接法。已有 KV cache 与流量层的团队,可以评估哪些接口能复用、哪些需要适配;没有这些能力的团队,先把“缺什么、谁维护、出错怎样回滚”写进方案。DeepSeek 同时开源的 deepseek-recipe 处理多种 API 协议到统一会话格式的转换,它能减少协议适配的工作,但不替团队承担路由、缓存与故障恢复。
等这些指标稳定后,才值得拿一小段可回滚流量做真实验证。上线不是把仓库 clone 下来那一刻,而是出错时你仍然知道请求在哪、缓存在哪、谁可以一键退回原路的那一刻。
DeepInfer 的可贵之处,恰恰是没有把这个差距遮起来。它把生产推理里最难的一部分露出了一截:模型之外,还有一整套让计算、网络、存储和流量彼此不打架的运行时。
你们现在的模型服务里,最先卡住的是内核、缓存,还是流量调度?
小岛AI