
Agent 训练要少堆几层?Axion 1.0 把配方和数据一起放出来了
字节团队刚公开 Axion 1.0 的训练代码、数据构造与评测脚本。真正值得借的不是 122B 分数,而是一套可复现的 Agent 训练—评测链路。
给一个 Agent 接上搜索、网页、Python 和业务接口,最难的通常不是让它“会调工具”。难的是它调用完之后,能不能拿回足够可靠的证据;错了,能不能被看出来;下次训练,能不能知道到底该奖励哪一步。
这也是我看到 Axion 1.0 时觉得有意思的地方。它不是又送来一个把工具串起来的框架,而是把一条 Agent 训练链尽量摊开:数据怎么造、哪些答案能自动验、两次监督微调怎么接强化学习、基准怎么准备、分怎么判,代码都在仓库里。
项目给出的结论很大胆:两段 SFT(监督微调,拿带答案的轨迹教模型)再接一段 RL(强化学习,让模型在工具环境里试错),可以做出有竞争力的通用 Agent 基座。官方报告的 122B 版本在受限网页访问的 HLE 上是 59.0,在 FrontierScience Olympiad 上是 87.0。
分数可以围观。但如果你在做真正要查资料、跑脚本、改代码的 Agent,眼下更值得带走的,是它把“模型能力”拆成一串能被工程团队复查的东西。
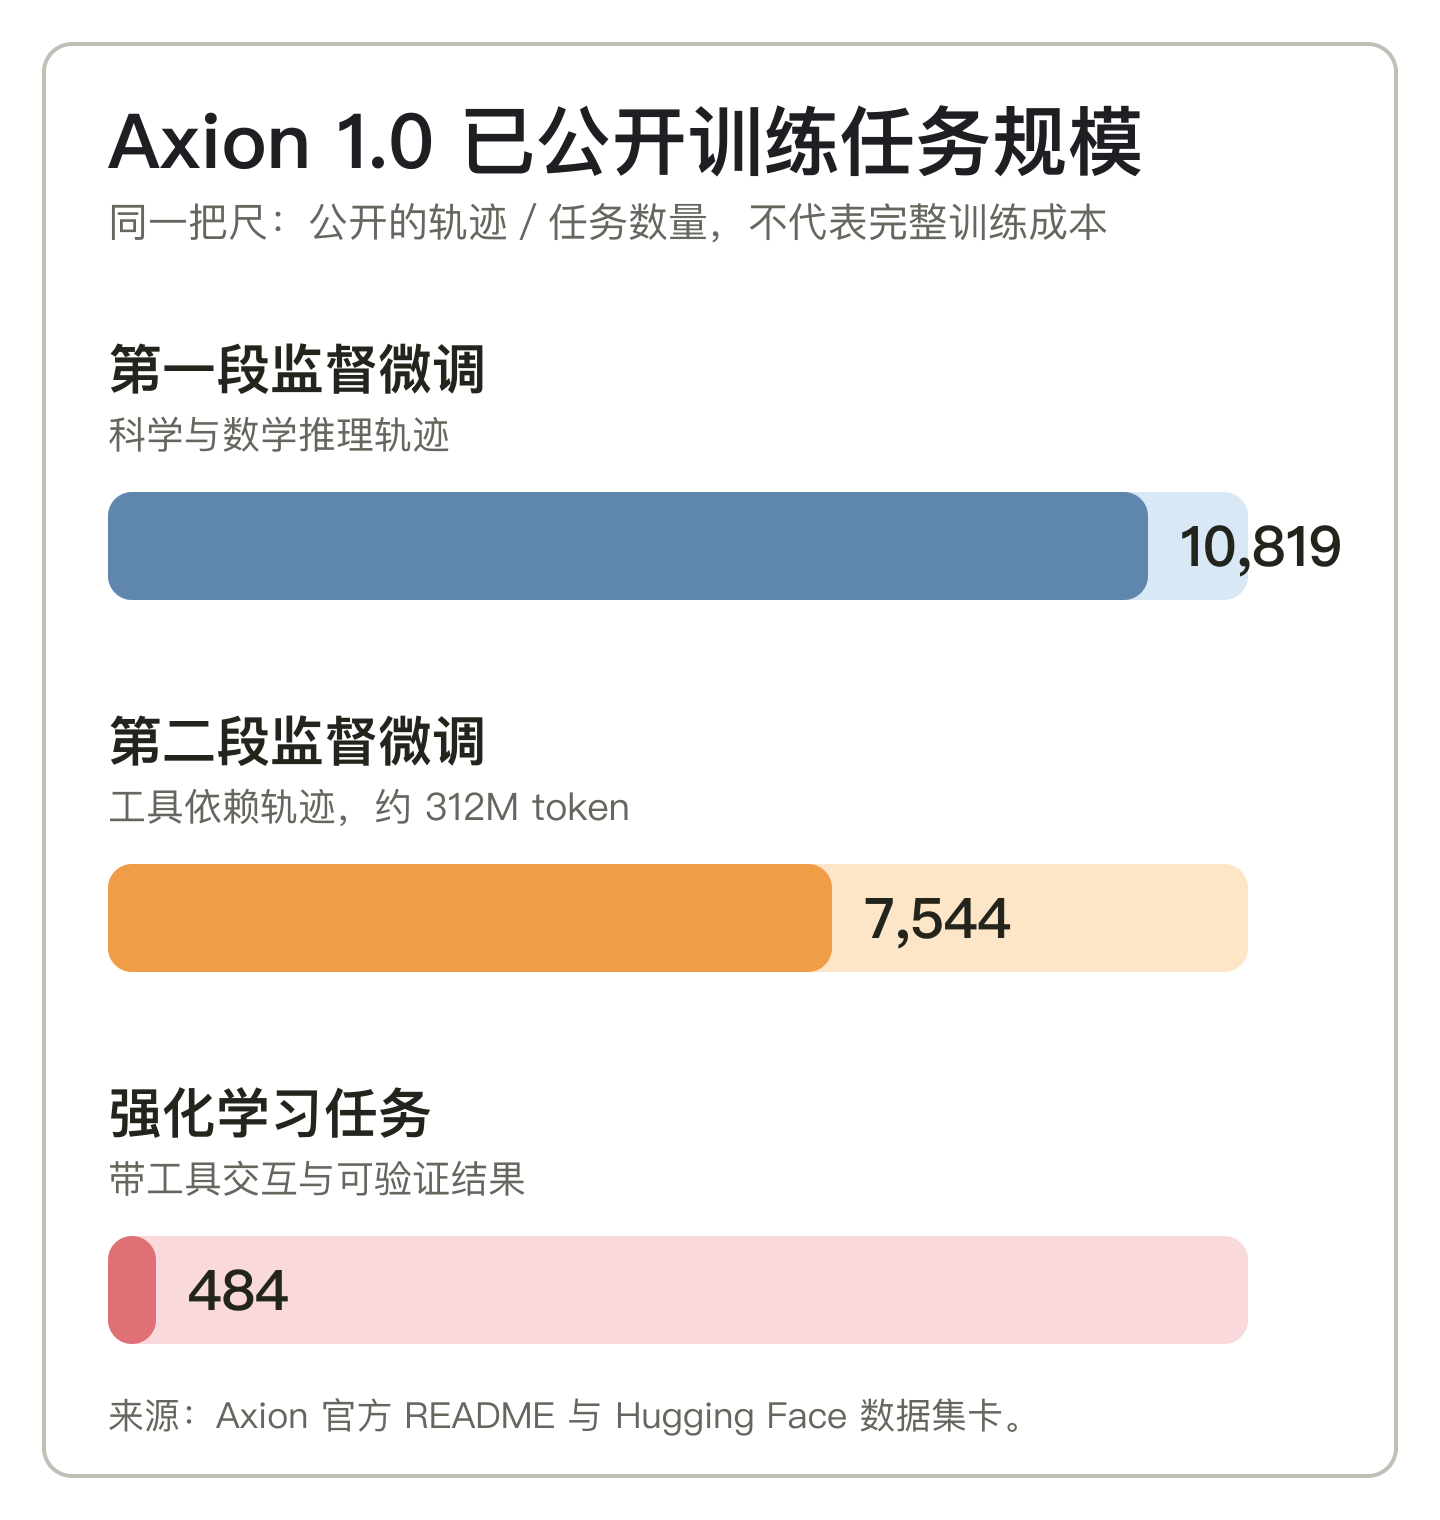
图:依据 Axion 官方 README 与数据集卡整理。前两段是已公开的 SFT 轨迹,RL 任务数量较小,但进入了真实工具交互环境。
把这张图倒过来看,会更接近一个训练负责人该问的问题。不是“数据够不够多”,而是每一段数据能不能把上一段学不到的东西补上。
Stage I 不检索,逼模型先把题意、计算和推导走完整。Stage II 则故意把答案放在工具外面,逼它承认自己不知道,并且去找。到了 RL,奖励才落到一串真实交互上:搜索词对不对、网页有没有读到关键字段、Python 有没有跑出可复查的结果、最终答案能不能和参考结果对上。
如果把这三段都混进一个“高质量 Agent 数据集”的文件夹,训练当然也许能跑,但之后很难解释能力从哪里来。模型突然学会了查库,到底是因为它掌握了工具协议,还是记住了答案模式?一个任务失败,是推理错、检索错、网页解析错,还是奖励脚本本身有洞?能分开,才有机会修。
先别把“少三层训练”听成“少三层活”
Axion 的训练流程很短,至少写起来很短:Stage I SFT、Stage II SFT、异步 GRPO 强化学习。项目没有使用单独的中期训练、DPO 或 on-policy distillation。
这句话很容易被读成一句行业口号:看,Agent 训练不用那么复杂。可仓库真正把功夫放在了训练之前。
第一段 SFT 放了 10,819 条科学和数学推理轨迹。它不允许模型去检索网页,只允许用 Python。题目也不是把公开题库原样倒进去:项目会从基础模型已经会做的题出发,再用组合、参数变化、范围调整和案例分析把题目加难,并用参考答案复核每一次改写。
第二段更接近 Agent 的日常。7,544 条轨迹、约 3.12 亿 token,题目来自 NASA Exoplanet Archive、OpenAlex、UniProt 等公开数据库。脚本先选定实体、计算参考答案,再让模型生成问题;真正求解时,构造数据和答案都会藏起来。那些不靠检索也能蒙对的问题会被筛掉。
这一步才是关键。不是“给模型加一个搜索工具”,而是先保证任务真的需要找证据,且最后有一个可以自动核对的答案。没有这层,训练很容易奖励到一种熟练的表演:工具调得很热闹,答案却无法验证。
到了 RL,模型才在搜索、网页访问、学术检索和 Python 的组合里滚动。最终答案对给满奖励;中间如果有可验证的推进,也能拿一部分分。这里没有魔法,只有一个很朴素的判断:长任务不能只看结尾那一行,过程里得有几个可检查的落脚点。
Axion 真正公开的是“怎么验”,不只是“怎么训”
很多开源模型项目会给权重、给一张漂亮的 benchmark 表,然后把最难复现的部分留在黑箱里:训练数据从哪来,奖励怎么写,失败轨迹怎么处理,评测环境和线上工具环境是不是同一套。
Axion 这次公开了数据构造、过滤、提示词、SFT、异步 RL 和评测准备代码。它甚至把外部 Agent harness 的位置说得很直白:模型要做 Agent 评测,仍需要一层工具执行环境来收集 rollout,再按规则打分。
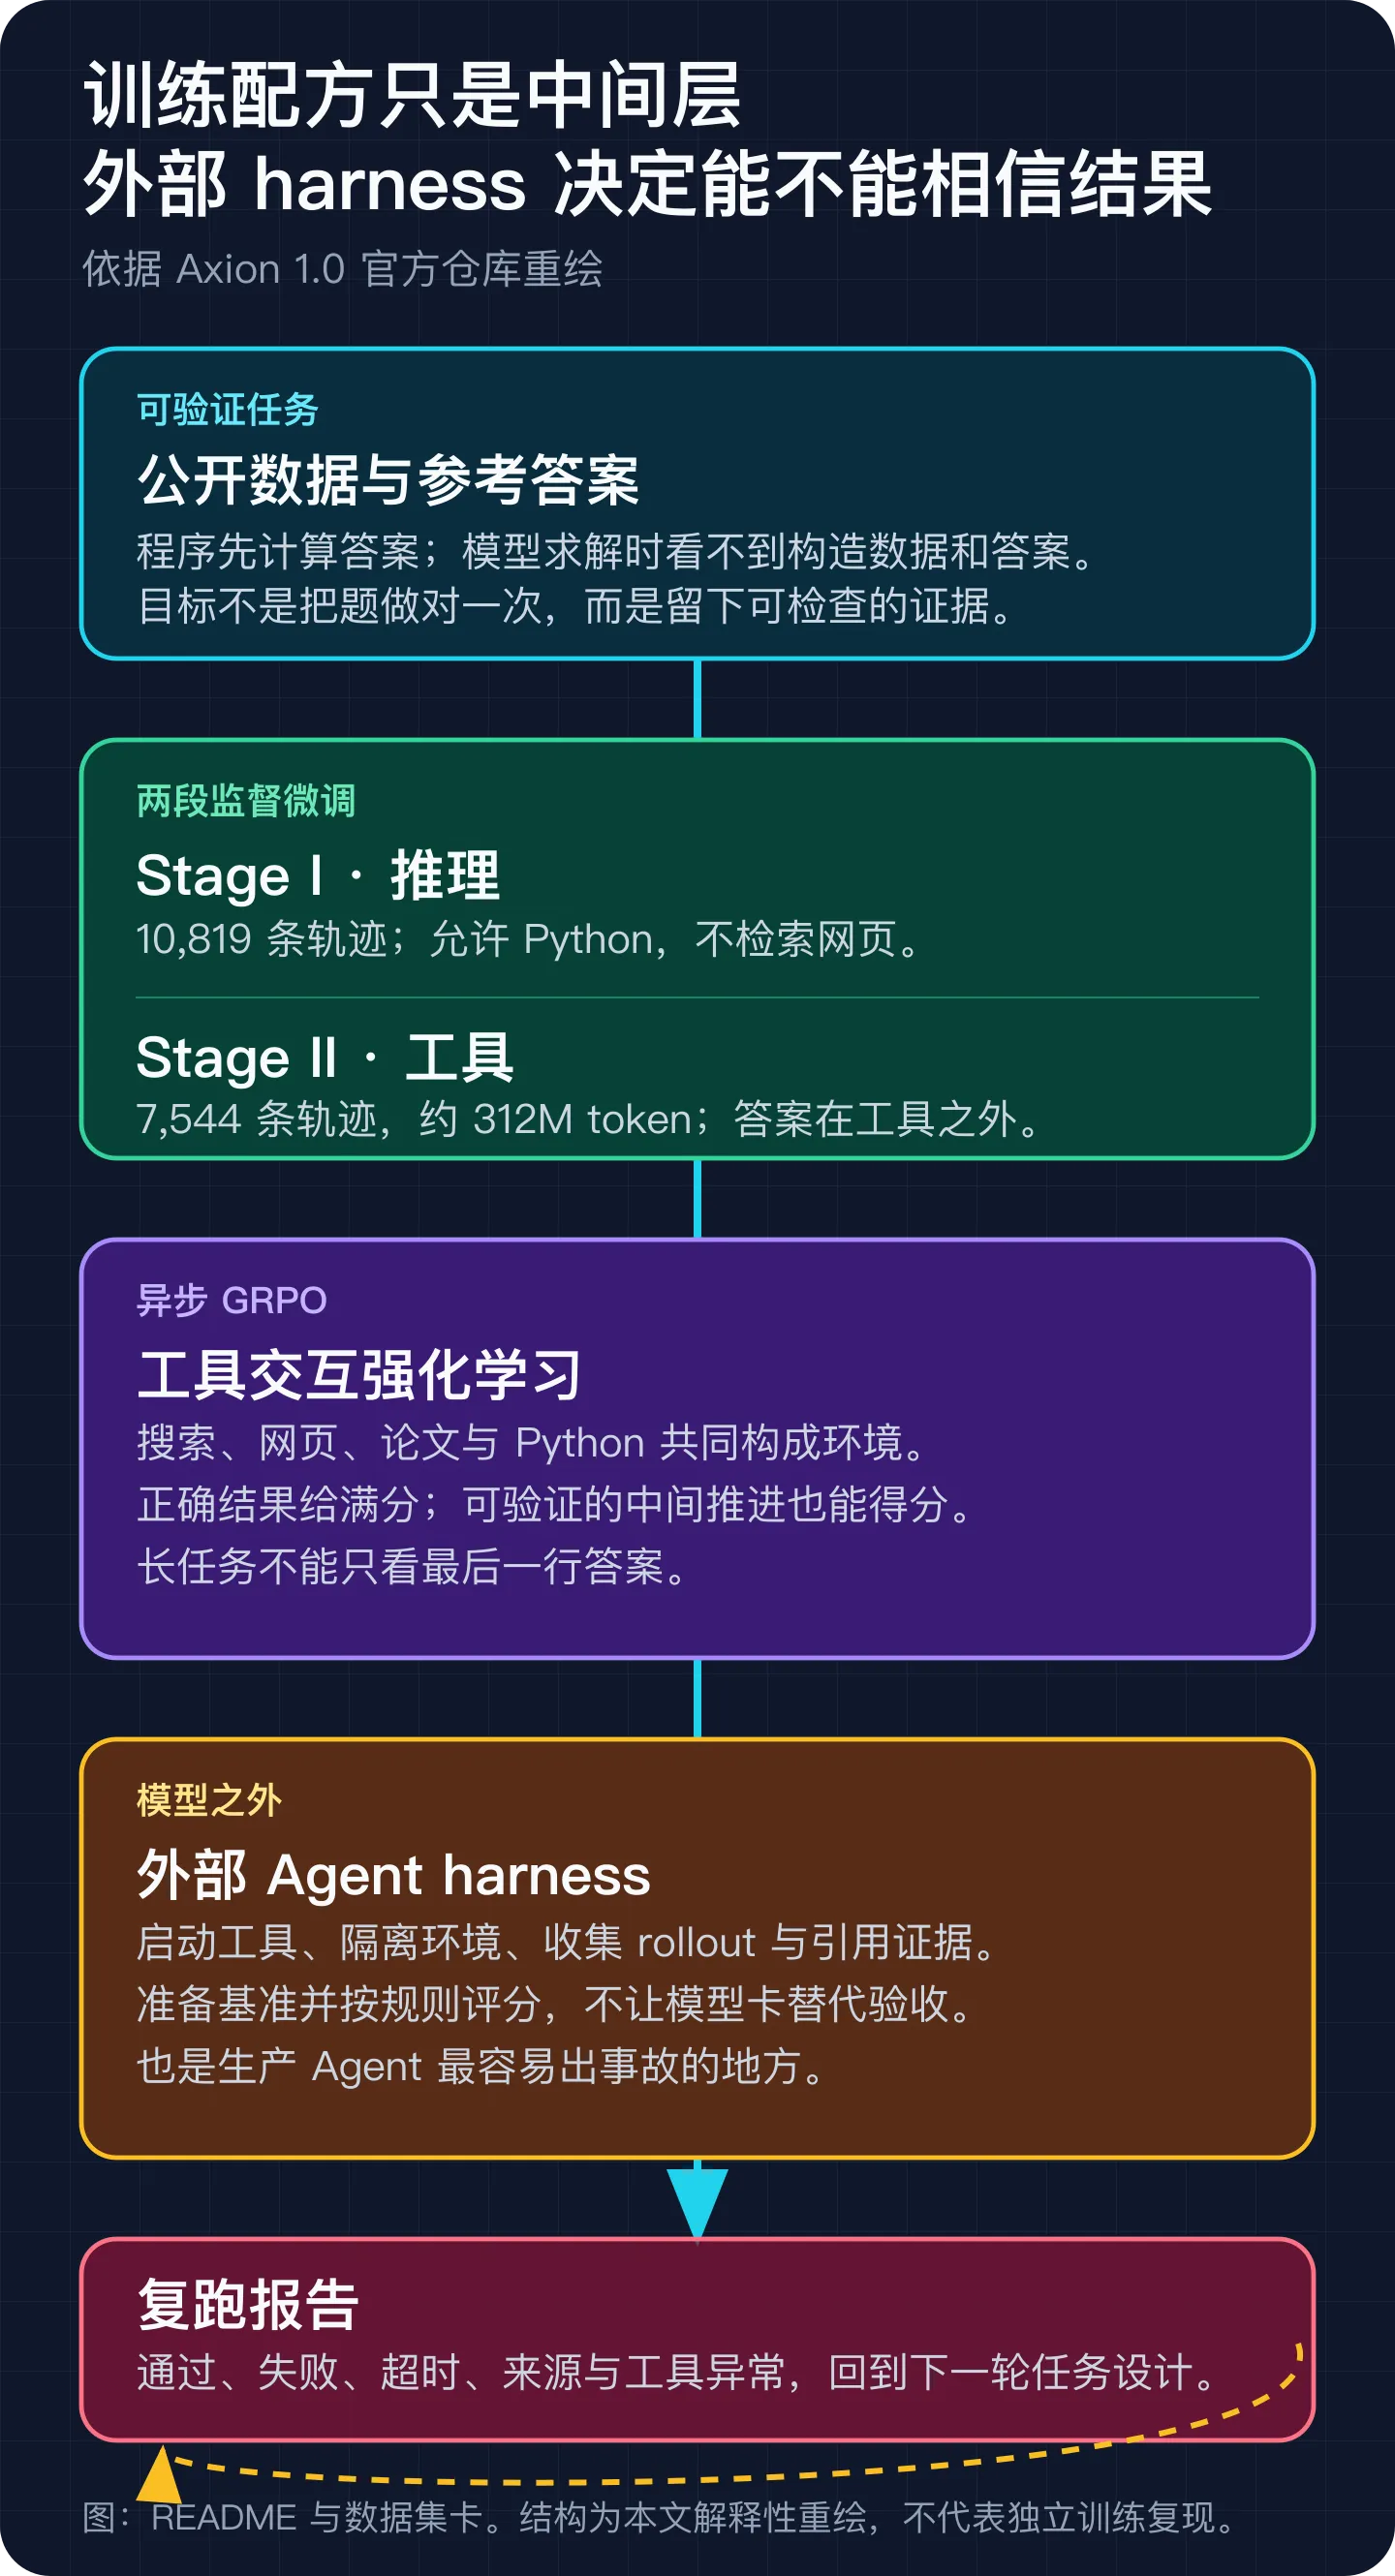
图:本文按官方配方重绘。模型训练只是中间一段;工具权限、轨迹留存与独立评分仍在模型之外。
这会改变一个很现实的讨论。团队常问:“要不要把某个开源模型换进来?”
更该先问的是:“我们有没有一组自己的、能重复跑的任务?”如果没有,不管换的是 Axion、别的 35B,还是更大的闭源模型,最后都只能在 Demo 上凭感觉选。模型说自己完成了,系统却没有证据告诉你它在哪一步拿错了资料、误判了状态,或者把一个本该人工确认的动作直接做掉。
Axion 的启发不是让所有团队去复训 122B。大多数团队根本不需要。它更像一份把问题摆上台面的清单:训练和评测的最小单位,应当是一条带工具轨迹、带参考结果、带评分规则的真实任务,而不是一句“帮我做研究”。
真正难抄的,是把业务任务变成可验证任务
公开项目最容易被低估的地方,往往不是模型结构,而是出题。Axion 的 Stage II 用公开数据库做题有一个很实用的前提:在模型开始前,系统已经能通过程序算出唯一或足够明确的参考结果。于是模型可以自由查、自由走工具,但不能把“看起来有道理”当成通过。
业务 Agent 很少有这么干净的条件。比如让它“整理客户反馈”,答案未必唯一;让它“修复线上告警”,还有权限、时效和回滚;让它“找一份合同里的风险”,甚至需要区分信息抽取、法律判断和人工批准。把这些都塞进一个最终得分,会让训练信号变得混浊。
一个可借的做法是先挑那些可以写验收器的任务。你不必从最复杂的办公流程开始。先做“从指定页面找出某字段并给出处”“把 CSV 转成符合 schema 的 JSON”“在隔离仓库里修复一个有测试的 bug”。它们都有共同点:允许模型有不同路径,但结果、引用、测试或文件 diff 至少有一样能被机器核对。
再往前走一步,才是半结构化任务。这里不再追求唯一答案,而是把评分拆开:事实有没有出处,引用是否指向允许的数据源,输出是否符合字段约束,涉及写入的动作有没有停在审批点。人工只复看系统无法判断的那部分,而不是每次从头读一遍 Agent 的长篇解释。
这和“做一个更聪明的模型”听起来不那么刺激,却更接近能够上线的工作。奖励脚本不是锦上添花;它决定了模型会努力迎合什么。
三道门比一张榜单更值得先跑
Axion 的仓库把外部 harness 留在模型之外,这一点很诚实。任何需要浏览器、数据库、沙箱或业务 API 的 Agent,都不可能只靠一张模型卡片完成验收。下面这三道门,比先换模型更划算。
第一道是证据门。每一个可评分任务都要规定它能访问什么、必须留下什么引用、引用怎样映射到最终结论。没有可回看的来源,模型答对一次也只是偶然;有来源,才知道它是不是恰好撞对了答案。
第二道是动作门。把读操作、可逆写操作和不可逆操作分开。模型可以在隔离目录里改文件、跑测试、生成候选;涉及真实账户、真实数据或生产系统的动作,需要停在明确的批准节点。这不是为了拖慢 Agent,而是避免训练时把“动作多”误当成“任务完成得好”。
第三道是复跑门。同一任务应当能在同样的输入、工具版本和权限下重跑;超时、网页变动、服务拒绝、解析失败都要留下状态。否则某个模型在演示当天拿到高分,到下一周就没有办法分辨是模型退步,还是外部环境变了。
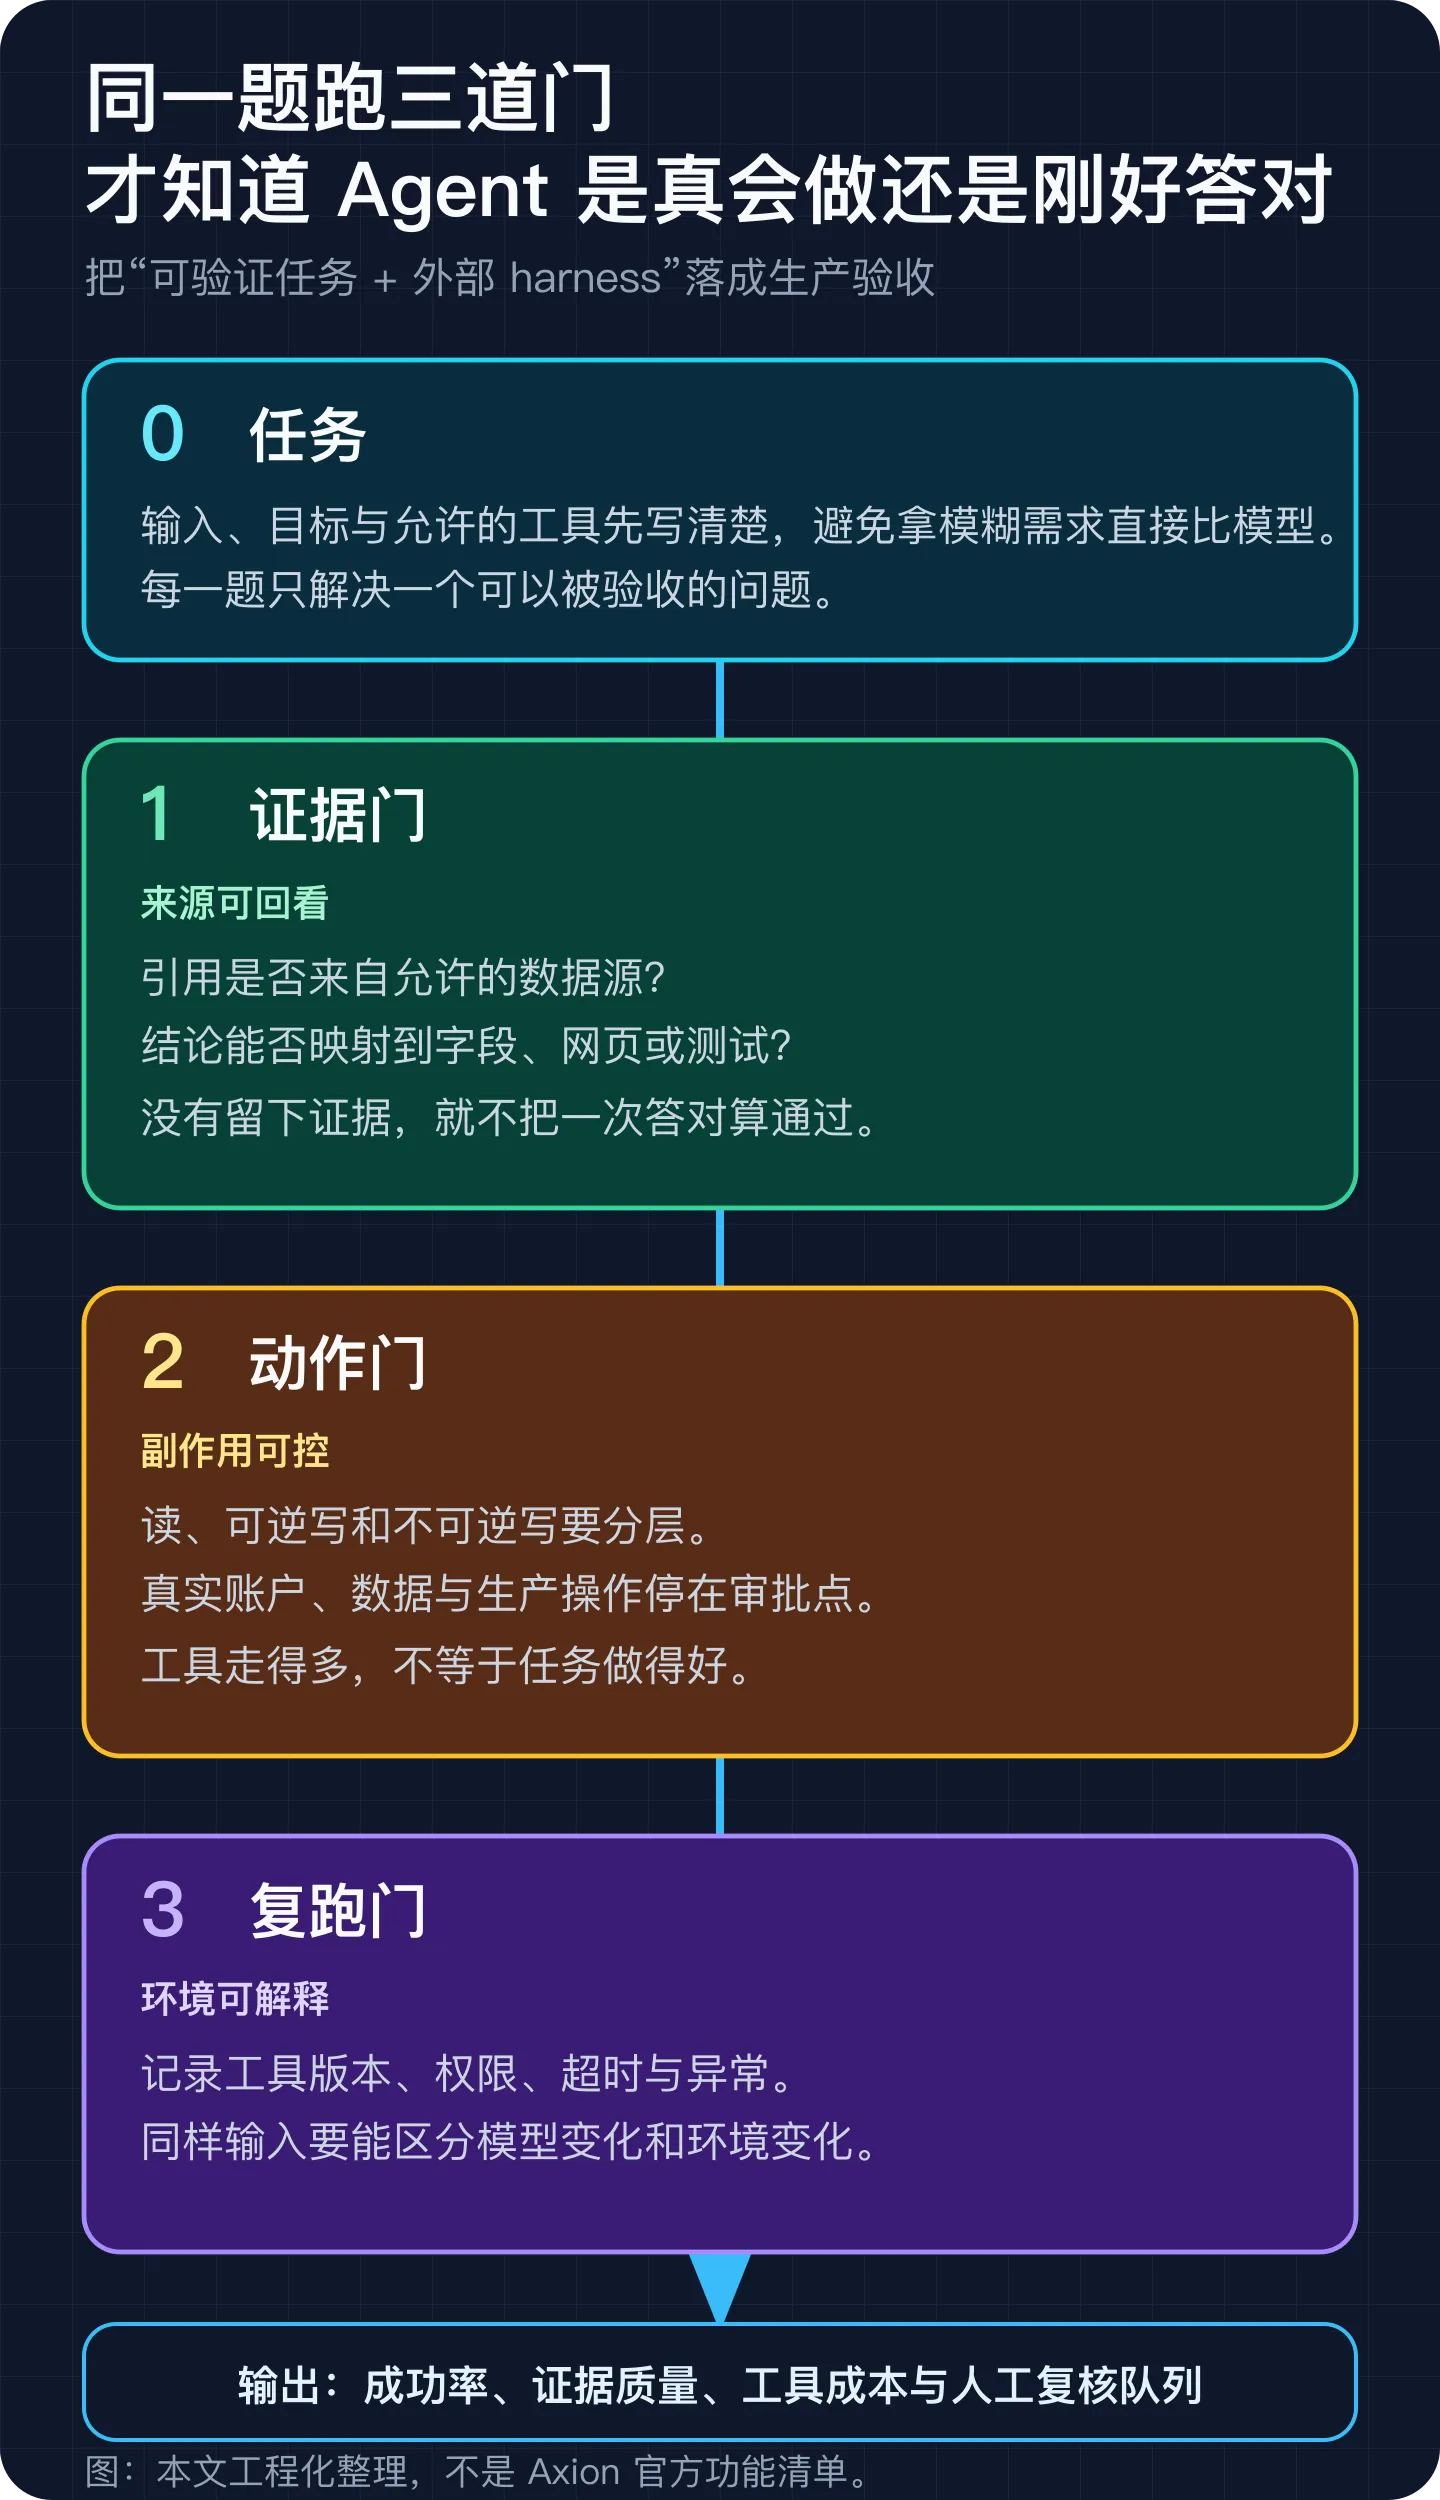
图:本文整理的评估门槛。它们不是 Axion 官方功能清单,而是把官方“外部 harness + 可验证任务”原则落到生产场景的工程化补充。
有了这三道门,模型对比才开始有意义。你可以换不同底座、不同温度、不同工具描述,甚至不同 Agent 编排方式,然后看成功率以外的东西:哪个模型总在引用上丢字段,哪个模型喜欢多走几轮工具,哪个模型一遇到拒绝就给出没有证据的答案。那才是可以指导预算和路由的差异。
122B 的成绩,先放在“待验证”这一栏
仓库给了两套模型信息:35B 版本以 Qwen3.6-35B-A3B 为底座,122B 版本以 Qwen3.5-122B-A10B 为底座;后者总参数 122B、一次只激活 10B。官方表格里的 122B 成绩很吸睛,但也要把脚注读完。
第一,README 链接的是一个 35B 的社区复现 checkpoint,并明确写了它不是官方 Axion checkpoint。122B 的官方可下载权重并没有在 README 中给出。把“论文里跑过的 122B”直接当作“今天能部署的 122B”,中间少了非常长的一段路。
第二,官方给出的约 90 和 240 GPU-hours,只是两段 SFT 在 32 张 GPU 条件下的记录,不是完整 RL、数据生成、调试、评测和推理服务的总账。把这个数当成“我也能用 240 GPU-hours 做出同样 Agent”,就有点像只看编译时间,不看 CI、测试环境和线上回滚。
第三,项目自己的表格中,部分商业模型成绩带星号,表示由 Axion 团队运行;不同模型是否拿到同样的工具、网页访问和提示词条件,需要独立复核。它足以成为值得跟踪的研究结果,不足以替代你的选型结论。
项目在推理指南里也没有假装事情很轻:要先把原生 SFT checkpoint 导成 Hugging Face 格式,再用 vLLM 服务;评测时仍要接外部 harness。真正碰到过模型服务和工具层的人,看到这里应该会松一口气——至少它没有把最容易出事故的那段藏起来。
还有一个容易被参数表遮住的事实:122B 总参数、10B 激活参数,并不等于“10B 模型的所有成本”。MoE(混合专家)确实让单次计算只调动一部分参数,但权重存储、加载、并行策略、上下文长度和工具调用等待都还在。选型时应分别量服务显存、首 token 延迟、长任务吞吐和工具失败后的重试成本,别用一个“激活参数”替代整张账单。
同理,90 或 240 GPU-hours 也不该被看成便宜或昂贵的结论。它给你的是一个非常有价值的边界:官方声称,两个 SFT 阶段在特定硬件配置下能落在这个量级。但你的数据清洗、奖励实现、异步 rollout、排错和回归集会带来另一套成本。把两张账分开,才不会在训练前乐观、在上线后发愁。
想借这条路,先做一个小得多的版本
如果你的团队已经有 Agent,不必等一个新模型权重。可以从十来个任务开始:每个任务只解决一个明确问题,例如“从三份规格文档里找出互相矛盾的字段,并给出带出处的判断”,或“根据指定仓库和一个已知缺陷,定位文件、写补丁、跑过给定测试”。
接着把任务拆成四样东西:允许哪些工具;正确结果怎么判;哪些中间证据值得留;失败时谁来复看。前两样决定训练信号,后两样决定你有没有资格相信训练后的结果。
然后再比较模型。不是只看一次成功率,而是把同一批任务放进隔离环境,记录工具调用、引用来源、测试输出和人工复核结果。若一个模型只是在答案框里更会说,却不能稳定留下可验证的过程,它对生产 Agent 的帮助很有限。
Axion 的价值恰好在这里:它把一个常被模型发布遮住的事实摊开了。Agent 的能力不是从“多会推理”直接跳到“能可靠干活”,中间隔着数据、工具、奖励、服务和评测。少几层训练配方可以,但少不了这些证据层。
官方材料在这里:Axion 1.0 GitHub 仓库、技术报告 和 训练数据卡。本文没有独立复现实验,文中成绩均按项目方公开口径表述。
如果你手上已经有一条会调用工具的 Agent 任务,你最难自动判分的那一步是什么?