
长会话 Agent 变慢?Claude 把历史留在服务端了
Message Threads 让长任务后续只发增量内容,官方称 500K—1M token 时首字等待可少约 35%。但 Token 不会少花,5 分钟空档也会让线程失效。
长任务 Agent 最磨人的时刻,常常不是模型想不出来,而是它已经记了一大堆东西,下一句却迟迟不肯开口。
改了几十个文件、跑过几轮测试、又塞进几张截图以后,用户只补了一句“继续”。客户端却还得把前面所有消息、工具结果和系统提示再传一遍。模型真正开始回答前,先把自己刚经历过的事重看一遍。上下文没满,等待已经很有存在感了。
Claude 这两天公测的 Message Threads 瞄准的就是这段等待:首轮照常发送完整对话;后面的请求只带新增消息和上一次响应 ID,把历史暂时留在服务端。官方给出的数据是,默认启用它的 Claude Code 用户中,500K—1M token 的请求,中位首 Token 时间约下降 35%。
这不是一张“上下文终于免费”的券。它更像给活跃 Agent 加了一条短时快车道。接对了,长任务不必每轮搬家;接错了,5 分钟一停、一次重试、一个字段改动,还是会在恢复路径上摔一跤。
图:Claude 官方公告。本文基于公开公告与 API 文档整理,未做独立 API 实测。
它省下的,是“把历史再搬一遍”的时间
很多人看到“服务端保留对话”,第一反应是缓存。两件事其实别混在一起。
Message Thread 解决的是请求传输和准备阶段。 长会话里,过去的消息、工具调用结果、截图引用会越积越多。没有线程时,每次调用都要把它们重新上传,服务端还要验证、分词,再等模型开始生成。线程让后续请求只发新的一轮,API 在调用模型前把对话重新拼起来。
提示缓存解决的是读这些历史时能否按缓存计费。 官方文档 写得很直白:线程不会自动替你开启提示缓存;模型每轮仍会读取完整对话,所以 Token 用量、标准价格和速率限制都不变。
这条分界很实用。假如你的瓶颈是“Agent 每次先沉默十几秒”,线程值得试;假如你的账单已经被长上下文拖着跑,只接线程不够,还得单独设计缓存断点、压缩策略和任务切片。别拿延迟优化去许诺成本优化,账单通常不配合演戏。
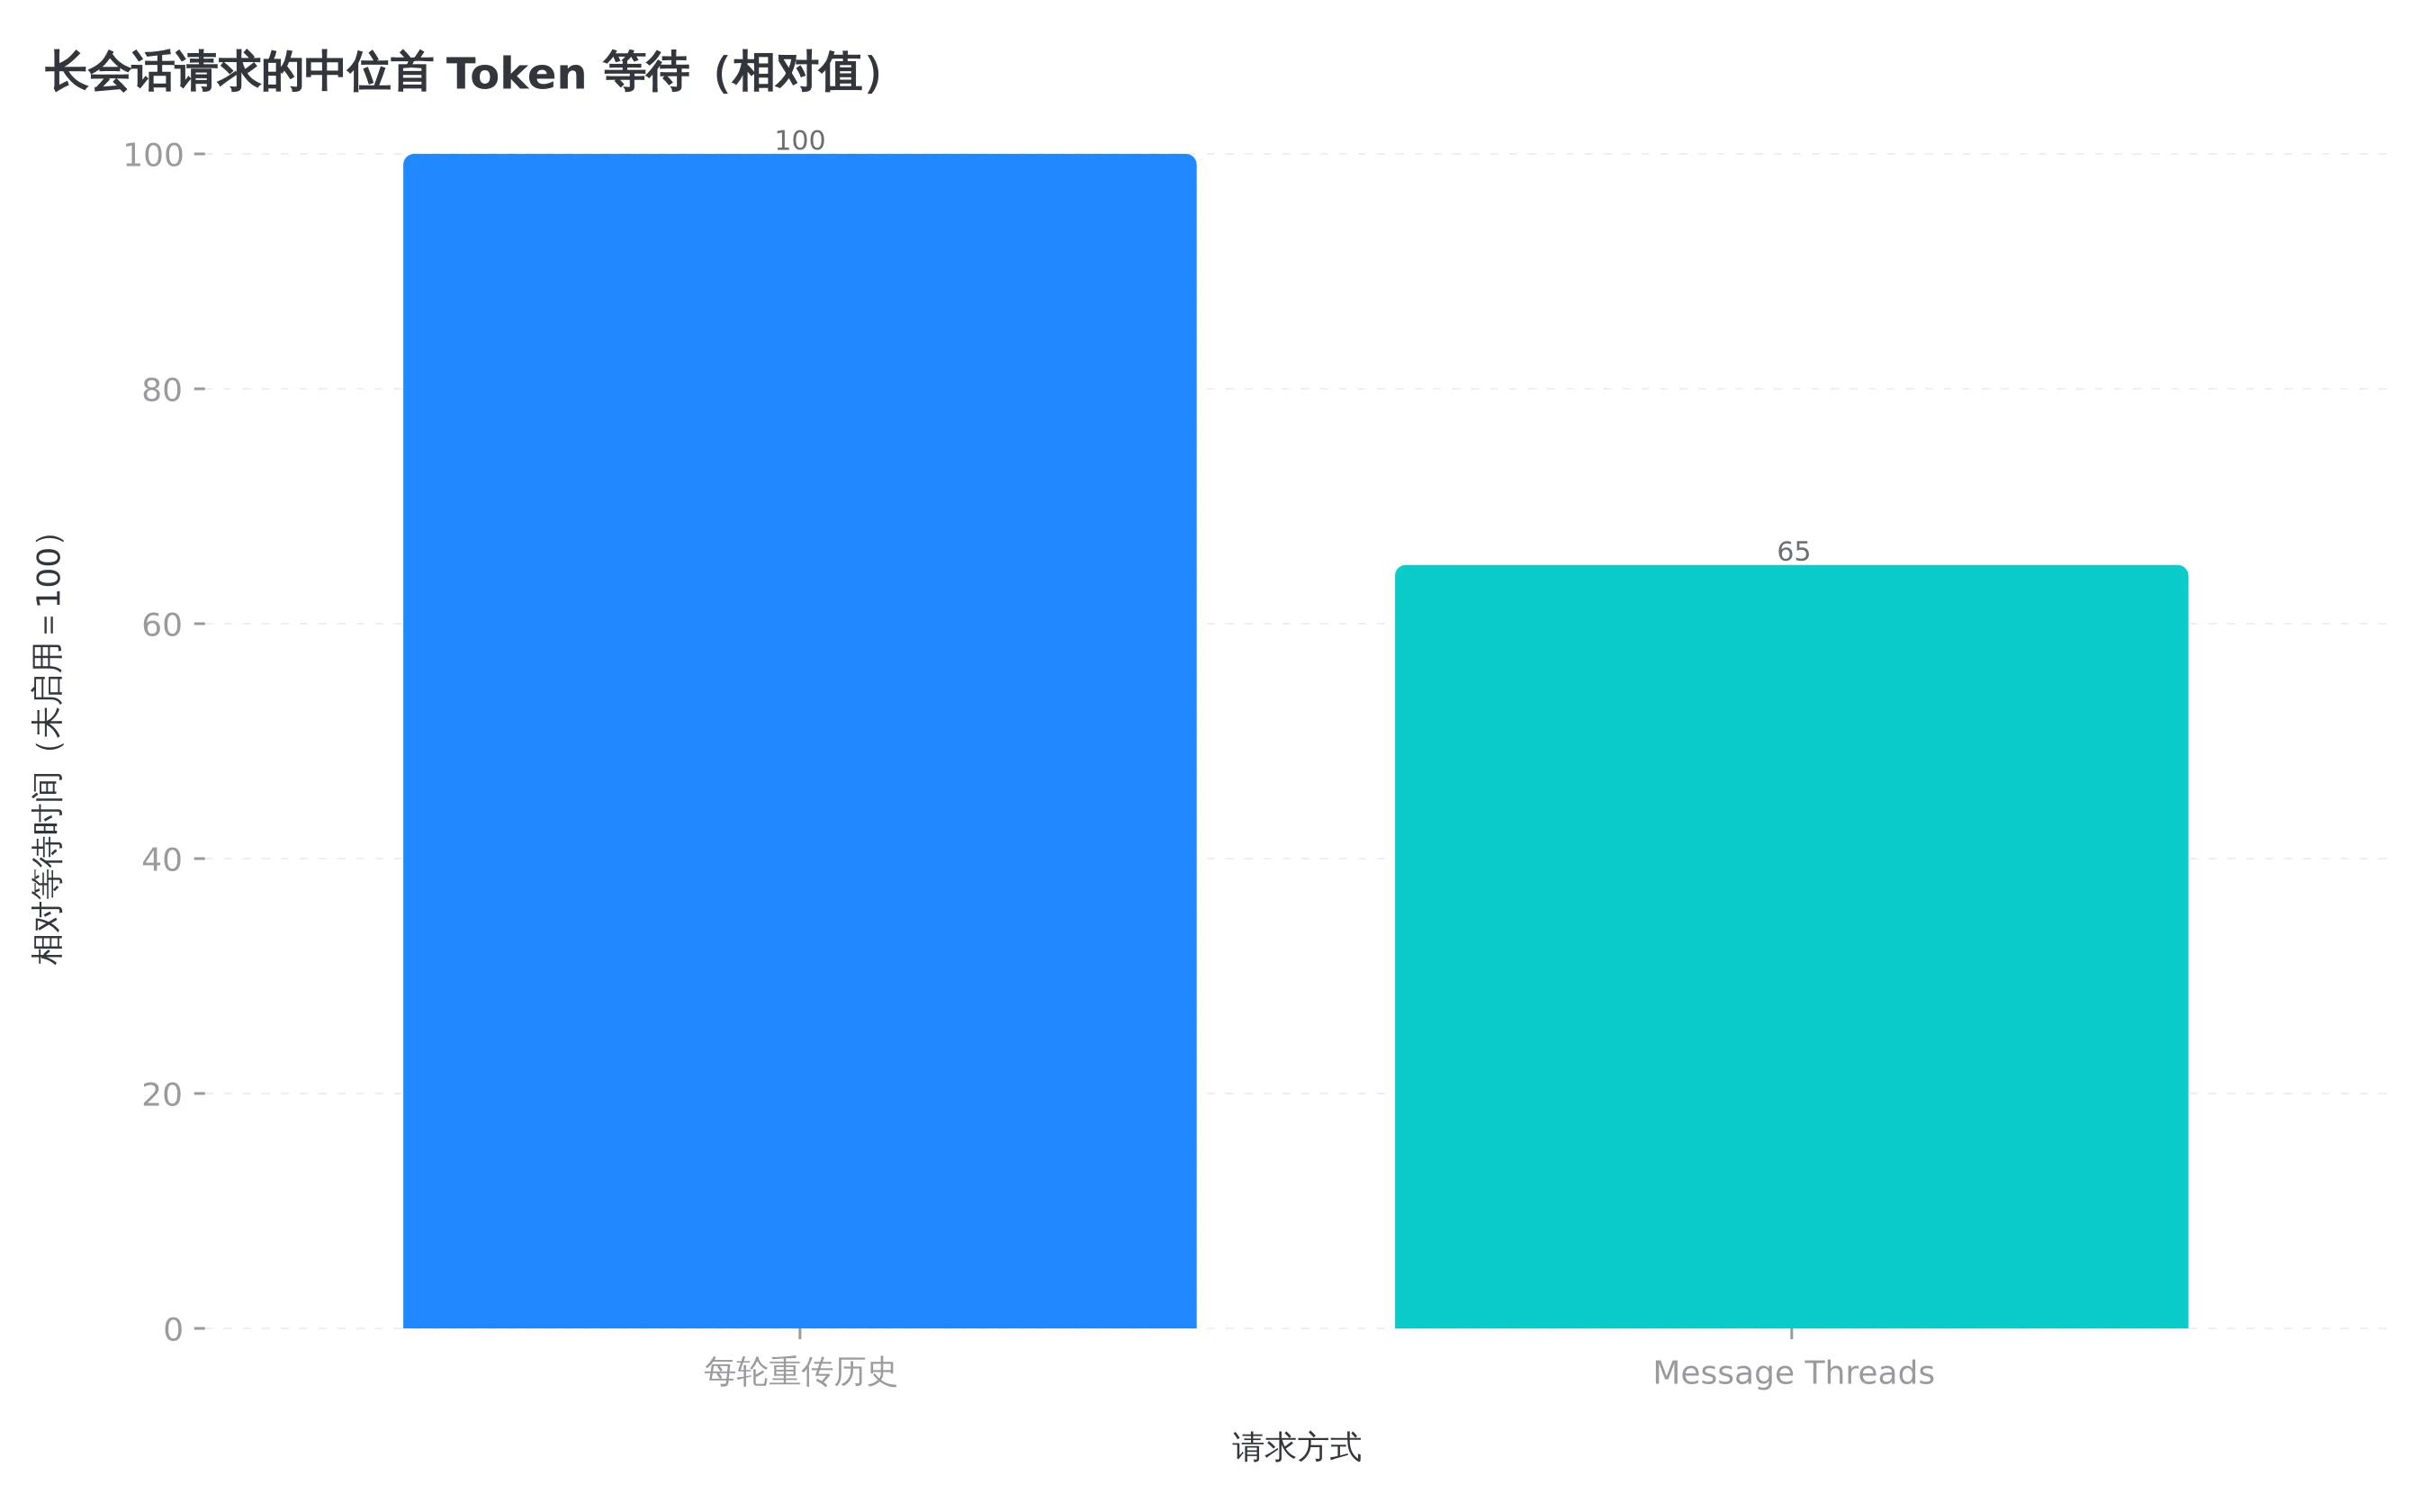
图:以未启用时的中位首 Token 等待为 100,图中 65 为官方“约下降 35%”换算的相对值,并非绝对毫秒数据。
接入不复杂,恢复路径才是正事
第一轮把完整历史、系统提示和工具定义送过去,并创建线程;以后只传新增消息和上次响应 ID。最小调用看起来大概是这样:
const first = await client.beta.messages.create({
  model,
  system,
  tools,
  messages: fullHistory,
  thread: { type: "create" },
  betas: ["message-threads-2026-08-12"],
});

const next = await client.beta.messages.create({
  model,
  messages: [newTurn],
  thread: { type: "continue", previous_message_id: first.id },
  betas: ["message-threads-2026-08-12"],
});
这里有两个很容易被忽略的约束。继续请求里别再带 system 和 tools,它们沿用创建线程时的版本;模型、工具选择、思考配置、MCP 服务器集合等固定字段,也要保持一致。改了,就应当从完整历史重新创建一条线程,而不是指望服务端替你猜。
还有一条更关键:应用自己的消息副本,才是事实来源。 API 不会告诉你某一轮有没有被成功保存。线程是尽力而为的;它最后一次请求后 5 分钟会过期,服务端会在最后使用后不超过 1 小时清掉。继续失败时,返回 thread_not_found,正确动作是拿自己的完整副本重放,建立新线程,再接着跑。
这很像给 Agent 多加了一层会话加速器,而不是把记忆外包出去。进程重启、队列延迟、人工审批、网络抖动都可能让它走到重放分支。谁把历史只存在临时线程里,谁就在等一次 404 来提醒自己备份的重要性。
有三种 Agent 很适合先拿它试跑
第一种是持续工作的编程 Agent。文件编辑、测试输出、工具结果不断累积,且任务仍在连续推进,最符合线程的节奏。
第二种是计算机操作 Agent。一串截图留在同一会话里,比每轮重新上传它们更轻;不过首张新图片或与旧对话不兼容的输入,可能触发重放,所以视觉任务的素材清单也该在本地留底。
第三种是文档和图片很多的处理流。比如合同审阅、报告整理、资料问答。它们最容易感到首字等待变长,也最容易把“线程在内存加密保存”误读成合规承诺。官方标注它不符合零数据保留(ZDR)和 HIPAA 条件,数据策略卡得紧的团队,不要只看速度。
反过来,隔半小时才回一次消息、需要频繁换系统提示或工具集、又不愿保存完整会话副本的工作流,就不该把它当救命药。那类任务更适合先切会话、做摘要,或者把状态拆到自己的存储层。
上线前,给它留一条很普通的后路
第一次接入不必从最贵、最长的 Agent 开始。挑一个能连续跑几分钟、又允许重放的任务,盯住三件事:
- 首 Token 等待是否真的下降,而不是只看总耗时;
- 线程失效、流中断或重试时,能不能从本地历史无损重建;
- 含敏感内容的会话,是否符合团队的保留与访问要求。
如果这三项都过了,再去接更长的编码循环、浏览器任务和文档工作流。Message Threads 最值得借的地方,不是把上下文藏得更深,而是提醒我们:让 Agent 跑得久,状态得能加速,也得能回来。
你手头哪个长会话最常卡在“模型还没开始说话”?