
让 Agent 后台接活:真正该留给人的,是哪几次拍板
新开源的 Agent Autoloop 把事件、命令行 Agent、请示卡片和续跑拆开了。重点不是“全自动”,而是把不可逆决定准确地留给人。
写代码 Agent 最容易浪费人的时刻,不是它报错,而是它停下来问了一句:“这个 PR 要不要合并?”
你看了一眼,去开会了,或者把终端关了。它的下一步却被卡在这里:要么进程一直占着,要么这段上下文就散了。等你回来,事情又得从“刚才做到哪了”开始捡。
今天看到一个刚开源的项目 Agent Autoloop,我觉得它有个很对的切口:不急着讨论怎样让 Agent 更自主,先把 “等你决定” 变成系统里的一个正式状态。
仓库说明写得很直白:它把定时任务、GitHub Issue、业务告警这类事件接进一个本地中台,交给 Codex、Claude Code 等命令行 Agent 处理;遇到拿不准的事,Agent 退出,状态留在本地,等人从飞书、桌面通知或其他通道回一张卡片,再接着原来的会话跑。
这篇不做项目复述。我想只抓住一件事:如果你也准备让 Agent 在后台接活,真正要先写清楚的不是 prompt,而是哪几次拍板必须留在人手里。
先把“等待”从一个卡死的进程,变成一种状态
很多自动化的真实流程是这样的:Agent 收到任务,跑到一半碰到模糊项,继续做有风险,停下来又浪费。
常见的补法是让进程挂着等回复。看着省事,代价却很隐蔽:后台任务持续占资源、上下文持续消耗、重启后的恢复路径也说不清。更麻烦的是,系统会慢慢把“等人一句话”跟“任务正在执行”混在一起。
Agent Autoloop 的流程正好拆开了这两件事:事件进来,规则决定谁去哪个目录处理;一轮做完就退出;需要决定时发一张卡;人回复后,再把原对话接起来。
它不是让 Agent 永远运行,而是让它在该停的时候干净地停。README 把这叫作“挂起零消耗”:等待状态保存下来,等待期间没有 Agent 进程,也不继续花 Token。这个思路不新,放在命令行 Agent 上却很实用——人类的响应速度不该决定一个 Worker 要挂多久。
不是所有“请示”都一样,先分成三种颜色
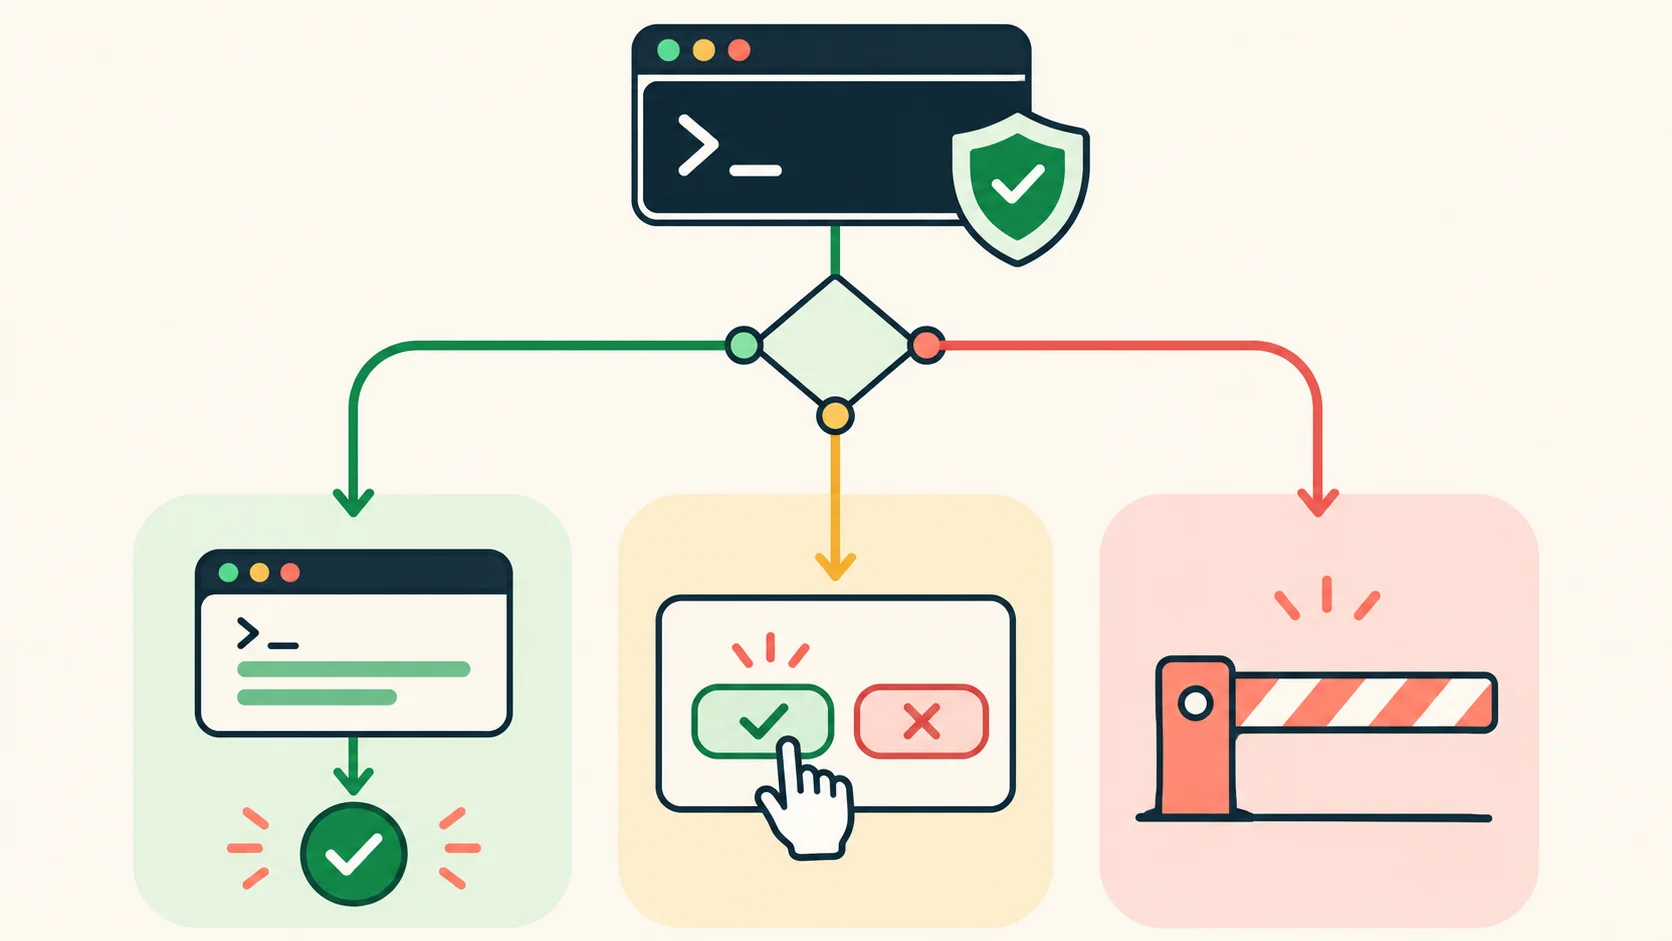
真正开始配规则时,我建议先别写一堆复杂的自动化。拿一张表,把动作分成绿、黄、红三类。
- 绿色:可重复、可验证、可撤销。 比如整理日报草稿、跑测试、给 Issue 打标签、生成待审 PR。它们适合自动执行,但仍要留下结果和验收证据。
- 黄色:信息不足,但补一个决定就能继续。 比如需求有两个实现方向、告警需要确定是否升级、发布说明的措辞需要确认。这里应该发卡片,不要让 Agent 自己猜。
- 红色:不可逆、有成本、对外产生影响。 删数据、重启服务、花钱、对外发消息、改权限、换密钥、合并到生产分支,都应该默认停在人的手里。
这个项目的 README 已经把删数据、重启服务、花钱、对外发消息列为需要拍板的例子。我的理解是:红线不该藏在长 prompt 最后一段,而要变成调度层默认拒绝的规则。你之后换模型、换 Skill、换通知通道,这条边界也不该跟着丢。
于是,“人参与”不再等于每一步都来点一下,而是只接住那些会改变成本、权限、外部承诺和不可逆状态的选择。
这个项目最值得借的,不是自动化菜单
它有每日早报、Issue 跟进、告警排查、网站巡检、PR 交付等现成模板。模板当然方便,但更值得看的,是它给自动化补的四个底座。
第一是 事件溯源。项目把状态从只追加的日志中计算出来,并把日志与索引一起落盘。出问题时,重点不是问“现在卡在哪”,而是能追到“是谁在什么时候因为什么规则领了这份活”。这才有资格谈自动化。
第二是 指令和外部数据分离。Issue 标题、用户反馈、Webhook 内容都很适合被当作资料,却不适合直接拼进高权限提示词。项目把它比作 SQL 参数化:事件里的文字只能作为数据,Agent、目录和权限只由本机规则决定。对会接公网事件的 Agent,这不是锦上添花。
第三是 跳数熔断。Agent 完成后又触发新事件,新事件又叫起另一个 Agent,很容易在一次配置失误后自己给自己派活。它给事件链设置上限,超过八层只记录并通知,不再继续调度。数字不一定要照抄,但“自动化必须有停止条件”该写进每个系统。
第四才是 等待期间不占资源。它解决的是人的注意力和机器资源之间的错位:你可以晚点答,系统也不会把“等待”伪装成“还在干活”。
这些机制不会替你判断一条业务规则对不对,却会让错误发生时更容易停住、查清、再继续。
如果只想试一次,从一个低风险试跑开始
项目支持 macOS 和 Linux,要求 Node 24、Git、curl,以及已登录的命令行 Agent。安装前请先读它的 INSTALL.md 和 SECURITY.md,尤其是你准备接 Webhook、飞书或交付流程的时候。
我更建议把第一条规则放在没有外部副作用的地方,例如每天把本地笔记和提交整理成一份草稿:
{
  "name": "早报",
  "when": { "cron": "0 9 * * *" },
  "to": "codex",
  "cwd": "~/notes",
  "prompt": "整理昨天的笔记和提交,写今天的早报。"
}
先用项目提供的 agent-autoloop try 跑通“提问 → 退出等待 → 回答 → 继续完成”这条最小链路,再用 agent-autoloop check 校验规则。这个顺序比一上来接 PR 自动交付稳得多。
然后盯住三件事:卡片有没有只在黄色、红色动作前出现;回答后是不是恢复了同一个任务;每一轮能不能通过状态和日志说清来龙去脉。三件事都对了,再把 Issue、告警和部署慢慢接进来。
开源第一天,最该保持的克制
这个仓库创建于 11 月 3 日,发布仍很新。README 提到 Codex、Claude Code、ACP 的多轮问答和跨进程续接已经跑通;部分 Webhook 模板只在本地模拟服务验证过。它展示了清晰的设计和可运行的入口,但不等于已经替你验证过生产环境里的权限、重试、密钥轮换和事故恢复。
所以它适合拿来学习一套“后台接活”的结构,也适合在低风险任务上试跑;不适合因为一句“全自动”就直接接管生产动作。
我喜欢它的地方,恰恰不是把人从流程里删掉,而是承认人的判断很贵,应该只花在真正需要判断的地方。
你现在最想从 Agent 手里收回、但又不想每天守着做的一件事是什么?