
新站接入 Cloudflare,AI Agent 默认进不了广告页
Cloudflare 今日给新接入域名启用 AI 流量新默认值。搜索可留,训练和实时 Agent 在广告页会被拦。真正要做的,是把内容边界和用户任务分开配置。
今天有一类访问,可能还没碰到你的应用代码,就已经被 CDN 拒在门外了。
Cloudflare 从今天起为新接入的域名启用一套新的 AI 流量默认规则。有广告的页面里,训练类爬虫和代表用户实时行动的 Agent 会默认被拦,搜索类访问仍然放行。官方说明 写得很清楚,改的不是某个模型的能力,而是网站对自动化访问的默认态度。
这件事看起来像站长圈的小更新,实际上会落到很多很日常的动作上。你上线一个文档站,盼着内容能被搜索到。你做一个带商品、表单或会员页的产品站,又不想任意 Agent 把页面当免费 API。你想拒绝训练,又担心把本来会带回访客的搜索入口一起关掉。
过去很多人的解法只有一个大按钮,拦或者不拦。
好家伙,现实已经不肯配合这个按钮了。
Cloudflare 这次把自动化流量拆成了搜索、Agent 和训练三类。分类听起来不复杂,真正有用的地方在于,它终于承认这三件事不是一回事。
搜索,是先收集或索引你的内容,之后再拿去回答问题。它和传统搜索引擎的逻辑最接近,网站通常期待的是被发现、被引用,再把人带回来。
Agent,是替某个正在等待的人实时做事。官方举的例子包括 ChatGPT-User,以及由 Gemini 或 Claude 驱动的浏览器使用能力。它不是先把你的站收进一个索引库,而是现在就来打开页面、读取状态、填写步骤,甚至尝试完成任务。
训练,则是把内容带走,用于训练或微调模型。它最容易被理解成内容边界问题,因为数据一旦进入训练链路,后续如何再出现,网站很难逐条追踪。
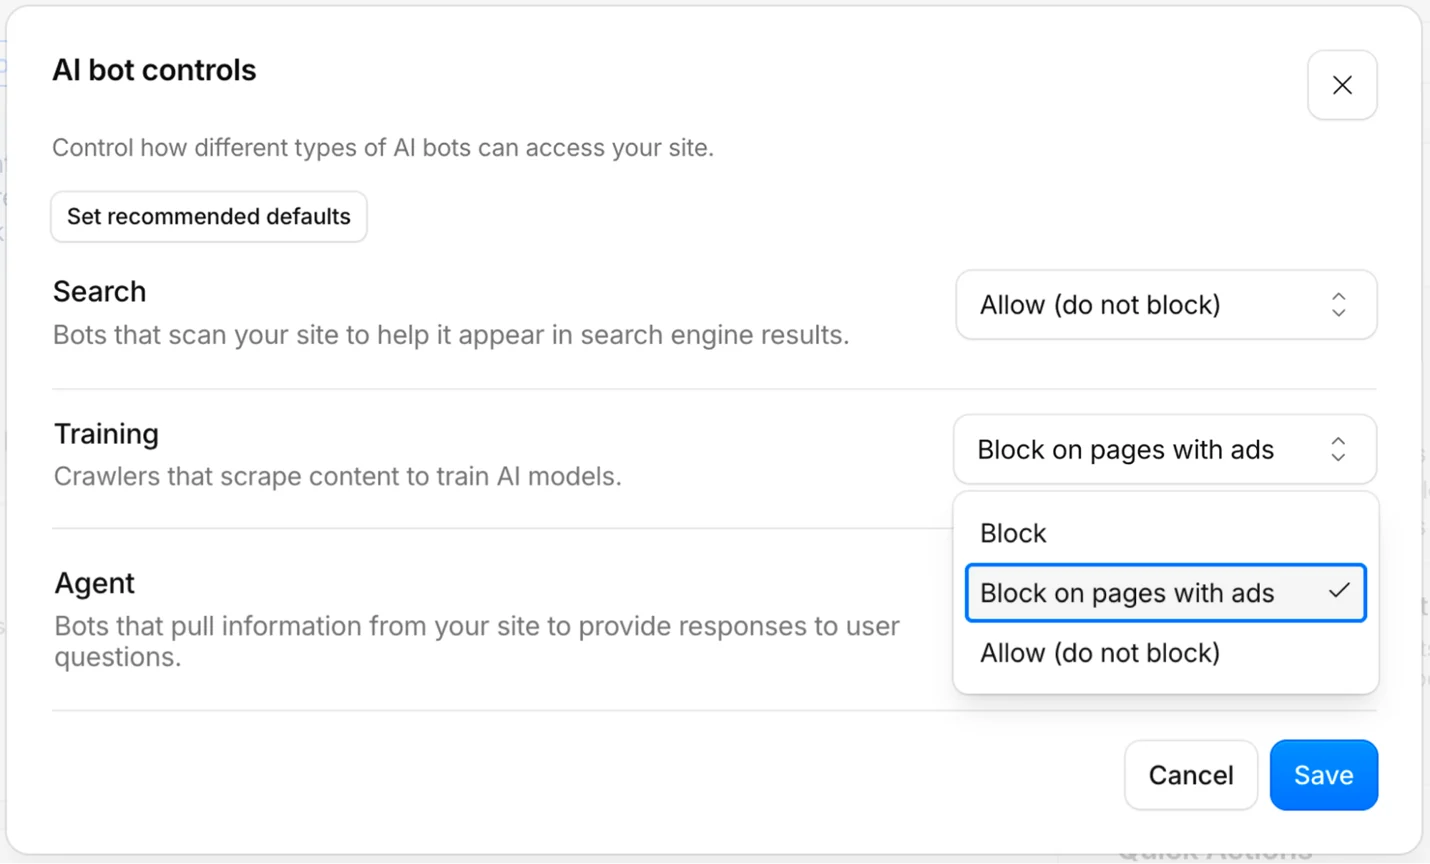
Cloudflare 官方截图展示了按用途配置 AI 流量的入口。
把这三种访问揉成一个词,叫 AI 爬虫,方便是方便,决策会很糊。你会发现自己在回答一个根本没法回答的问题,究竟要不要允许 AI。
更接近现实的问题是,你想让谁,以什么目的,在什么页面上做什么。
这就像给办公室配门禁。搜索更像前台登记后进大厅,Agent 像有人带着具体委托来敲门,训练则像把文件抱走复印进资料库。三个场景都叫自动化,不代表应该拿同一把钥匙。
一个默认值,为什么会影响产品设计
很多团队会把这事交给 robots.txt。文件当然重要,它能表达站点希望哪些客户端如何抓取。但它更像写在门上的说明牌。边缘网络的 Bot 策略和 WAF 规则,才可能在请求抵达源站前直接决定放行或拒绝。
所以会出现一种很别扭的状况。工程师确认 robots.txt 写着 Allow,产品同学也以为内容开放,结果某个 Agent 在 CDN 层拿到 403,日志里只剩一声闷响。前台说欢迎光临,保安说今天不行,用户夹在中间看不懂。
Cloudflare 在配置文档里把这层说得更具体。新默认值针对展示广告的页面,训练和 Agent 被拦,搜索保留。它的判断不是技术洁癖,而是一个很朴素的商业假设,带广告的页面,网站所有者希望真实访客停留并看到广告,实时自动化访问可能绕开这段价值交换。
这里没有绝对正确答案。
如果你的产品靠广告内容生存,默认拦截可能很合适。若你的服务卖的是即时查询、比价或预约,Agent 能否进来又可能直接关系到未来的分发入口。它不是安全开关,也不是增长开关,更像一张访问权清单。
我觉得最容易被忽略的,是页面级别的差异。首页、公开文档、帮助中心和博客,通常希望被搜索与引用。登录后的个人数据、结算页、后台页面、限量接口,就算没有广告,也不该因为想要曝光而对实时 Agent 敞开。
别把内容可见和任务可执行混成一句话。
一个网站被 AI 找到,和一个 Agent 能代替用户在网站里操作,是两种完全不同的授权。
三类流量,各自该问哪一句
如果你今天正上线新域名,最有用的不是急着把所有 Bot 都封掉,而是把下面三句话分别回答完。
对搜索,你希望哪些公开内容被发现。这里看的不是页面漂亮不漂亮,而是内容能不能让人找到原始出处。文档、FAQ、产品说明和公开文章,往往都应该有明确的搜索策略。允许搜索也不等于允许任何形式的重用,Cloudflare 还在推动用内容使用信号标注即时使用、参考使用和完整重现等偏好。
对 Agent,你要问的是它能替用户完成什么。只读一篇公开文章,和读取价格、提交表单、创建订单,风险级别差很多。能代表用户的客户端,最好有可识别的身份、范围更小的权限和可追溯的日志。所谓 Agent 访问,不该是一张无限额度的通行证。
对训练,问题更直接,你愿不愿意让内容进入模型训练或微调。这里更接近内容资产和授权边界。你可以允许搜索带回流量,同时拒绝训练,这两个选择并不冲突。
| 访问类型 | 用户或站点最关心的事 | 适合先看的页面 |
|---|---|---|
| 搜索 | 能不能被发现和回链 | 公开文档、博客、FAQ |
| Agent | 能不能替人完成实时任务 | 查询页、表单、下单流程、登录后资源 |
| 训练 | 内容是否被长期吸收利用 | 原创文章、数据库、付费或高价值内容 |
这张表不是推荐你照抄配置,它只是把一个模糊的开关,拆成三个团队能讨论的业务问题。安全、增长、内容和产品终于可以在同一张纸上说话,不用各自守着一个抽象词。
最容易误伤的,是一身多职的爬虫
Cloudflare 还专门提醒了多用途爬虫的处理方式。一个客户端如果同时有搜索和训练等行为,策略会按它全部行为来判断。对于选择拦训练的客户,Googlebot、Applebot、BingBot 这类多用途爬虫就可能受到更严格规则影响。
这部分我看完没有觉得它有多酷,反而有点子紧张。
因为它提醒我们,爬虫名字不是权限模型。一个名字背后可能有多种行为,一个已验证身份也不自动等于可以访问所有页面。Cloudflare 甚至把已验证机器人的含义收紧了,验证只说明身份和类别可被识别,最终能不能进,仍要看站点给那个类别开的门。
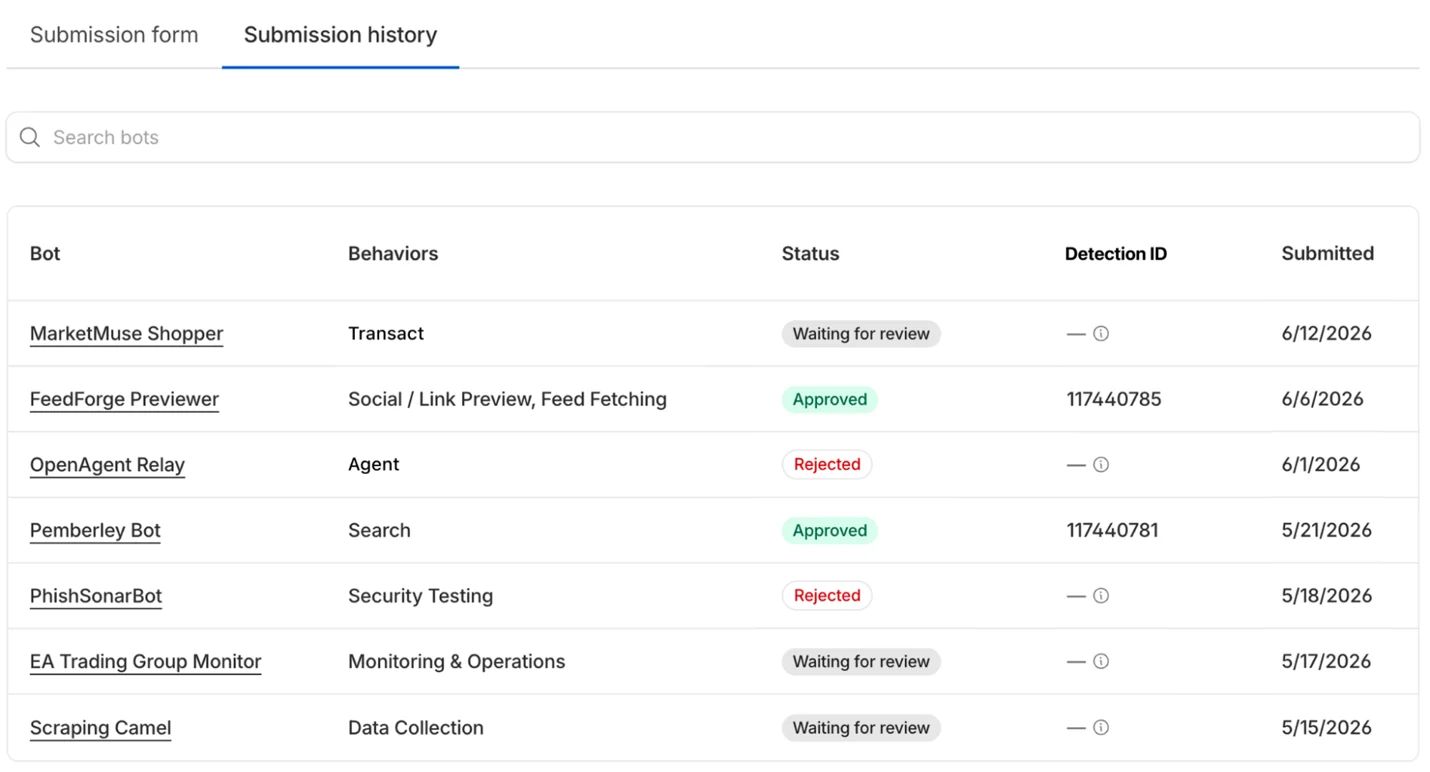
官方文章里的 BotBase 预览,重点不是多了一个目录,而是让身份、用途和规则能被放在一起看。
这其实是给 Agent 产品的一个提醒。我们常常讨论模型会不会调用工具,却很少把外部网站的视角补完整。对站点来说,来访者不是一个漂亮的模型名,而是一段请求。它有没有代表谁、能访问什么、会不会重用内容、失败时能不能查到记录,这些才是门口真正要核验的东西。
Cloudflare 提到的 Web Bot Auth 和转发信息,也是沿着这个方向走。它试图让网站能分辨自动化请求来自谁,委托关系经过了谁,并给信任留下一条能丢、也能查的链路。标准未必马上统一,问题已经摆在桌上了。
Agent 越像真人,网站越不能只靠猜。
新域名上线前,留十分钟做这件事
如果你正把一个新站接进 Cloudflare,可以先别把这个提醒当成一条资讯读过去。打开区域的安全与 Bot 设置,确认公开内容、带广告页面、登录后页面和执行交易的页面,分别想要什么结果。
第一步,列出你真正依赖的自动化访问。不是泛泛地写 AI,而是写清楚搜索收录、合作方抓取、聊天产品的即时读取、内部监控和自动化测试。清单越具体,后面越不容易误伤。
第二步,把页面按风险分层。公开说明和帮助中心可以讨论可见性,用户数据、管理后台、付款和写入操作要讨论身份与权限。一个有登录态的请求,不该因为名字里带着搜索或助手就绕开业务校验。
第三步,到边缘日志里看真实结果。重点不是今天改完开关,明天再也不看。要观察哪些 User-Agent、验证状态和状态码在命中规则。没有日志的允许与拒绝,都只是愿望。
第四步,给需要开放的 Agent 设计窄门。能给只读就别给写入,能要求账户确认就别让它静默执行,能留下审计记录就不要把动作藏在一次普通页面访问里。厉害了的 Agent 体验,不该以网站失去边界为代价。
这套检查不会让配置变得浪漫,甚至有点像上线前又多了一张表。可互联网从来不因为表少而更安全。现在访问者里多了会读、会点、会代替人完成任务的软件,把门牌写清楚,反而是对用户和内容最老实的交代。
Cloudflare 今天改的是默认值,不是替每个网站做决定。真正该由你决定的,是哪些内容值得被发现,哪些动作必须经过人,哪些数据不能被顺手带走。
门可以开。
但别再只留一把钥匙。
你的网站如果接入了 Cloudflare,会给搜索、Agent 和训练流量分别设什么边界?