posts/code-architecture-skill-rfc.md
代码架构 Skill 82.6 万次安装,先把重构写成 RFC
82.6 万次安装,24.1 万 GitHub Star。
它干的又是程序员最熟悉、也最容易翻车的活,审查代码架构。
安装只有一条命令。
npx skills add https://github.com/mattpocock/skills --skill improve-codebase-architecture这个 Skill 叫 improve-codebase-architecture。名字挺长,野心听着也不小。好家伙,代码库里那些耦合、浅模块、测试缝隙,难道丢给 AI 扫一遍,就能自动重构干净?
还真不是。
我把它的完整规则和配套说明翻完,最喜欢的一点,恰恰是它不让 AI 立刻改代码。
一次运行只产出一份临时 HTML 架构报告,再跟人讨论。重构要放到后面的独立流程里。
厉害了,82 万人装的不是一键优化器,而是一脚刹车。
AI 最爱从第一行代码开始用力
让 coding agent 看一个老项目,常见画面并不陌生。
它先搜几个类名,看到四层调用链,觉得抽象太多。接着合并两个文件,改一组类型,顺手再补三个测试。终端一片绿色,diff 也挺漂亮。
可过两天,业务又加一种支付方式,团队才发现被删掉的那层不是废话,它隔开了两个真的会变化的东西。原来难看的地方没消失,只是被挪进了调用者。
AI 很擅长在眼前代码里找模式,却不天然知道哪里值得动、为什么现在动、未来还会不会动。如果任务只写「改善架构」,模型就容易把代码风格偏好当成架构事实。
这个 Skill 先做了一件很朴素的事,读 git log --oneline。
它会先找最近反复变化的热点路径,再把注意力压到那些地方。半年没人碰的角落,即使长得不够优雅,也不会优先端上来。因为重构的回报来自未来修改,没人再改的代码,今天整理得再漂亮也很难收回成本。
这块我觉得很聪明。
不是先问「哪里最丑」,而是先问「哪里还会继续变」。
删除测试,比多画一层更有用
范围定下来后,它会读项目里的 CONTEXT.md 和 ADR。前者给业务概念统一命名,后者记住团队已经做过的决定。报告应该说「订单录入模块」,而不是临时编一个 FooBarHandler,也别把团队半年前否掉的方案换个名字再推荐一次。
然后才开始找摩擦。
理解一个概念是不是要在五个小文件之间来回跳。某个模块的接口是不是和内部实现一样复杂。为了方便单测抽出去的纯函数,是否把真正的组合错误留在了调用端。两个模块之间那条缝,是否正在向两边泄漏知识。
每个怀疑对象还要过一道 deletion test,删除测试。
想象把这个模块删掉。如果复杂度只是摊回十个调用者,它至少还在集中知识,不能因为文件小就判成多余。如果删掉后复杂度也跟着没了,那它很可能只是传递参数、换个名字再返回。
这个判断比「函数超过多少行就拆」「依赖超过几层就合」靠谱得多。架构不是文件数量游戏,真正要看的是,调用者学会一个接口后,到底换回了多少能力。
官方的 deep module 词汇表把这件事讲得很直接。深模块用小接口藏住大量行为,浅模块的接口几乎和实现一样费脑子。调用者从深度里得到 leverage,维护者得到 locality,改动、Bug 和验证都集中在更少的地方。
有点子牛逼,但先别急着喊架构革命。
它不是按代码行数算深度,也不认为模块越胖越好。一个塞满分支、要求调用者记住十条顺序规则的巨型类,照样很浅。深度看的是接口带来的杠杆,不是实现堆了多少行。
Before 和 After 先画出来
候选通过删除测试后,AI 仍然不能动代码。它要先写一份 HTML 报告。
每张候选卡必须给出涉及文件、当前摩擦、准备怎么改、测试会怎样变,还要画一张 Before 和 After 图。调用关系适合 Mermaid,就画调用图。接口像一堵大墙、实现只有薄薄一层,就用面积图把反差摆出来。几个小模块只是层层转发,就画成横截面,看它们怎样合进一个更深的模块。
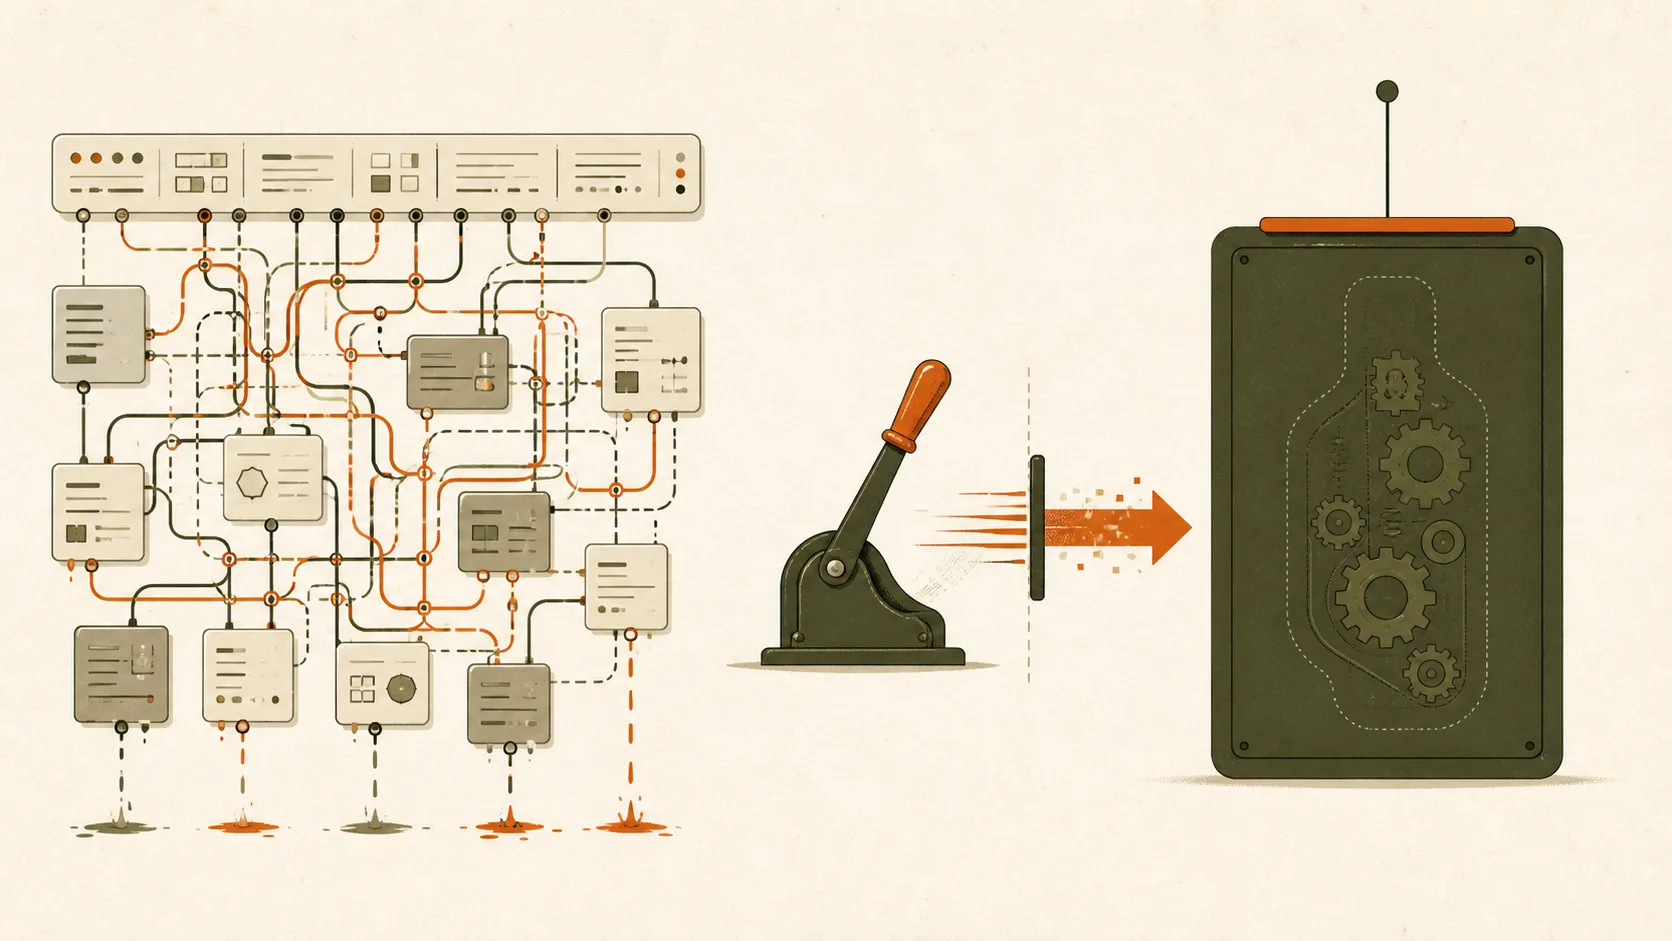
这张图不是装饰。
拿一个常见的订单处理链路作说明,这只是按官方报告合同做的示意,不是我的本地实测。Before 里,校验、定价、库存和持久化分散在许多公开入口,调用者要知道先后顺序,还要自己处理一半错误。After 里,调用者只交一个订单请求,内部怎样校验、怎样选适配器、怎样回滚,都藏在同一个接口后面。
如果 After 只是把四个盒子套进第五个盒子,接口一点没缩,报告会立刻露馅。
这就比一页「建议降低耦合、提高可维护性」强多了。图里哪条 seam 在漏,哪个接口太宽,测试要跨过什么位置,一眼就能争论。不同意也没关系,至少大家反对的是同一张图。
报告末尾只给一个 Top recommendation,还会给每个候选标 Strong、Worth exploring 或 Speculative。全部都是 Speculative,差不多就在委婉地说,这次没找到值得现在动刀的地方。
我喜欢这种诚实。架构审查不该每次都交出一场大手术。
选中之后,才轮到接口设计
人挑中一个候选后,它才进入 grilling,追问约束、依赖、seam 放在哪、哪些测试应该留下。
遇到自己掌控的远程系统,它会把接口放在 port 上,生产走 HTTP、gRPC 或队列 adapter,测试走内存 adapter。遇到 Stripe 这类外部依赖,才用 mock adapter。只有一个实现、也没有测试替身时,它还会提醒,一只 adapter 只是想象中的 seam,两只才像真的。
想比较接口方案,它会走 Design It Twice。一份方案把入口压到一到三个,一份强调扩展性,一份只为最常见调用者服务,必要时再补 ports and adapters 版本。几份方案按接口深度、变化是否集中、seam 是否放对位置来比较。
这和让 AI 一次吐出「最佳架构」不是一回事。
第一个方案往往只是最顺手的方案。并排放三种设计,才看得出哪份灵活性是业务真的需要,哪份只是模型舍不得放弃的抽象欲。
它对测试的态度也挺硬,接口就是测试面。新模块建立行为测试后,原来盯着浅模块内部细节的测试该删就删,不要在旧测试上再叠一层。测试只看调用者能观察到的结果,内部函数改名、文件搬家、实现换掉,都不该拉着测试一起重写。要是一次内部整理能让三十条测试全红,问题可能不在重构手法,而在那些测试早就穿过了接口,偷偷和实现绑在一起。
别把 82 万次安装当正确答案
坦率讲,这个 Skill 也有几块硬伤。
我没有拿一个真实仓库把整条流程完整跑完,所以这里不冒充实测。公开安装量能证明注意力,不能证明它在你的八年老项目里一定有用。
官方文档也没藏着。它默认要产出候选,因此很少直接说代码库已经很好。仓库越乱、领域词汇越模糊,模型越可能绕圈。某些运行环境不支持它原本依赖的并行探索,扫描会变浅。HTML 报告还会从 CDN 加载 Tailwind 和 Mermaid,离线或安全策略严格的环境,可能只剩一页没样式的原始文字。
更现实的一点,它负责找「哪里值得设计」,不负责给 TypeScript 项目送上一份万能目录结构。具体怎么切包、怎样部署、哪条 seam 真有两个 adapter,团队仍然得自己决定。
所以我不会建议把它接进 CI,每周自动生成十份架构整改通知。那大概率只会多一个没人看的报告目录。
更合适的用法,是在大功能开工前,把即将变化的模块指给它,问一句「怎样让这次改动更容易」。或者接手老项目时先看报告,不改代码。又或者准备补测试之前,先确认测试该穿过哪个接口,别给一堆浅模块逐个上铐。
命令很短,使用边界也该写在同一张便签上。
先给范围,再看报告
只挑一个候选继续
先写 RFC,再开重构分支
全是 Speculative,就先别动
AI 写代码越来越快以后,稀缺的可能不是再多一双手,而是有人在第一刀落下前问,这块为什么现在要动。
82.6 万次安装最值得看的,真不是热闹。
是这脚刹车。