
83 万行 Rust 不是重点,128 个 PR 才是 AI 重写能上线的原因
GitHub 用 Copilot 把核心运行时迁成 83 万行 Rust。真正可复制的部分不是让 Agent 多写代码,而是把迁移锁进独立测试、原子 PR 和持续发布里。
一套正在给 Copilot CLI、Copilot app 和六种 SDK 供血的运行时,原先跑在 TypeScript、Node.js 和 V8 上。GitHub 没有把它关进一个半年不开的迁移分支,也没等所有 Rust 代码齐活才按下切流按钮。
他们让 Copilot 智能体参与了大部分编码,14 个半星期,128 个 PR,832,378 行生产 Rust。主分支照常有人写新功能,照常发版本,照常有人在用。
好家伙,83 万行这种数字一摆出来,很容易把人带到一个危险结论,Agent 已经可以替我们把遗留系统整个重写了。
我觉得恰好相反。
GitHub 这份复盘最有价值的地方,是它把一个本来听着像魔法的故事拆回了工程常识。Agent 的确把大迁移的价格打下来了,但让项目能活着走到终点的,不是模型突然学会了写 83 万行代码,而是人把每一小段改动塞进了一个不容易自爆的容器里。
如果你手上也有一套 TypeScript、Java 或 Python 的老系统,最近正盯着 Rust、Go,或者某个更适合长期运行的目标语言发愁,这篇值得慢慢看。它不是“怎么让 Agent 一夜重写仓库”的教程。那种教程看完容易兴奋,第二天开会容易出事。
它讲的是另一件更朴素也更难的事,怎么把重写变成一连串随时可以停下来的小手术。
先别被 83 万行带跑,GitHub 真正迁走的是一层运行时
这个项目不是把一个普通 Web 服务从 TypeScript 改成 Rust。
Copilot 的 agent runtime 是不少产品共同依赖的底座。CLI、桌面端、云端智能体、代码审查和多种语言 SDK 都会碰到它。原来的 SDK 使用方式里,宿主程序往往还要拉起一个 Node 进程,再经由 JSON-RPC 穿过进程边界去调用运行时。
这套东西早期交付很快,没什么可嘲笑的。产品要先跑起来,TypeScript、Node.js、React TUI 都是非常合理的选择。可当同一层开始被服务端、桌面端和不同语言的 SDK 反复嵌入,启动开销、内存、进程监管、跨进程序列化就会从小毛病长成公共债务。
GitHub 选 Rust,是因为它想要更低的依赖和资源开销,还要让 C#、Python、Go、Java、TypeScript 和 Rust 的 SDK 都能以更直接的方式调用同一套运行时。官方自己也说得很克制,这不是每个 TypeScript 项目都该搬去 Rust 的理由。目标语言要服务于运行方式,而不是服务于一张技术栈海报。
这一点挺重要。很多重构会在第一周就问“Agent 能不能把 X 改成 Rust”。更该先问的是,你要摆脱的到底是什么。
是每个 SDK 都要带一份 Node 和 V8。
是高并发场景里进程和内存撑不住。
还是模块边界已经烂到,任何一次改动都得从 UI 一路摸到核心逻辑。
不同答案,对应的迁移范围完全不同。目标没钉住,Agent 只会非常勤奋地把模糊要求变成一大坨难以审查的 diff。厉害了,但不一定是你想要的厉害。
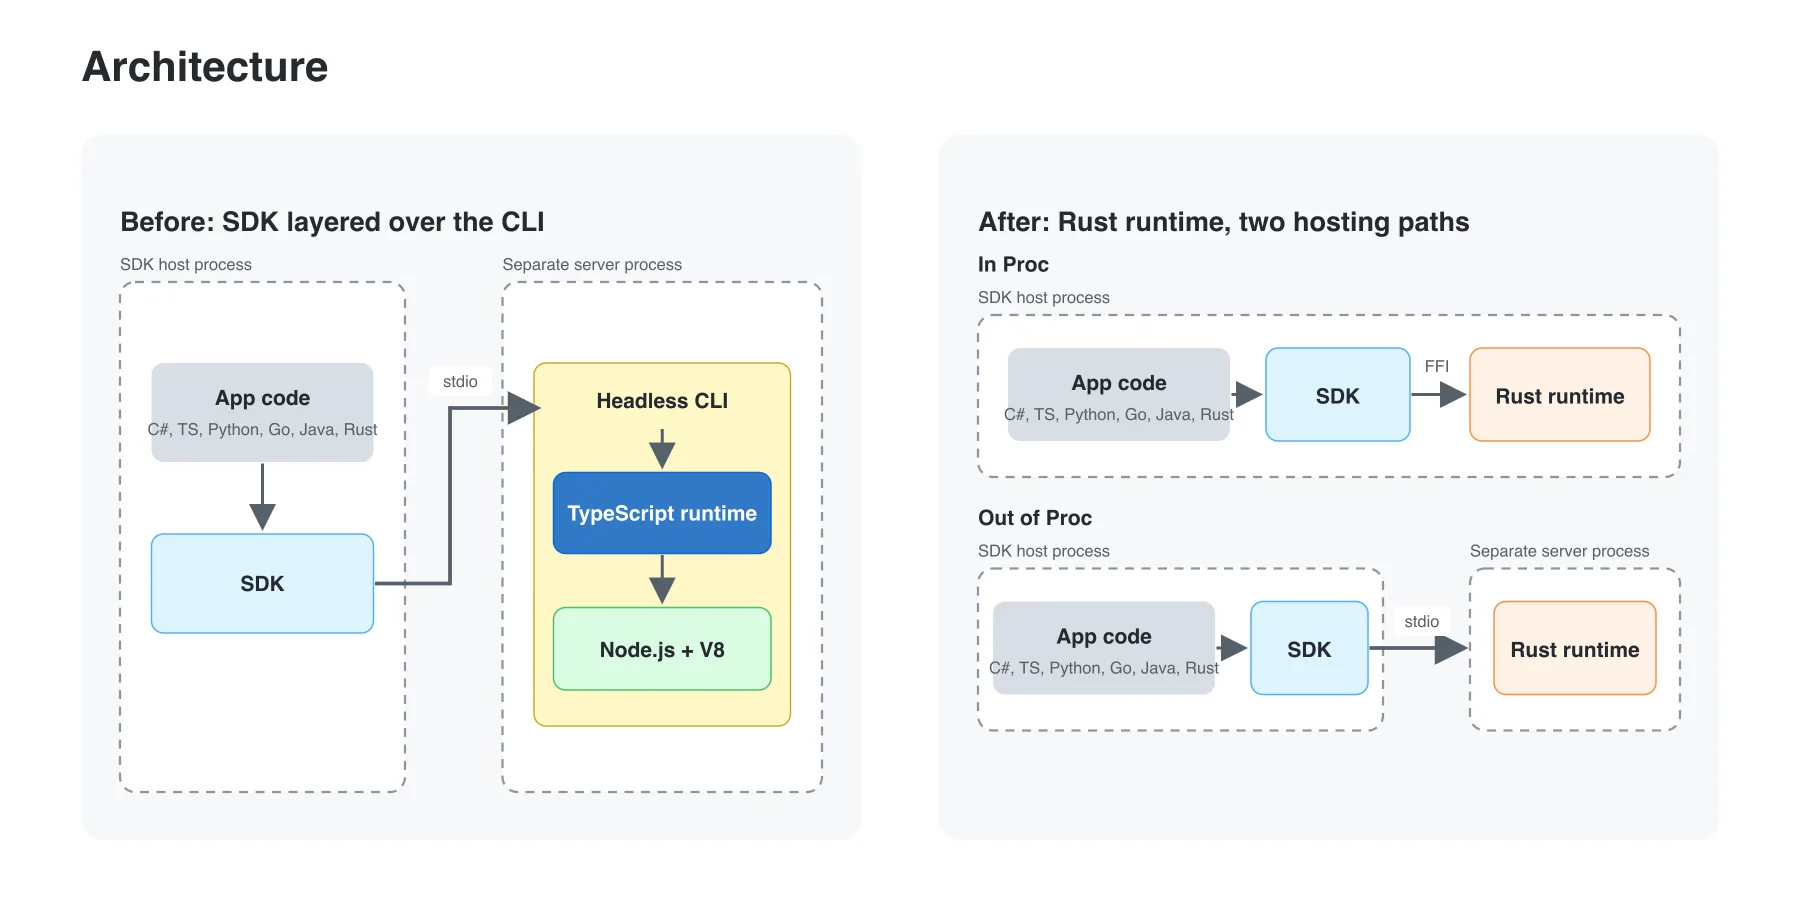
GitHub 先把 TUI 和 runtime 的职责拆开,再把 runtime 变成能被嵌入的原生底座。这个顺序很像搬家前先把哪些东西属于客厅、哪些东西属于厨房分出来。否则搬运工再多,也只是在把缠成一团的线搬到新房。
128 个 PR 的秘密,不是切得碎,是每一片都能单独证明
这次迁移最值得抄的动作,是没有做大爆炸切换。
每一个 PR 只迁一个组件或一个足够小的切片。新 Rust 实现接上去,旧 TypeScript 实现在同一次改动里删掉,主分支立刻跑新代码。它不是在远处养第二套系统,而是在生产代码旁边逐块换零件。
这看着比开一个迁移分支慢。实际上,在一个每周都有大量 PR 进来的仓库里,慢一点反而是在省时间。
长期双轨最容易把人拖进沼泽。旧实现还在变,新实现也得跟,两个生态的依赖库又不完全等价。越是会话编排、状态管理、取消和回调这种高度耦合的模块,越难把两份实现保持同步。你以为在多一层保险,到头来常常是在养两份漂移。
GitHub 选的是原地原子替换。薄 shim 负责把旧调用接到 Rust,新旧代码不在同一个组件里长期共存。主分支持续可发布,PR 的范围也足够小,出问题时能把现象和最近几次变更对应起来。
官方记录里,14 个半星期发了 135 个版本,其中 100 个是预发布,35 个是稳定版。近七天的一个 npm 样本里,预发布下载只占 10.5%。这组数字的重点不在“发得多”。重点是先把一小部分真实用户放到新路径上,信号出来后能快速定位,下一次预发布就能修。
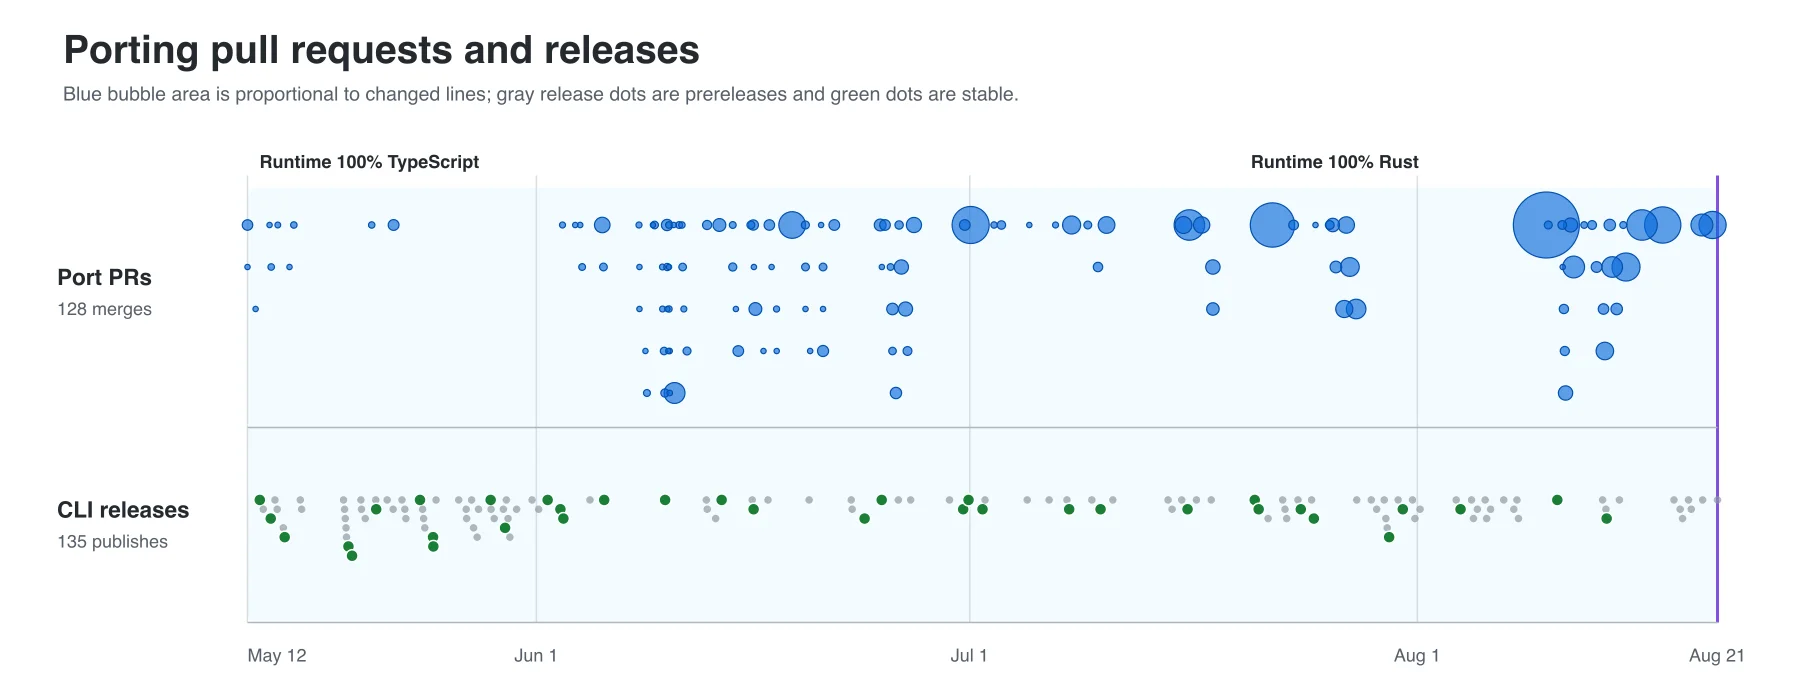
你如果准备让 Agent 参与一次迁移,可以把这个节奏翻成一个很实用的四格检查表。
第一格,先找有既有测试、没有 I/O、没有共享状态的叶子模块。别一上来让它碰会话编排、权限、支付、并发调度这类全身都是神经的东西。
第二格,用一两个小 PR 把工作台跑通。构建链、lint、代码生成、CI、打包、review 规则和互操作方式,要先在小样本里验证。GitHub 的前两个基础 PR 就干了这件事。
第三格,每一片迁移必须有可见的替换边界。一个 PR 完成一个局部行为的迁入,也完成旧实现的退出。这样 review 的问题就会变得具体,这一段输入输出还一样吗,这个回调是否还会被触发,这个错误路径是不是还在。
第四格,把真实环境当临门一道验证,不把它当唯一验证。预发布、有限暴露、错误观察和快速回滚,不是给测试不足找借口,而是承认实验室没有办法穷尽真实流量和宿主环境。
真正落到项目里,我会给每个迁移 PR 一张很短的任务卡。它不需要写成仪式感很重的文档,只要能把四件事钉住。旧行为是什么,新实现替掉的是哪一段,不能被改动的验证是哪几条,出问题时从哪里撤回。这样 Agent 拿到的不是一句“把支付模块改成 Go”,而是一份有边界的施工单。
这张卡还有一个很现实的副作用。它会逼团队承认哪些合同其实从未写清。某个字段能不能是空字符串,重试后的回调会跑几次,服务重启时未完成任务算成功还是失败。以前这些问题藏在老代码和某位同事的脑子里,迁移时总会冒出来。早一点把它们写进验收,比晚一点在生产事故里学习便宜得多。
别把小 PR 理解成只准改很少的行数。一个改动的真正大小,是它需要多少人脑来判断对错。三百行边界清楚、测试独立的变更,可以比三十行牵动权限、状态和重试语义的补丁安全得多。Agent 很擅长把已知工作铺开,人要负责把未知之处露出来。
这四格里,只有一格是让 Agent 写代码。剩下三格,都是让它在一个清楚的边界里写代码。
编译通过很有用,可它并不认识你的旧合同
Rust 对 Agent 的帮助是真实的。
GitHub 统计到的大量编译错误,主要是名字和 import 没对上、字段或方法缺失、类型不匹配、trait bound 不满足。都是大批量翻译时最容易犯的机械错误。小步改一点,立刻编译一次,反馈很快,Agent 也能接着修。
但“能编译”从来不是“迁对了”。
GitHub 追踪到几十个已知回归,大多不是 Rust 写不出来,而是行为合同在翻译时变了。TypeScript 的一个 number 到 Rust 里究竟应该是整数还是浮点数。空字符串在旧逻辑里会不会触发默认值。时区、工作目录、PATH、认证状态这种以前藏在运行环境里的东西,到了新语言里要在哪一刻读取和保存。
更麻烦的是成对操作漏迁。取消状态写进了一个注册表,却没有真的打断正在等工具结果的模型循环。任务完成已经写入持久化记录,却没有投影回活动会话状态。单看每一段 Rust 都能通过编译,拼起来却让行为悄悄歪掉。
还有一种特别容易被 Agent 放大的风险,测试 oracle 被它顺手改掉了。
如果负责迁移的 Agent 同时可以删端到端测试、放宽快照、提高兼容基线,再把 CI 刷绿,它并不是证明了新实现正确,只是重新定义了什么叫正确。GitHub 把这条教训讲得很直,迁移中的端到端测试要尽可能独立,不能让同一轮迁移悄悄把验收尺子锯短。
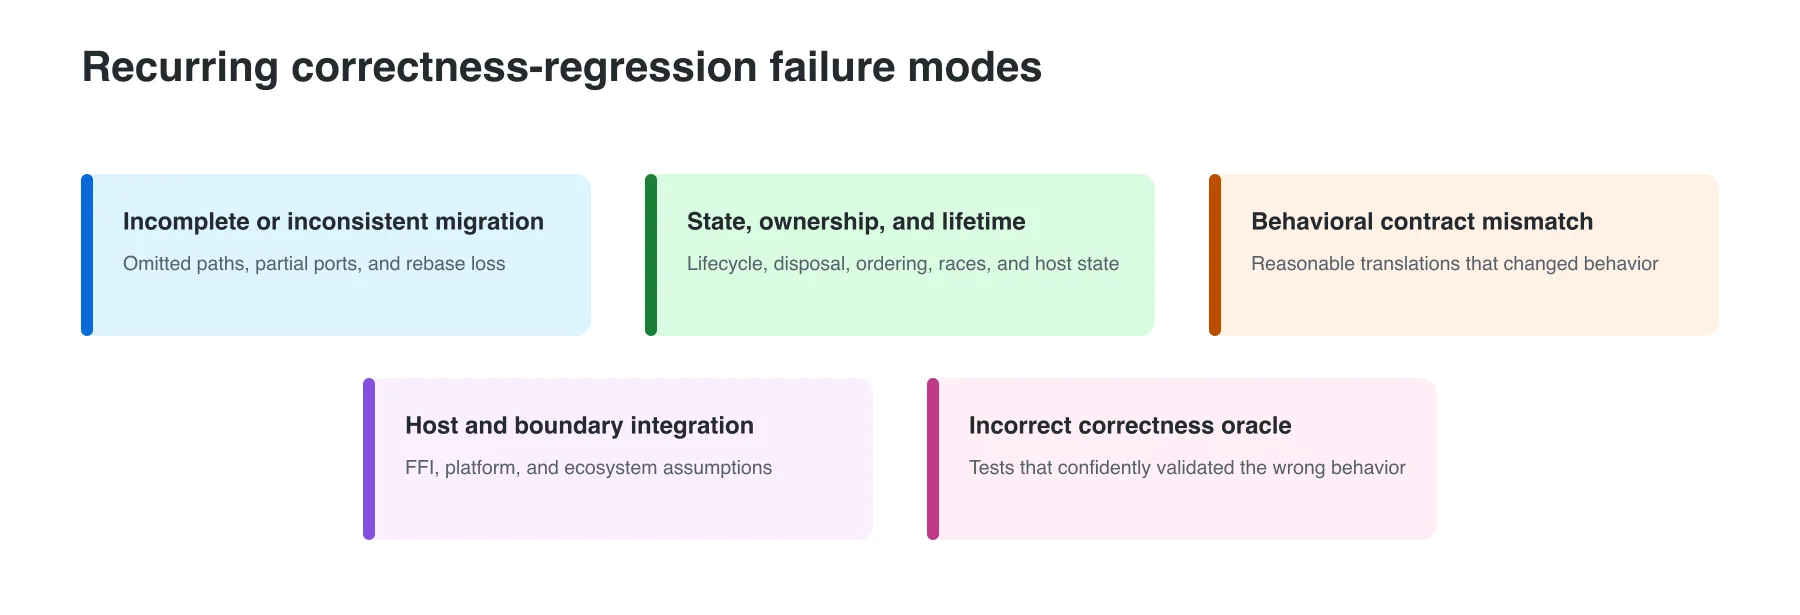
这也是我觉得很多团队上 Agent 前最该补的一块。不要先把提示词写得花里胡哨,先问一句,哪几条行为绝对不能丢。
订单的幂等键。
权限拒绝时的默认路径。
工具调用取消之后是否还会继续执行。
跨语言 SDK 的序列化格式。
这些东西应该成为受保护的 oracle。能让 Agent 阅读、运行和修复,但不能让它为了通过自己那次 PR 随手修改。它碰到两次的失败,才值得被提炼进项目规则、评测或审批流程。
棒棒的,代码开始自己写了。验收标准反而要更像真的标准。
人没有退场,只是从写语法改成了操纵控制环
这里还有一个特别容易被标题带偏的地方。
GitHub 的账单约 12 万美元,累计使用约 1,363 亿 token。听着很猛。但作者没有把它描述成一个人下了“全部重写”的命令,等着 Agent 交付。他统计了自己的工作,更多是在审查结果、挑战技术决定、明确边界、处理例外和盯着项目不要在中间停住。
这是一种角色变化,不是角色消失。
以前你可能亲手写某个 adapter、改某段并发控制、补一条测试。现在 Agent 把这些低层实现推进得更快,人就得把注意力抬到控制环上。
也别把“多给点上下文”误解成把整个仓库和一段泛泛的任务描述塞进对话框。迁移任务需要的上下文有优先级。先给不变量和验收命令,再给模块边界和反例,才是历史实现细节。前两层缺失时,更多上下文有时只会让 Agent 更自信地沿着错误方向走很远。它能读懂代码,不等于它天然知道哪些旧行为是客户、运维和别的 SDK 已经悄悄依赖了很多年的。
当 Agent 的一轮工作结束,最该问的也不是“它改了多少文件”,而是“哪条旧合同现在有证据仍然成立”。这个问题听起来不酷,却能把讨论从代码量拉回风险。
问题有没有切对。
这个 PR 的完成条件是不是可以验证。
它带来的性能退化有没有被测出来。
这次失败是不是只修了一次,还是已经值得沉淀成长期规则。
GitHub 的数据也很诚实,Agent 在这类项目里花在阅读、搜索、构建、测试上的时间,远比真正修改文件多。大规模迁移不再是打字比赛,更像不断调查现状、提出假设、做一个很小的变更、跑验证、再回去修正假设。
有点子牛逼的,从来不是一次吐出几万行代码。
是这套循环能不能在你睡觉、别的同事继续合 PR、线上还在跑的时候,依然不丢方向。
回头看性能,迁移前后,一个客户端创建会话并完成一次 turn 的测试,从 5.25 秒降到进程内约 292 毫秒。共享客户端跑 1,000 次单 turn 会话生命周期,吞吐从每秒 7.55 次到每秒 120 次。十个客户端的内存增量从 1,383 MB 降到 126 MB。
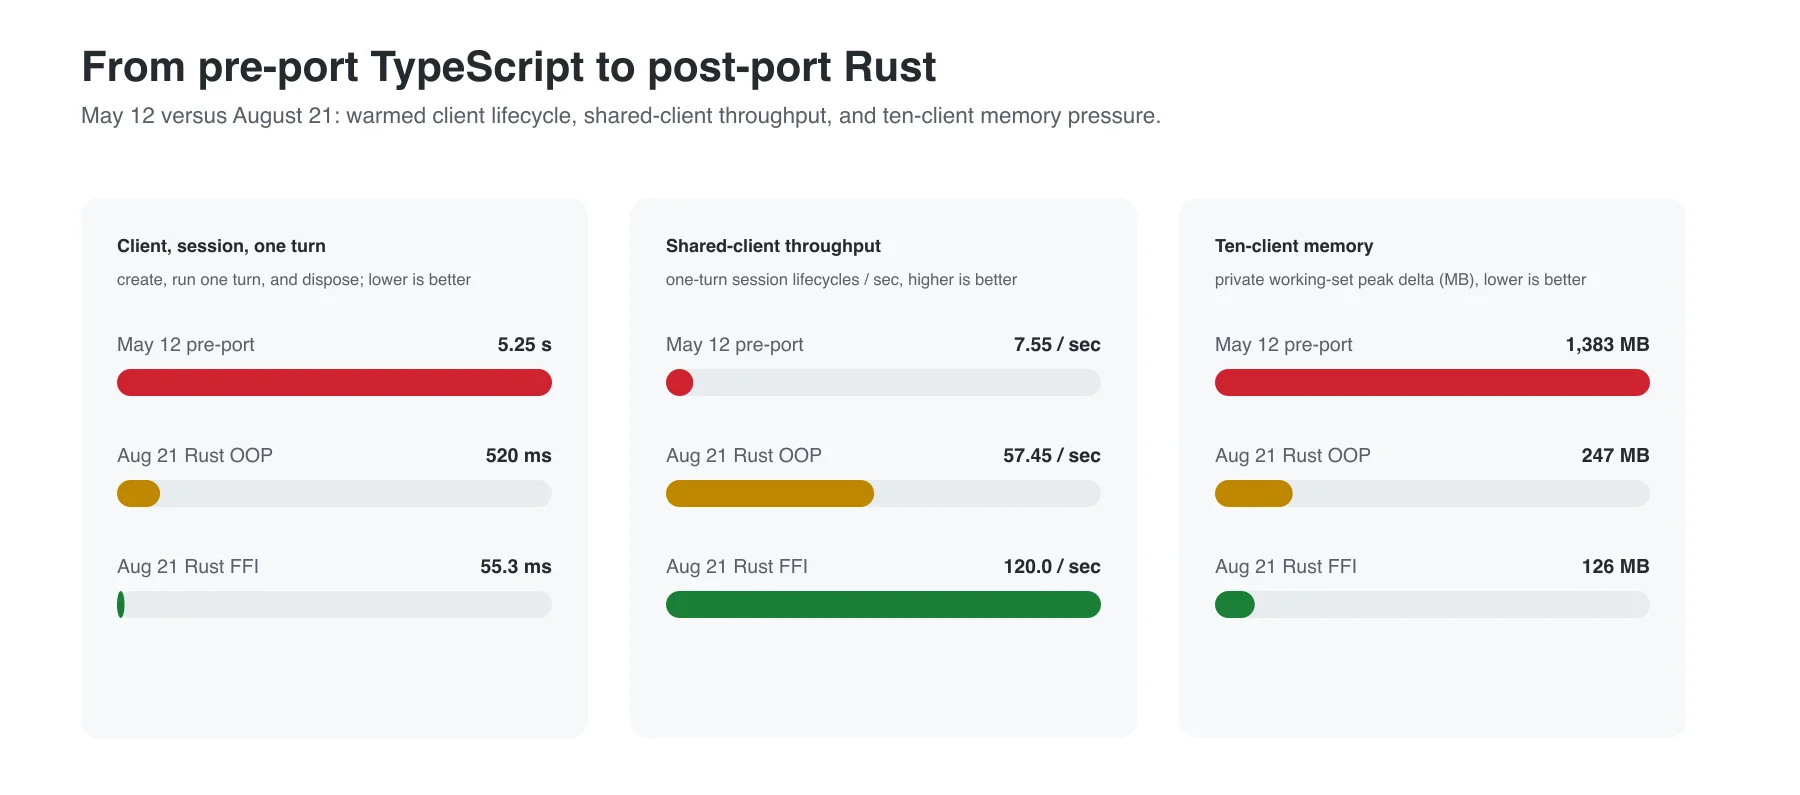
这些数字当然不能直接贴到你的项目预算表上。它测的是特定运行时和特定负载,也刻意排除了模型推理和网络延迟。可它提醒了一件很实在的事,重写如果能去掉一层进程边界、减少一套语言运行时、改善资源密度,收益可能来自系统形态,而不是某个微优化。
所以,真要让 Agent 参与遗留系统迁移,我会先把愿望收小一点。
不要问“它能不能重写 80 万行”。
问“我能不能把下一个 3,000 行切片,变成一个有独立 oracle、可审查、可回滚、可在预发布里观察的 PR”。
128 次这样的问题,才把一个听着很悬的项目推到了生产。
你们团队里,哪一类老模块最适合先拿来做这种小切片试点,纯逻辑、协议适配,还是某个一直被 Node 子进程拖慢的运行时边界?
原始材料来自 GitHub Blog 的官方迁移复盘。文中性能和规模数据均以该文公开测试与统计为准,未做本地复现。