
Genie 4 把实时世界推到眼前,产品团队该准备什么?
它有原生音频、连续交互与运行中改写场景的能力,但仍只是研究预览。比起赶着立项,团队更该先用三条可验证的假设判断它值不值得进入路线图。
Google DeepMind 昨天放出了 Genie 4。它最容易被转成一句很顺口的话:输入一段文字,眼前就出现一个能走进去、能改天气、还能听见声音的世界。
这句话没错,但它太像演示片的字幕了。真正值得产品团队盯住的,不是“画面又更像真的了”,而是模型的输出单位正在变:以前我们拿到的是一张图、一段视频、一次回答;现在它试着交付一个可以继续被操作的环境。
Google 对 Genie 4 的定位是实时交互式世界模拟。官方展示里,使用者能在环境中探索,在运行中用自然语言改场景或加入物体;模型还开始原生生成环境声和人物对话。它目前只向受信任测试者开放,后续才计划进入 Project Genie、Gemini API 和 AI Studio 的早期访问。
所以这不是“明天给产品接一个 API”的新闻。它更像一张提前送到桌上的试卷:如果未来模型能把一个环境维持成可探索、可打断、可继续的状态,我们手里的产品交互该怎么重新写?
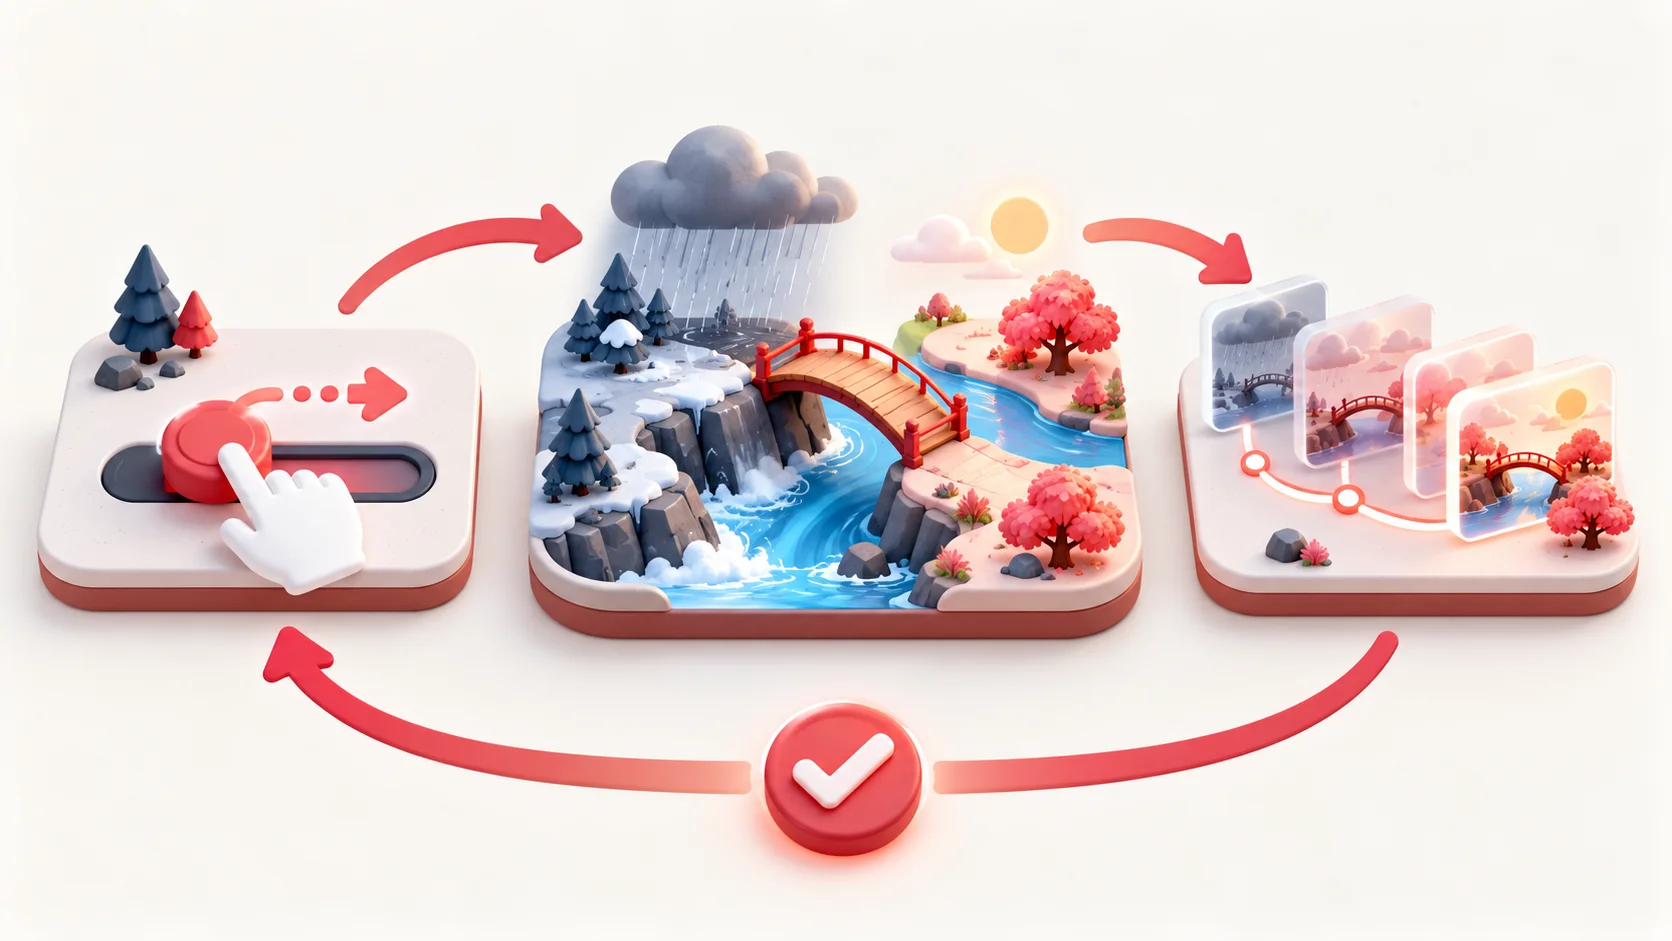
图:本文用“动作—状态—验证”而非“提示词—结果”来理解实时世界模型。
先把“会生成”翻译成“能完成一个循环”
视频生成已经让人习惯了看结果:给一句描述,等几秒,得到一段可播放的内容。这个模式里,用户是观众,最多当一次导演。
实时世界模型的难点在下一步。用户走了两步、改了一句话、搬走一个物体,系统不能只给一帧漂亮的新画面;它得让这次操作和后面的世界状态接得上。用户动作要改变状态,状态要影响下一次可见结果。少任何一头,都还是一次性的生成。
这也是我觉得 Genie 4 比“更强视频模型”更值得讨论的地方。原生音频、环境、人物对话单独看都是功能点;放进同一段持续交互里,它们才开始变成产品能力。声音不是配乐,人物不是镜头里的装饰,天气也不只是滤镜——它们都得跟用户此刻做的事保持一致。
不过先踩一下刹车。Google 自己给的是研究预览,不是稳定的生产承诺。公开材料没有给出你能据此排期的可靠性指标、成本曲线、并发上限和失败回退方案。“能看见”与“能把它写进路线图”之间,还隔着一整套验收。
对正在做互动内容、学习产品、训练模拟或 agent 体验的团队,最有用的动作不是马上开一个“世界模型专项”,而是把下面三个问题写成小实验。
第一问:你的用户真的需要“连续状态”吗?
很多产品把“实时交互”当成天然卖点。可用户真正需要的,也许只是一张更快、更可控的图,或者一段可编辑的视频。给一个本来只需要交付物的任务塞进持续世界,不一定更聪明,可能只是把等待时间和失败面一起放大。
判断方法很朴素:写下一个用户从开始到结束必须跨过的动作链,然后问——后一个动作是否依赖前一个动作留下的状态?
例如,假设你在做一款面向门店培训的产品。员工进入一个模拟的投诉场景,先选择如何回应;顾客的情绪、柜台上的信息、下一轮提问,都应受这次回应影响。这里的连续状态就是任务本身。反过来,如果用户只是要一张“节日橱窗方案”的效果图,连续世界未必带来额外价值。
这两类任务看起来都能用生成式模型做,产品设计却完全不同。前者要测试状态能不能被保留、被解释、被回看;后者重点是控制、编辑和导出。把它们都叫“AI 创作”,很方便,但对工程没有帮助。
你可以先用一页纸写下这个最小循环:
用户动作 → 环境发生了什么变化 → 用户如何看见变化 →
下一步还能否基于这次变化继续操作 → 失败时怎样回到可理解的状态
只要其中有两步答不上来,世界模型还不是这条产品线现在最急的依赖。先把任务逻辑补齐,比追一次新模型更划算。
第二问:你要验证的不是画面,而是“可被打断的反馈”
Genie 4 的一项更新是原生音频。这个词听起来像给世界补了一层氛围,但放在交互产品里,它的意义要严格得多。
用户在一个空间里移动、询问、改变条件时,视觉、声音和角色反馈必须对同一件事作答。一旦声音像在讲另一段故事,用户对系统状态的信任会先断掉。 很多 demo 的问题恰好在这里:单帧很漂亮,连续操作几轮,角色身份、物体位置或前后因果开始各走各的。
因此,团队不妨把“好看”从首要指标里往后放一位,换成三次可重复的打断测试:
- 用户在任务中途改变目标,系统能否承认目标变了,并让接下来的环境响应它。
- 用户回到刚经过的地方,关键对象和任务条件是否还说得通。
- 用户要求解释刚才发生了什么,产品能否给出与可见状态一致的说明。
这三个测试不需要等到 Genie 4 对外开放才开始。你甚至可以先在现有原型里用手工脚本、状态机或人工运营把它跑一遍。目的是分清:你的产品缺的是生成能力,还是缺一条让用户理解“系统记住了什么”的反馈链。
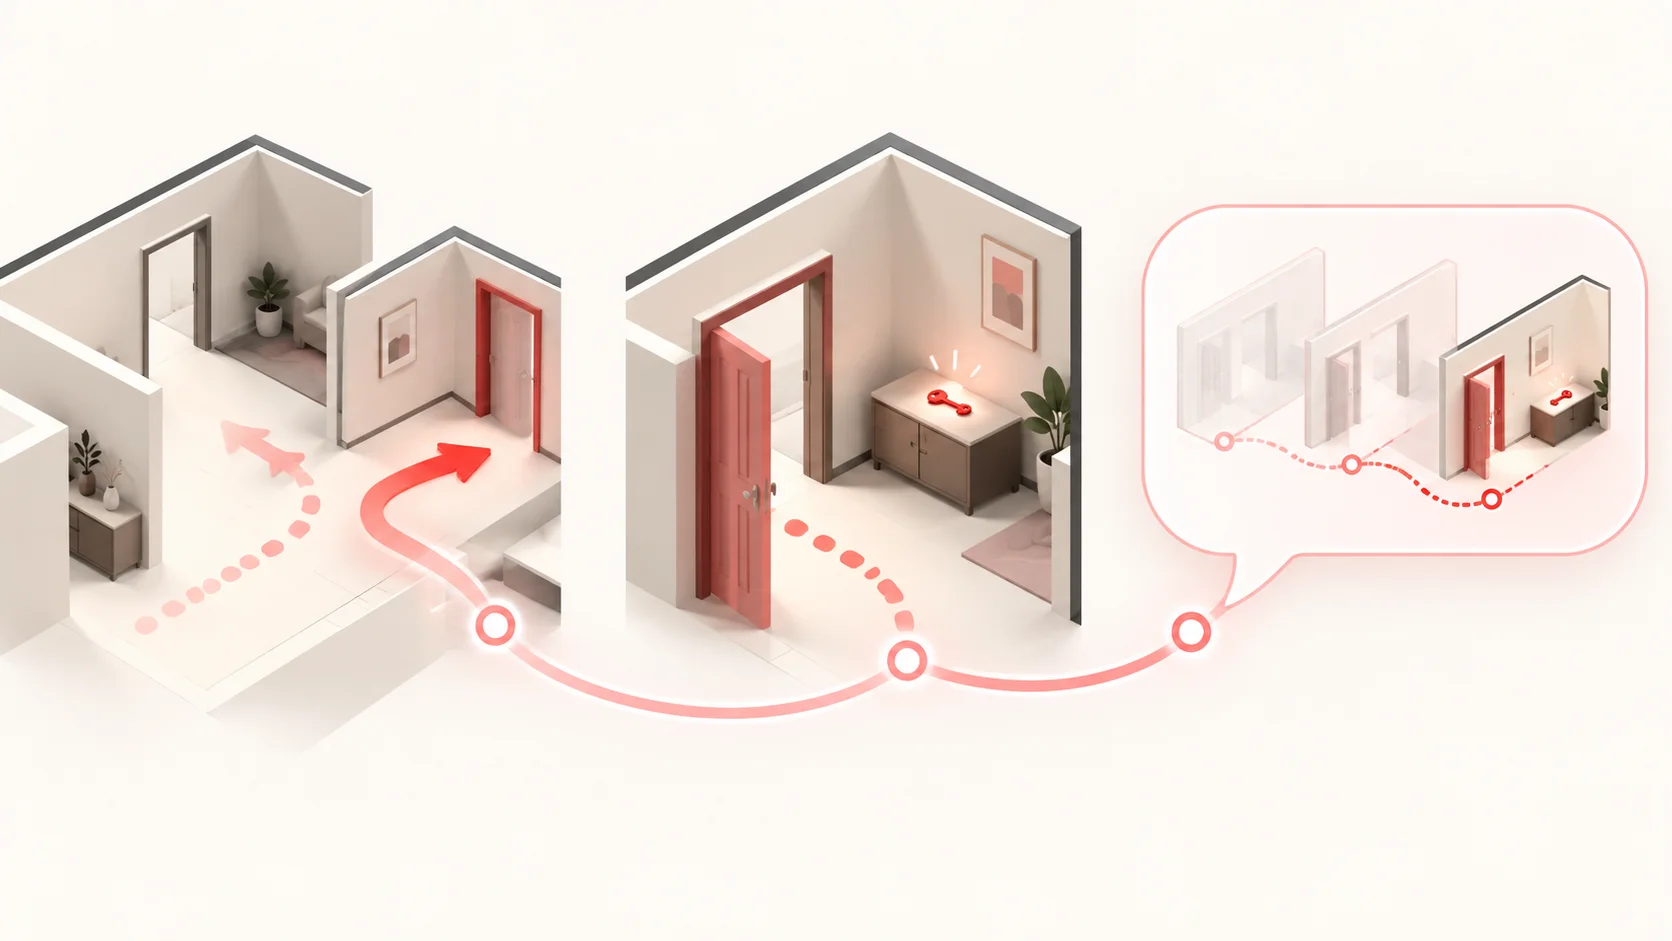
图:把“能实时生成”拆成三次可重复的打断测试,才知道体验卡在模型还是产品。
第三问:失败以后,用户还能不能继续做事?
现实产品不会只跑一段发布会里的顺滑路径。用户会改错词、反复返回、临时换目标、上传不完整的素材,也会在网络不稳的时候点第二次。
世界模型一旦进入产品,失败不再只是“这一张图不够好看”。它可能表现为场景突然跳变、角色前后矛盾、操作没有可见结果,或者系统继续往前生成却忘了用户刚改过什么。对用户来说,最难受的往往不是出错,而是不知道刚才的输入到底有没有被系统接住。
所以评估新能力时,建议把“失败后的可恢复性”单列出来。不是要求模型永远正确,而是要求产品在不确定时诚实一点:保留上一个可用状态、明确标出正在重新生成的范围、给用户撤销或改写路径,而不是悄悄把世界换掉。
这也是为什么我不建议把 Genie 4 的公开演示直接变成路线图 PPT 上的一个大方块。它现在能证明的是方向感:模型正在从生成一个结果,走向维护一个可互动的过程。它还不能替你证明这条过程在真实任务里够稳、够快、够便宜。
现在可以做的,是一张很小的决策表
如果你负责产品或工程排期,我会把这次发布压缩成下面这张表,而不是开一场“世界模型要来了”的兴奋会。
| 要问的问题 | 能回答“是”时再做什么 | 答不上来时先补什么 |
|---|---|---|
| 用户任务是否依赖连续状态? | 设计一个三到五步的真实流程原型 | 明确交付物和编辑控制,不急着引入环境模拟 |
| 用户是否需要中途改变目标? | 加入目标切换和回看测试 | 先把单次生成的可控性做扎实 |
| 失败后是否有可理解的恢复路径? | 记录状态、撤销和解释机制 | 先定义错误提示与人工兜底 |
这里没有“接入 Genie 4”这一项,是故意的。因为此刻最稀缺的不是访问资格,而是一个能把新能力接住的任务定义。先知道自己要验证什么,拿到模型时才不会只剩一场好看的试玩。
等它真的进入更广泛的 API 或产品入口,再看三个更硬的问题:连续交互能保持多久、用户干预后状态会怎样漂移、以及每一轮可交互体验的成本能否落进业务账本。那时才是做取舍的时候。
Google DeepMind 的 官方公告 和 产品页 都明确把 Genie 4 放在研究预览阶段。这个限定词不扫兴,反而给了团队一段很宝贵的准备时间。
如果你的产品里有一段用户必须“进入、改变、再回来”的任务,你最想先拿它验证哪一个状态?
—— 小岛 AI
记录一线实战、踩坑与成长