
多 Agent 写代码,先把这 4 个 Git 卡点管起来
GitHub 为智能体规模开发重做 Git 基础设施。大多数团队不需要重造存储层,却该先把提交延迟、分支隔离、合并队列和 CI 扇出当成新生产力指标。
如果你的仓库里已经同时跑着 Claude Code、Codex,或者好几位同事各自带着一个 Agent 干活,最先让人不舒服的,往往不是模型突然变笨。
是 Git 开始慢半拍。
一个 Agent 改完文件要 checkpoint,另一个 Agent 在同一条分支上推送,CI 立刻跟着拉取,合并队列又要等保护规则。单看每一步都很合理,叠在一起,原本只给人类开发者准备的节奏就有点跟不上了。
GitHub 在 10 月 6 日公开了它为什么要为智能体规模开发重做 Git 基础设施。官方文章给出的数有点吓人,2026 年 8 月平台月度 Git 事件从一年前的 2183 亿增至 4733 亿。9 月,开发者和智能体一共产生了 73.8 亿次提交,推送量同比增长 4.9 倍,GitHub Actions 单月跑了 32.6 亿次。
好家伙,Agent 不是只多写几行代码,它把提交、分支、拉取、扫描和合并全都按下了加速键。
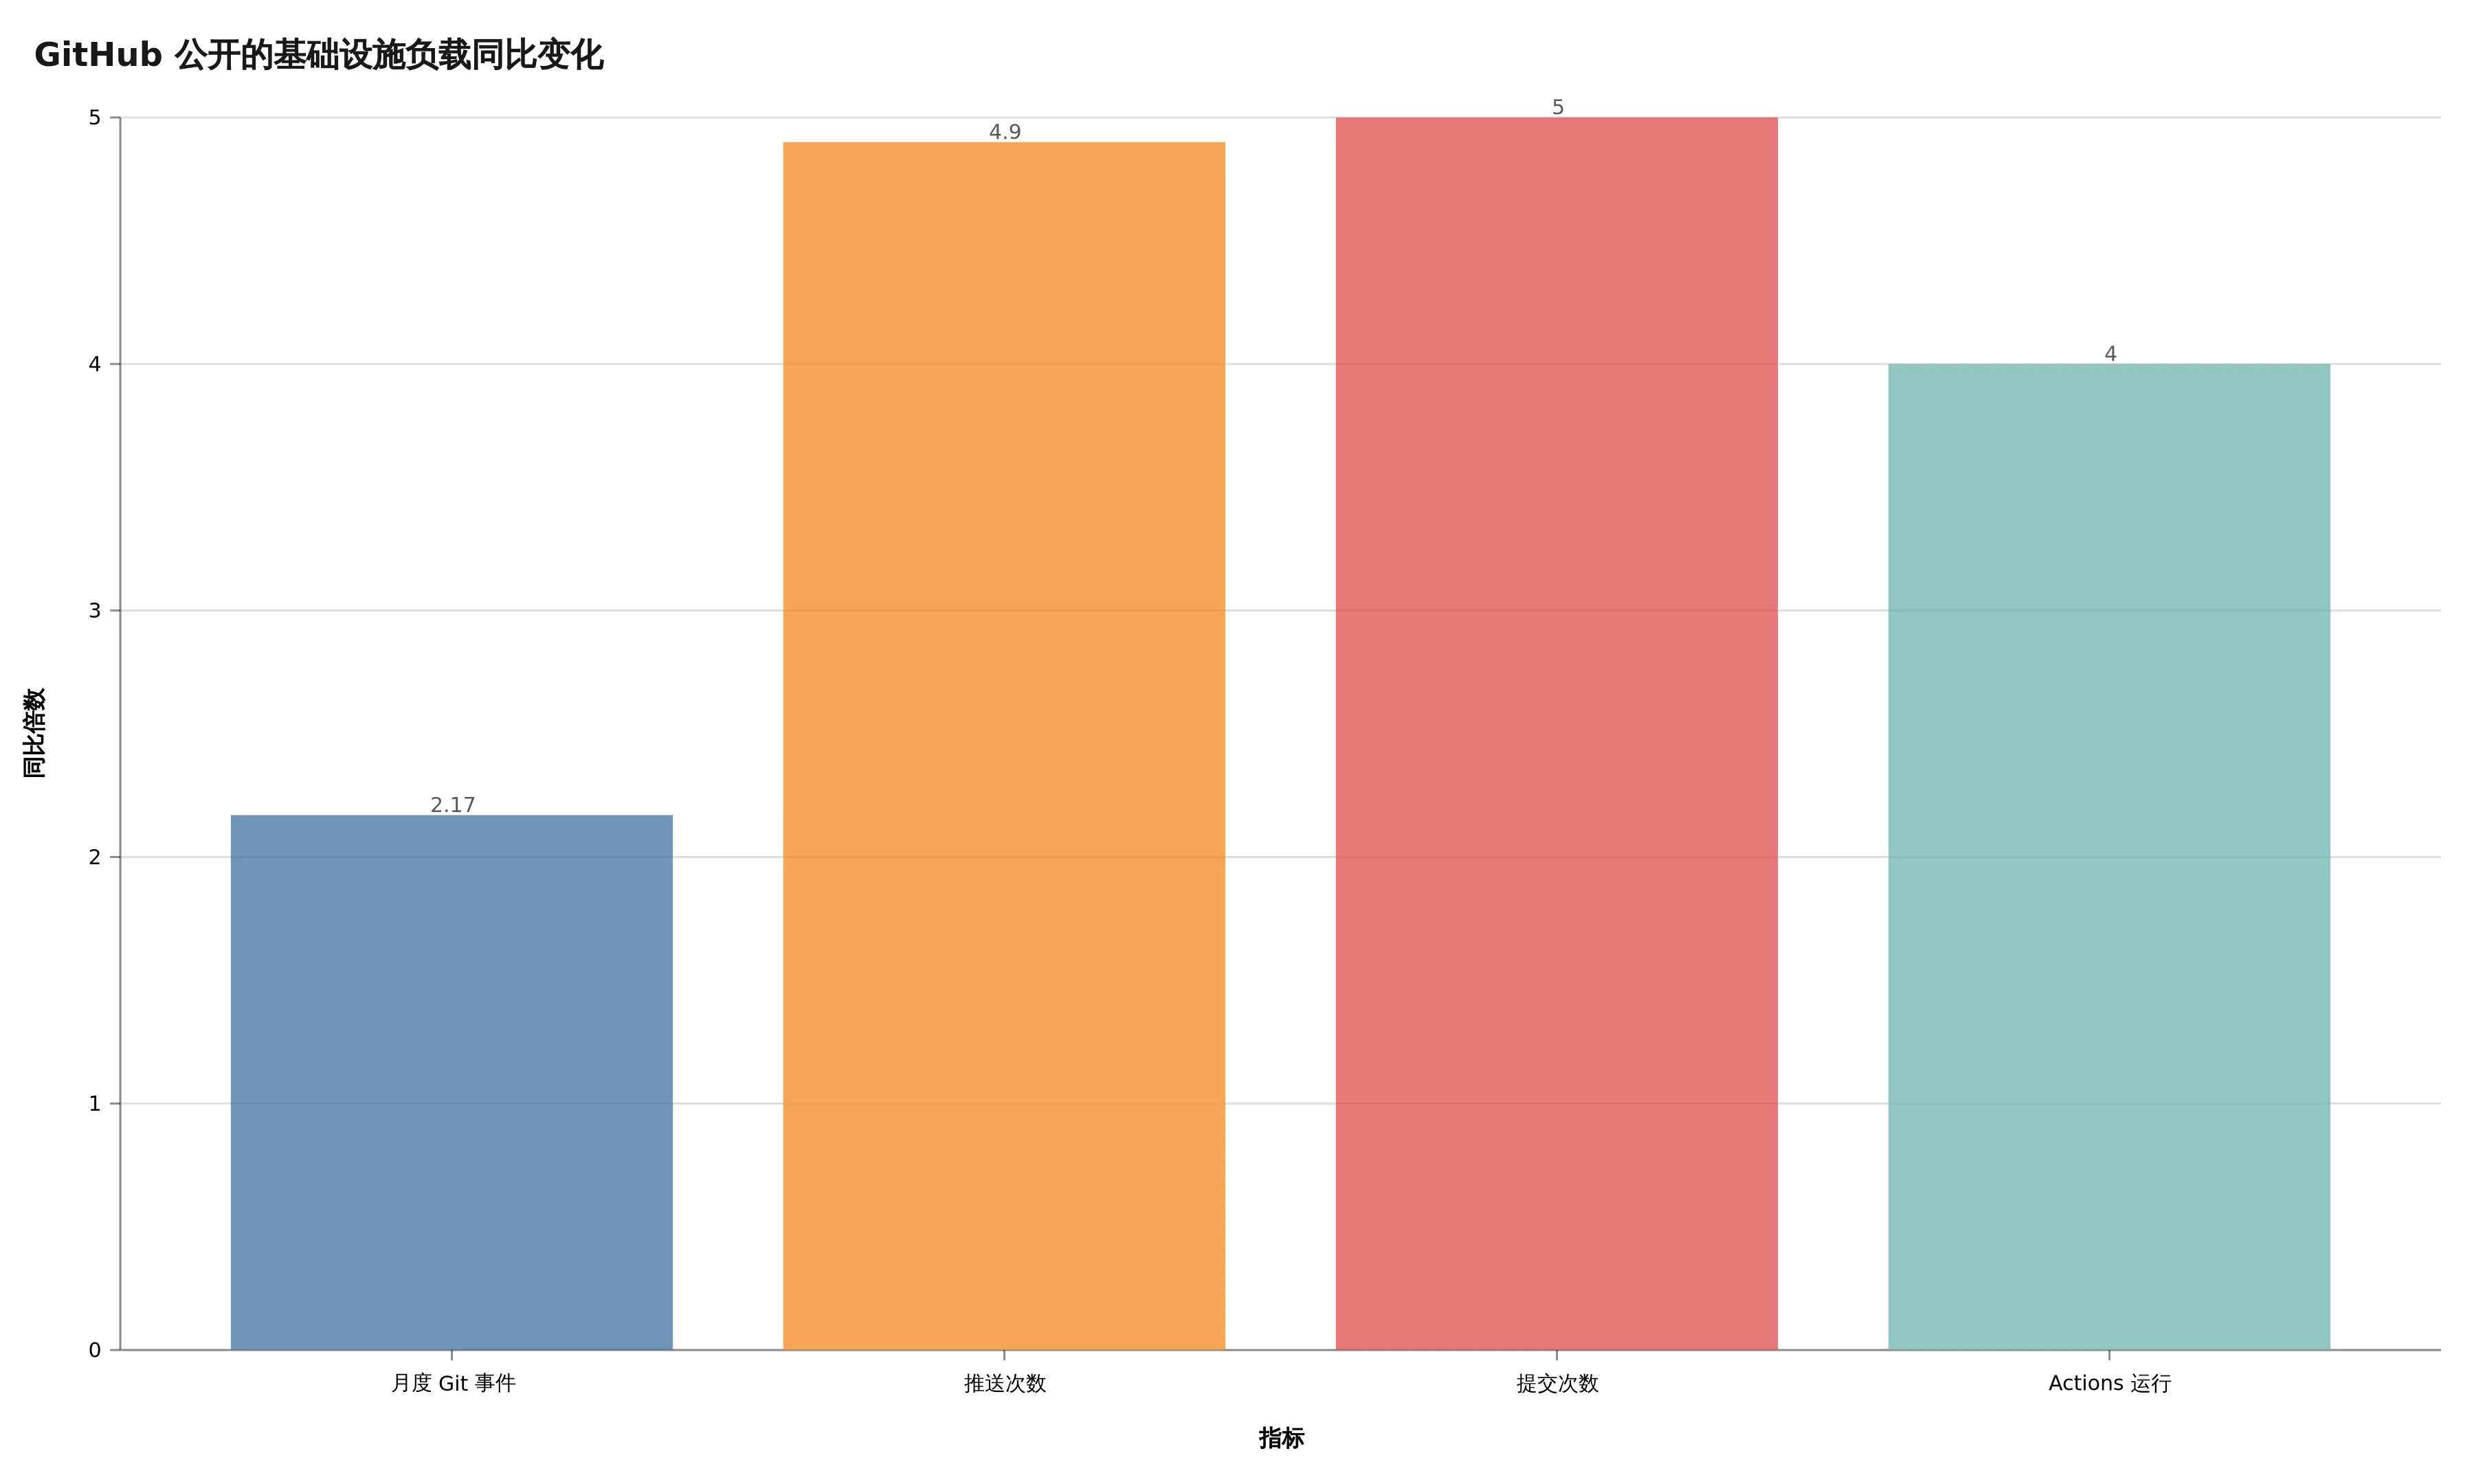
GitHub 公开数据,增长最快的不只是提交,还有推送与 CI 运行。
这篇公告最值得工程团队看的,不是 Azure Blob Storage,也不是 GitHub 那个最高可达 35 倍写入吞吐的内部基准。那是平台要解的题,离多数团队还远。
真正该拿走的提醒很朴素,Agent 并行一多,代码托管链路会从背景设施变成吞吐瓶颈。模型调用再快,变更进不了可信主干,交付速度照样被卡住。
先别把并发 Agent 当成并发人类
人类开发者会停下来读需求、等评审、去吃饭,提交频率天然带着空隙。Agent 不一样。它处在工具调用循环里,改一处、跑一次、提交一次,失败了再接着试。GitHub 把这件事说得很直接,单次 push 的延迟会成为一个 Agent 的速度上限。
这不是在说 Agent 喜欢频繁提交就不对。恰恰相反,细粒度 checkpoint 让回滚、比较和审查更有依据。问题是,团队以前把 Git 当作稳定但不用太操心的底座,开始并行跑 Agent 后,它会变成每一步都要经过的收费站。
所以别只盯着一个 Agent 的任务完成时间。多 Agent 真正该看的,是从改动产生到可被下游 CI、评审和其他 Agent 安全消费,中间到底堵在哪儿。
一个很实用的判断法是,先看这四个问题。
第一件事,任务有没有真的隔开
让三个 Agent 同时改一个大目录,和让三个 Agent 各自在独立 worktree、独立分支里完成边界清楚的任务,表面都叫并行,后果差很多。
前一种会把冲突拖到收尾,等三份改动都写完才发现碰到了同一组文件、同一个配置,或者同一条默认分支。后一种至少把冲突暴露在合并前,还能让人知道哪项任务该停、该拆,还是该重新排顺序。
GitHub 的新架构仍然把分支、评审、合并和历史当作要保留的工作流。这个取舍挺对。Agent 多了,不代表人就可以失去变更的边界。分支隔离不是旧世界的仪式感,它是让多个自动化执行者不互相踩脚的最小护栏。
如果你们现在只能回答「大家都在同一个仓库里跑」,那还没到加 Agent 数量的时候。先把任务按目录、服务、接口或者明确的文件集合切开,效果通常比换更大的模型来得实在。
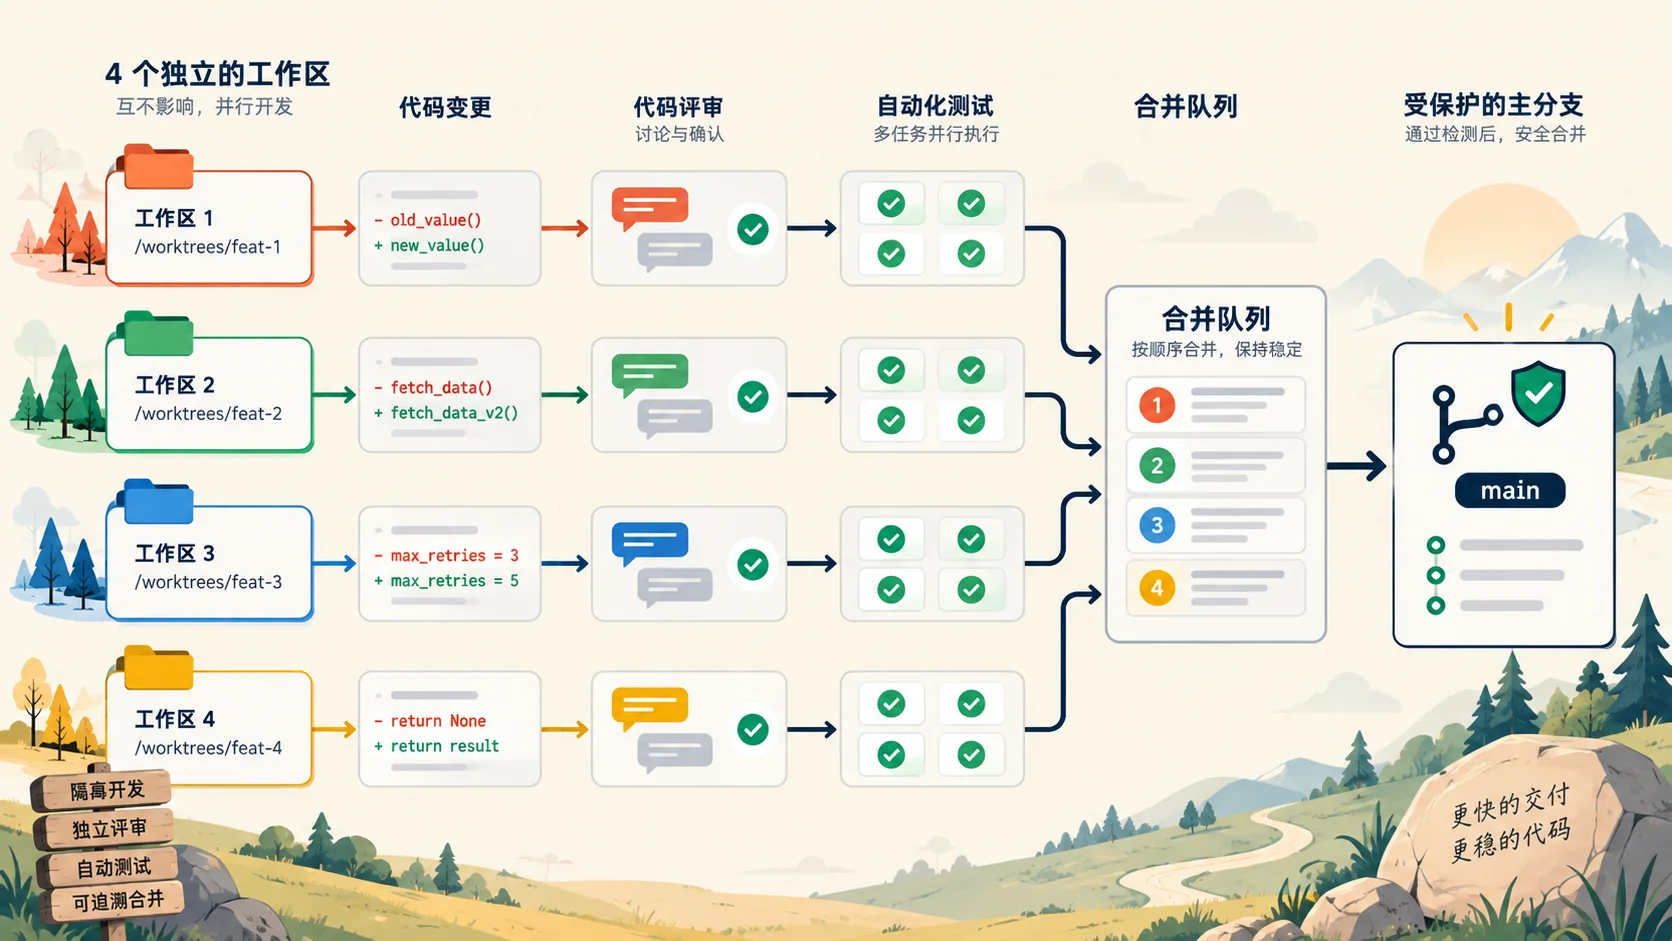
先隔离任务,再让变更经过评审、测试和受保护的合并路径。
第二件事,把提交和推送延迟放进看板
以前看板上常有构建时长、失败率、发布频次,Git push 的延迟大多没人单独盯。人类一天推十来次,晚几秒也不至于把下午毁掉。
Agent 不会这么客气。它们每一个小循环都可能碰一次远端,很多并行分支又会同时碰。GitHub 的数据里,2026 年 9 月推送量达到 33.5 亿次,写入压力不再是少数巨型仓库的怪问题。
团队不需要照着 GitHub 重建存储层,但可以补两个很便宜的指标,提交到远端的 P95 延迟,以及因为锁、限流或服务错误重试的比例。前者告诉你 Agent 是不是在等路,后者告诉你并发是不是已经开始制造看不见的浪费。
这类数据一开始可能没什么戏剧性。可当某个批量任务一开,P95 突然翻倍,CI 等待队列跟着变长,排查会比在聊天记录里猜「今天模型是不是抽风」靠谱得多。
第三件事,合并队列要有资格当调度器
GitHub 在文中点出了一个很老但很顽固的事实,最终所有变更都会争同一条引用。无论前面分了多少分支,默认分支、发布列车和合并队列,总有一个地方要决定谁先进去。
人类团队可以靠默契和时区把这个问题糊弄过去。Agent 不会。它们能在很短时间里交来一堆看起来都通过测试的改动,然后把真正的竞争压到合并前几分钟。
这时合并队列就不能只是一个排队页面。它至少得回答三件事,哪些检查必须在合并前重跑,哪些改动能并行验证,队列变慢时谁该降速。没有这些规则,多 Agent 最终只会把等待从写代码阶段搬到绿色按钮前面。
你也不必一上来搭复杂的自治调度系统。先给 Agent 任务一个并发上限,把触及同一目录或同一依赖的任务分组,再为高风险路径保留人工确认。厉害了,这几条土办法在并发上来以后,往往比又加一层提示词有效。
第四件事,别让 CI 和审计成了盲区
GitHub 的数字里还有一个很容易被跳过的部分,9 月 GitHub Actions 跑了 32.6 亿次,同比增长超过四倍。每一次提交后面的 clone、fetch、代码扫描和测试,会把一次小改动放大成大量读取。
Agent 编程最容易出现一个错觉,代码生成很快,所以整个流程很快。可只要 CI 被重复触发、缓存命中率掉下去、同一分支被反复拉取,算力和等待都会在你没看见的地方堆起来。
更麻烦的是审计。Agent 越多,越不能只留下最新一条 merge commit。任务从哪里来,调用过哪些工具,修改了什么,谁批准了合并,失败后怎样回滚,这些记录不是给流程加负担,它们是以后定位事故时唯一能走回去的路。
GitHub 这次强调要保留分支保护、必要评审、审计日志和仓库可见性,我觉得很关键。平台可以为了吞吐拆开存储和计算,团队不能为了追吞吐拆掉责任边界。
一个够用的落地顺序
如果你们刚开始让 Agent 并行改代码,先别被 35 倍吞吐这种数字带跑偏。按下面这个顺序做,成本低得多。
第一步,给每个 Agent 一块明确的变更边界,默认独立分支或 worktree。
第二步,在看板上补提交 P95、推送重试率、合并队列等待和 CI 重复执行率。
第三步,给同目录、同接口和同一发布路径的任务设并发上限,必要时改成串行。
第四步,把 PR、测试结果、工具调用和人工确认串到同一条可追溯记录里。
听起来不酷,甚至有点像又多了几张表格。可这正是把 Agent 从演示里的单人秀,变成团队生产力的那段路。
GitHub 重做 Git,不是在宣告每个团队都该升级底层架构。它只是把一个更早到来的问题摆在了台面上,自动化开发的单位不再只是一个人,也开始是一群会不断提交、不断触发系统的执行者。
模型能力当然重要。但当多个 Agent 开始同时碰你的仓库,谁能稳稳地让改动被隔离、验证、合并和追溯,谁才是真的把并行开发跑起来了。
你们团队现在最先卡住的,是 Agent 的任务拆分、Git 推送、CI,还是合并队列?