posts/gpt-57-official-404-no-benchmarks.md
GPT-5.7 官方页还是 404,别急着替它跑分
有些模型还没出现,结论已经排队来了。
GPT-5.7 就是一个很干净的例子。有人贴出产品截图,有人说路由里见过名字,有人转来一张分数表,接着就有人开始写它比谁强、该不该迁移、某个榜单要变天。消息跑得比模型快,厉害了。
但这次的公开核验结果很朴素。截至 2026 年 9 月 6 日,OpenAI 的 GPT-5.7 文档直达路径 返回 404,官方模型目录 没有这个条目,API 变更日志 也没有这个名字。
这几件事只支持一个窄结论,公开资料里还没有足够证据,把 GPT-5.7 写成一个已经正式发布、可以公开调用并能稳定复测的模型。
它们不支持另一个更大的结论,OpenAI 内部肯定没有做任何相关研究。公开缺席和内部不存在,是两回事。把这两句话黏在一起,才是很多讨论最容易滑倒的地方。
在模型真正出现以前,最值得写的不是它有多强,而是我们凭什么认定它已经出现。
先把“看到”和“证实”拆开
一张截图是真的截图,不等于截图里的产品状态已经公开生效。一个路由名真的出现过,也不等于它对应的模型可供外部客户使用。缓存摘要可能是旧页面残影,搜索结果也可能把转述和原始页面混在一起。至于二次传播的 benchmark 图,常常连模型 ID、访问权限、提示词和工具开关都没有。
好家伙,信息流最会干的事,就是把一条线索压缩成一句像结论的话。
工程上有个很朴素的习惯,先问证据能证明到哪一层。一个模型的官方公告,可以证明发布方正在公开说这件事。模型目录、价格页、模型卡或 API 文档,可以说明命名、访问范围、能力边界和使用成本。独立复现的测试,才有资格讨论它在某个任务上的表现。
官方公告也只回答「发布方说了什么」,它不自动回答「每个账户现在能不能用」,更不会自动回答「放进你的代码库会不会更好」。这不是抬杠,是把产品事实、访问事实和性能事实拆成三张不同的单据。模型新闻最容易翻车的瞬间,往往就发生在这三张单据被合并成一张海报的时候。
这三层不是同一件事。
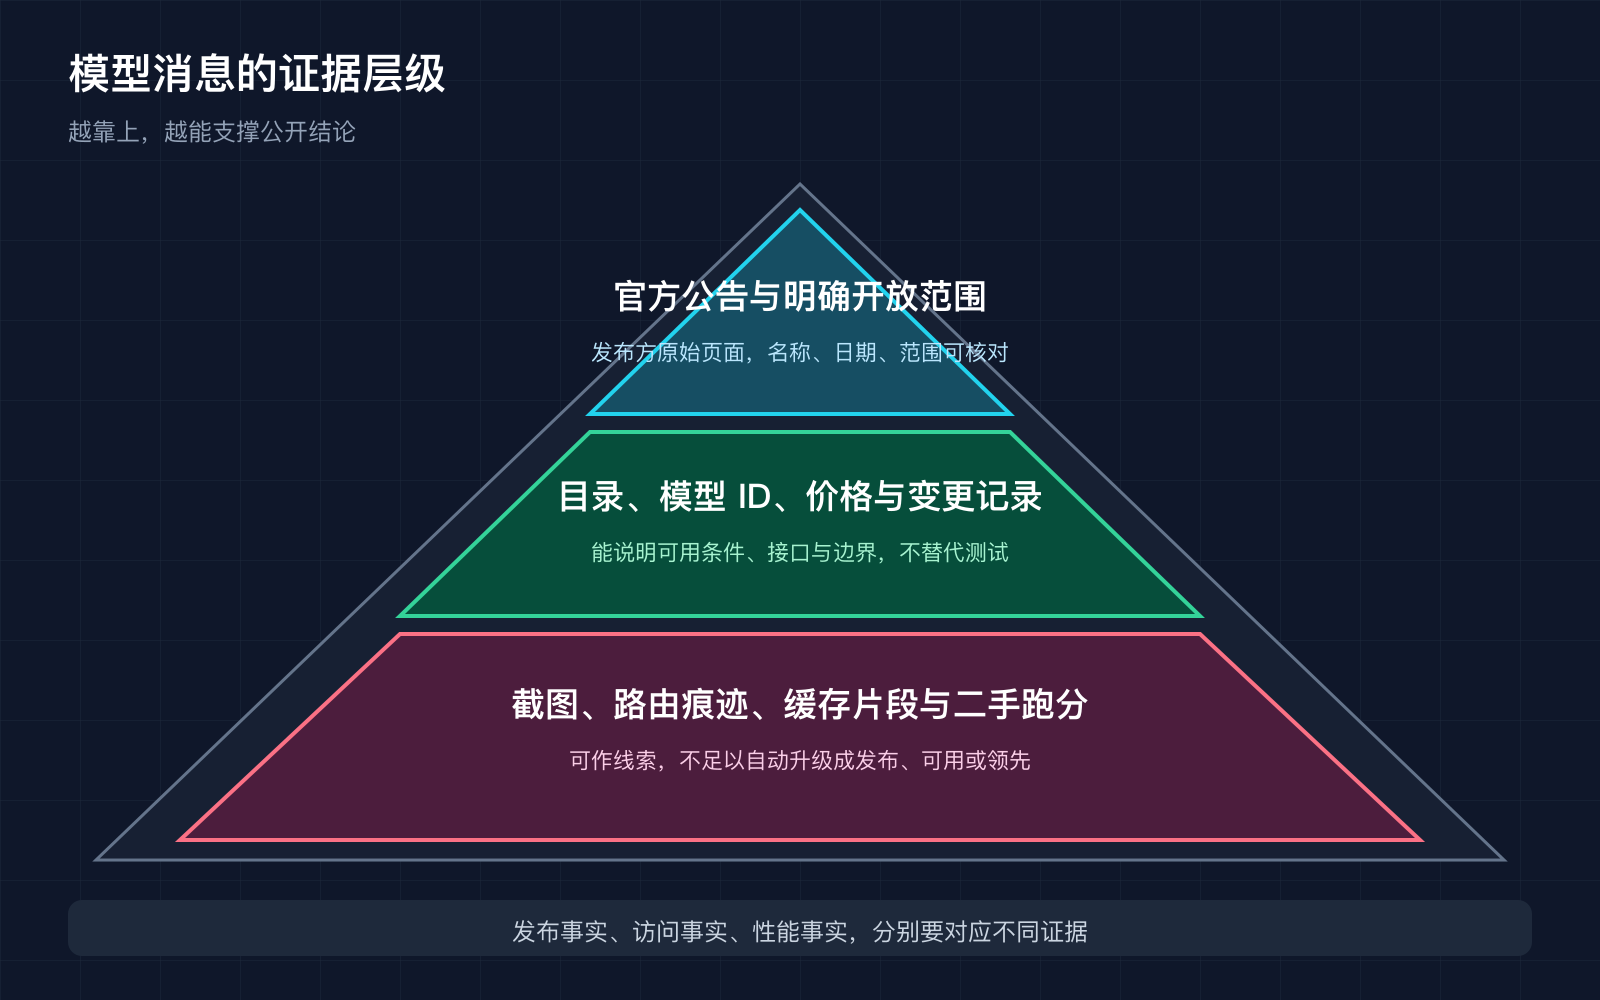
图里最重要的不是把截图一票否决。截图可以是线索,路由记录也可以是线索,缓存片段当然也可以是线索。它们值得被保存、被追问、被等待后续材料印证。
只是线索不能自动升级成发布,发布也不能自动升级成已对所有人可用,更不能自动升级成在你的业务里更强。中间少一个环节,标题就应该少一档语气。
一个真正能落地的发布判定
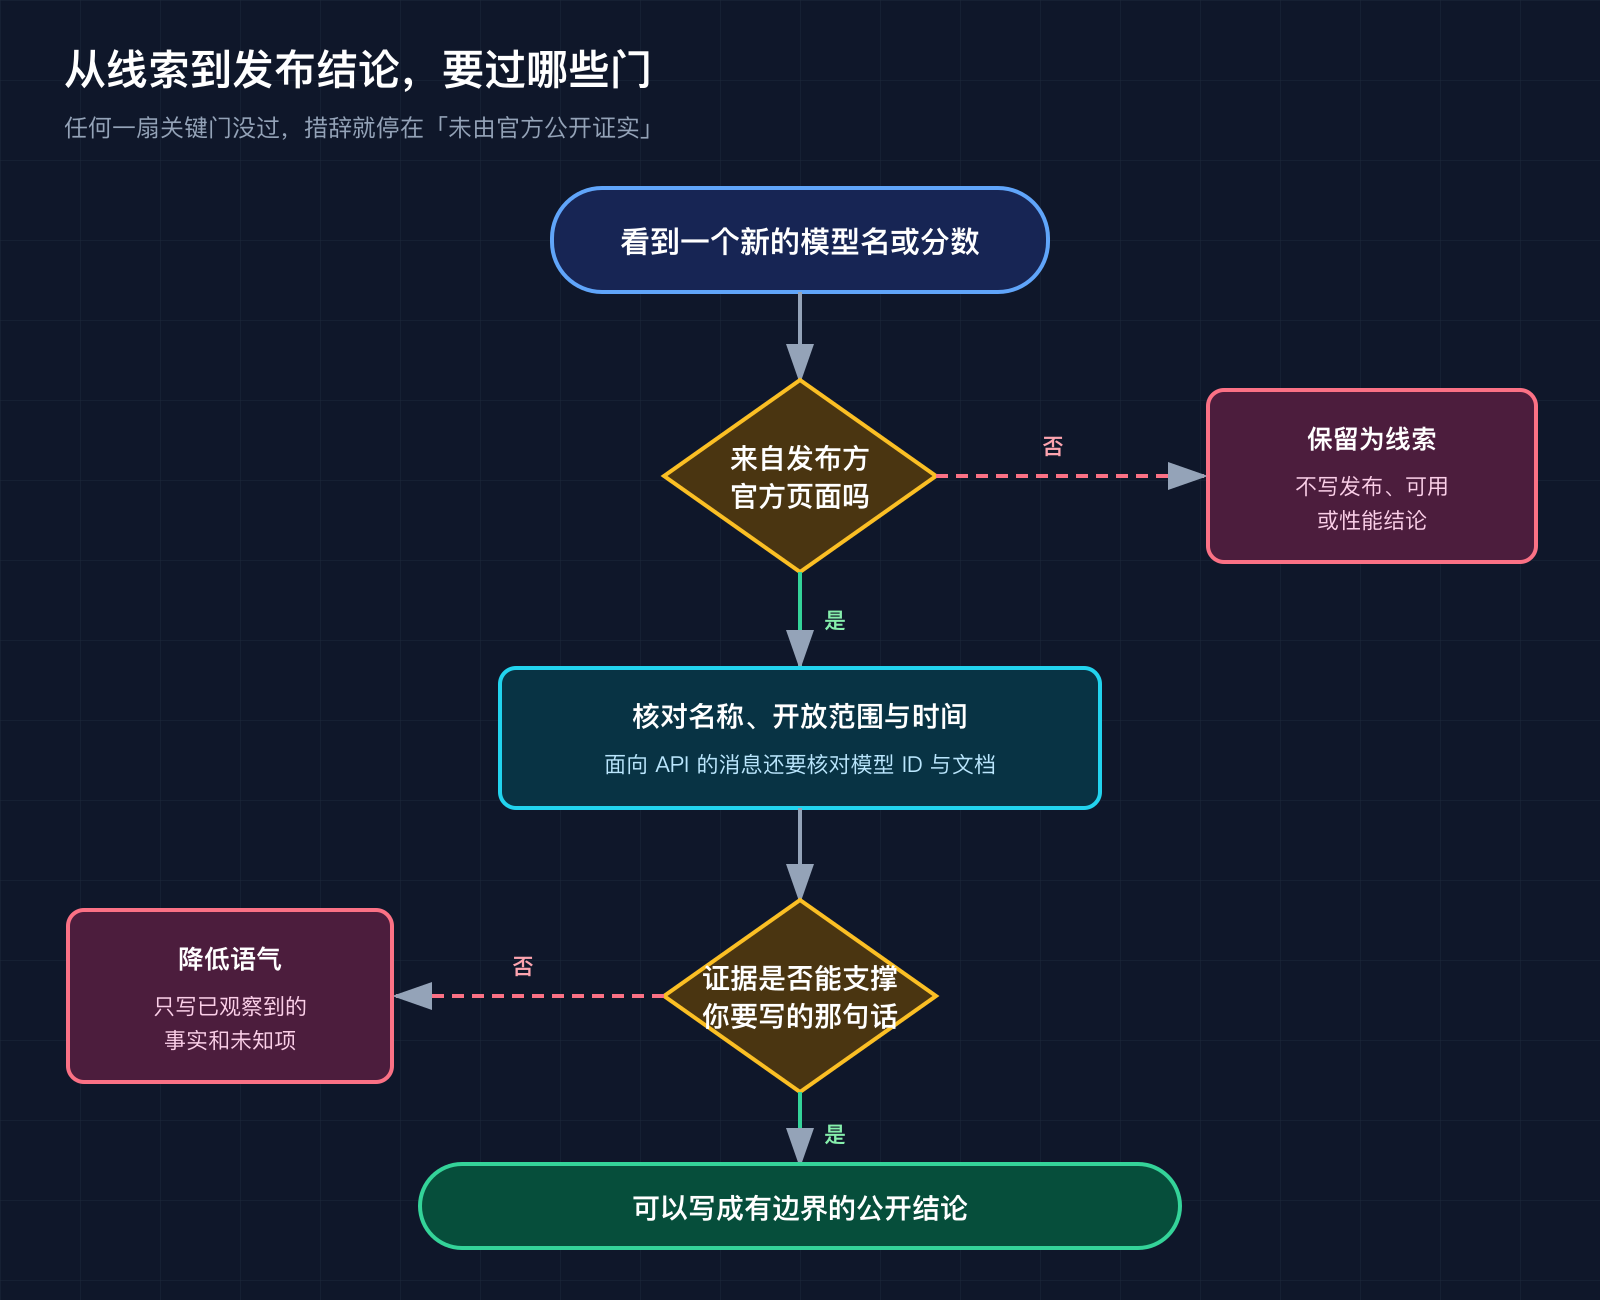
如果你准备转发、写点评,或者要把一条模型新闻带进团队的选型会议,可以按这个顺序过一遍。它不优雅,但很省掉后来改稿和回滚判断的时间。
先找发布方自己的页面,确认域名、发布时间和模型名称是否明确。然后看页面有没有说清适用产品、开放范围、地区或账户条件。面向 API 的消息,还要确认模型 ID 是否出现在模型目录、文档或变更记录中。涉及安全、价格和能力边界时,继续找模型卡、系统说明、价格页或开发者更新。
只要这条链里关键一环还空着,就把措辞停在“尚未由官方公开证实”会更诚实。不要替发布方补全日期、上下文长度、参数规模,也不要用“已上线”“已实测”去填一个网页上还没有的空白。
对内容团队来说,这套分法还有一个很现实的好处。发现线索的人不必假装自己已经完成核验,只需要把原始链接、截图时间和看到的位置留好。负责发布的人只处理能够落到公开页面上的事实。真正做评测的人,则等到模型标识和访问条件稳定后,再开始记录实验。三种动作都重要,只是不要让后一层替前一层背书。
如果你在做产品选型,边界还要再收紧一点。传闻可以提醒你把接口写得更可替换,把预算留出余量,却不该成为改架构、采购额度或承诺客户交付时间的依据。模型更新很快,工程上的稳妥不是假装自己什么都不知道,而是让未知项不进入已经签字的判断。
这里有个常见误会。有人会说,等所有材料齐了,热点都凉了。这个焦虑我懂,做内容的人和做产品的人都怕错过窗口。
可抢时效,不等于抢结论。你完全可以先写“目前官方公开了什么,还没有公开什么”,把页面、时间和边界摆好。这样的稿子反而更经得住更新。等正式资料来了,再补能力、价格和测试,不需要把昨天的笃定悄悄删掉。
跑分不是一张图,是一份实验记录
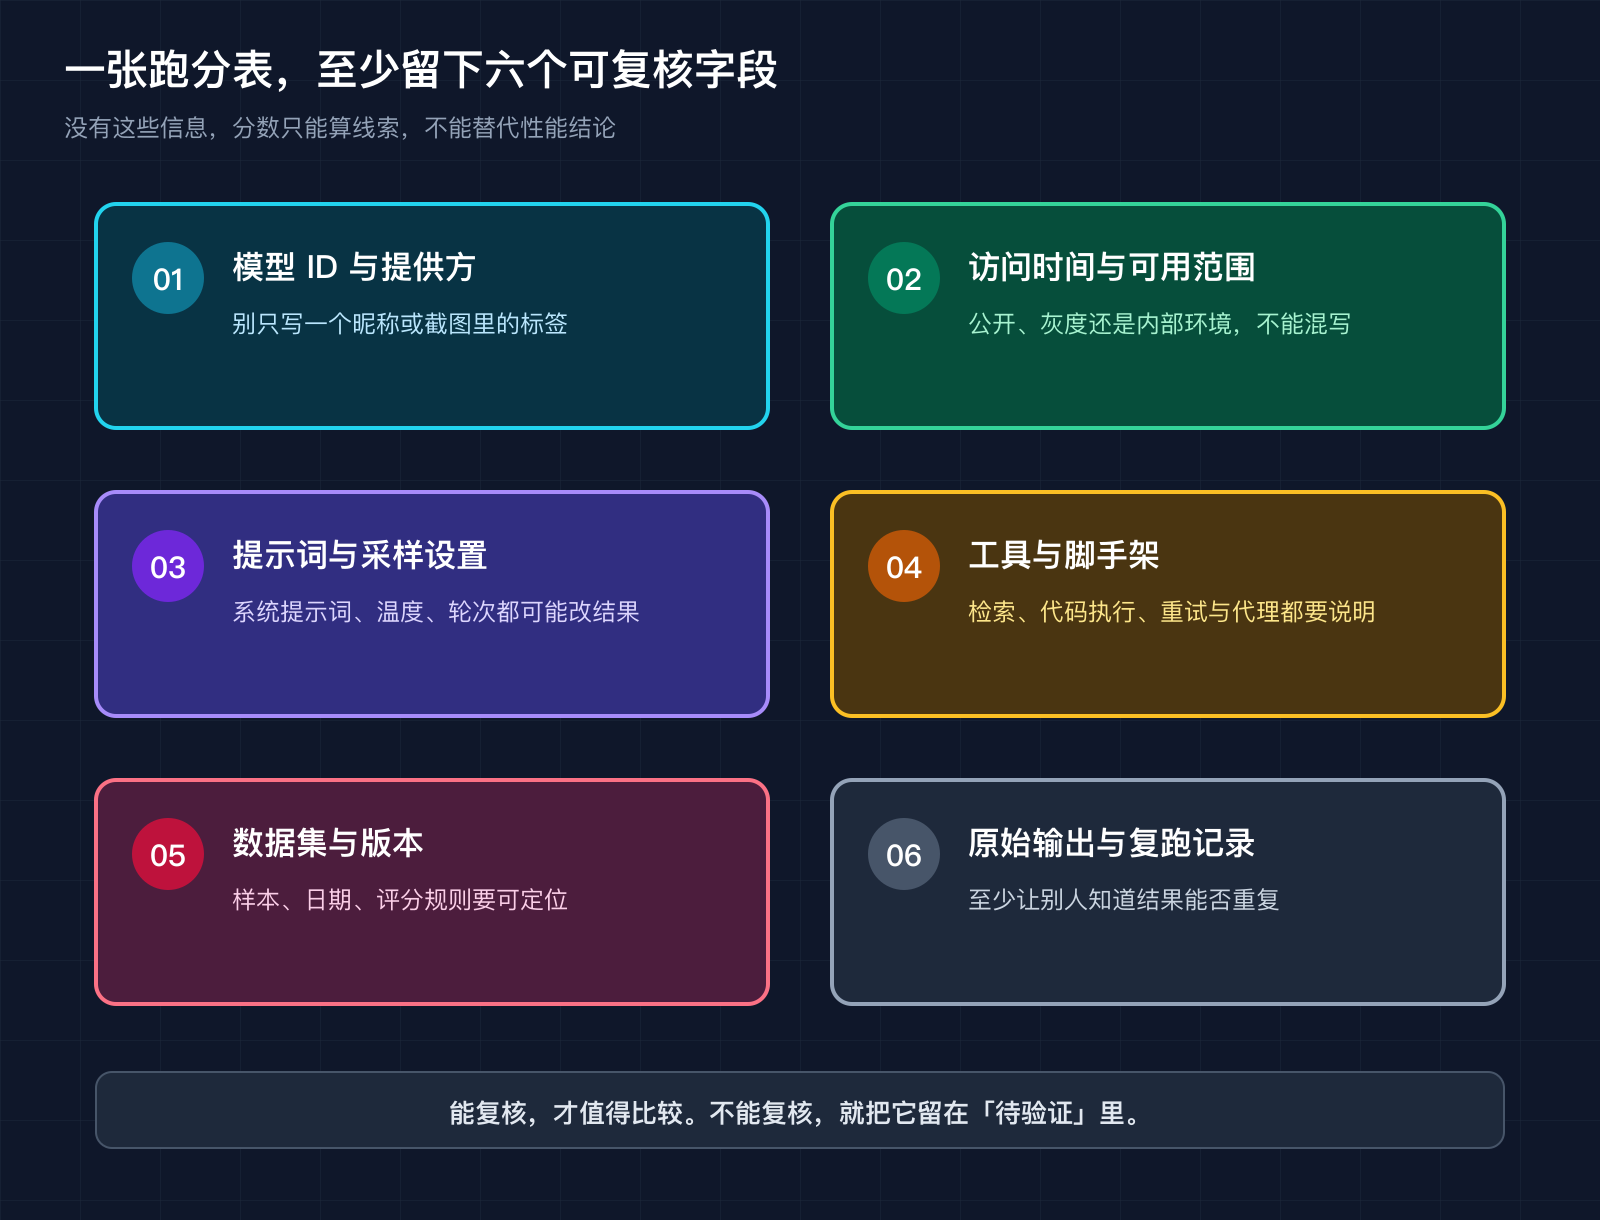
尤其别急着替一个尚无公开模型条目的名字跑分。没有可核对的模型 ID,就无法确认实际调用了谁。没有访问范围,就不知道这是公开版本、灰度版本,还是别的环境。没有提示词、工具、数据集版本和原始输出,就无法判断分数是模型变化、脚手架变化,还是某个设置刚好占了便宜。
不是说封闭测试没有价值。它可以帮助参与者做内部决策,也可能比公开发布更早发现问题。可它的证据边界必须跟着访问边界走。把只够内部参考的结果,写成全行业比较,读者拿走的不是信息,是一个很难复核的印象。
如果一张跑分表真要被当成结论,最少该附上六件东西,模型 ID 与提供方、访问时间与可用范围、系统提示词和采样设置、是否调用工具、数据集及其版本、原始输出或可重复的运行记录。少了其中几项,能说的通常只是“有人声称看到过一个结果”。
这也是为什么我不太喜欢提前替未来模型排座次。它看起来很懂行,实际上把最难的变量全部藏起来了。模型名字可能会改,访问政策可能不同,工具配置会影响结果,连同一个基准的版本都可能变。拿一个未确认的标签去承接这些变量,等于先把结论写好,再慢慢找证据。
404 不是终点,是一个停笔点
这次 GPT-5.7 的 404 不是什么大新闻,它只是一次很清楚的提醒。当前公开页面不足以支撑发布、可用或 benchmark 的断言,就到此为止。继续猜,当然可以。但猜测要叫猜测。
很多朋友可能不知道,真正节省团队时间的不是更早转发一个名字,而是更早建立一句统一的话术。没有官方条目时,先不写上线结论。没有访问条件时,先不写全面可用。没有实验记录时,先不写性能领先。
这样做一点也不扫兴。相反,它让我们在正式资料到来时,能更快分辨什么是新事实,什么只是旧传言换了张皮。
下次再看到一个还没进官方目录的模型名,先别急着开跑分表。把浏览器标签页里的热闹按住几分钟,核对发布方、模型条目、开放范围和实验记录。
等证据到了,再下结论。