
GPT-6.1 Terra 便宜十倍后,电脑操作任务怎么分级?
Terra 用更低价把电脑操作推到日常任务里。关键不在于“能不能点”,而在于把读取、填写、提交拆成不同的授权与验收层。
OpenAI 刚把 GPT-6.1 Terra 放进 Codex、ChatGPT Work 和 API。它会看屏幕、跨应用操作、写东西,标准 API 价格是每百万输入 token 1 美元、缓存输入 0.05 美元、输出 5 美元。官方公告给出的重点很直白:电脑操作这件事,开始从“昂贵的演示”往“可高频调用的工作流部件”走。
但我更在意另一个问题:当模型点按钮、填字段、切软件的边际成本一下子降下来,团队会把更多步骤交出去。真正需要先改的,反而不是模型路由,而是授权设计。你得先区分它是在读、在填,还是在替你提交。
Terra 的发布适合拿来重画一条线:便宜可以扩大自动化覆盖面,不能自动扩大模型的决定权。
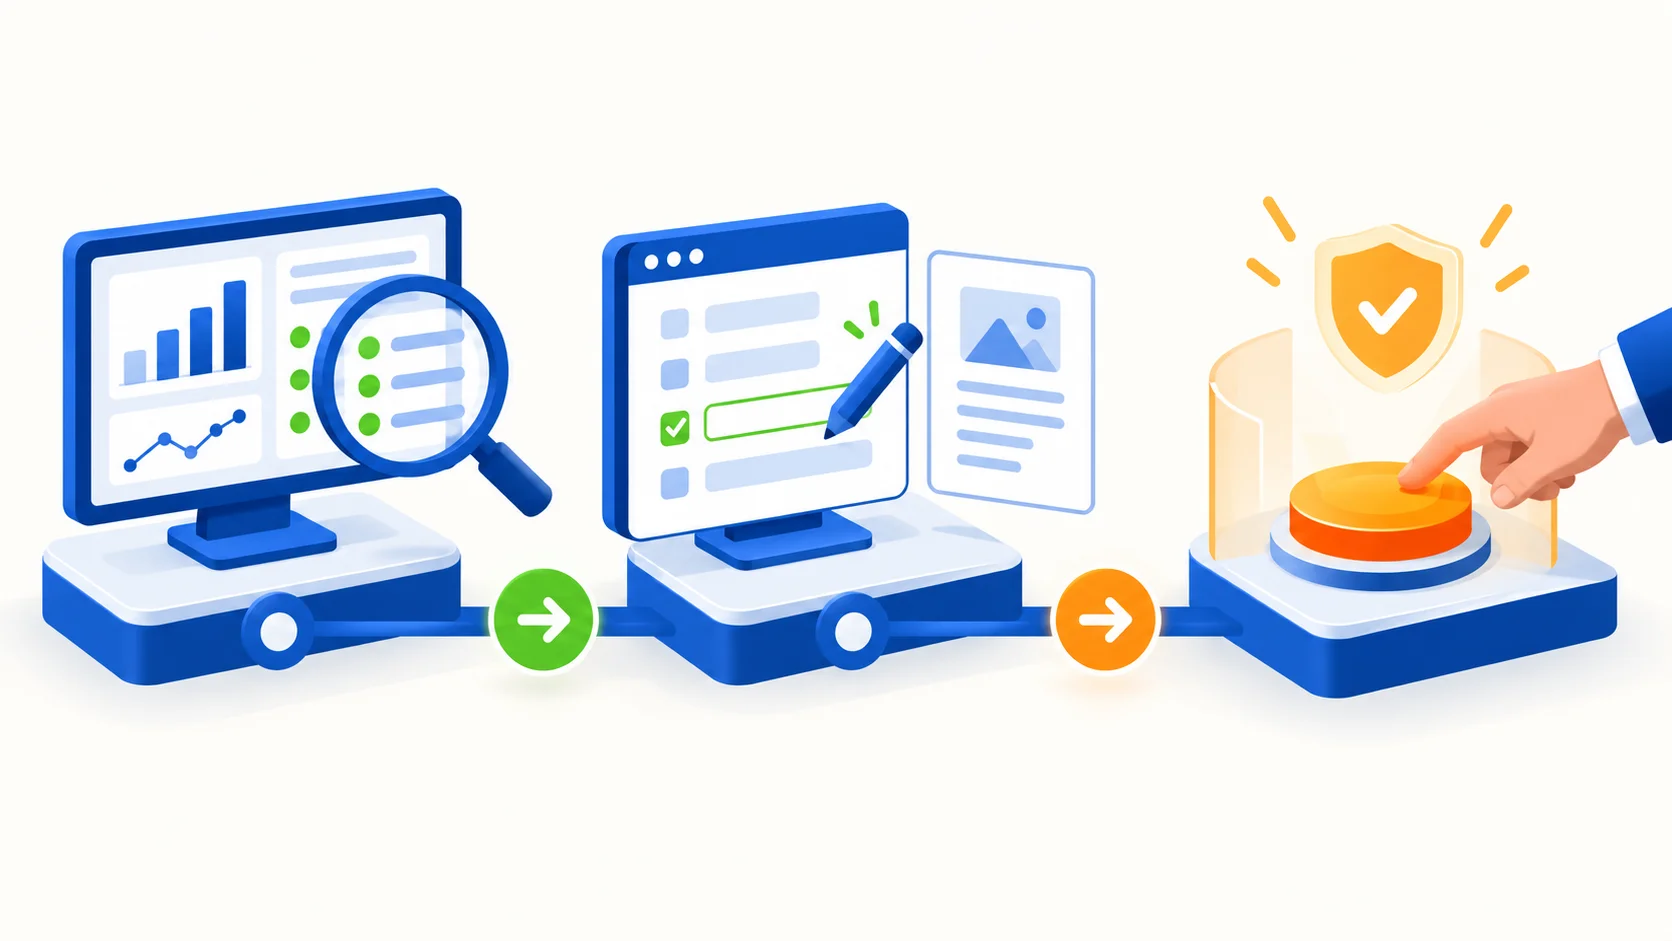
把电脑操作按动作后果分层,比先讨论“要不要全自动”更实用。本文为设计示意,不是官方产品界面。
这次降下来的,到底是什么
官方把 Terra 定位为视觉推理和精确电脑操作模型。它能处理读技术图纸、填表、改文档、剪视频这类横跨多个应用的任务;开发者则通过 gpt-6.1-terra 调用,模型页列出了 computer use、web search、file search、MCP 等工具能力。模型文档还给出了 105 万上下文和 12.8 万最大输出 token。
官方公布的比较也很激进。在 Agents’ Last Exam 的中等推理强度下,Terra 比 GPT-5.6 Terra 高 15 个百分点,成本约为三分之一;OpenAI 还称它以约十分之一的每 token 价格达到接近 GPT-6 Astra 的表现,完成任务速度超过 Astra 和 GPT-6.1 Sol 三倍。这里都该带上一个小括号:这是官方评测,不是本文独立实测。
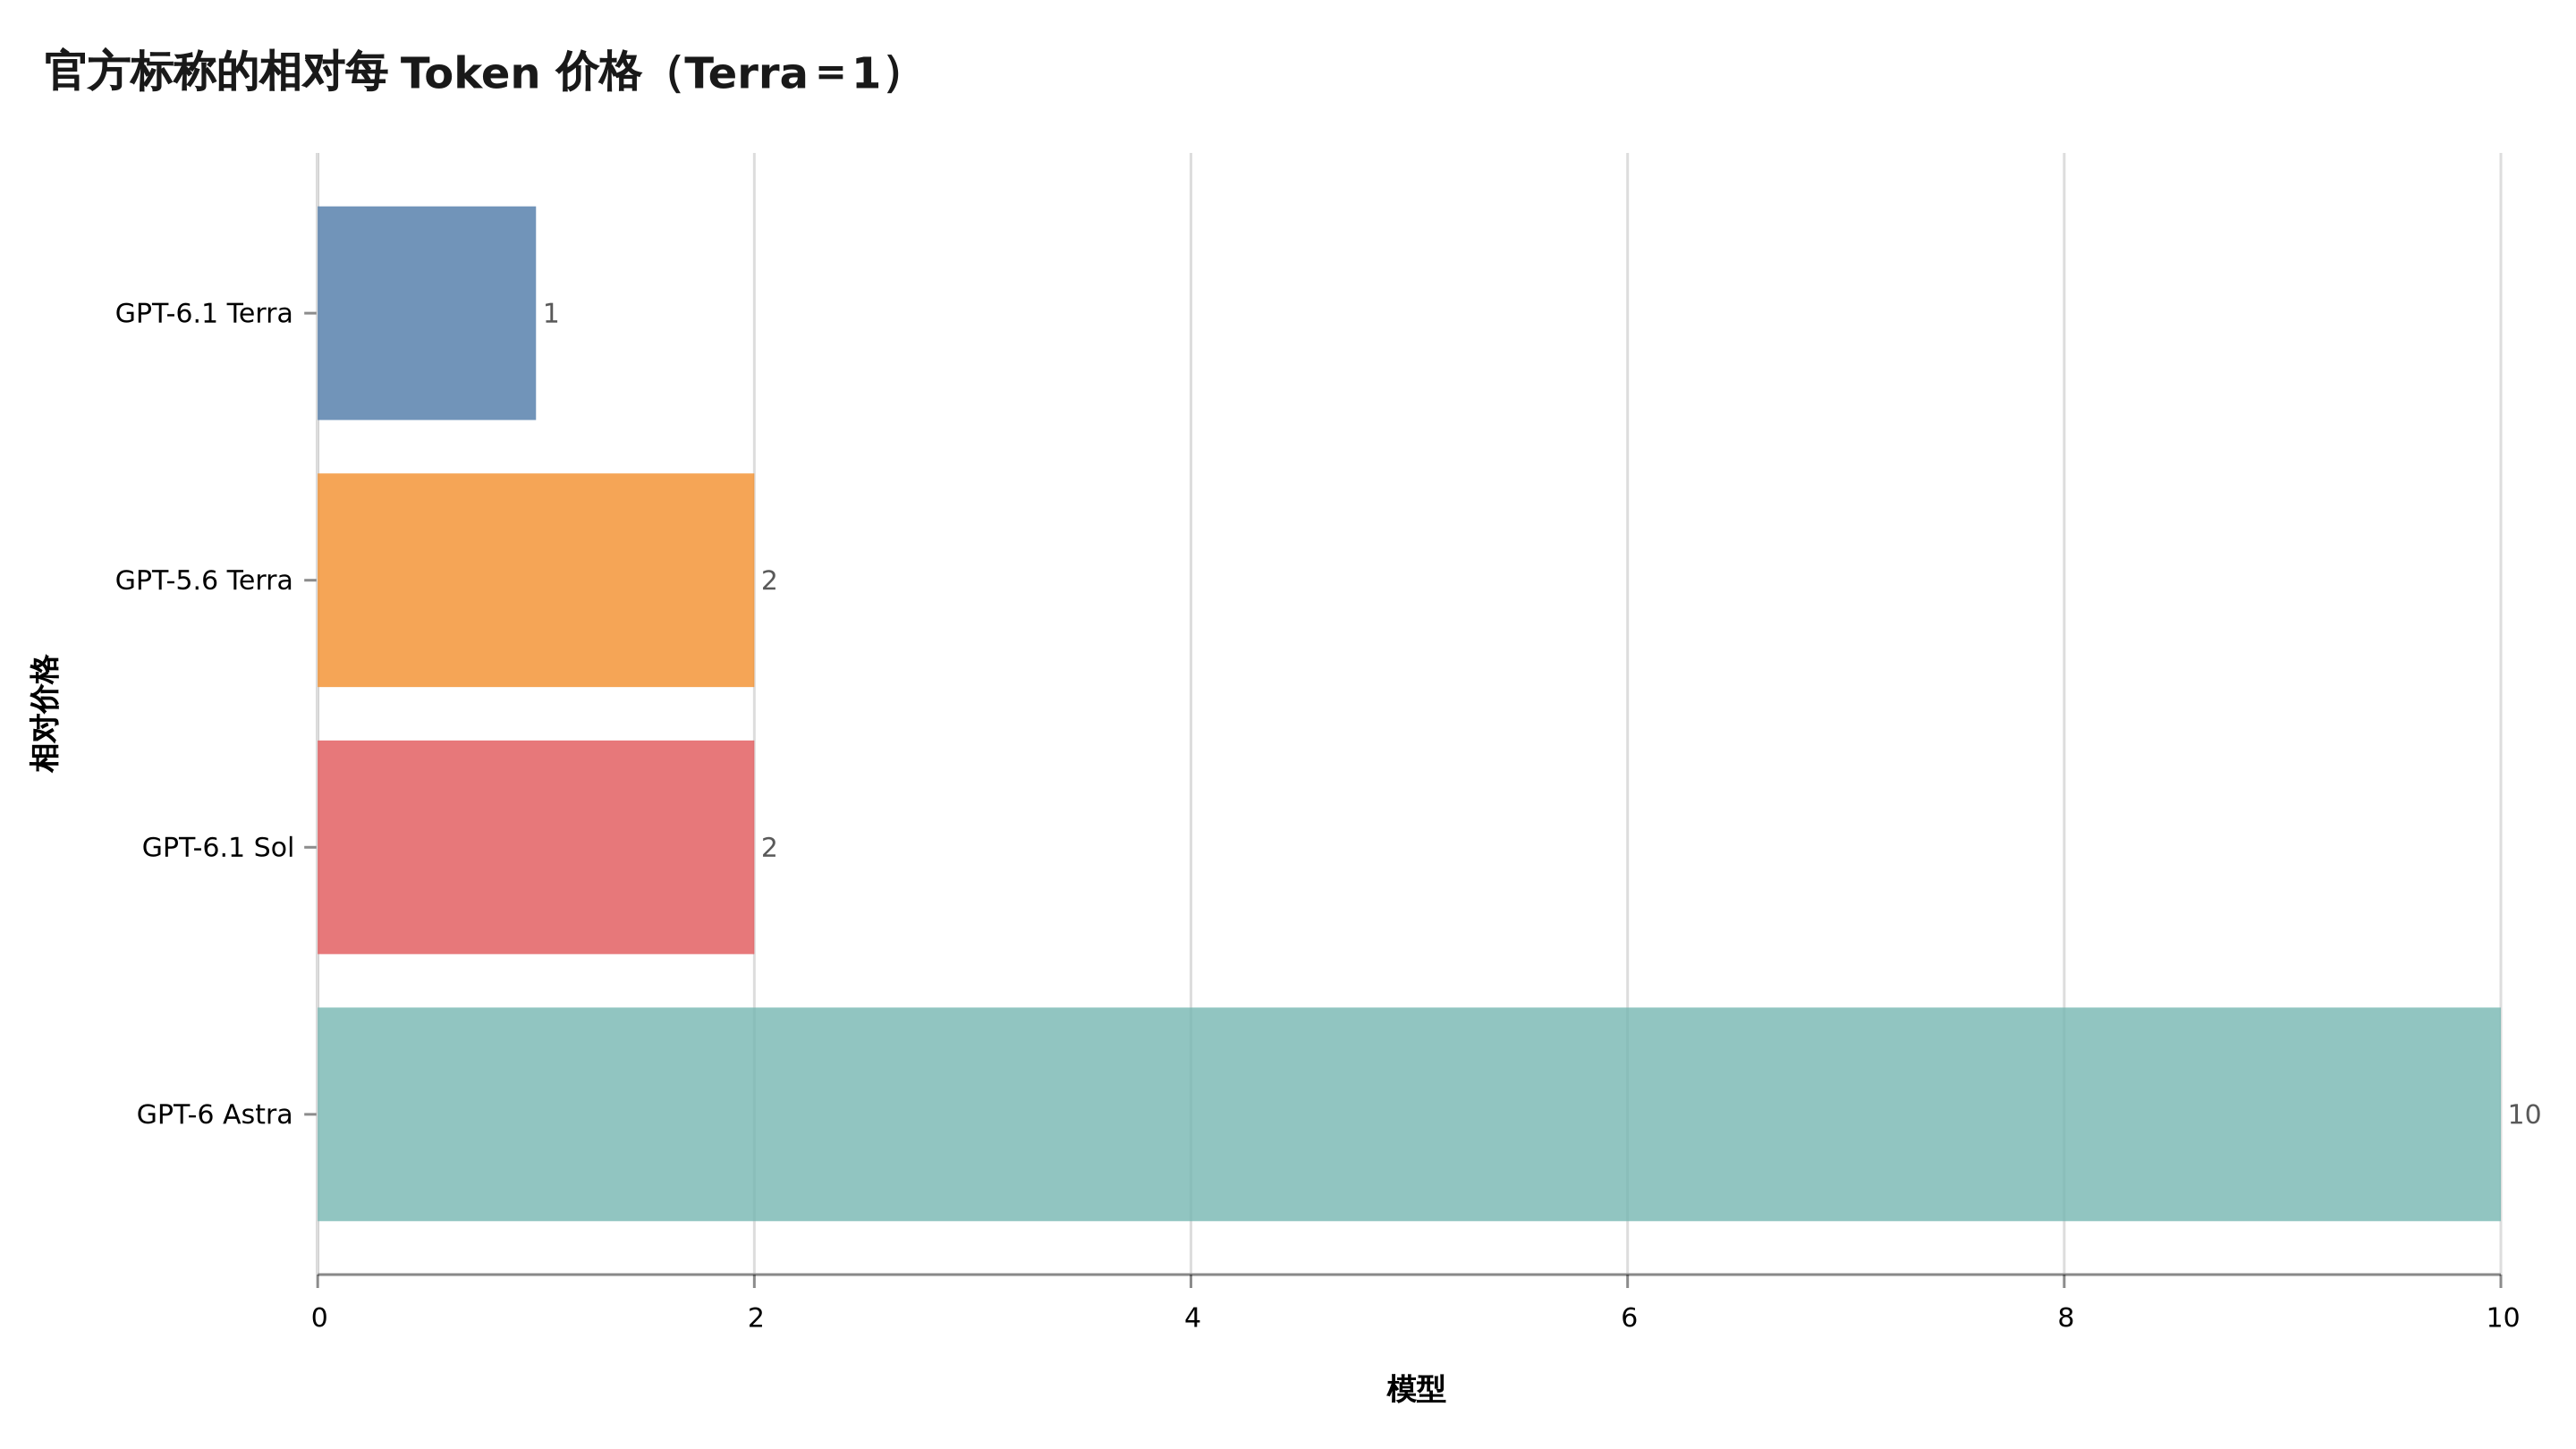
相对价格以 Terra=1 计算。GPT-5.6 Terra 与 GPT-6.1 Sol 来自“Terra 标准价格低 50%”的官方表述;Astra 为官方在相近表现比较中提到的约 10 倍。它不等于一次真实任务的总账单。
图里最容易让人冲动的一点,是 Astra 那根 10 倍的柱子。可 API 单价从来不是任务总成本:长上下文、缓存写入、快速模式、工具调用、失败后的重试,还有人工复核,都会留在账单上。更要命的是,电脑操作一旦价格下降,通常不是“同样任务更省一点”,而是“以前不值得自动化的十个小动作,现在都想接进去”。
工作流的吞吐会放大,错误的吞吐也会放大。别把这句听成保守主义——低价很值得用,只是应该拿去买更多可验证的步骤,而不是买更多不可逆的权限。
别按模型能力分,按动作后果分
不少团队给 computer use 设计权限时,喜欢用一个粗开关:能不能操作浏览器,能不能调用桌面。这种开关太大了。一个模型从后台读取订单、把地址填进草稿、最后按下“发送给客户”,都叫“操作浏览器”,可三件事的后果完全不同。
我会把任务拆成下面三层。模型可以在同一次工作流里跨层,但每跨一层,授权和验收就该变一次。
| 动作层 | 常见任务 | 可以自动化到哪一步 | 人或系统要留下什么 |
|---|---|---|---|
| 读取与归纳 | 读页面、提取表格、整理收据、找出待办 | 只读访问、结构化草稿 | 来源链接、截图或字段证据、置信度与缺失项 |
| 受限填写 | 更新 CRM 草稿、录入固定字段、生成工单 | 仅写入字段白名单或沙盒 | 提交前预览、字段 diff、回滚记录、抽样复核 |
| 最终提交 | 对外发送、发布、付款、删除、改权限 | 默认停在确认前 | 人工确认或独立审批、接收方与金额二次校验、审计日志 |
第一层最适合吃到 Terra 的低成本红利。模型要做的是把原始信息搬进一个可核对的结构,最好的结果不是“它说已经做完了”,而是让你能迅速看到它从哪一页读到了什么、哪一项没把握。只读也不是没有风险,涉及客户资料、内网页面和浏览器登录态时,最小权限依然是底线。
第二层最容易被低估。填表看着无害,但字段错位、日期格式错、把上一位客户的上下文带到下一单,后果往往不是即时爆炸,而是几周后对账时才冒出来。这里不要只做“模型生成内容的预览”,还要做它打算改哪些字段的 diff;如果一个动作没法做成 diff,至少要能回滚。
第三层最不该因为模型更快就放松。付款、发通知、删除数据、变更权限、把内容发到外部平台,问题不是模型点得准不准,而是一次点错有没有可承受的后果。把它们保留为人工确认,并不浪费自动化:模型照样可以完成读取、整理、填写、生成备选内容,最后把人需要判断的 15 秒留出来。
一份够小的上线策略
不要把下面这段当成 OpenAI 的配置项。它只是把授权策略写成可讨论、可评审的形状;真正接入时,还要落到你们自己的身份系统、审计系统和业务规则里。
task_policy:
  read:
    permission: read_only
    required_output: [source_link, evidence, missing_items]
  fill:
    permission: field_allowlist
    required_output: [preview, field_diff, rollback_id]
  commit:
    permission: human_approval_required
    required_output: [target, impact_summary, approval_record]
这张小表有个好处:模型换代时不用重新争论“它靠谱吗”。Terra 官方说,它比 GPT-5.6 Terra 更可能留在任务范围内,也更可能诚实说明阻塞;在提示注入测试里表现出更强抵抗力。公告的安全部分值得认真看,但这些改进更适合帮助你决定哪些低风险步骤可以先扩容,不能替代业务侧的审批规则。
拿“处理发票”举例。模型读取邮件和附件、抽出供应商、金额、日期、订单号,属于第一层;把这些字段填进会计系统的待提交页面,属于第二层;真正入账、付款或把异常单据放行,则是第三层。Terra 的成本和速度改善,可能让前两层更有经济性,却没有把第三层的业务责任转移给模型。
很多 Agent 项目卡住,也不是模型不会点,而是团队没有把这三个动作拆开。结果只有两个极端:要么模型权限太小,最后仍然需要人从头再做一遍;要么权限太大,大家靠一句“它应该会自己判断”祈祷。中间那条路其实很朴素:让模型尽量靠近最后一步,但在有外部后果的按钮前停住。
现在值得先试的,不是“全自动接管”
Terra 对应的最合适试点,是流程稳定、字段清楚、结果可预览、失败能撤销的工作。比如把固定格式的收据整理成待确认条目,把后台页面的信息同步进一个草稿表单,或者为客服和运营准备跨系统的操作建议。先选一条能完整留证据的链路,比一上来让模型“替团队跑一天”有意义得多。
对复杂编程任务也别把 Terra 当成万能替换。OpenAI 自己在 Terminal-Bench 4.0 的说明里写得很坦诚:最复杂的编码任务,GPT-6.1 Sol 和 GPT-6 Astra 仍是更好的选择。模型路由不该只按价格排队,而要同时看任务的难度、运行时长、是否需要看屏幕、失败代价,以及最后一步由谁签字。
电脑操作模型变快、变便宜,是一件很好的事。它让“先读、先填、先把证据摆出来”变得更便宜,也让我们没借口继续把验收设计拖到项目快上线时才补。
如果你们已经给 Agent 放开过浏览器或桌面操作,最先保留人工确认的是哪一个动作?
小岛AI|记录一线实战、踩坑与成长