
Agent 总在重复调工具?小米这套止损法,成本只要 4%
别把每一次多工具调用都当成模型失控。小米公开的复盘给了一套可复核的判断顺序,帮你在 Agent 开始空转前及时刹车。
让 Agent 去读几个文件,屏幕却开始像坏掉的复读机。
相同的搜索、相同的路径、相同的命令,一轮又一轮地刷过去。token 和等待时间一起蒸发,任务却没有往前挪半步。你以为它很勤快,它其实已经迷路了。
这个场景,做过 Claude Code、Codex、OpenCode 或自建 Agent 的朋友,多半都见过。最烦的是它不像一次干脆的报错。终端一直在动,日志还挺热闹,人却只能盯着进度条发呆。
小米 MiMo 团队刚公开了一份 MiMo-V2.6 的工具调用复盘。他们承认模型曾出现重复发起相同或高度相似工具调用的情况,还把修复过程、训练曲线和跨 Harness 对比都摆了出来。好家伙,能把自家模型的坑挖这么深再公开,这份材料比一页跑分表有用多了。
里面最值得带走的,不是 MOPD 这个名字有多拗口,而是一个运行层的判断。Agent 出手多,不等于它在干活。真正该管的,是每一次调用有没有换来新的环境信息。
小米先把三件常被混在一起的事拆开了。
并行调用没毛病。模型同时读几个独立文件,或者把彼此不相关的查询一起发出去,目的都是缩短等待。你若把这类调用全砍掉,Agent 反而会从小跑变成排队买奶茶,棒棒的,效率先没一半。
调用洪泛是另一回事。一次塞进来的工具调用多到环境处理不过来,队列开始堆、反馈开始慢,模型很可能连前一批结果都没看见,又继续往外丢。这是数量出了问题。
复读更糟。环境状态没有实质变化,模型还在发同一个工具、同一组参数,或者拿到反馈后绕回原点。这不是合理重试,也不是代码改完后再跑一遍测试,而是调用本身已经不再产生信息增量。
小米给出的可复核口径很朴素。同一个 assistant 回合里,在还没收到任何工具反馈前,如果工具名相同、参数经过 JSON 规范化后也相同,就算一次精确重复。这个口径抓不到跨回合的近似复读,也看不见脚本内部的调用,但它至少把争论从感觉它在抽风,拉回到日志里能核对的字段。
这块很重要。很多团队一看到 Agent 连续调用,就急着在提示词里加一句不要重复调用。然后它还是会重复,只是多绕两句话。问题不总在提示词,常常在运行时没有给它一个明确的停损面。
小米的训练回放很能说明这件事。在已经出现问题的样本里,单轮超过 10 次工具调用的比例,会随着 RL 训练推进从 11.1% 涨到 24.6%。他们原有的惩罚规则,要到单轮超过 32 次才出手。这个阈值像给漏水的水管准备了一把伞,等地板已经漂起来才说要不要关阀。
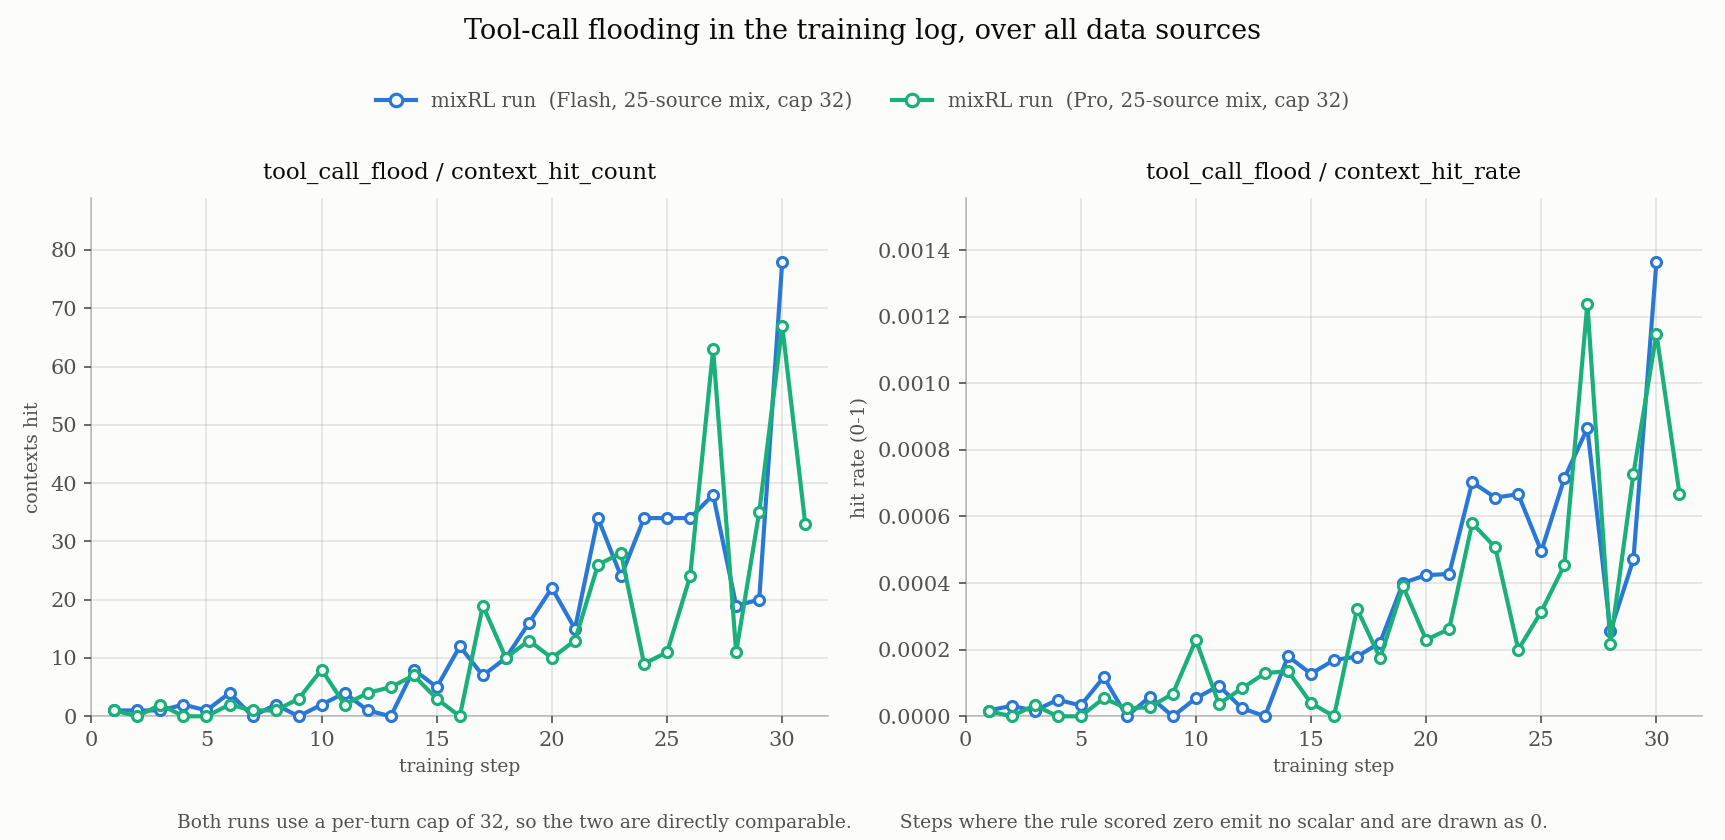
图中是小米公开的训练日志。真正值得警惕的不是某一次跑到了 33 次,而是从第 8 次、第 10 次开始,调用是否已经持续没有新信息。
他们也试过把阈值从 32 次收紧到 8 次。结果并不意外,洪泛下来了,整体 reward 也没有明显掉。但要从旧 checkpoint 继续训练约 20 步,估算成本约 231 万美元,而且在内部全量测试里,复读率只是从 13.45% 降到 3.83%。能治,贵,还没治透。
后面的做法有点子牛逼。他们拿已经出现复读的样本,单独训练了一个复读特化的 RL teacher。它只学一件事,什么时候该停止工具调用。12 步、约 7000 条训练样本后,这个 teacher 在样本内外的回放里把复读率降到 0。再用 MOPD,把这项专长合并回主模型。
MOPD 可以把它理解成给主模型请了一位偏科但很会刹车的教练。主模型继续保留原来的通用能力,教练只在最容易上头的那段提醒它,够了,先看结果。小米公布的总训练成本约 9 万美元,只是重跑 MixRL 方案的 4%,并称基准表现持平。
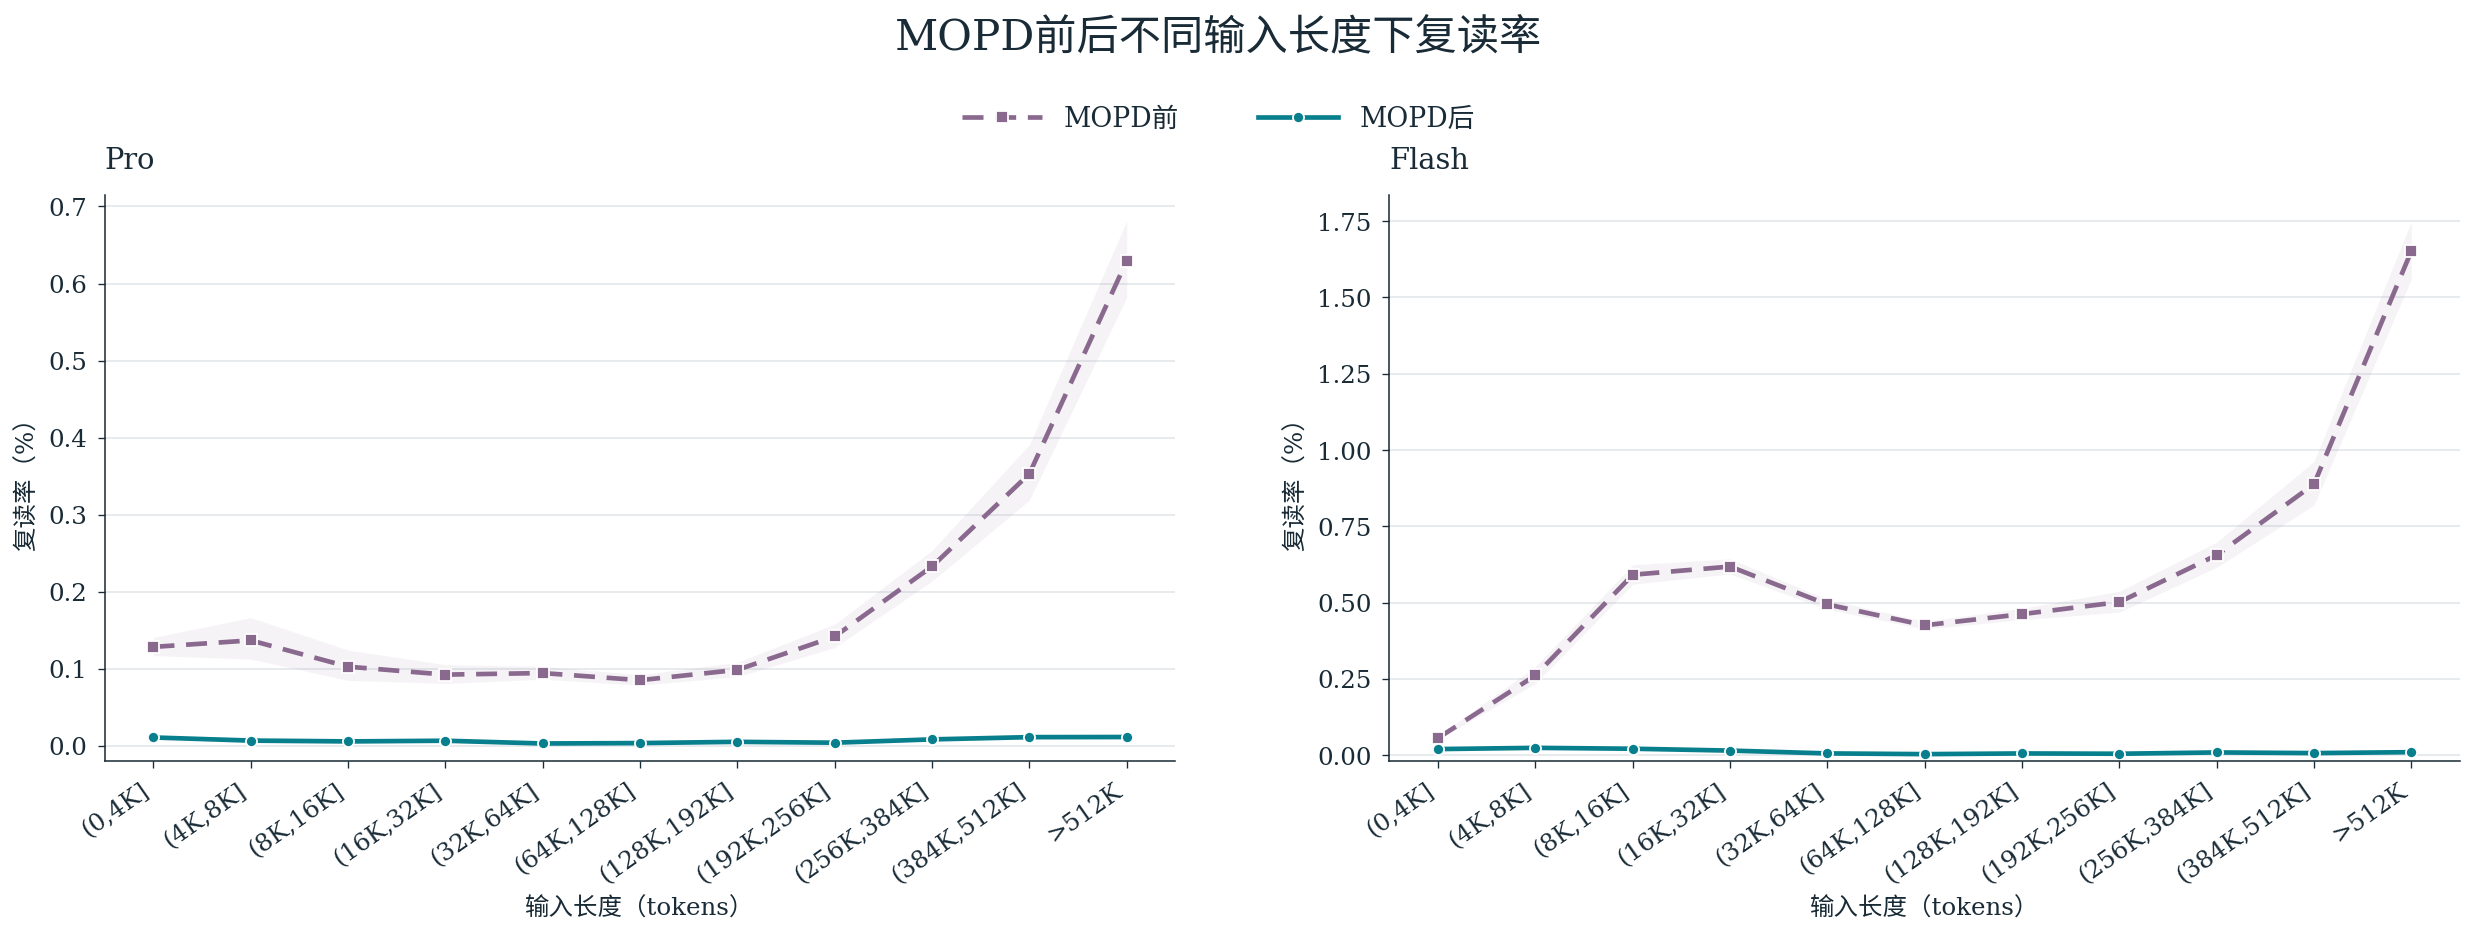
这当然还是厂商自己的结果,不是独立测评。不同 Agent 的工具设计、超时策略和上下文裁剪方式都不一样,不能把一张热力图当作所有环境的保证书。但它给运行 Agent 的人提了一个很实在的问题。
你的日志里,什么才算无效动作?
我会先盯四个信号。相同工具和归一化参数在同一回合重现。最近几轮的调用没有产生新文件、新搜索结果或新的报错。调用总数突然高于这个任务平时的分位数。还有,工具已经返回失败,模型却不改参数也不换路径,原地再来一次。
前两个信号可以直接进日志聚合。第三个适合做看门狗阈值,但别照搬别人的 8 次或 32 次,读代码和批量检索的合理并行数根本不同。第四个最适合接状态机,第一次失败允许带退避的重试,第二次必须改变参数或理由,第三次就要求模型总结已有信息,再决定继续还是交还给人。
这套规则的目标不是把 Agent 管成只敢调一次工具的乖宝宝。能并行时并行,该重试时重试。只是在每一批调用之后问一句,刚刚得到的新信息,究竟改变了什么。
如果答案是没有,继续烧 token 不叫自动化,叫把云账单拿去打水漂。
小米已经把修复后的 MOPD checkpoint 放进 MiMo-V2.6 collection。对大多数开发者来说,眼下未必需要研究他们的训练细节。更值得马上拿走的,是把工具调用的成功标准从调用完成,换成环境状态真的向前走了一步。
你现在给 Agent 的运行日志里,有没有能识别这种空转的规则?没有的话,最先补哪一个?