
Claude 缓存读取砍半,Agent 账单该从哪一行重算
Sonnet 5.5 的缓存读取单价从每百万 token 0.20 美元降到 0.10 美元。把折扣落到总账前,先分清缓存读取、缓存写入、未缓存输入和输出各占多少。
同一段 20 万 token 的上下文,Claude Sonnet 5.5 以前从缓存读一遍是 0.04 美元,现在是 0.02 美元。
这个数字很容易让人脑内自动补全成一句更好听的话,Agent 终于便宜一半了。
先别替财务把海报贴出去。Anthropic 在 10 月 7 日下调的,是 Sonnet 5.5 的提示词缓存读取价,从每百万 token 0.20 美元降到 0.10 美元。缓存写入、未缓存输入和输出价格都没动。官方 release notes 写得很克制,真正容易被省略的恰好是后半句。
如果你在跑代码助手、客服编排或者多轮工作流,这次调整当然值得处理。但处理方式不是把预算表里的 Claude 一列打五折,而是把一笔请求拆开看。很多 Agent 的账单里,缓存读取只是其中一格,有时还是最小的一格。
那张「砍半」的价格表,到底砍了哪儿
Sonnet 5.5 目前的官方单价里,基础输入是每百万 token 2 美元,输出是 10 美元。5 分钟缓存写入是 2.50 美元,1 小时缓存写入是 4 美元,缓存读取现在是 0.10 美元。提示词缓存文档 也明确写了,命中缓存和刷新缓存都按读取价算。
所以一轮调用至少有四种钱在流动。
未缓存输入,是模型第一次见到的系统提示、用户材料和新工具定义。
缓存写入,是把一段稳定前缀留在缓存里,等后续调用复用。它并不便宜,5 分钟写入甚至比基础输入贵。
缓存读取,才是这次从 0.20 美元降到 0.10 美元的那一项。
输出 token 则还是每百万 10 美元。一个 Agent 如果总在长篇解释、反复改写文件,输出那一列照样能把折扣吃掉。
这也是为什么看模型主页上的单价,经常和月底账单对不上。模型价格只是单价表,Agent 成本是一次次请求拼出来的流水。
先用 usage 字段,把总账拆成四块
不需要先改架构。先从调用日志或用量导出里找四个字段,input_tokens、cache_creation_input_tokens、cache_read_input_tokens 和 output_tokens。字段名随 SDK 或报表略有不同,但它们对应的账目不会变。
下面这个式子可以直接贴进笔记本或成本看板。金额单位是美元,token 数按同一段时间累加。
旧缓存读取成本 = cache_read_input_tokens / 1_000_000 × 0.20
新缓存读取成本 = cache_read_input_tokens / 1_000_000 × 0.10
本次可省金额 = cache_read_input_tokens / 1_000_000 × 0.10

新总成本 = 未缓存输入 + 缓存写入 + 新缓存读取 + 输出
这个式子不花哨,但能拦住最常见的误判。
假设某个工作流一天有 2,000 万未缓存输入 token、8,000 万缓存读取 token、500 万 5 分钟缓存写入 token,以及 800 万输出 token。按现在的价目表,新旧差额只是缓存读取的 8 美元。旧总账约 148.5 美元,新总账约 140.5 美元,整体下降大约 5.4%。
读取单价确实减半了,总账却没有。不是折扣缩水,是其他三格没跟着变。
反过来,如果你的代码 Agent 每轮都带着一大段稳定仓库规则、工具说明和历史摘要,绝大多数输入都命中缓存,输出又很短,这 0.10 美元会变得很实在。两类系统不能共用一句「便宜一半」的结论。
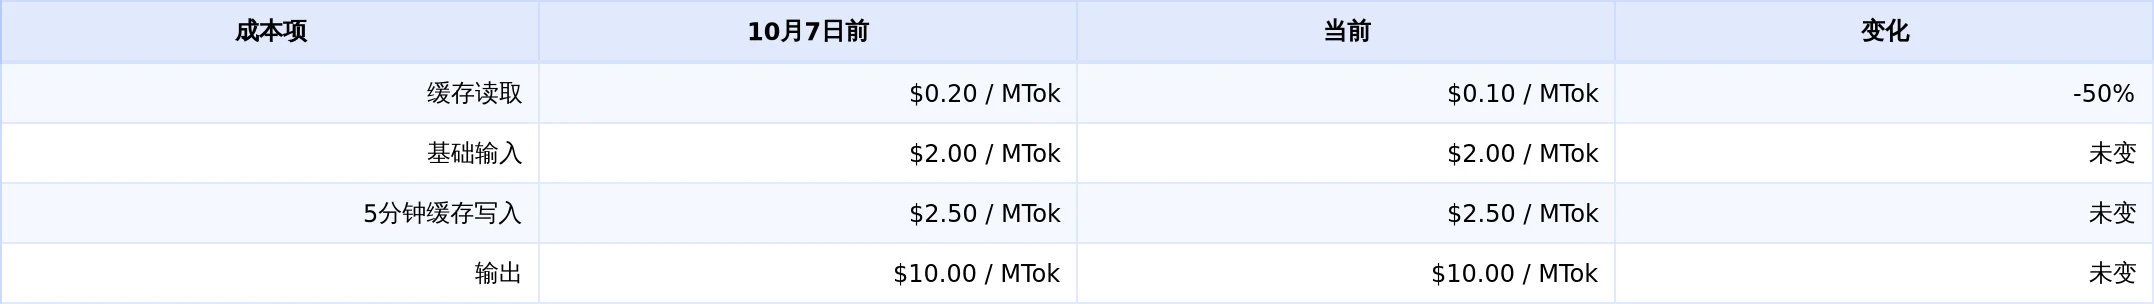
官方价目表中,只有缓存读取这一行变成了每百万 token 0.10 美元。
值得重算的,不是所有缓存策略
第一类值得立刻看的是长会话和重复上下文很多的产品。代码审查 Agent、带公司知识库的问答、固定工具箱的多轮任务,都很可能有一条很长而且稳定的前缀。缓存读取占得越多,新的单价越接近真实收益。
第二类是为了省钱而频繁做上下文裁剪的系统。有些团队把稳定规则切得很碎,或者过早压缩历史,只为了不让输入变长。现在读取更便宜后,可以重新比较一次,保留更多稳定上下文会不会比反复摘要更划算。这里只能说值得比较,不能默认保留越多越好,长上下文也会带来定位困难、旧指令干扰和调试成本。
第三类是有缓存命中异常的系统。Anthropic 已把 cache diagnostics 放到正式接口里。比起猜某个 prefix 有没有复用,直接看诊断和 usage 记录更省事。动态日期、每轮变化的工具定义、插在稳定前缀之前的临时指令,都可能让一段本来能复用的上下文重新写入。
这次降价给了你一个更好的理由去修命中率,但它不会替你修命中率。
有两件事,别因为 0.10 美元反手做错
第一件是盲目拉长缓存时间。1 小时缓存写入每百万 token 是 4 美元,5 分钟写入是 2.50 美元。请求间隔短、复用次数多时,长一点可能合理。流量稀疏时,先为 1 小时多付的写入费,可能等不到足够多的读取来回本。缓存时长不是越长越省,而是要和真实调用节奏配对。
第二件是把缓存读取和模型效果混成一个决策。Sonnet 5.5 的价格变了,任务成功率、工具调用稳定性、重试次数和人工返工没有自动变。一个看起来便宜的路由,如果多跑两轮、多写一大段解释,省下的读取钱会很快被输出和重试吞掉。
价格表能回答「每个 token 怎么收费」,不能回答「这条链路交付一次任务要花多少」。后一个问题仍要拿真实任务集、失败日志和完成时长来算。
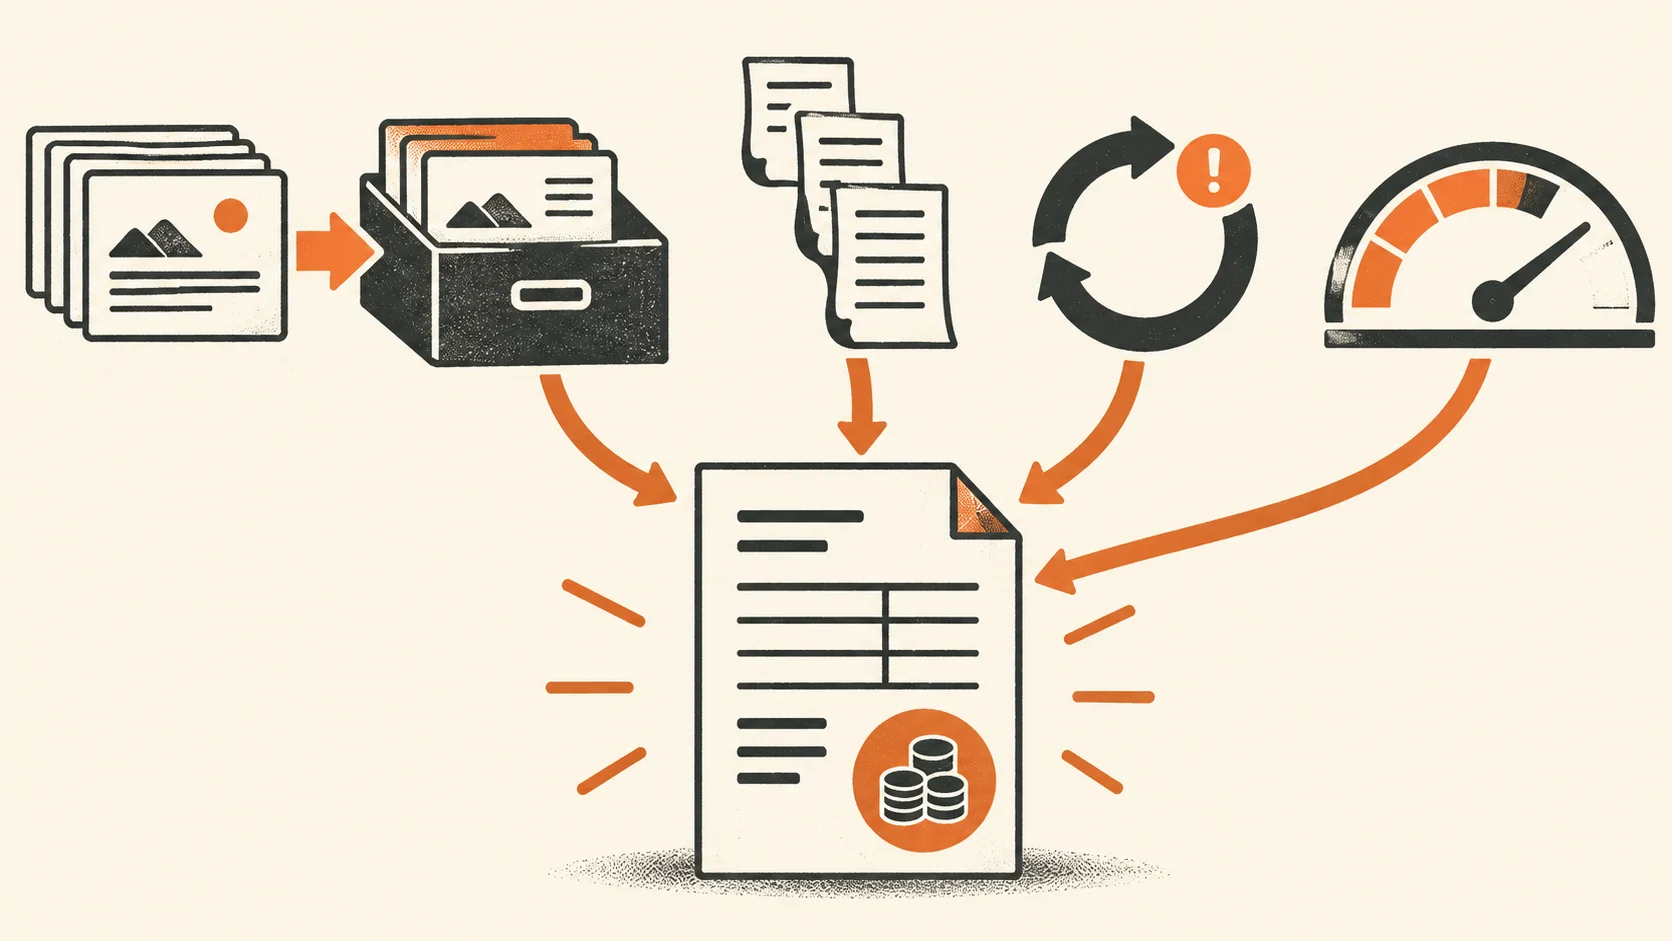
缓存单价只是一个输入,总成本还取决于命中率、输出长度和重试次数。
一次小更新,顺手把账本补齐
我会把这次变更当成一次成本观测的提醒,而不是一次架构迁移通知。
先拉最近 7 天同一条工作流的四类 token 占比,再用新旧读取价各算一遍。接着挑缓存读取占比最高的两个任务,检查稳定前缀有没有被动态内容打断。再把输出 token 和重试次数并排放进看板,别让某一格的折扣把整张账单骗过去。
真正值得保留的结论很简单。缓存读取砍半是好消息,但只有缓存读取足够多时,它才会变成你的好消息。
你现在的 Agent 账单里,缓存读取大概占多少?如果还没拆过,最想先看哪一条工作流?