posts/claude-code-task-state-boundary.md
Claude Code 删掉任务工具,我觉得只对了一半
Claude Code 2.1.233 做了件挺狠的事。
它把 TaskCreate、TaskGet、TaskUpdate、TaskList 和 TodoWrite 从一批新模型的默认工具箱里撤了。Opus 4.8、Sonnet 5、Fable 5、Mythos 5,以及后续同家族模型,都在名单上。
一口气五个。
你要是想把它们请回来,也不难。设置 CLAUDE_CODE_ENABLE_TODO_TOOLS=1,工具还在。可官方在2.1.233 更新日志里只说了怎么恢复,没解释为什么撤,也没宣布谁来接班。
好家伙,Agent 天天被要求先计划再执行,做任务清单的工具却被默认收走了。
社区立刻分成两拨。一拨觉得这会伤到长任务和编排,模型干到哪儿、卡在哪儿、还有什么没做,突然少了一块可见面板。另一拨觉得删得好,新模型脑子够用了,别再为了勾一个框反复调用工具、更新状态、消耗上下文。
我自己的判断有点拧巴。
对短任务,删得挺对。对真正要跨会话、跨 Agent、失败后接着跑的工作,只删工具却不把状态边界讲清楚,事情就只做了一半。
任务清单里其实混着两种东西
很多朋友看到 todo,会把它当成一个东西。列计划,做一项,勾一项,不就完了。
放进 Agent 系统里,它至少有两张完全不同的脸。
第一张脸是模型的工作记忆。模型刚读完需求,临时把任务拆成改接口、补测试、跑构建、更新文档。这个计划服务于眼前这轮推理,写得粗一点没事,中途改了也正常,任务结束后丢掉都不可惜。
第二张脸是系统的执行状态。它得回答更麻烦的问题。这个任务是谁领走的,代码改到哪个提交,测试为什么失败,重试了几次,下一位 worker 从哪里接手,人类中途点了暂停以后还能不能恢复。
前者可以住在模型脑子里。
后者不行。
我那条定时运行的自动化流水线就是个很朴素的例子。模型会自己决定怎么完成一篇稿,但进程锁、阶段标记、失败结果和最终账本都放在会话外面。哪怕模型进程被杀,下次启动也能从磁盘判断上一次到底走到哪儿。要是这些信息只存在模型维护的一张 todo 里,进程一退,现场跟着一起蒸发,棒棒的,自动化又变回了人工考古。
这正是任务工具最容易制造的错觉。
面板上有几个格子,不等于系统拥有可靠状态。模型说测试完成,也不等于测试命令退出码为零。它把某项更新成 done,只能说明模型发出过一次状态更新,不能替代 CI、数据库事务或可核验产物。
任务清单是视图,不该天然成为事实源。
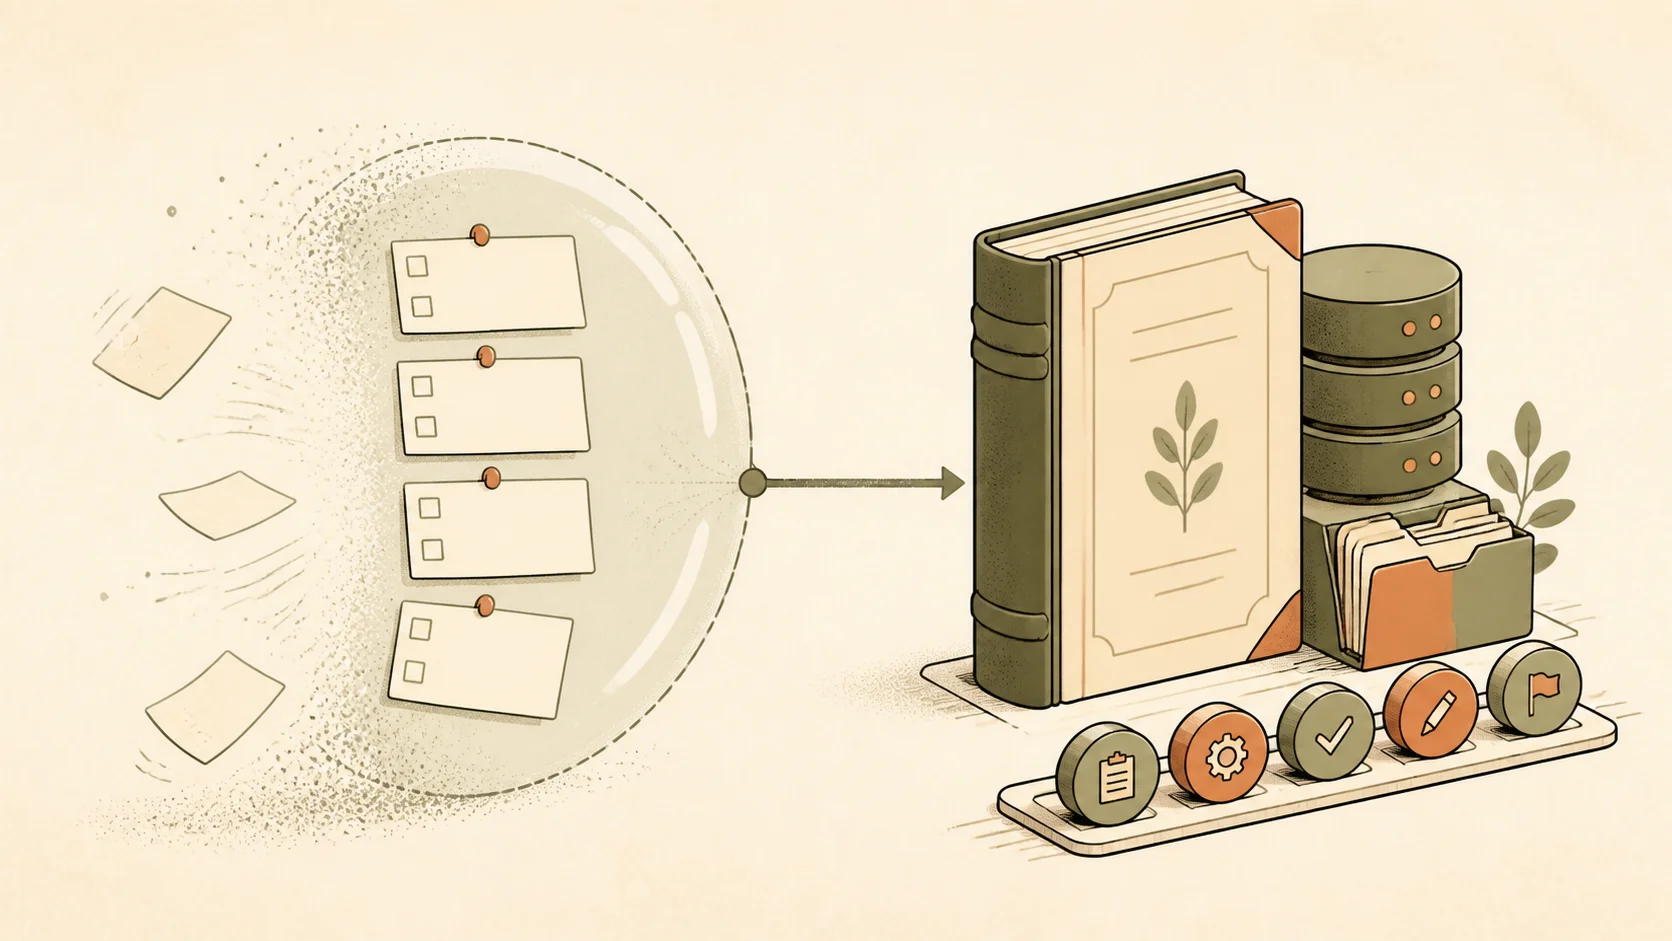
会话里的计划会消散,外部账本负责留下真正发生过的事
从 TodoWrite 到 Task 工具,官方其实已经走过一遍
Claude 的任务工具不是一直长这样。
官方的 Todo Lists 文档写得很具体。旧 TodoWrite 每次调用都重写完整 todos 数组。后来换成结构化 Task 工具,新增任务用 TaskCreate,修改状态用 TaskUpdate,查询全量状态用 TaskList,查单项用 TaskGet。
这个变化看起来只是 API 从一把大锤拆成几把小扳手,工程含义却挺实在。
整张表重写时,后一次写入很容易覆盖前面的变化。拆成按 taskId 局部更新以后,宿主程序能更清楚地观察发生了什么,也更容易把进度渲染到界面上。TaskCreate 生成的 ID 还会通过工具结果返回,应用可以维护一份以 ID 为键的映射。
这套设计明显在往系统状态靠近。
但它仍然有个尴尬边界。工具调用由模型发起,模型可能忘了更新,也可能用错字段。官方文档甚至提醒开发者,流里可能出现 id、task_id 或 taskId,Claude Code 会在执行前做修复,但监控代码仍要防御性读取。
看到这里我没忍住笑了一下。
我们一边把任务状态做成结构化工具,一边又得给模型拼错字段准备兼容层。很真实,完全是生产系统的味道。
所以 2.1.233 把这些工具从新模型默认上下文里拿走,并不等于 Anthropic 突然反对计划。Agent SDK 的文档仍然保留了开回任务工具的 TypeScript 和 Python 示例。更准确的说法是,Anthropic 不再认为每个新模型、每个会话都值得默认背着这套工具。
至于原因,官方没说。
社区有人猜是 token 与 Prompt Cache 成本,有人说新模型已经能靠内部 Scratchpad 维持计划。猜测可以讨论,但别替厂商补发布说明。唯一能确认的是,默认工具集合变了,而且变化已经影响到依赖这些工具的工作流。
删掉以后,受伤最重的不是普通聊天
你让 Claude Code 改一个函数、补一条测试、解释一段报错,少一张 todo,大概率没什么。
任务短,状态天然藏在代码 diff、终端输出和当前上下文里。模型先改文件,再跑测试,失败就修。专门创建五个任务、更新八次状态,有时真像请了一位项目经理来监督自己拧螺丝,会议纪要比螺丝还长。
短任务删掉,挺清爽。
问题出在长任务。
一个跨二十个文件的迁移,可能先改 schema,再写兼容层,再迁数据,再切流量,然后删旧代码。中途任何一步失败,都不能靠一句「我记得刚才做到第三步」恢复。上下文一压缩,模型的记忆会被摘要。会话一重启,Scratchpad 未必还在。另一个 Agent 接手,更不知道前一位到底做过什么。
一个 7 月公开 issue已经展示过这种漂移。用户在 Claude Code 2.1.216 与 Fable 5 的某些会话里发现 TaskCreate 和 TodoWrite 都不可用,恢复同一会话后依然缺失。到了 2.1.233,这种缺失不再只是莫名其妙的灰度现象,而是写进更新日志的默认行为。
还有多 Agent 编排。
两个 Agent 同时看见 pending,各自都觉得这活归自己。一个把状态改成 done,另一个还在跑旧版本。第三个 Agent 发现失败后重试,却不知道前一个 worker 的 lease 有没有过期。只靠模型主动维护任务列表,迟早会撞上重复领取、状态覆盖和幽灵任务。
这不是模型聪不聪明的问题。
数据库也不会因为客户端变聪明,就把事务和锁删了。
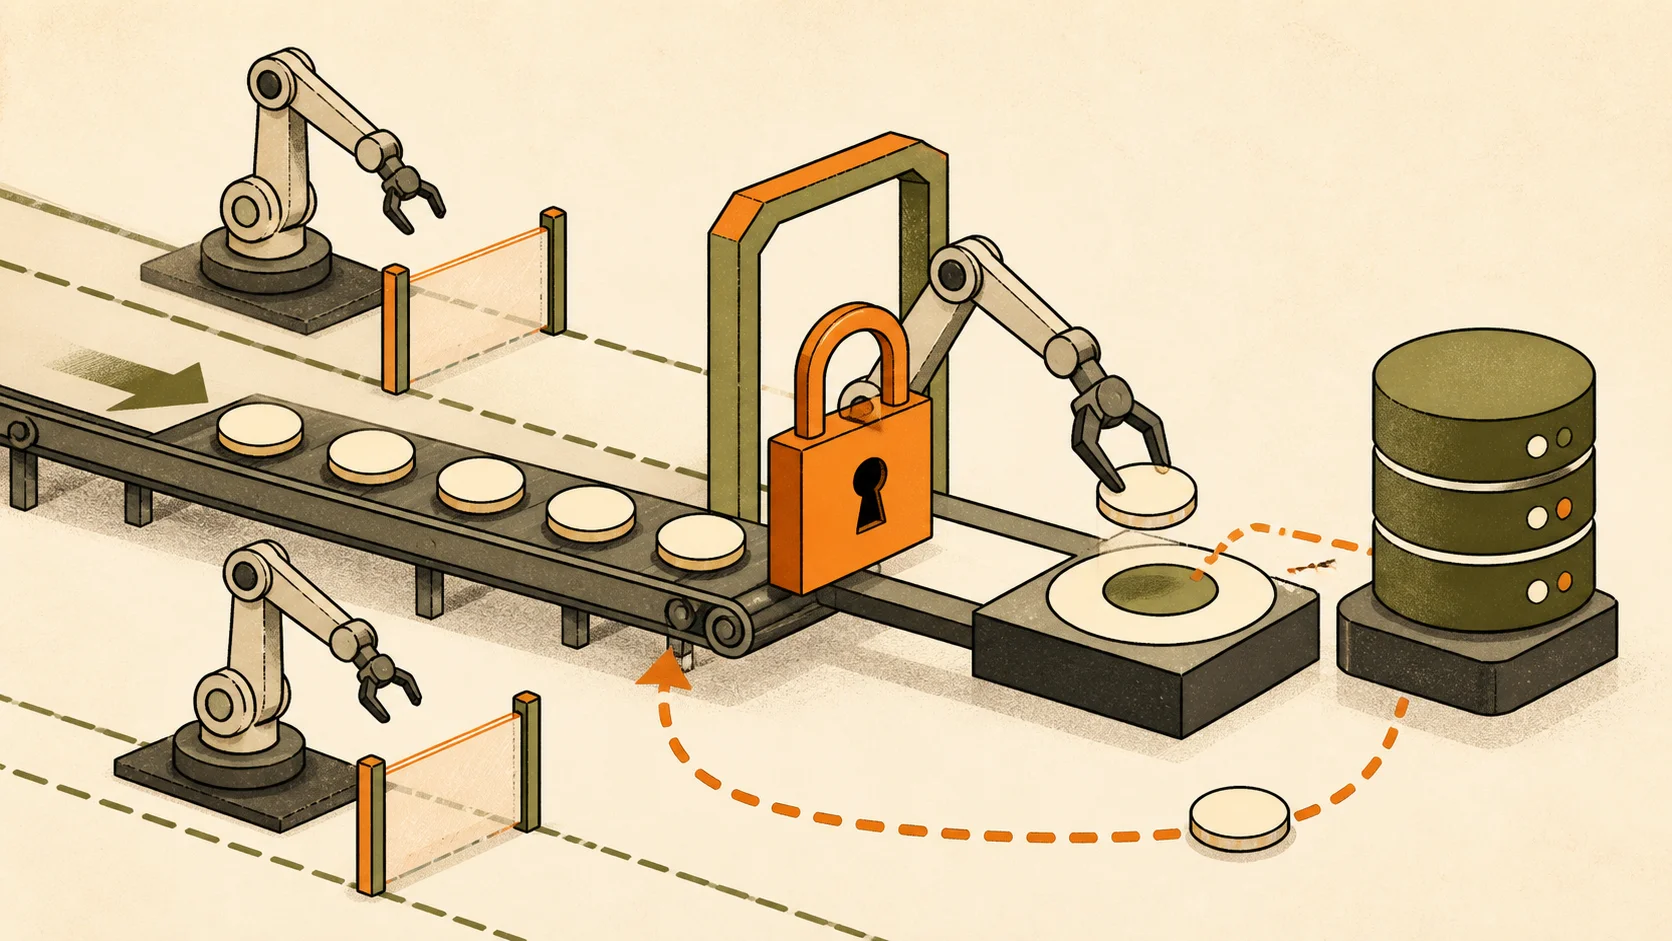
让队列、锁和 lease 决定谁能领取任务,别让 Agent 靠礼貌抢活
真正该搬走的是状态,不是计划
社区里有个挺接地气的做法。有人把工作分成 Projectplan.md、Backlog.md 和归档文件,当前几轮只读热路径里的计划,远期任务与历史记录放在冷路径。这个方案出现在相关讨论里,不是什么神奇框架,就是三个文件。
我觉得这个思路比争论 todo 要不要删更有价值。
它把计划从某一次会话搬进了仓库。人能看,模型能读,Git 能留历史,换模型也不怕。更重要的是,计划与代码处在同一份版本上下文里,不会出现代码已经回滚,todo 还显示完成的荒诞场面。
当然,Markdown 也不是万能药。
单 Agent、单仓库、更新频率不高时,文件够用。多 Agent 并发领取任务时,就该上有原子状态迁移的数据库或队列。至少要有 pending、running、blocked、done、failed,领取时带 lease 或幂等键,避免同一任务被重复执行。任务真的完成以后,再用测试结果、构建产物或部署状态做验收。
这里可以借用 Temporal 对 durable execution 的解释。工作流执行的价值,不是模型永远不出错,而是进程挂掉、网络抖动、worker 重启后,系统还能根据已经持久化的事件继续往下走。
模型负责决定下一步做什么。
系统负责记住上一步真的发生了什么。
这两个职责一分开,很多争论会突然变简单。
哪些情况该把工具开回来
那 CLAUDE_CODE_ENABLE_TODO_TOOLS=1 到底要不要设?
我不太赞成看见更新就全局塞进 shell profile。默认值变了,先看自己的工作流是不是依赖它。
如果你只是用 Claude Code 做半小时内能收尾的修改,任务工具消失后没有明显损失,那就让它消失。少几个工具 schema,少几次状态调用,界面也安静一点。
如果你在 Agent SDK 里监听 TaskCreate 和 TaskUpdate 来渲染进度,或者自动化明确依赖任务 ID 做下游动作,那就应该显式开回,并把这个环境变量写进项目配置与测试。别靠某台开发机恰好开着,生产 worker 却没开,太离谱了。
如果你跑的是跨会话长任务,开回工具只能解决可见性,不能解决耐久状态。任务列表可以当 UI,可以当模型的短期备忘录,但最终状态仍要写进仓库、数据库、队列或工作流引擎。把恢复逻辑测一遍,主动杀掉进程,确认下一次真的能接着跑。
如果你在做多 Agent,任务领取必须由宿主系统仲裁。不要让几个模型靠聊天礼貌决定谁先干。它们可以讨论分工,真正的 claim、lease、retry 和 done 要由外部状态机说了算。
另一个社区线程里,有用户因为升级后编排受影响,直接回退 2.1.232 并关闭自动更新。临时止血没问题,但长期更该补一条兼容性测试,启动时探测必需工具是否存在,缺失就快速失败。否则下一次不是任务工具变动,也会是模型名、权限模式或插件接口变动,照样在半夜把流水线掀翻。
我为什么说只对了一半
我赞成 Claude Code 不再默认塞一套所有任务都未必需要的追踪工具。
模型越来越强以后,Harness,也就是让模型真正干活的那层脚手架,确实该删掉一部分历史包袱。一个五分钟的改动,不需要先开项目会。能直接做完、跑完、验收完,就别让模型为了仪式感维护计划。
但我不赞成把工具消失理解成「新模型不需要任务状态」。
恰恰相反,模型能承担的任务越长,外部状态越重要。它跑五分钟时,失败可以重来。它跑五小时、跨三个 worker、改四个服务时,重来本身就是事故。
有点子牛逼的模型,配上一套只活在会话里的状态,仍然是一艘没有航海日志的快船。跑得很快,风浪一来,没人知道它刚才在哪儿。
所以这次更新真正值得抄的,不是那个环境变量。
而是重新画一条线。
计划可以交给模型,状态不能只交给模型。