
Codex 额度翻倍了,团队该把多出来的并发留给哪三类活?
OpenAI 上调了 Work 与 Codex 的订阅用量,也取消了 Pro 200 的下调计划。真正该重排的不是任务数量,而是哪些任务值得并行、哪些仍必须守住验收和权限。
如果你每天都给 Codex 派活,最近这条更新很容易让人产生一个朴素冲动:额度多了,那就多开几个任务。
10 月 29 日,OpenAI 在 ChatGPT Business release notes 里更新了 Work 与 Codex 的订阅用量:Pro 100、Pro 500 的额度变为此前两倍;此前计划下调的 Pro 200 额度取消,已经处于较高额度的用户保留原额度,较低额度用户的 Work 与 Codex 用量翻倍回到同一水位。更新也覆盖了 Business Premium。
这当然是好消息。只是「额度翻倍」不是一颗把交付能力翻倍的按钮。它更像给原来拥堵的任务入口多开了几条车道:如果车上装的是能独立检查的小包裹,吞吐会变好;如果车上装的是同一个生产环境、同一份密钥、同一个没人验收的改动,堵车只会换个地方发生。
这一篇不讨论哪个套餐最值,也不替你算一次任务究竟烧掉多少额度。官方更新没有给出通用的任务消耗换算,模型、上下文、工具和任务复杂度都会改变实际用量。值得立刻调整的,是你给 Agent 分配工作的方式。
先把「可排队」和「可交付」分开
以前额度紧,很多团队自然会把 Agent 当成一个坐在旁边的同事:先问一个问题,等它回来,再决定下一步。这样慢,但有一个隐形好处——人会被迫盯着每个交接点。
额度宽一点之后,最常见的错误是把这个顺序反过来:先把十个任务塞进去,最后才想起它们是不是依赖同一份状态、会不会改到同一块代码、输出到底由谁验收。
真正稀缺的不是请求次数,而是可验证的结果。一个任务如果没有清楚的输入、允许动作、预期产物、检查方式和停止条件,它再便宜也只是把不确定性批量生产出来。
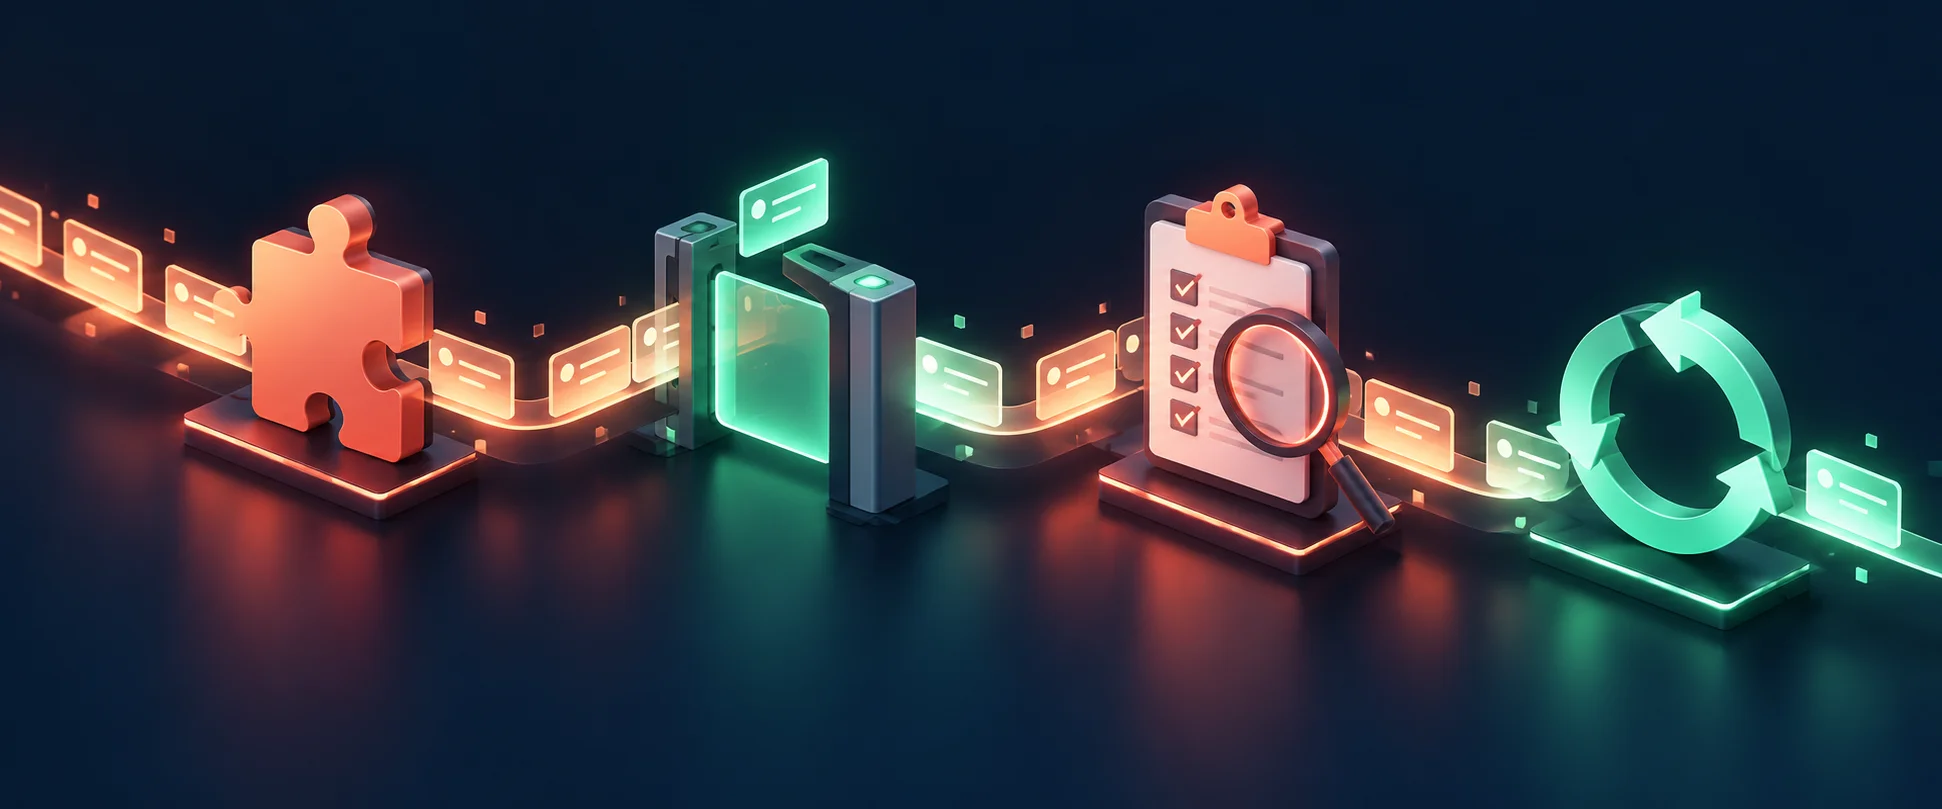
图:新增额度不是直接进入执行队列;先过独立性、权限、验收和回收四道关。
所以,开新并发之前先问一句:这项工作失败了,能不能在十分钟内由另一个人或另一个任务判定「没过」?不能,就不要因为余额变多把它放进自动队列。
第一类:把探索活并行,不把结论外包
最适合吃掉新增容量的,是资料收集、代码库勘探、替代方案盘点、测试失败归因这类探索任务。它们可以从同一问题出发,但各自交一份独立、可比较的材料。
比如准备重构一个老模块,可以并行让三个任务分别做:梳理调用链、列出历史故障和回归风险、找出已有测试没有覆盖的接口。它们都不应该改文件,也不该互相等待。最终由人或一个单独的汇总步骤对照原始证据,决定下一张工单怎么写。
这里的重点是「并行找证据」,不是「并行拍板」。让三个 Agent 都给架构方案,表面上很热闹,最后常常得到三种措辞不同、假设却相同的意见。把问题拆成信息来源不同的子问题,才是真的增加视野。
一个好用的拆法是让每个探索任务带上自己的反证要求:除了它支持的方案,还要写出会让这个方案失效的一个条件,并附上能检查的文件、日志或命令。这样并发出来的不是三份汇报,而是三组能淘汰错误判断的材料。
第二类:把隔离测试并行,别把生产变更并行
第二类值得扩容的,是有边界的测试工作:为一个 Bug 补最小复现、给迁移脚本生成 dry run、为 API 改动列出契约测试、把一段可疑逻辑跑在临时数据上。
这些任务有共同特征:环境可重建,输出能保存,失败不会把真实用户数据或线上状态推向不可逆的位置。它们很适合排队,也很适合在不同分支、不同临时目录或不同数据库快照里并行跑。
相反,额度变多以后最不该顺手放开的,是「顺便替我发版」「把这批客户数据修一下」「登录后台把表单填完」这一类任务。它们的难点从来不是模型能不能点到按钮,而是一次错误动作谁来撤销、异常输入会不会被识别、执行人到底有没有权限。
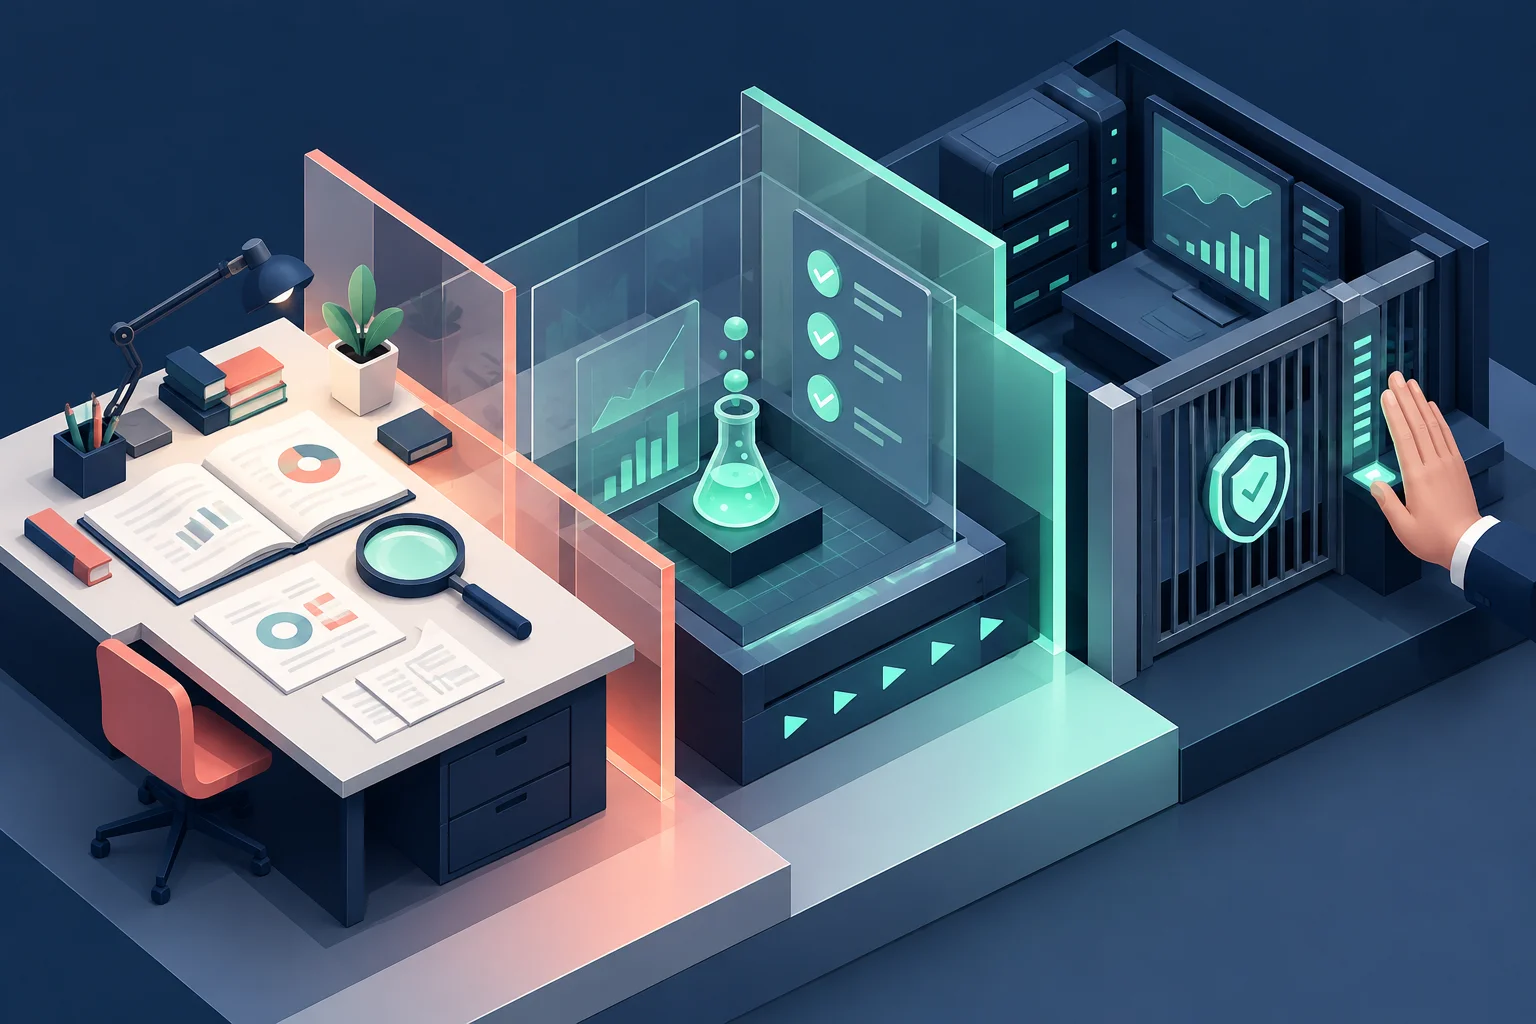
图:前两条车道可以扩容;涉及外部写入、敏感信息或不可逆状态的动作,仍要单独审批。
这里没有什么神秘方法。把「读」「提议」「生成候选」「运行隔离测试」和「写入」「发布」「付款」「删除」分成不同能力就够了。Agent 可以把后者准备到最后一步,但最后一步应该有明确的人类确认或另一套独立的规则检查。
第三类:把可复核的文档活并行,让知识留下来
第三类常被低估。很多团队把 Agent 额度都花在写代码上,却仍然让人手工追需求、对版本、补变更说明。实际上,接口变更摘要、测试说明、迁移清单、PR 审阅准备、故障时间线这些工作,往往更适合批量并行。
原因不是文档比较简单,而是它们通常天然拥有对照物:Issue、提交记录、测试结果、接口定义、监控事件。只要要求每个结论回链到这些材料,Agent 就是在整理证据;如果没有证据,它应该写「待确认」,而不是用流畅的句子把缺口抹平。
这类任务的产物也比一次聊天回复耐用。下周要追查某次改动为什么上线,能回看的迁移清单和失败项,会比「当时有个 Agent 说没问题」可靠得多。
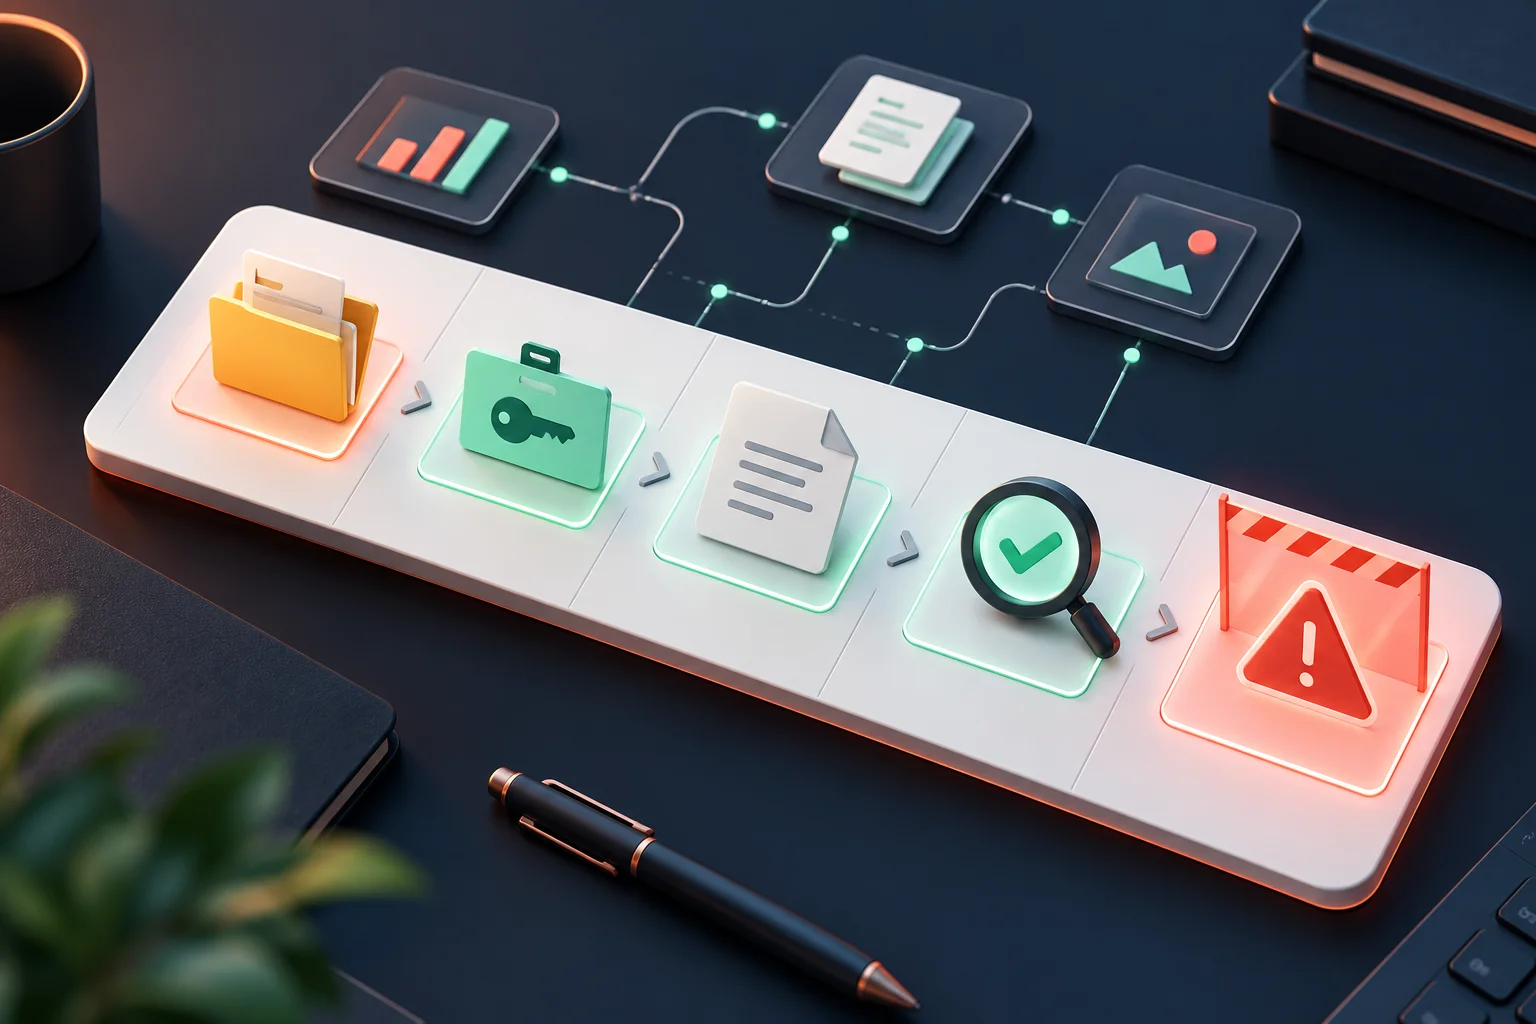
图:每张任务卡都要写清输入、允许动作、交付物、验证器和停止条件。
给每个并发任务一张很短的任务卡
额度放宽后,不必把流程变成厚重的项目管理。反而可以把规则压缩成五行,放进任务描述最前面:
输入:只读哪些仓库、文档、日志或测试数据
允许动作:检索/分析/创建临时文件/运行隔离测试
交付物:要返回什么文件、表格、补丁或证据链接
验证器:由什么测试、差异检查或人工复核判定通过
停止条件:遇到权限、敏感数据、外部写入或不确定信息时怎么办
这五行的作用不是约束模型说话,而是让协作对象知道任务何时完成。尤其是「停止条件」,不要只写一句“有问题就问我”。应该把会触发停止的事写成具体事件:需要访问未授权目录、要修改生产配置、无法复现报错、证据互相矛盾、准备向外部系统提交数据。
另一个容易漏掉的字段是验证器。没有验证器的任务,最容易被模型写成一段看起来完整的结论。验证器可以很朴素:单元测试通过、迁移 dry run 输出为空、截图与设计稿逐项对上、两个独立来源得出一致数字。关键是它存在于任务外部,不由同一个执行过程自己宣布成功。
多出来的并发,先留给「减少返工」
如果今天就要调整工作流,我会优先把新增容量留给两件事:一件是执行前的证据收集,另一件是执行后的独立验收。
前者让你少在错误假设上投入;后者让你不必把「任务已完成」误当成「结果可交付」。中间真正写代码、改配置或整理文档的那一步,反而通常不缺人手——缺的是有人能把它送进正确的队列,又能在出错时把它拦住。
OpenAI 这次更新改变的是可用容量,不是这些工程规律。额度多出来以后,最值得庆祝的不是后台数字变大,而是终于可以把原来总被砍掉的复核、回归和记录工作补回来。
你会先把多出来的 Codex 容量用在探索、隔离测试,还是验收?如果只能加一条任务卡规则,你最想先写哪一条?
小岛AI|记录一线实战、踩坑与成长