
设计 Agent 改完页面,先验收哪四件事?
Figma 把专用编辑模型的训练与评测摊开了。真正值得借走的不是某个分数,而是把 AI 改稿拆成请求、结构、画面和人工校准四道关。
让设计 Agent 改一版页面,最危险的情况往往不是它没动,而是它动完之后看起来挺像那么回事。
位置标签加上了,颜色也换了,截图往群里一发,大家点头。等工程接到文件才发现:它顺手改掉了原来的组件实例,移动端状态没跟着更新,或者把一个看不见的箭头裁掉了。画布是好看的,交付开始长刺。
Figma 刚公开了一篇关于专用画布编辑模型的技术文章。它没有只讲“模型会设计”,而是把训练和评测里的脏活都摆了出来:原生文件格式、合成编辑请求、确定性校验、视觉评委、设计师校准。对正在试 Figma Agent,或正把别的生成工具塞进设计流程的团队来说,最值得抄的不是模型名,而是这套验收顺序。
这篇文章给一个很具体的答案:AI 改完页面后,先验收请求、结构、画面,再由人校准判断。 顺序不要倒过来。
先看请求:它到底有没有做你让它做的那件事
Figma 用了一个很小的示例开场:在一张卡片左上角插入地点标签。听上去不算什么能力展示,甚至有点朴素。但这恰好是设计文件里最常见、也最容易被低估的活:改间距、换颜色、补一个状态、根据评论调布局。
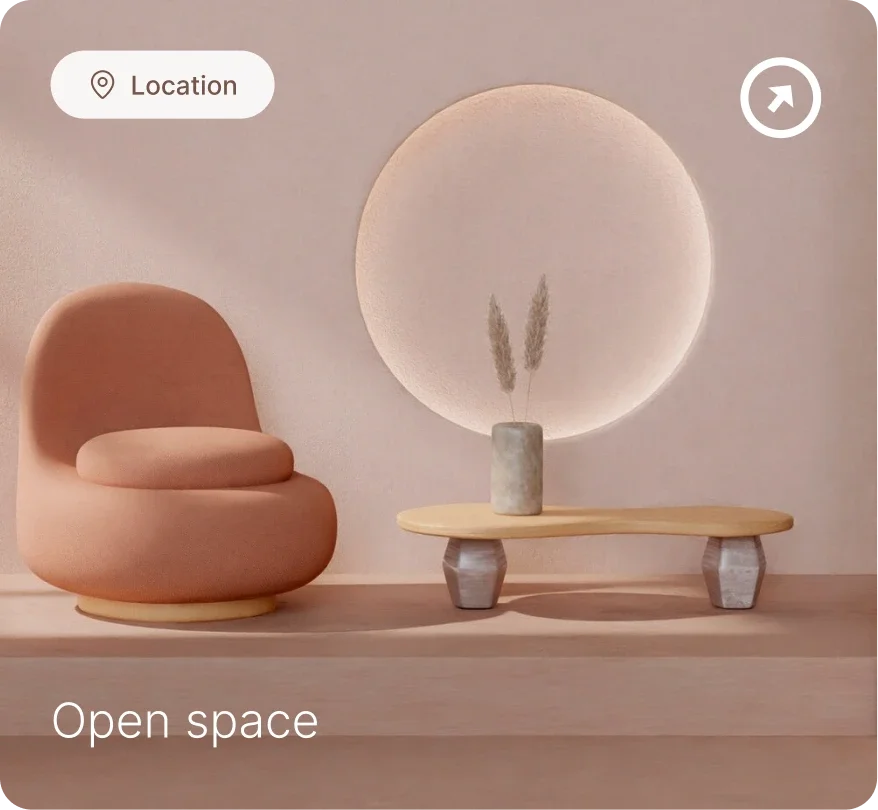
图注:Figma 官方的编辑结果示例。它把“标签出现”与“原有内容被保住”放在同一个验收条件里。
这里第一道关不是审美,是把一句模糊的“帮我改一下”改成能判定对错的请求。一次修改至少要说清三件事:改谁、改成什么、哪些地方不能碰。
比如“把优惠卡片做得更清爽”很难验收;“把优惠卡片的标题字号从 18 调到 20,保留现有组件、变量和移动端 Auto Layout,不改价格文案”就已经接近可交付的任务单了。前者只能靠人凭感觉争论,后者至少能检查。
这不是把设计师变成写规格的人。相反,是给设计判断留出位置。模糊需求当然可以用于探索;一旦要把改动带回团队文件,模糊就会把返工藏起来。AI 最擅长在你的话里补全空白,而设计系统里最怕的,正是它补得太热心。
再看结构:画面没坏,不代表文件没坏
很多团队第一次用设计 Agent 时,眼睛只盯着截图。截图通过了,文件却可能已经从“可维护的设计系统”变成“看起来没问题的一次性拼贴”。
Figma 的做法值得注意:它没有把训练对象只当成一张图,而是用 Figma 的原生文件格式表示设计。原因很直接。一个按钮看起来是对的,可能仍然用了错误的组件;一个间距看起来刚好,可能已经脱离了原来的变量和布局规则。屏幕上没有爆炸,不等于下一次改版不会爆。
所以第二道关该看结构,至少问四个问题:
- 该保留的组件实例、变体和变量还在吗?
- 改动有没有越过指定 Frame、页面或组件边界?
- 文本、图层和 Auto Layout 的关系还能继续编辑吗?
- Agent 有没有为了“看起来完成”复制出一套不受设计系统控制的元素?
这层最适合交给规则和脚本。文件是否能被正常解析、指定节点有没有被改、是否新建了不该有的元素、变量引用是否断开,这些都不是“美不美”的问题,却比“美不美”更容易被稳定地检查。
Figma 在训练数据生成阶段也走了类似路径:教师模型先尝试编辑,随后用确定性校验器和视觉模型评委筛选;失败的候选还能依据评估反馈修一轮。它早期用超过 25 万个样本训练过 Llama 3.3 70B,已经能在当时与顶级模型竞争。这里真正有意思的地方在于,数据并不是随便堆一堆“好看的页面”,而是把一次编辑能否重新落回文件当作训练目标的一部分。
如果你的团队还没有能力做复杂的文件级校验,也不用一上来造评测平台。先把“不可改区域”“必须保留的组件”“允许新建的范围”写进任务模板,已经能挡住一大批隐形损耗。
然后看画面:视觉评委可以抓错,不能替你定调
结构对了,画面仍然可能翻车。Figma 在官方材料里列了几个很典型的失败:图标压住文字、下拉箭头被裁切、两段文字互相撞车。每个问题都很小,小到单独截一张图时你甚至会想“也还行”。但把它们堆到真实产品里,体验会立刻像一件没熨平的衬衫。
这正是视觉检查该单独成为第三道关的原因。它要看的不是“AI 有没有生成一个漂亮的页面”,而是更具体的事:文字是否可读、对比是否足够、元素有没有重叠、点击目标是否被遮住、信息层级是否还在。
Figma 的内部编辑评测把这些维度分开处理,再把结构检查、视觉模型评委和设计师复核结合起来。官方图中,最新的 Figma edits 1026 中档配置在 445 个真实设计编辑样例上得到 77.8%,GPT 6.1 Sol 中档配置为 76.9%。这个差距本身不值得被神化:它是 Figma 自己的任务集、自己的评审口径,不是通用设计能力排行榜。
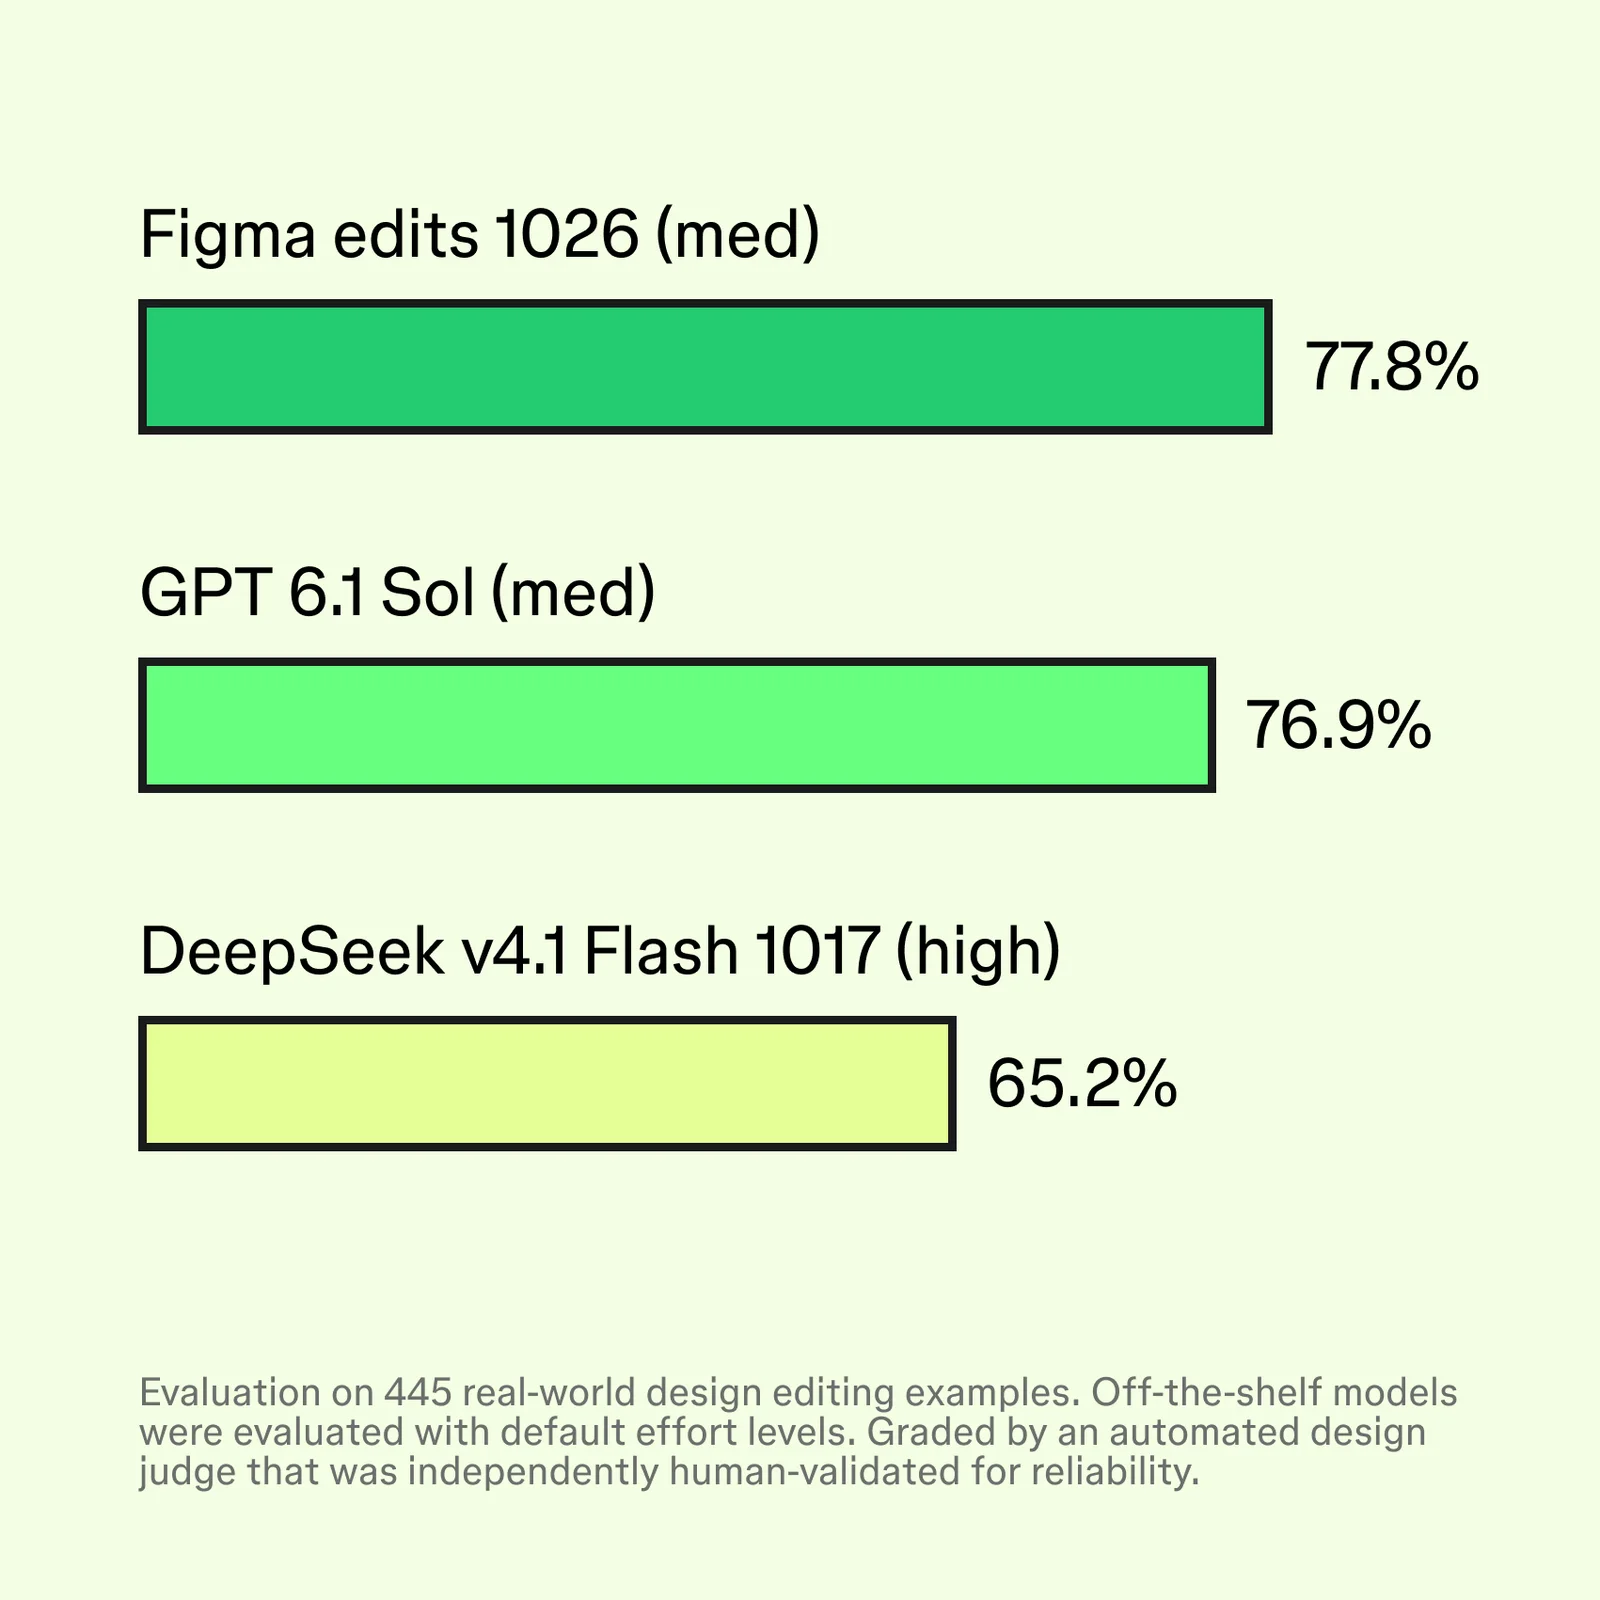
图注:Figma 官方内部评测图。分数只能说明这个任务集上的表现,不能直接替代你的品牌、产品和交付标准。
但评测方式很有启发。与其问“哪个模型最会设计”,不如问“它在哪一类错误上最常出问题”。只要能把错误聚成几类,团队就能把复核动作前置:价格模块重点看数字和裁切;表单重点看状态和可访问性;营销页重点看品牌、文案和层级;设计系统改动重点看组件与变量。
模型做第一轮肉眼筛查很合适。让它给出最终审美判断,尤其是面对品牌、信息优先级和陌生用户的理解路径时,还是太早了。视觉评委的价值是帮你把“这里不对劲”变成一个能复现的提示,不是替团队宣布“这版可以发”。
收口留给人:校准的不是像素,是取舍
Figma 的训练流程最后仍然回到设计师标注和校准。这个细节比“用了强化学习”更重要。
设计里有一类问题不能靠通用规则收口。两个方案都没重叠、没裁切、组件也都用对了,但其中一个把注意力放在错误的功能上;另一个符合规范,却让熟悉产品的用户觉得陌生。这不是检测器失灵,而是产品判断本来就带着上下文。
所以第四道关不是让设计师重新从头看一遍,而是让人只处理机器不该替你做的选择:
- 这次改动是否还服务于当前页面的目标?
- 它有没有破坏已有的品牌语气和信息优先级?
- 如果它看起来“更完整”,是不是因此抹掉了原本有意留下的空白、弱化或节奏?
- 这条规则值得沉淀进设计系统,还是只适合这一次?
这也是为什么“AI 让设计提速”不该被翻译成“设计师少看几眼”。Figma 披露,从 beta 到全面可用期间,典型任务速度约快 20%,专家设计师对头测试中,新 Agent 有 62% 的情况胜过或打平上一代生产 Agent;用户评分高 33%,撤销操作少 60%。这些都是官方内部数据,不能拿来替你的团队预估 ROI。不过它们确实说明一件事:当任务边界、模型、工具和评测一起变好,速度和返工可以同时改善。
少掉的不是判断,而是那些本来就不该靠人眼反复确认的机械回合。
一份能直接塞进团队试点的四层任务卡
如果你们准备把设计 Agent 放进真实项目,先别从“一次生成整页”开始。挑一个高频、范围窄、结果可回放的编辑任务,例如:给一组卡片补状态、把一页升级到新颜色变量、根据已确认的评审意见统一间距。
把任务卡写成这样:
任务:把「支付方式」卡片组改成紧凑布局。

请求:标题与说明之间的间距改为 8;三张卡片使用现有 compact 变体。
保留:价格文案、图标、组件实例、颜色变量、移动端 Auto Layout。
结构检查:不得新增脱离组件库的图层;不得改动其他 Frame。
画面检查:文字不重叠;图标不压文案;窄屏下仍完整可读。
人工校准:设计师确认信息优先级与品牌语气没有被改弱。
它不像一句神奇提示词。好消息是,真实团队不需要靠神奇提示词活着。
先让 AI 在这个小范围里反复修改,记录每次失败落在哪一层:没听懂请求、破坏了结构、画面出错,还是人不接受它的取舍。每次复核都留下任务、差异、截图和最终结论;下次出现相似问题,团队才不用再从“这张图好像有点怪”重新猜起。跑满十来次之后,再决定要不要扩大权限、接更多文件或把某些检查自动化。这样拿到的不是一张漂亮 demo,而是一条知道在哪里会翻船的流程。
Figma 这次最有价值的提醒,大概就在这里:专用模型当然重要,但它只是其中一块。真正让设计 Agent 能留在团队里的,是任务足够具体、文件上下文能被读懂、错误能被查出,以及设计师仍然握着最后那把尺子。
如果你们已经在用 AI 改设计稿,最常见的返工是落在请求、结构、画面还是人工判断这一层?
小岛 AI
记录一线实战、踩坑与成长