
让 Agent 自己接活,最难的不是多开 Worker
DeepSeek 的公开原型把接入事件、授权判断、独立执行和回传拆成一套控制面。它最值得借的不是多 Agent,而是让每次开工都说得清:谁提的、能做什么、何时该停。
GitHub、飞书、CI 都接上以后,一个常驻 Agent 最容易犯的错,不是没把活干完。
是太积极。
它看见 PR 里一句「这个地方要不要再看看」,顺手开一个会话;CI 红了,另一个会话开始改;群里有人贴了报错,又有人让它查日志。几小时后,机器上多了几条分支、几段看似合理的解释,以及一堆没人记得是谁批准过的动作。
这不是模型不够聪明。恰恰相反,模型越能自己接着往下做,**「它为什么有资格做这件事」**就越不能靠一句 prompt 糊过去。
DeepSeek Harness 团队 10 月 31 日公开了一个名为 dsh-superagent 的研究原型。仓库上线两天后已接近一万 Star,但 README 的第一句很克制:它只是参考原型,不是正式产品,更不是可以直接推到生产环境里的答案。
我反而觉得这份克制,才是它最值得看的地方。
它讨论的不是「怎么再多拉几个 Worker」,而是把常驻 Agent 最容易混在一起的四件事拆开:谁把消息送进来、谁判断该不该开工、谁在独立环境里执行、谁把结果送回原处。
图:官方仓库将其明确标注为研究原型,要求使用前审查和改造。
多个 Worker 解决不了「谁让你动的」
很多多 Agent 架构的第一反应,是先画一个调度器,再往下面挂几个执行器。画完很壮观:一个总控,三个 Worker,后面再补个监控器。真正跑起来以后,麻烦却总从入口冒出来。
同一条 GitHub 评论,到底是新的任务、已有任务的补充,还是只需要留档的噪声?一条 CI 失败通知,是让原来的执行器继续,还是另开任务?群里转发的内容,能不能让 Agent 修改仓库里的代码?
dsh-superagent 给的答案很朴素:别先问「派给谁」,先问「这件事是否被允许开始」。它把流转压成一条很明确的链:
Source → Trigger → Eval → Ticket(带 Mandate)→ Executor → ChannelSource 是 GitHub、飞书这类事件来源;Trigger 是一条不可变的事件记录。Trigger 进入 Eval 后,系统才判断它应当接受、停止、忽略,还是暂时无法处理。只有接受后,才会创建 Ticket,并给它挂上 Mandate。
Mandate 可以翻成人话:这张工单凭什么成立,以及它最多能做什么。 官方文档要求它记录策略版本、允许范围、触发人的来源身份和匹配到的规则。一个 Worker 不会因为「看起来相关」就自动拥有新的权限;需要扩大范围,就该创建新的 Ticket。
这不是多写一层对象来显得架构优雅。它是在给自动化补一张能追溯、能停止的授权单。
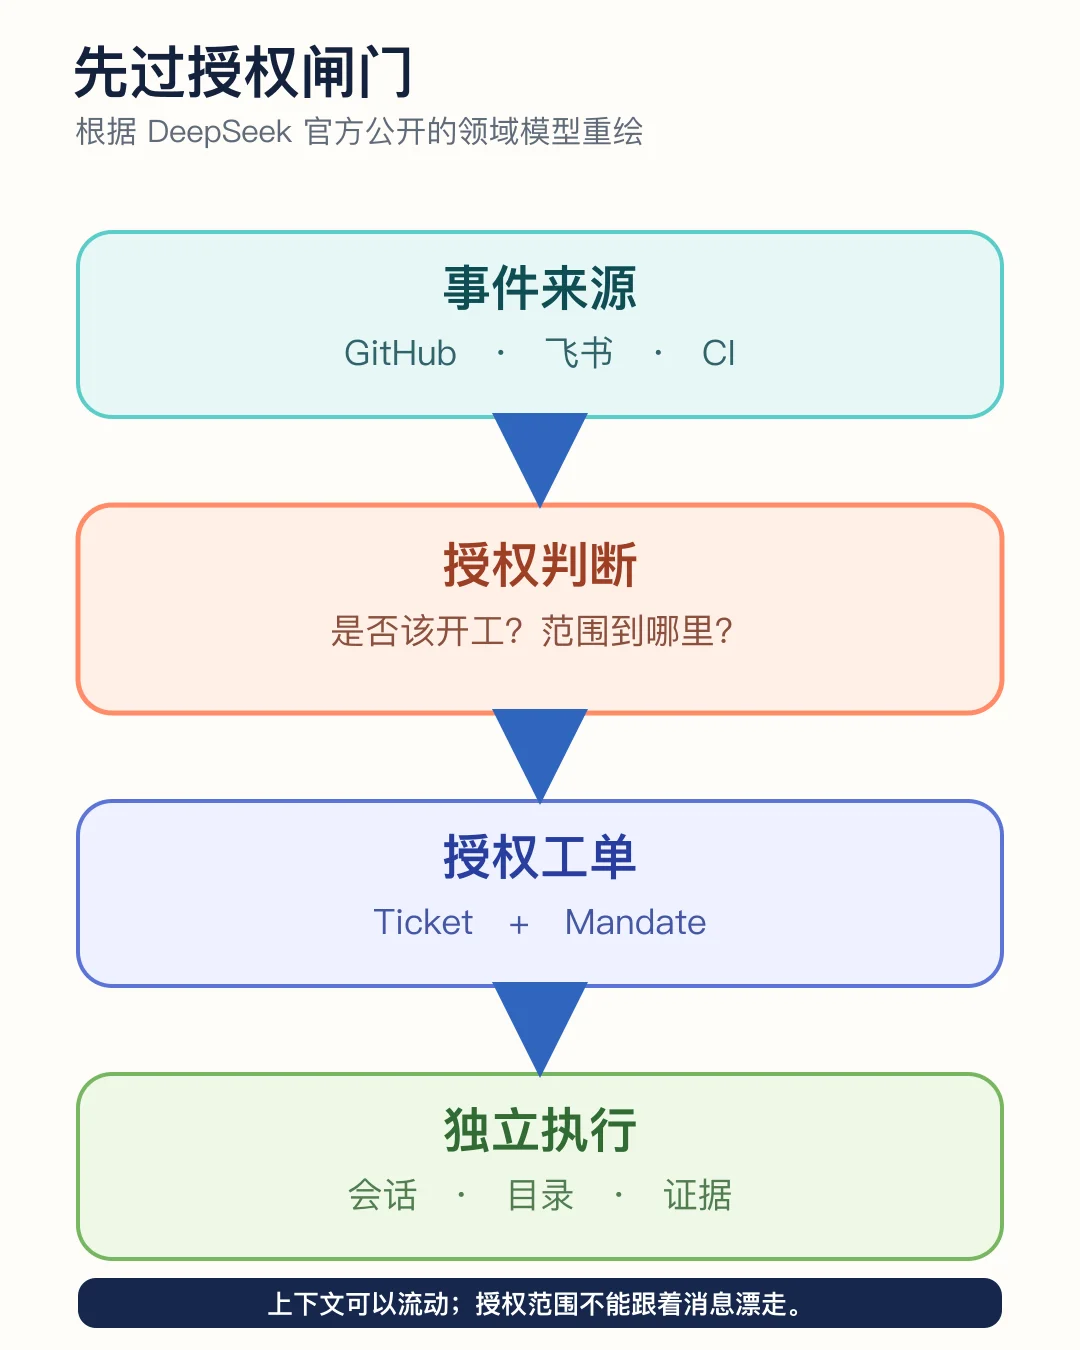
图:本文按官方领域模型重绘。事件可以带来上下文,但不能越过授权闸门。
如果团队只做一个改动,我会建议先做这一层。哪怕暂时只有一个执行器,也把每次运行的来源、范围、策略版本和停止条件写进不可变记录。否则你看到的只是「模型跑了什么」,看不到它为什么有权跑。
上下文可以流动,权限不能跟着漂
这里有个很容易被忽略的区分。
常驻 Agent 必须能跟进上下文:某个 PR 的后续评论、CI 的结果、关联 Issue 的讨论,都应该回到原任务里。要是每一条新消息都重新开一个任务,系统很快会把同一件事拆成互相不知道对方存在的几段工作。
但「收到上下文」和「得到新授权」不是一回事。
这个原型用 Subscription 让 Ticket 订阅相关 Thread。新事件可以扇出给已有 Ticket,供它判断下一步;可它不会因此扩大 Mandate。官方的授权文档还把这句话说得更硬:消息、评论和被引用的文档都只是决策输入,不能自己改变允许列表、规则或授权范围。
这条边界很适合拿来检查自家的 Agent:
- 有人把一段带操作指令的日志贴进群,Agent 会把它当数据,还是当管理员命令?
- 一个已经结束的修复任务收到新评论,系统能否只恢复原范围内的工作?
- 一条看起来相关、实际无关的 CI 通知,会不会把 Worker 从原任务拽走?
前两年我们常把 prompt injection 理解成「模型被一句奇怪的话带偏」。放到长期运行的系统里,它更像授权链路没画清:外部文字一旦能直接改执行环境、换工作对象或扩大写权限,问题就已经不只是提示词了。
DeepSeek 的设计没有把这件事交给 Worker 自觉。允许列表、规则和 Mandate 由宿主程序保存;执行器只处理自己 Ticket 内的输入。文本可以影响判断,却不能改权限本身。这个分层不花哨,但比给总控加一段「请谨慎执行」可靠得多。
真正像工程的地方,是它默认会失败
另一个很对胃口的细节是,它没有把 Agent 画成一条永远顺滑的箭头。
每个 Ticket 有独立的执行器会话和目录。准备阶段可以用 git worktree 建出独立检出;并发有 worker slot 限制;CI 等输入在没有空位时等待;一次失败的输入投递会重试;策略变化会让正在进行的判断失效并重新排队。连「人说了停」也不是 Worker 自己脑补的终止信号,而是作为事件重新经过判断流程。
这类设计读起来有点啰嗦,因为它处理的都是不那么性感的东西:重复事件、进程重启、超时、排队、已经结束的任务又收到后续评论。
可一套 Agent 真正开始替人干活时,基本就会撞上这些东西。模型输出再漂亮,遇到重启后重复开 PR、CI 红一次就连跑三次、有人改了规则却没影响正在执行的任务,信任会掉得比模型分数快。
官方原型把 Trigger 设计成不可变记录,把 Ticket 当作授权工作的单位,也让执行器在独立目录里工作。这三件事合起来,至少提供了三个朴素的工程收益:同一事件不应该重复变成两张工单;一件事可以被停掉、恢复或追查;一个 Worker 的工作区不该污染另一个 Worker。
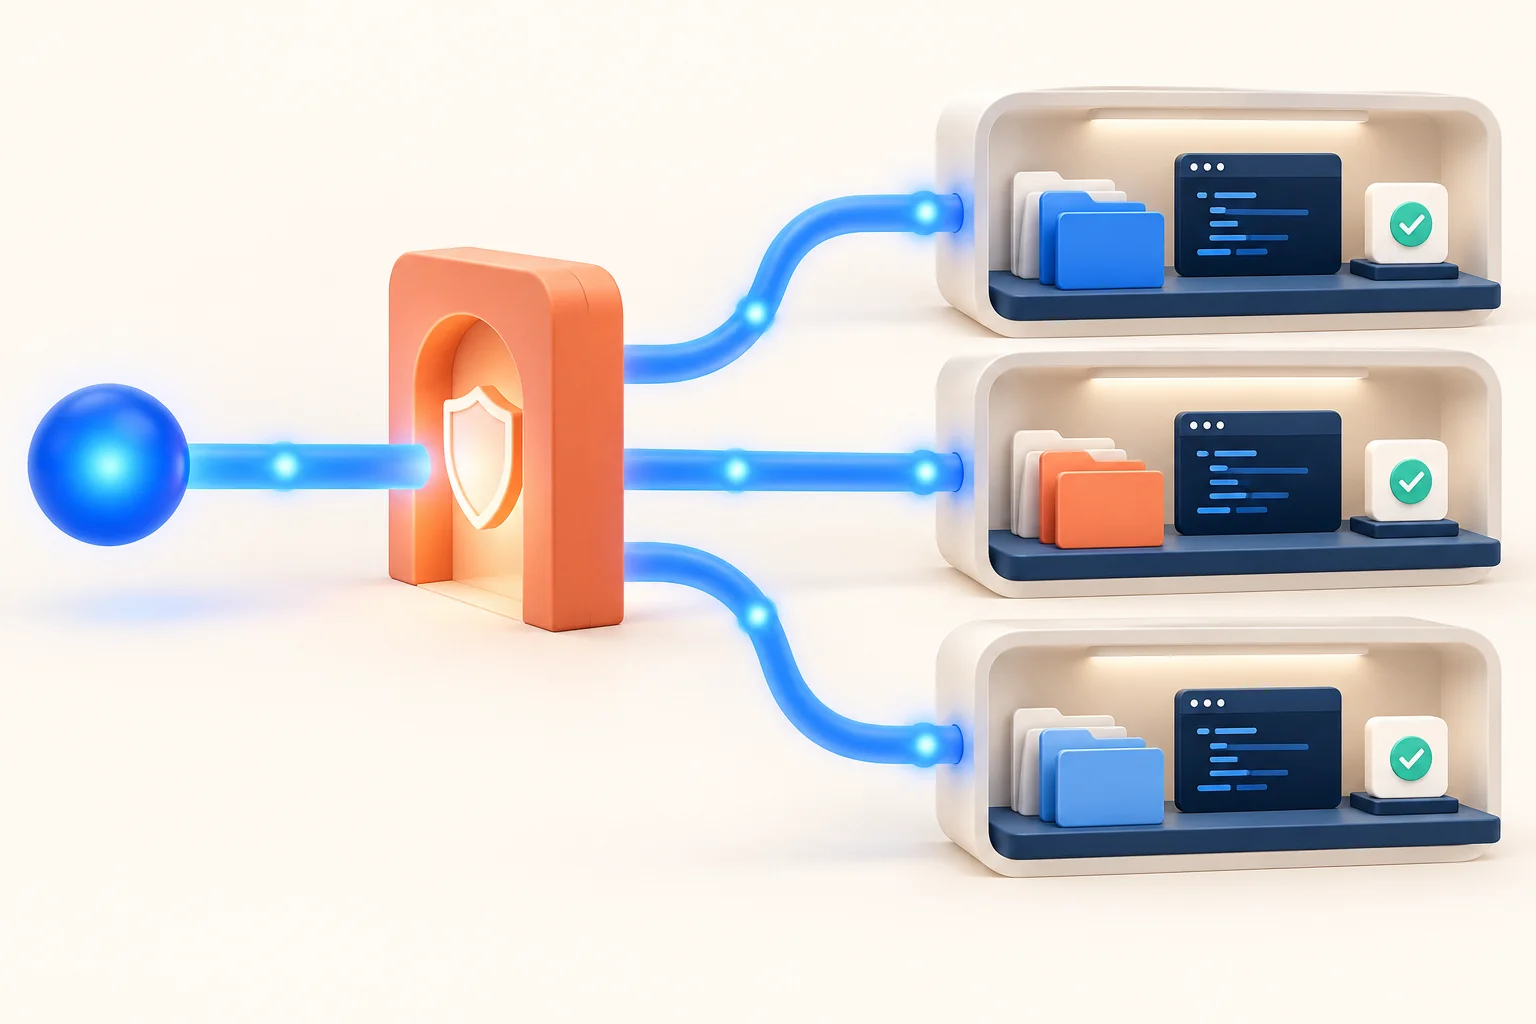
图:本文的概念图。并发不是让所有 Agent 都说话,而是让它们在受控范围内安静地完成各自任务。
真要抄,先抄这三张表
它并不要求你把整套框架搬回公司。README 反复提醒:这是研究代码,公开版本与内部实现也不完全相同。直接照着安装,反而会错过里面真正可迁移的东西。
第一张是接活表。把每个入口事件分为「仅记录」「可评估」「可直接形成明确请求」三类。GitHub 的 @ 提及、已经绑定的 PR 追问、CI 状态变化、飞书群聊里的普通转发,默认不该拥有同样的力度。
第二张是授权表。每个被接受的任务至少带上:发起来源、发起人身份、允许动作、可访问的仓库或目录、停止条件、规则版本。策略变了,不要悄悄让旧任务沿用新世界;要么让它重新评估,要么把差异留进审计记录。
第三张是交付表。一个执行器结束时,不能只回一句「已完成」。至少需要说明改了什么、证据在哪里、是否需要人复核、后续事件应该回到哪个 Ticket。把结果、Pull Request、测试和失败原因绑定在同一个任务上,后面的人才不必翻聊天记录猜发生过什么。
下面这段不是原型的配置文件,只是一份可以贴进自己系统的最小检查模板:
ticket:
  origin: github:pr-comment
  requester: allowed-maintainer
  scope: "review #482 的失败测试,不修改部署配置"
  policy_version: 2026-11-02
  allowed_actions: [read_repo, run_tests, open_pull_request]
  stop_when: "涉及生产密钥、费用或跨仓库写入"
  evidence_required: [test_output, diff, pull_request]
它没有替你做安全隔离,也不会自动保证测试是真的。但它会逼团队把一句模糊的「让 Agent 看看」变成可执行、可限制、可验收的契约。
少打扰人,不等于让人失去控制
原型的核心原则是「少占用人的注意力,多交付价值」。听起来像产品口号,落到实现上却很具体:只在有人必须决定或能使用结果时发消息;主动工作先从只记录开始;问题一次只问一个;执行时安静,结果就绪、需要决策或无法完成时再出现。
这比「给 Agent 建一个总控」更难,因为它要求团队先回答一件不太舒服的事:我们到底愿意把哪些判断交出去?
Worker 数量不是答案。能证明自己不会乱开工、不会顺着一条聊天消息越权、不会在失败后把现场搅得更乱,才是常驻 Agent 能留下来的前提。
如果你们已经把 Agent 接进了代码仓库:现在最难追的,是它做过什么,还是它为什么有资格做?