
ChatGPT 与 Codex 共用额度后,Agent 任务要拆成两档
12 月起,ChatGPT 与 Codex 的用量将进入同一池。比起盯着 token 数,更实用的是把 Agent 工作分成探索与交付两档,为关键任务留出可预测的窗口。
你有没有遇过这种工作日:上午在 ChatGPT 里追一个难复现的报错,来回补日志、改条件;下午把同一件事交给 Codex,让它看仓库、改文件、跑测试。两边都像在干活,直到某个关键需求进来,才发现自己已经不知道还剩多少余量。
这件事从 12 月开始,会变得更具体。OpenAI 最新的帮助中心说明写得很直白:Plus、Pro 和 Business 的 ChatGPT 与 Codex 用量会共享,并按 token 计算;Instant 即时聊天不从这份共享额度里扣。
官方还没有在这篇说明里公布每档具体有多少 token、不同工作怎样换算。现在没法严肃地算出「一个 PR 值多少钱」,也不该拿想象出来的数字吓人。
但方向已经足够清楚:以后要管理的,不再只是某个工具的次数,而是一整段 Agent 工作流的预算。
这事儿最容易被误解成「少聊两句,给 Codex 留点额度」。我觉得没那么简单。真正会吞掉额度的,往往不是一次提问,而是没有边界的任务:带着一大段旧上下文反复换说法、让模型在错误方向上继续搜索、或者把一个尚未讲清的需求丢给 Agent,期待它自己从迷雾里走出来。
如果聊天与编码 Agent 开始从同一池子取水,最实用的调整不是省着用,而是把任务拆成两档:探索档可以快、可以浅、可以中止;交付档要慢一点,但每次都得留下证据。
探索档:把「想一想」限制在一个小盒子里
探索不是浪费。写代码前让模型读一段报错、比较两个方案、列出可能受影响的文件,很多时候反而能少走弯路。问题在于,探索任务特别容易没有终点。
「再看看有没有别的原因」「把这个仓库全读一遍再给我建议」「换个思路继续」——这些话在人类同事之间听着很自然,交给 Agent 却相当于把停止条件删掉。模型会继续读更多文件、拉长上下文、尝试更多路径。它可能得到更好的答案,也可能只是更完整地迷路。
探索档应该只拿来回答一个小问题,而且要在任务里写出退出条件。比如:
目标:判断支付回调失败最可能的两个原因。
范围:只看最近一次报错、回调处理器和这次改动的 diff。
输出:按可能性排序,列出需要人工确认的证据。
停止:找不到证据时直接说“不足以判断”,不要继续扩大检索范围。
这段提示没有让模型更聪明,只是把工作装进了一个盒子。它能给你一个可选方向,却不该承担「把整个问题想明白」的承诺。
对 ChatGPT 里的深度分析、Codex 的代码库问答、临时让模型读日志,这个盒子都适用。探索档的产物最好是候选、风险和待验证清单,不是自动改好的结果。它可以被丢掉,所以预算也该小。
一个很朴素的判断法:如果你还不能说出「答案出来后我下一步会做什么」,这件事还停留在探索档。别急着让 Agent 开工具跑一个下午。
探索档也该留下结果,不过结果只需是候选与未知项;交付档则要留下 diff、测试或可审查的决策。以后回看消耗,才知道哪一类请求真的把产品往前推了一步。
图:探索档不是少用模型,而是让每轮探索有可见边界。
交付档:每多花一轮,都要换回一份证据
另一档才是需要认真给额度让路的工作:修一个明确的 bug、完成一个已经写清验收条件的小功能、审查一段具体 diff,或者把一组测试跑通。
交付档不是「给一个大 prompt 然后祈祷」。它需要一个明确的输入、一份能验证的输出,以及一个人类仍然握着的停损点。
拿代码修复举例。比起说「把登录问题修好并把测试都跑一遍」,不如把任务写成:
- 已知现象:哪条请求、什么条件下失败,附最短的报错或复现步骤。
- 允许改动:具体模块、配置和依赖边界;不确定的迁移或删除操作必须停下来。
- 验收证据:新增或更新的测试、命令输出、diff 中的关键改动。
- 停损规则:连续两次修复没有缩小失败范围,就返回当前证据与下一步建议,而不是继续猜。
这里最值钱的不是「让模型多跑几轮」,而是每一轮之后都能知道它到底推进了没有。以前额度分开时,一次失控的深度对话和一次失控的编码任务至少不会互相挤占。共享之后,它们会同时消耗同一个余量,失败路径也就更该尽快露出来。
有些团队会把这当成模型选型问题:轻任务用便宜模型,重任务用强模型。模型当然重要,但任务形状更靠前。一个没有范围、没有验收、没有停损的轻任务,也能把上下文拖得很长;一个范围很窄、测试很明确的重任务,反而可能一次就结束。
所以交付档要追问的不是「它还能不能再试一次」,而是「再试一次能新增什么证据」。如果回答只是「也许会成功」,那轮重试大概率不值。
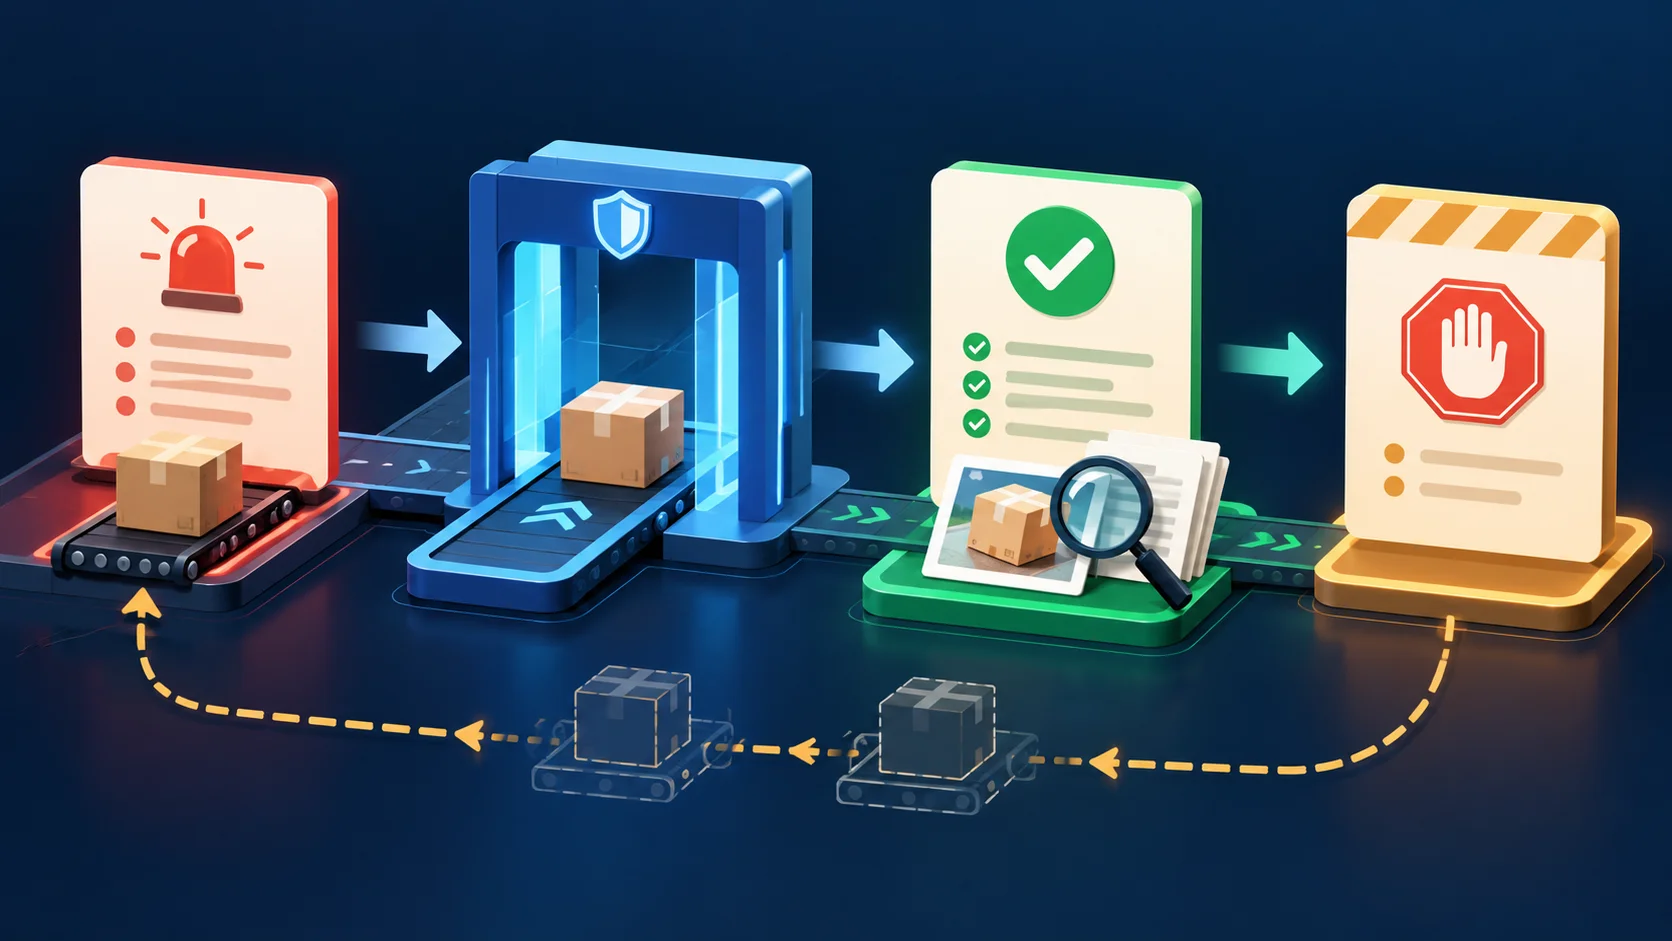
图:交付档把每次模型调用绑定到可检查的推进,而不是绑定到希望。
同一个额度池里,最该留下的是关键窗口
共享额度还有一个容易被忽略的变化:它会让个人习惯更容易变成协作话题。
对一个重度用户而言,ChatGPT 里的研究和 Codex 的大改动,最后都会反映在同一份余额上。小团队即使每人额度独立,也会在同一条交付链上遇到类似的取舍:有人还在扩大探索范围,有人已经在等一个可审查的修复。把任务优先级留到快见底时再处理,通常只会变成「谁的任务更急」的临时辩论。
可以从一个很轻的标记开始:每个 Agent 任务在发出前,写上 探索、交付 或 紧急。不用建复杂看板,三类已经够用。
[探索] 30 分钟内给出根因候选,不改文件。
[交付] 修复 checkout 超时;需要测试输出和可审查 diff。
[紧急] 线上告警;先收集证据,再由负责人决定是否扩大范围。
这个标记的作用,不是给调用上道德枷锁。它只是让大家在消耗同一份资源前说清楚:这是为了减少不确定性,还是为了产出一个可以验收的东西。
OpenAI 说,用户届时可以在「设置 → 用量」里看到合并后的剩余额度和重置时间;到达上限后,可以等待重置、升级,或在符合条件时购买额度。对重度用户来说,更值得提前做的是观察,而不是抢着下结论:把未来两三周里最耗时的任务记下来,看看它们到底属于探索还是交付。
如果多数消耗都来自探索,优化重点是上下文、范围和停损;如果多数消耗来自可验收交付,才值得讨论套餐、额度或把部分工作迁到 API。没做这层区分就去比较价格,容易把问题看成「模型不够多」,其实可能是任务太松。
共享额度不一定会让每个人都更早撞线,官方也说预计大多数用户不必更频繁地等待重置。可它确实把一个以前藏在工具边界后的事实摆到了台面上:高级模型的注意力是有限资源,越像一个随时可叫来的同事,越需要把任务讲清楚。
你现在最容易让 Agent 无边界消耗的任务,是排查问题、写方案,还是反复改同一段代码?